

Je m'appelle Sergey, je viens de l'entreprise ITSumma, et je veux vous expliquer comment nous abordons la sauvegarde dans Kubernetes. Récemment, je me suis beaucoup investi dans le conseil pour l'implémentation de diverses solutions devops pour différentes équipes, et en particulier, je travaille sur des projets utilisant K8s. Lors de la conférence Uptime Day 4, consacrée à la sauvegarde dans des architectures complexes, j'ai présenté un exposé sur la sauvegarde du « cube », et voici son résumé libre. Je tiens à prévenir à l'avance qu'il ne s'agit pas d'un guide pratique, mais plutôt d'une synthèse de réflexions sur le sujet.
En principe, la surveillance et la sauvegarde sont les deux principaux outils pour améliorer la résilience de tout projet. Mais, vous direz-vous, dans K8s, tout est déjà équilibré, tout se scale automatiquement, et si quelque chose se produit, ça se relève tout seul... Donc, lors d'une première exploration superficielle du sujet, à la question de savoir comment chacun aborde la sauvegarde de K8s, Internet m'a répondu « mais pourquoi ? » Beaucoup pensent que K8s est une sorte de chose magique qui élimine tous les problèmes d'infrastructure et garantit que le projet ne s'effondrera jamais. Mais... le monde n'est pas ce qu'il semble.
Comment abordions-nous le processus de sauvegarde auparavant ? Nous avions des plateformes identiques pour l'hébergement — soit des machines virtuelles, soit des serveurs physiques serveurs, auxquelles nous appliquions trois pratiques fondamentales :
- synchronisation du code et des fichiers statiques
- synchronisation des configurations
- réplication de bases de données
Et voilà : à tout moment, nous basculons vers la plateforme de sauvegarde, tout le monde est heureux, nous nous levons et nous nous éloignons.
Que nous est-il proposé pour augmenter la disponibilité permanente de notre application Kubernetes ? La première chose que la documentation non officielle mentionne est de mettre en place plusieurs machines, d'avoir plusieurs maîtres — leur nombre doit satisfaire aux conditions pour atteindre le quorum au sein du cluster, et qu'un etcd, api, MC, scheduler, etc. soit déployé sur chacun des maîtres. Cela semble idéal : en cas de défaillance de plusieurs nœuds de travail ou maîtres, notre cluster se rééquilibre et l'application continue de fonctionner. Cela ressemble encore à de la magie ! Cependant, souvent, notre cluster se trouve dans un seul centre de données, ce qui peut soulever certaines questions. Que se passe-t-il si une pelle arrive et endommage un câble, si un coup de foudre survient, si un déluge universel se produit ? Tout cela s'effondre, notre cluster n'existe plus. Comment aborder la mise en place de la redondance en tenant compte de ce problème ?
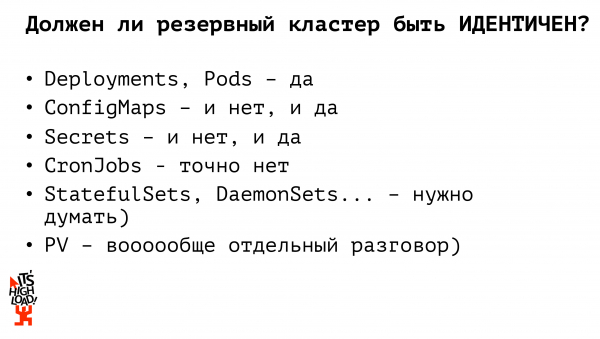
Avant tout, vous devez avoir un autre cluster en réserve chaude, c'est-à-dire un cluster vers lequel vous pouvez basculer à tout moment. Du point de vue de Kubernetes, les infrastructures doivent être totalement identiques. Cela signifie que s'il existe des plugins non standards pour travailler avec le système de fichiers, des solutions personnalisées pour l'ingress, elles doivent être complètement identiques sur vos deux (ou trois, ou dix, selon vos moyens financiers et la disponibilité des administrateurs) clusters. Il est nécessaire de définir clairement deux ensembles d'applications (déploiements, statefulsets, daemonsets, cronjobs, etc.) : lesquels peuvent fonctionner en réserve en permanence, et lesquels vaut mieux ne pas lancer avant un basculement immédiat.
Notre cluster de secours doit-il être complètement identique à notre cluster de production ? Non. Alors que, dans le cadre de projets monolithiques avec une infrastructure matérielle, nous maintenions des environnements presque totalement identiques, cela ne doit pas être le cas avec Kubernetes. Voyons pourquoi.
Par exemple, commençons par les entités de base de Kubernetes — les déploiements - elles doivent être identiques. Des applications doivent être lancées, capables à tout moment de prendre en charge le trafic et permettant à notre projet de continuer à vivre. Si nous parlons de fichiers de configuration, il faut se demander s'ils doivent être identiques ou non. Autrement dit, si nous, êtres sensés, ne consommons aucune substance interdite et ne maintenons pas notre base de données dans K8s, nous devons avoir dans nos configmaps les configurations d'accès à la base de données de production (le processus de sauvegarde de celle-ci étant géré séparément). Par conséquent, pour garantir l'accès à l'instance de sauvegarde de la base de données, nous devons avoir un fichier de configuration distinct (configmap). De la même manière, nous travaillons avec les secrets : mots de passe pour accéder à la base, clés API ; à tout moment, nous pouvons avoir soit le secret de production, soit le secret de sauvegarde. En résumé, nous avons déjà deux entités Kubernetes, dont les versions de sauvegarde ne doivent pas être identiques aux versions de production. La prochaine entité sur laquelle nous devons nous concentrer est le cronjob. Les cronjobs de sauvegarde ne doivent en aucun cas être identiques à l'ensemble des cronjobs du cluster de production ! Si nous déployons un cluster de sauvegarde et le démarrons complètement avec tous les cronjobs activés, par exemple, les gens recevront chez vous deux courriels à la fois au lieu d'un seul. Ou bien une certaine synchronisation des données avec des sources externes se produira deux fois, ce qui nous mettra dans une situation délicate, nous fera pleurer, crier et nous mettre en colère.
Et comment nous proposent-ils d'organiser le cluster de sauvegarde, ces gens d'internet ? La deuxième réponse la plus populaire après "pourquoi ?" est l'utilisation de la fédération Kubernetes.
Qu'est-ce que c'est ? C'est, disons, un grand méta-cluster. Si nous imaginons l'architecture de Kubernetes — où nous avons un maître, plusieurs nœuds — du point de vue de la fédération, nous avons aussi un maître et plusieurs nœuds, sauf que chaque nœud est un cluster distinct. Cela signifie que nous travaillons avec les mêmes entités, avec les mêmes primitives, que pour un seul Kubernetes, sauf que nous manipulons non pas nos machines physiques, mais de véritables clusters. Dans le cadre de la fédération, nous avons une synchronisation complète des ressources fédératives entre les parents et les descendants. Par exemple, si nous avons lancé un déploiement via la fédération — il será déployé sur chacun de nos clusters enfants. Si nous prenons un configmap ou un secret et que nous le déployons via la fédération — il se propage à tous nos clusters enfants ; tout en permettant à la fédération de personnaliser nos ressources sur les enfants. Ainsi, nous avons pris un configmap, l'avons déployé via la fédération et ensuite, si nous avons besoin de modifier quelque chose sur des clusters spécifiques, nous allons ajuster sur le cluster particulier, et ce changement ne sera plus synchronisé nulle part.
La fédération Kubernetes — un outil relativement récent, ne supporte pas encore l'ensemble des ressources proposées par K8s : au moment de la publication de l'une des premières versions de la documentation, il était fait mention du support uniquement pour les config maps, le déploiement via replica set et ingress. Les secrets n'étaient pas pris en charge, et le travail avec les volumes non plus. C'est un ensemble d'options trop limité. Surtout si nous aimons expérimenter, par exemple en utilisant des custom resource definitions pour transmettre nos propres ressources à Kubernetes, ces dernières ne pourront pas être intégrées dans la fédération. Cela ressemble à une solution presque réaliste, mais qui nous pousse parfois à nous tirer une balle dans le pied. D'un autre côté, la fédération permet de gérer de manière flexible notre replica set. Par exemple, si nous souhaitons avoir 10 répliques de notre application, la fédération répartira ce nombre de manière proportionnelle entre les clusters par défaut. Et cela peut encore être configuré ! Ainsi, on peut indiquer qu'il faut garder 6 répliques de notre application sur le cluster de production, et seulement 4 répliques sur le cluster de secours, soit pour économiser des ressources, soit pour d'autres expérimentations. C'est également très pratique. Mais avec la fédération, nous devons utiliser de nouvelles solutions, déployer des éléments en cours de route, et nous forcer à réfléchir un peu plus…
Peut-on aborder le processus de réservation de Kubernetes d'une manière plus simple ? Quels outils avons-nous à notre disposition ?
Tout d'abord, nous avons toujours un système CI/CD, ce qui signifie que nous ne devons pas nous rendre manuellement sur les serveurs pour écrire des create/apply. Le système génère des fichiers yaml pour nos conteneurs.
Deuxièmement, nous avons plusieurs clusters, avec soit un seul, soit plusieurs (si nous sommes prévoyants) registries que nous avons également réservés. Et il existe une merveilleuse utilitaire kubectl qui peut fonctionner avec plusieurs clusters simultanément.
Ainsi, à mon avis, la solution la plus simple et la plus efficace pour construire un cluster de sauvegarde est un déploiement parallèle primitif. Il existe un pipeline dans le système CI/CD ; d'abord, nous construisons nos conteneurs, les testons et déployons les applications via kubectl sur plusieurs clusters indépendants. Nous pouvons effectuer des déploiements simultanés sur plusieurs clusters. Par conséquent, la livraison des configurations est également résolue à ce stade. Nous pouvons définir à l'avance un ensemble de configurations pour notre cluster de production et un ensemble de configurations pour le cluster de sauvegarde, et au niveau du système CI/CD, nous déployons l'environnement de production dans le cluster de production et l'environnement de sauvegarde dans le cluster de sauvegarde. Comparé à la fédération, il n'est pas nécessaire de se rendre, après avoir défini la ressource fédérative, à chaque cluster enfant pour redéfinir quelque chose. Nous l'avons fait à l'avance. Comme nous sommes bons.
Mais… il y a… j'avais écrit qu'il y a « la racine de tous les maux », mais en réalité, il y en a deux. Premièrement, le système de fichiers. Il existe un PV, ou nous utilisons un stockage externe. Si nous stockons des fichiers à l'intérieur du cluster, il faut agir selon les anciennes pratiques héritées des infrastructures matérielles : par exemple, synchroniser avec lsync. Ou tout autre béquille que vous préférez personnellement. Nous déployons tout sur d'autres machines et vivons.
Deuxièmement, et c'est en réalité un point d'accroche encore plus important — la base de données. Si nous sommes des gens intelligents et ne maintenons pas la base dans Kubernetes, alors le processus de sauvegarde des données selon l'ancien schéma — réplication master-esclave, puis basculement, nous rattraperons la réplique et nous vivrons bien. Mais si nous maintenons notre base de données à l'intérieur du cluster, il existe en principe de nombreuses solutions prêtes à l'emploi pour organiser la même réplication master-esclave, de nombreuses solutions pour mettre en place une base de données à l'intérieur de Kubernetes.
Des milliards de présentations ont déjà été faites sur la sauvegarde des bases de données, des milliards d'articles ont été écrits, il n'y a en fait rien de nouveau ici. En gros, suivez votre rêve, vivez comme vous le souhaitez, inventez-vous aussi des béquilles compliquées, mais pensez absolument à comment vous allez toutes les sauvegarder.
Maintenant, parlons de la façon dont nous allons procéder au basculement vers le site de secours en cas d'incendie. Tout d'abord, nous déployons en parallèle des applications stateless. Celles-ci n'affectent pas la logique commerciale de nos applications, de notre projet ; nous pouvons maintenir en permanence deux ensembles d'applications en cours d'exécution, prêtes à recevoir du trafic. Il est très important, lors du basculement vers le site de secours, de vérifier si les configurations doivent être redéfinies. Par exemple, nous avons un cluster Kubernetes en production, un cluster Kubernetes de secours, une base de données principale externe et une base de données principale de secours. Nous avons quatre options quant à la manière dont ces applications en production peuvent interagir entre elles. La base de données peut basculer, et il s'avère qu'il est nécessaire de rediriger le trafic vers la nouvelle base dans le cluster de production, ou bien le cluster peut planter — et nous passons sur le secours, tout en continuant à travailler avec la base production. Il y a aussi la troisième option, où il y a eu une défaillance ici et là, et nous redirigeons les deux applications, redéfinissant notre configuration, afin que les nouvelles applications fonctionnent déjà avec la nouvelle base de données.
Alors, quelles conclusions peut-on tirer de tout cela ?
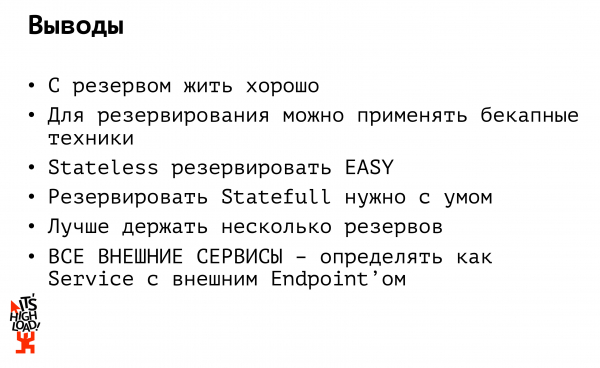
Première conclusion : avoir un site de secours est bien. Mais coûteux. Idéalement, il ne faudrait pas se contenter d'un seul site de secours. Il est préférable d'en avoir plusieurs. Tout d'abord, le site de secours ne doit pas se trouver dans le même centre de données, et deuxièmement, il doit être chez un autre hébergeur. Cela s'est déjà produit, et je l'ai constaté dans ma pratique. Je ne peux pas nommer les projets, mais lorsque l'incendie s'est produit dans le centre de données... je me suis dit : basculons vers le secours ! Alors que les serveurs de secours étaient dans le même rack...
Ou imaginez que Amazon soit interdit en Russie (et cela a déjà eu lieu). Et voilà : à quoi bon que notre réserve soit dans un autre Amazon ? Elle est également inaccessible. Donc, je le répète : gardons une réserve, au minimum dans un autre centre de données, et de préférence — chez un autre hébergeur.
Deuxième sortie : si vous avez une application dans Kubernetes qui communique avec des sources externes (cela peut être une base de données ou une API externe), définissez-la obligatoirement comme un service avec un point de terminaison externe, afin de ne pas devoir redéployer vos 15 applications qui accèdent à la même base lors du changement. Définissez la base comme un service distinct, accédez-y comme si elle était à l'intérieur de votre cluster : si votre base échoue, vous changez l'IP à un seul endroit et continuez à vivre heureux.
Et enfin : j'aime « le cube », tout comme les expériences qui l'entourent. J'aime également partager les résultats de ces expériences et mon expérience personnelle en général. C'est pourquoi j'ai enregistré une série de webinaires sur K8s, bienvenue sur pour plus de détails.
Source : habr.com
