

Le Serverless ne signifie pas l'absence physique de serveurs. Ce n'est pas un « tueur » de conteneurs, ni une mode passagère. C'est une nouvelle approche pour construire des systèmes dans le cloud. Dans cet article, nous aborderons l'architecture des applications Serverless, examinerons le rôle du fournisseur de services Serverless et des projets open-source. Enfin, nous discuterons des questions liées à l'application de Serverless.
Je veux écrire la partie serveur d'une application (même si c'est un magasin en ligne). Cela peut être un chat, un service de publication de contenu ou un équilibreur de charge. Quoi qu'il en soit, il y aura beaucoup de casse-tête : il faudra préparer l'infrastructure, définir les dépendances de l'application, réfléchir au système d'exploitation de l'hôte. Ensuite, il sera nécessaire de mettre à jour de petits composants qui n'affectent pas le fonctionnement du reste du monolithe. Et n'oublions pas la montée en charge.
Et si nous utilisions des conteneurs éphémères, dans lesquels les dépendances nécessaires sont déjà préinstallées, et où les conteneurs sont isolés les uns des autres et de l'OS hôte ? Nous allons décomposer le monolithe en microservices, chacun pouvant être mis à jour et mis à l'échelle indépendamment des autres. En plaçant le code dans un tel conteneur, je pourrai l'exécuter sur n'importe quelle infrastructure. C'est déjà mieux.
Et si je ne veux pas configurer des conteneurs ? Je ne veux pas penser à la montée en charge de l'application. Je ne veux pas payer pour le temps d'arrêt des conteneurs en cours d'exécution lorsque la charge de service est minimale. Je veux écrire du code. Me concentrer sur la logique métier et lancer des produits sur le marché à la vitesse de la lumière.
Ces pensées m'ont conduit au calcul sans serveur. Serverless, dans ce cas, signifie pas l'absence physique de serveurs, mais l'absence de casse-tête liée à la gestion de l'infrastructure.
L'idée est que la logique de l'application est décomposée en fonctions indépendantes. Elles ont une structure événementielle. Chaque fonction exécute une « micro-tâche ». Tout ce que le développeur doit faire est de télécharger les fonctions dans la console fournie par le fournisseur de cloud et de les relier aux sources d'événements. Le code sera exécuté à la demande dans un conteneur automatiquement préparé, et je ne paierai que pour le temps d'exécution.
Voyons maintenant à quoi ressemblera le processus de développement de l'application.
Du point de vue du développeur
Auparavant, nous avons commencé à parler d'une application pour un magasin en ligne. Dans l'approche traditionnelle, la logique principale du système est exécutée par une application monolithique. Et le serveur avec l'application est toujours en cours d'exécution, même si il n'y a pas de charge.
Pour passer au serverless, nous décomposons l'application en micro-tâches. Pour chacune d'elles, nous écrivons notre propre fonction. Les fonctions sont indépendantes les unes des autres et ne conservent pas d'informations sur l'état (sans état). Elles peuvent même être écrites dans différents langages. Si l'une d'elles « tombe », l'application dans son ensemble ne s'arrête pas. L'architecture de l'application ressemblera à ceci :
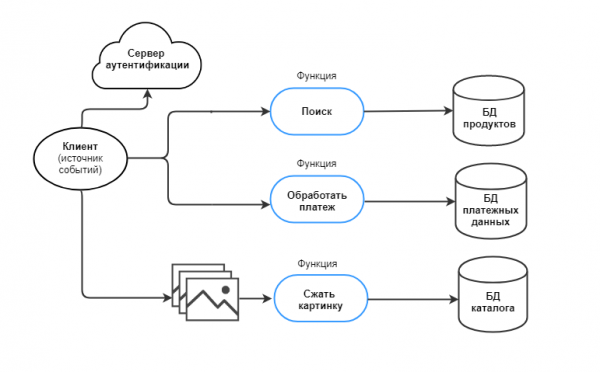
La division en fonctions dans Serverless ressemble au travail avec des microservices. Mais un microservice peut exécuter plusieurs tâches, tandis qu'une fonction doit idéalement en exécuter une seule. Imaginons qu'il y a une tâche à accomplir pour collecter des statistiques et les afficher sur demande de l'utilisateur. Dans l'approche microservices, une seule service exécute la tâche avec deux points d'entrée : un pour l'écriture et un pour la lecture. Dans le calcul sans serveur, ce seront deux fonctions différentes, non liées entre elles. Le développeur économise des ressources de calcul si, par exemple, les statistiques sont mises à jour plus fréquemment qu'elles ne sont exportées.
Les fonctions Serverless doivent s'exécuter pendant un court laps de temps (timeout), qui est défini par le fournisseur de services. Par exemple, pour AWS, le timeout est de 15 minutes. Cela signifie que les fonctions à long terme devront être adaptées aux exigences ― c'est ce qui distingue Serverless d'autres technologies populaires aujourd'hui (conteneurs et Platform as a Service).
Nous attribuons un événement à chaque fonction. Un événement est un déclencheur pour une action :
Événement
Action exécutée par la fonction
Une image du produit a été téléchargée dans le stockage
Compresser l'image et l'exporter dans le répertoire
L'adresse du magasin physique a été mise à jour dans la base de données
Charger la nouvelle localisation sur les cartes
Le client paie le produit
Démarrer le traitement du paiement
Les événements peuvent être des requêtes HTTP, des données en streaming, des files d'attente de messages, etc. Les sources d'événements sont des modifications ou l'apparition de données. De plus, les fonctions peuvent être déclenchées par un minuteur.
L'architecture a été développée et l'application est presque devenue sans serveur. Passons ensuite au fournisseur de services.
Côté fournisseur
En général, le calcul sans serveur est proposé par les fournisseurs de services cloud. Ils l'appellent différemment : Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
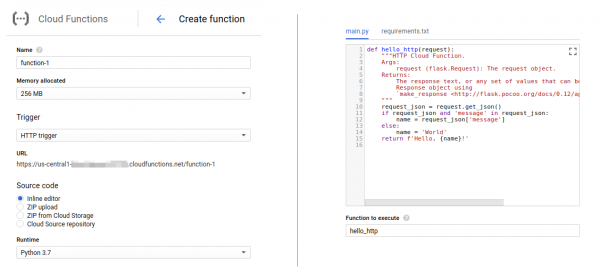
Nous utiliserons le service via la console ou le tableau de bord du fournisseur. Le code des fonctions peut être téléchargé de l'une des manières suivantes :
- écrire le code dans les éditeurs intégrés via la console web,
- télécharger une archive avec le code,
- travailler avec des dépôts git publics ou privés.
Ici, nous configurons les événements qui déclenchent la fonction. Les ensembles d'événements peuvent différer chez les différents fournisseurs.
Le fournisseur a construit et automatisé un système Function as a Service (FaaS) sur son infrastructure :
- Le code des fonctions est stocké côté fournisseur.
- Lorsqu'un événement se produit, des conteneurs avec un environnement préparé se déploient automatiquement sur le serveur. Chaque instance de fonction a son propre conteneur isolé.
- Depuis le stockage, la fonction est envoyée au conteneur, est calculée et renvoie le résultat.
- Le nombre d'événements parallèles augmente, ce qui augmente le nombre de conteneurs. Le système se met automatiquement à l'échelle. Si les utilisateurs n'utilisent pas la fonction, celle-ci sera inactive.
- Le fournisseur définit le temps d'inactivité des conteneurs : si aucune fonction n'apparaît dans le conteneur pendant cette période, il est détruit.
Ainsi, nous obtenons le Serverless « prêt à l'emploi ». Nous paierons pour le service selon le modèle pay-as-you-go et uniquement pour les fonctions utilisées, et uniquement pour le temps pendant lequel elles ont été utilisées.
Pour familiariser les développeurs avec le service, les fournisseurs proposent jusqu'à 12 mois d'essai gratuit, mais limitent le temps total de calcul, le nombre de requêtes par mois, les fonds ou la puissance consommée.
Le principal avantage de travailler avec un fournisseur est de ne pas avoir à se soucier de l'infrastructure (serveurs, machines virtuelles, conteneurs). De leur côté, les fournisseurs peuvent mettre en œuvre le FaaS à la fois avec leurs propres développements et à l'aide d'outils open-source. C'est de cela dont nous allons parler ensuite.
Du côté de l'open source
Au cours des deux dernières années, la communauté open-source a activement travaillé sur des outils Serverless. Parmi ceux-ci, les plus grands acteurs du marché contribuent au développement des plateformes sans serveur :
- Google propose aux développeurs son outil open-source ― . IBM, RedHat, Pivotal et SAP ont participé à son développement ;
- IBM ont travaillé sur la plateforme Serverless , qui est ensuite devenue un projet de l'Apache Foundation ;
- par Microsoft ont partiellement ouvert le code de la plateforme .
Le développement se poursuit également dans le domaine des frameworks serverless. et sont déployés dans des clusters Kubernetes préparés à l'avance, fonctionne à la fois avec Kubernetes et Docker Swarm. Le framework agit comme un contrôleur spécifique : sur demande, il prépare un environnement d'exécution au sein du cluster, puis lance la fonction.
Les frameworks laissent place à la configuration de l'outil selon ses besoins. Par exemple, dans Kubeless, le développeur peut configurer le délai d'exécution de la fonction (la valeur par défaut est de 180 secondes). Fission, pour résoudre le problème du démarrage à froid, propose de maintenir certaines conteneurs toujours en cours d'exécution (ce qui entraîne des coûts liés aux ressources inactives). OpenFaaS, quant à lui, propose un ensemble de déclencheurs diversifiés : HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs et d'autres.
Les instructions pour commencer peuvent être trouvées dans la documentation officielle des frameworks. Travailler avec eux nécessite un peu plus de compétences que de travailler avec un fournisseur : c'est au minimum la capacité de lancer un cluster Kubernetes via la CLI. Au maximum, cela inclut l'utilisation d'autres outils open-source (par exemple, le gestionnaire de files d'attente Kafka).
Quelle que soit la manière dont nous travaillerons avec Serverless — par le biais d'un fournisseur ou en utilisant open-source, nous obtiendrons une série d'avantages et d'inconvénients du modèle Serverless.
Du point de vue des avantages et des inconvénients
Serverless développe les idées de l'infrastructure conteneurisée et de l'approche microservices, permettant aux équipes de travailler dans un mode multilingue sans s'attacher à une seule plateforme. La construction du système est simplifiée, et la correction des erreurs devient plus facile. L'architecture microservices permet d'ajouter de nouvelles fonctionnalités au système beaucoup plus rapidement que dans le cas d'une application monolithique.
Serverless réduit encore davantage le temps de développement, permettant aux développeurs de se concentrer exclusivement sur la logique métier de l'application et sur l'écriture du code. En conséquence, le temps de mise sur le marché des développements est réduit.
En prime, nous bénéficions d'une mise à l'échelle automatique en fonction de la charge, et nous ne payons que pour les ressources utilisées et uniquement pendant qu'elles sont utilisées.
Comme toute technologie, Serverless a ses inconvénients.
Par exemple, un de ces inconvénients peut être le temps de démarrage à froid (en moyenne jusqu'à 1 seconde pour des langages comme JavaScript, Python, Go, Java, Ruby).
D'une part, en réalité, le temps de démarrage à froid dépend de nombreuses variables : le langage dans lequel la fonction est écrite, le nombre de bibliothèques, le volume de code, l'interaction avec des ressources supplémentaires (comme les bases de données ou les serveurs d'authentification). Étant donné que le développeur contrôle ces variables, il peut réduire le temps de démarrage. Mais d'autre part, le développeur ne peut pas contrôler le temps de lancement du conteneur - ici, tout dépend du fournisseur.
Un démarrage à froid peut devenir un démarrage à chaud lorsque la fonction réutilise un conteneur déjà lancé par un évènement précédent. Cela se produira dans trois cas :
- si les clients utilisent fréquemment le service et que le nombre d'appels à la fonction augmente ;
- si le fournisseur, la plateforme ou le framework permettent de garder certains conteneurs lancés en permanence ;
- si le développeur déclenche les fonctions par minuterie (disons, toutes les 3 minutes).
Pour de nombreuses applications, le démarrage à froid n'est pas un problème. Il faut se baser sur le type et les objectifs du service. Un délai de démarrage d'une seconde n'est pas toujours critique pour une application business, mais peut le devenir pour des services médicaux. Il est probable que dans ce cas, l'approche sans serveur ne soit plus adaptée.
Un autre inconvénient du Serverless est la courte durée de vie de la fonction (timeout, délai dans lequel la fonction doit être exécutée).
Cependant, si l'on doit travailler avec des tâches à long terme, on peut utiliser une architecture hybride - combinant Serverless avec une autre technologie.
Tous les systèmes ne pourront pas fonctionner selon le modèle Serverless.
Certaines applications continueront à stocker des données et des états pendant leur exeécution. Certaines architectures resteront monolithiques, tandis que certaines fonctions seront à long terme. Cependant (tout comme les technologies cloud à l'époque, puis les conteneurs), Serverless est une technologie avec un bel avenir.
Dans cette optique, j'aimerais transitionner vers la question de l'application de l'approche Serverless.
Du point de vue de l'application
En 2018, le pourcentage d'utilisation de Serverless . Parmi les entreprises qui ont déjà intégré cette technologie dans leurs services, on trouve des géants du marché comme Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. Il est à noter que Serverless n'est pas une panacée, mais un outil pour résoudre un certain type de problèmes :
- Réduire le temps d'arrêt des ressources. Il n'est pas nécessaire de garder constamment une machine virtuelle pour les services qui sont peu sollicités.
- Traiter les données « à la volée ». Compresser les images, enlever les arrière-plans, changer l'encodage vidéo, travailler avec des capteurs IoT, effectuer des opérations mathématiques.
- « Coller » d'autres services ensemble. Un dépôt Git avec des programmes internes, un chatbot sur Slack lié à Jira et à un calendrier.
- Équilibrer la charge. Ici, nous allons nous arrêter en détail.
Supposons qu'il y a un service qui reçoit 50 personnes. Une machine virtuelle avec un matériel modeste y est dédiée. Parfois, la charge sur le service augmente plusieurs fois. Dans ce cas, le matériel modeste ne peut pas gérer la charge.
On peut intégrer un répartiteur de charge dans le système, qui distribuera la charge, disons, sur trois machines virtuelles. À ce stade, nous ne pouvons pas prévoir la charge avec précision, donc nous conservons un certain nombre de ressources en cours d'exécution « en réserve ». Et nous payons trop cher pour l'inactivité.
Dans une telle situation, nous pouvons optimiser le système grâce à une approche hybride : derrière le répartiteur de charge, nous laissons une machine virtuelle et plaçons un lien vers un Endpoint Serverless avec des fonctions. Si la charge dépasse un certain seuil, le répartiteur de charge lance des instances de fonctions qui prennent en charge une partie du traitement des requêtes.
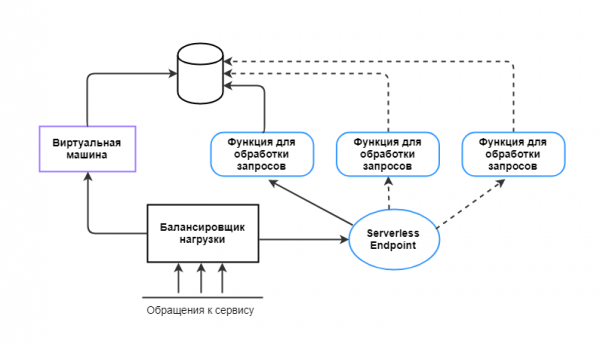
Ainsi, Serverless peut être utilisé là où il est nécessaire de traiter un grand nombre de requêtes de manière intensive sans le faire trop fréquemment. Dans ce cas, lancer plusieurs fonctions pendant 15 minutes est plus rentable que de maintenir en permanence une machine virtuelle ou un serveur.
Malgré tous les avantages de l'informatique sans serveur, il est primordial, avant son adoption, d'évaluer d'abord la logique de l'application et de comprendre quelles tâches Serverless pourra résoudre dans le cas particulier.
Serverless et Selectel
Chez Selectel, nous avons déjà via notre panneau de contrôle. Maintenant, nous construisons notre propre plateforme FaaS. Nous voulons que les développeurs puissent résoudre leurs tâches à l'aide de Serverless via une interface conviviale et flexible.
Si vous avez des idées sur ce à quoi devrait ressembler une plateforme FaaS idéale et comment vous souhaitez utiliser Serverless dans vos projets, partagez-les dans les commentaires. Nous prendrons vos suggestions en compte lors du développement de la plateforme.
Documents utilisés dans l'article :
Source : habr.com
