

Aujourd'hui, la haute disponibilité des services est exigée partout et tout le temps, pas seulement dans des projets coûteux et de grande envergure. Les sites temporairement indisponibles avec le message « Désolé, maintenance technique en cours » sont encore rencontrés, mais suscitent généralement un sourire indulgent. Ajoutons à cela la vie dans le cloud, où il suffit d'une seule requête API pour déployer un serveur supplémentaire, sans avoir à se soucier de l'exploitation matérielle. Il n'y a donc plus d'excuse pour ne pas avoir conçu un système critique de manière fiable en utilisant des technologies de clustering et de redondance.
Nous allons discuter des solutions que nous avons envisagées pour garantir la fiabilité des bases de données dans nos services et de la conclusion à laquelle nous sommes parvenus. De plus, une démo avec des conclusions pertinentes.
Le legacy dans l'architecture de haute disponibilité
Cela se voit encore mieux dans le développement des différents systèmes open-source. Les anciennes solutions ont dû ajouter des technologies de haute disponibilité à mesure que la demande augmentait. La qualité de ces solutions variait. Les solutions de nouvelle génération intègrent la haute disponibilité en tant que fondement de leur architecture. Par exemple, MongoDB positionne le cluster comme l'utilisation principale. Le cluster se redimensionne horizontalement, ce qui constitue un fort avantage concurrentiel pour ce SGBD.
Revenons à PostgreSQL. C'est l'un des projets open-source les plus anciens et populaires, dont le premier lancement a eu lieu en 1995. Pendant longtemps, l'équipe du projet ne considérait pas la haute disponibilité comme un problème à résoudre côté système. Par conséquent, la technologie de réplication pour créer des copies de données n'a été intégrée qu'à partir de la version 8.2 en 2006, mais elle était basée sur un fichier (log shipping). En 2010, la version 9.0 a introduit la réplication en continu, qui est la base de la création de divers clusters. Cela surprend généralement les personnes qui découvrent PostgreSQL après Enterprise SQL ou les NoSQL modernes, car la solution standard de la communauté n'est qu'un couple master-réplique avec réplication synchrone ou asynchrone. De plus, dans la version de base, le changement de maître se fait manuellement, et la question du basculement des clients est également laissée à la discrétion de l'utilisateur.
Comment nous avons décidé de créer un PostgreSQL fiable et ce que nous avons choisi pour cela
Cependant, PostgreSQL ne serait pas aussi populaire sans le grand nombre de projets et d'outils qui facilitent la création de solutions résilientes n'exigeant pas une attention constante. Dans le cloud (MCS) depuis le lancement de DBaaS, des serveurs PostgreSQL isolés et des paires maître-réplique avec réplication asynchrone étaient disponibles.
Naturellement, nous voulions simplifier la vie de tous et rendre accessible une installation PostgreSQL qui pourrait servir de base à des services hautement disponibles, sans nécessiter de surveillance constante et sans avoir à se lever la nuit pour effectuer un basculement. Dans ce secteur, il existe à la fois des solutions anciennes et éprouvées et une nouvelle génération d'outils utilisant les dernières avancées.
Aujourd'hui, la problématique de la haute disponibilité ne se limite pas à la redondance (c'est évident), mais à un consensus — un algorithme de sélection du leader (Leader election). Le plus souvent, les grandes pannes surviennent non pas en raison d'un manque de serveurs, mais en raison de problèmes de consensus : aucun nouveau leader n'a été choisi, deux leaders ont émergé dans des centres de données différents, etc. Un exemple est la panne du cluster MySQL de Github — ils ont écrit .
La base mathématique sur cette question est très sérieuse. D'une part, il y a , qui impose des limitations théoriques sur les possibilités de construction de solutions HA, d'autre part — des algorithmes de détermination du consensus prouvés mathématiquement, tels que et . Sur cette base, il existe des DCS assez populaires (systèmes de consensus décentralisés) — Zookeeper, etcd, Consul. Par conséquent, si un système de prise de décision fonctionne selon un algorithme conçu en interne, il convient d'y faire très attention. Après avoir analysé un grand nombre de systèmes, nous avons choisi Patroni — un système open source, principalement développé par Zalando.
En tant qu'aparté lyrique, je dirai que nous avons également envisagé des solutions multi-master, c'est-à-dire des clusters capables d'évoluer horizontalement en écriture. Cependant, pour deux raisons principales, nous avons décidé de ne pas créer un tel cluster. Tout d'abord, ces solutions sont très complexes et, par conséquent, présentent davantage de vulnérabilités. Il sera difficile d'établir une solution stable dans tous les cas. Deuxièmement, dans ce cas, PostgreSQL cesse d'être natif, certaines fonctions ne seront pas disponibles et certaines applications peuvent rencontrer des bugs cachés lors de leur fonctionnement.
Patroni
Alors, comment fonctionne Patroni ? Les développeurs n'ont pas cherché à réinventer la roue et ont proposé d'utiliser comme base l'un des DCS éprouvés. Il s'occupe de toutes les questions de synchronisation des configurations, de choix du leader et de quorum. Nous avons choisi pour cela etcd.
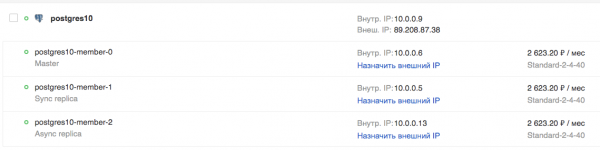
Ensuite, Patroni s'assure de l'application correcte de tous les paramètres sur PostgreSQL et des réglages de réplication, ainsi que de l'exécution des commandes de switchover et de failover (c'est-à-dire le basculement normal et anormal du maître). Dans le cloud MCS, il est possible de créer un cluster à partir d'un maître, d'une réplique synchronisée et d'une ou plusieurs répliques asynchrones. La présence d'une réplique synchronisée garantit la sécurité des données sur au moins 2 serveurs, et c'est cette réplique qui sera le principal « candidat pour devenir maître ».
Étant donné qu'etcd est déployé sur les mêmes serveurs, il est recommandé d'avoir 3 ou 5 serveurs pour une valeur de quorum optimale. Ce cluster peut être évolué horizontalement en lecture (j'ai évoqué l'extension en écriture précédemment). Cependant, il convient de noter que les répliques asynchrones tendent à avoir un retard, surtout en cas de forte charge.
L'utilisation de telles répliques en lecture (hot standby) est justifiée pour des tâches de reporting ou d'analyse et décharge le serveur maître.
Si vous souhaitez créer un tel cluster vous-même, vous aurez besoin de :
- préparer 3 serveurs ou plus, configurer l'adressage IP et les règles de pare-feu entre eux ;
- installer les paquets pour les services etcd, Patroni, PostgreSQL ;
- configurer le cluster etcd ;
- configurer le service Patroni pour travailler avec PostgreSQL.
Cela signifie qu'il faut correctement créer une dizaine de fichiers de configuration sans se tromper. Pour cela, il vaut vraiment la peine d'utiliser un outil de gestion de configuration, tel qu'Ansible, par exemple. Toutefois, il manque toujours un équilibrage de charge TCP hautement disponible. Le créer est un travail à part.
Pour ceux qui ont besoin d'un cluster prêt à l'emploi mais ne souhaitent pas se plonger dans tous ces détails, nous avons simplifié la vie en créant un cluster sur Patroni dans notre cloud, que l'on peut tester gratuitement. En plus du cluster lui-même, nous avons créé :
- Un équilibrage de charge TCP ; il pointe toujours vers le master actuel, une réplique synchrone ou asynchrone, respectivement, via différents ports ;
- Une API pour changer le master actif de Patroni.
Ils peuvent être connectés via l'API du cloud MCS ou la console web.
Démo
Pour tester les capacités du cluster PostgreSQL dans le cloud MCS, voyons comment se comporte une application en direct en cas de problèmes avec la base de données.
Voici le code de l'application qui va enregistrer des événements artificiels et en faire rapport à l'écran. En cas d'erreurs, elle fera également un retour et continuera son travail en boucle jusqu'à ce que nous l'arrêtions avec la combinaison Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Connection ouverte vers", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Valeur enregistrée, total: {}".format(record[0]))
    except Exception as error:
        print ("Erreur lors de la connexion à PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Connexion fermée")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Erreur attrapée:
", e)
                sleep(1)
    except KeyboardInterrupt:
        print("sortie")
L'application a besoin de PostgreSQL pour fonctionner. Créons un cluster dans le cloud MCS en utilisant l'API. Dans un terminal classique, où la variable OS_TOKEN contient le jeton d'accès à l'API (que l'on peut obtenir avec la commande openstack token issue), saisissons les commandes :
Créons un cluster :
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
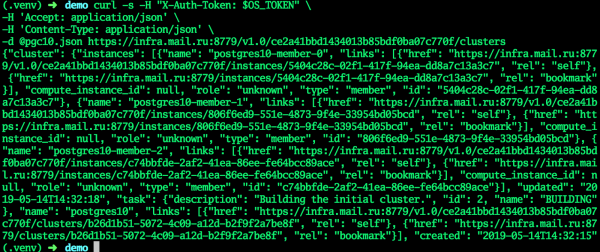
Lorsque le cluster passe au statut ACTIF, tous les champs recevront des valeurs actualisées — le cluster est prêt.
Dans l'interface graphique :
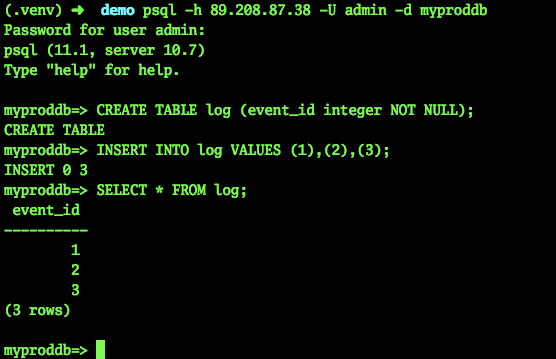
Essayons de nous connecter et de créer une table :
psql -h 89.208.87.38 -U admin -d myproddb
Mot de passe pour l'utilisateur admin :
psql (11.1, serveur 10.7)
Tapez "help" pour obtenir de l'aide.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 lignes)

myproddb=>
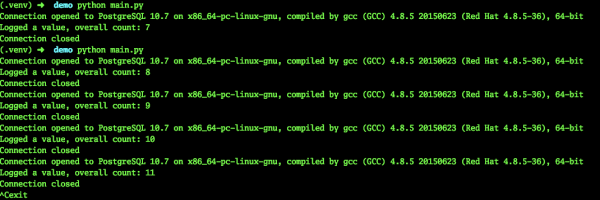
Dans l'application, nous indiquerons les paramètres actuels pour nous connecter à PostgreSQL. Nous spécifierons l'adresse du répartiteur de charge TCP, ce qui évitera de devoir basculer manuellement sur l'adresse du maître. Nous allons le lancer. Comme on peut le voir, les événements sont correctement enregistrés dans la base de données.
Basculement programmé du maître
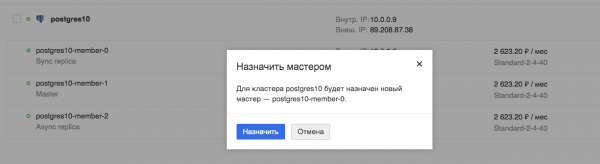
Testons maintenant le fonctionnement de notre application lors du basculement programmé du maître :
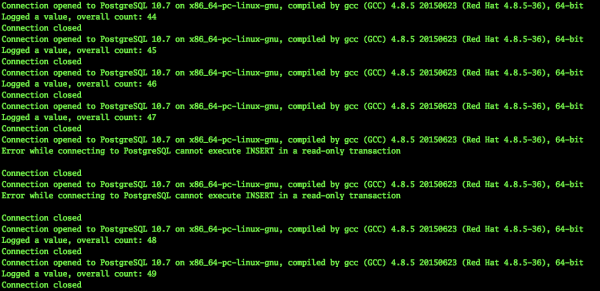
Nous surveillons l'application. Nous constatons que la fonctionnement de l'application est effectivement interrompu, mais cela ne prend que quelques secondes, dans ce cas précis, un maximum de 9.
Panne de la machine
Essayons maintenant de simuler la panne de la machine virtuelle, le maître actuel. Nous pourrions simplement éteindre la machine virtuelle via l'interface Horizon, mais ce serait un arrêt normal. Un tel basculement serait géré par tous les services, y compris, Patroni.
Nous avons besoin d'un arrêt imprévisible. Donc, j'ai demandé à nos administrateurs d'éteindre la machine virtuelle — le maître actuel — d'une manière non planifiée à des fins de test.
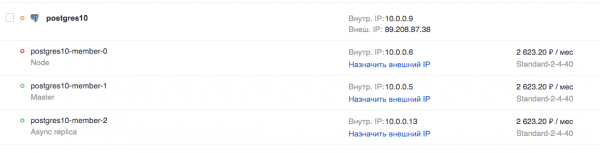
Pendant ce temps, notre application continuait à fonctionner. Bien sûr, un tel basculement d'urgence du maître ne peut pas passer inaperçu.
2019-03-29 10:45:56.071234
Connexion ouverte à PostgreSQL 10.7 sur x86_64-pc-linux-gnu, compilé par gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valeur enregistrée, compte total : 453
Connexion fermée
2019-03-29 10:45:59.205463
Connexion ouverte à PostgreSQL 10.7 sur x86_64-pc-linux-gnu, compilé par gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valeur enregistrée, compte total : 454

Connexion fermée
2019-03-29 10:46:02.661440
Erreur lors de la connexion au serveur PostgreSQL, connexion fermée de manière inattendue
        Cela signifie probablement que le serveur a été arrêté de manière anormale
        avant ou pendant le traitement de la demande.

Erreur attrapée :
 variable locale 'connection' référencée avant l'assignation
……………………………………………………….. - il y a un certain nombre d'erreurs
2019-03-29 10:46:30.930445
Erreur lors de la connexion au serveur PostgreSQL, connexion fermée de manière inattendue
        Cela signifie probablement que le serveur a été arrêté de manière anormale
        avant ou pendant le traitement de la demande.

Erreur attrapée :
 variable locale 'connection' référencée avant l'assignation
2019-03-29 10:46:31.954399
Connexion ouverte à PostgreSQL 10.7 sur x86_64-pc-linux-gnu, compilé par gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valeur enregistrée, compte total : 455
Connexion fermée
2019-03-29 10:46:35.409800
Connexion ouverte à PostgreSQL 10.7 sur x86_64-pc-linux-gnu, compilé par gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valeur enregistrée, compte total : 456
Connexion fermée
^Cexit
Comme on le voit, l'application a pu continuer à fonctionner en moins de 30 secondes. Oui, un certain nombre d'utilisateurs du service verront les problèmes. Cependant, c'est une défaillance sérieuse du serveur, cela n'arrive pas si souvent. De plus, il est peu probable que la personne (administrateur) ait pu réagir aussi rapidement, à moins qu'il ne soit assis devant la console, prêt avec un script de basculement.
Sortie
À mon avis, un tel cluster offre un avantage colossal pour les administrateurs. En effet, des pannes sérieuses et des indisponibilités des serveurs de base de données ne seront pas perceptibles pour l'application et, par conséquent, pour l'utilisateur. Il n'y aura pas besoin de réparer quoi que ce soit à la hâte et de passer à des configurations temporaires, des serveurs, etc. Et si une telle solution est utilisée sous forme de service prêt à l'emploi dans le cloud, il n'y aura pas besoin de perdre du temps sur sa préparation. On pourra se consacrer à quelque chose de plus intéressant.
Source : habr.com
