

Lorsque nous parlons de stéganographie, les gens imaginent des terroristes, des pédophiles, des espions, voire au mieux des crypto-anarchistes et d'autres chercheurs. Et en effet, à qui d'autre cela pourrait-il servir ? de cacher Quel intérêt cela peut-il bien avoir pour un simple citoyen ?
Il s'avère qu'il y en a effectivement un. C'est pourquoi aujourd'hui nous allons compresser des données en utilisant des méthodes de stéganographie. À la fin, le lecteur pourra même utiliser ses précieux archives photo en JPEG pour augmenter l'espace libre sur son système de fichiers.
Quoi ?
Si le lecteur s'en souvient, la stéganographie ce sont ces étranges algorithmes permettant de cacher une information à l'intérieur d'une autre. En d'autres termes : image + fichier = à peu près la même image, mais pas tout à fait (il peut s'agir de n'importe quoi à la place des images, mais c'est généralement plus clair avec elles). En même temps, il ne doit pas y avoir de méthode simple pour déterminer s'il y a quelque chose à l'intérieur ou non.
Mais si l'on ne peut pas faire la différence, y a-t-il vraiment un enjeu ? Du point de vue du consommateur, l'utilisateur ne se soucie pas de la précision mathématique (réfléchie par un ensemble spécifique de bits), seulement de ce qu'il perçoit.
Par exemple, regardons trois images d'un adorable chien :
Attention, JPEG !
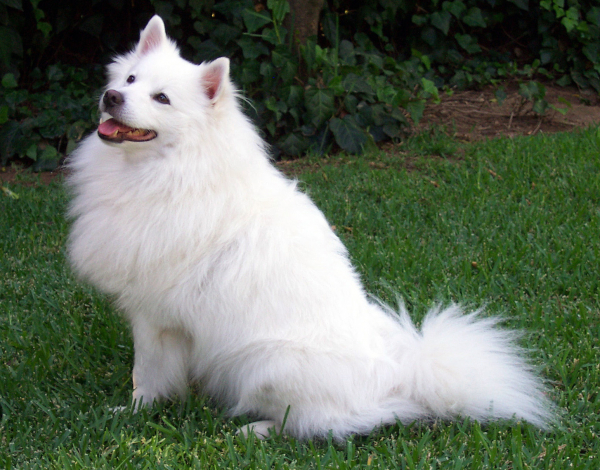
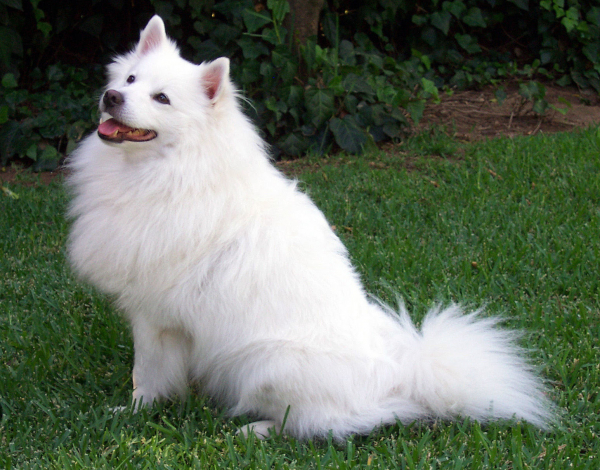
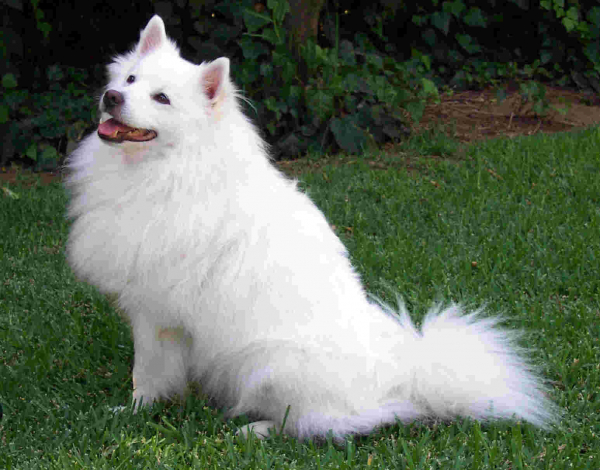
Malgré la différence colossale de taille, peu de gens choisiraient la troisième version. En revanche, la différence entre les deux premières photos n'est pas aussi évidente, et la quantité d'information qu'elles contiennent (à mon avis) peut être considérée comme équivalente.
Ce principe en soi est déjà ancien et exploité depuis de nombreuses années par des méthodes de compression avec perte. Mais détruire n'est pas construire, nous nous intéressons à un aspect plus avancé de la question. Peut-on intégrer des informations supplémentaires d'une taille N dans un fichier de sorte que sa taille augmente de M < N, sans que les modifications soient perceptibles pour l'utilisateur ?
Bien sûr que c'est possible. Mais il convient de faire quelques réserves immédiatement :
- Tout d'abord, la méthode doit être universelle et donner des résultats positifs sur la plupart des données d'entrée. En d'autres termes, en moyenne, pour une entrée quelconque, il devrait y avoir une diminution réelle de la quantité d'information stockée. 'En moyenne' signifie que des cas opposés peuvent se produire, mais ne devraient pas prédominer.
- Deuxièmement, la taille du conteneur compressé avant l'intégration des informations doit être plus grande que celle de sa compression similaire post-modification. Il ne suffit pas d'intégrer dans une image BMP par la méthode LSB une quantité de bits : cela ne constitue pas une compression stéganographique, car, une fois traité par un algorithme DEFLATE, l'image originale sera probablement beaucoup plus petite.
- Troisièmement, il est nécessaire de mener et de comparer le résultat par rapport à des données déjà compressées par des méthodes classiques. Cela permettra d'éliminer l'effet probabiliste des différences de leur redondance et d'effectuer une compression plus efficace dans l'ensemble.
Où ?
L'utilisation de la stéganographie implique que, en plus des informations à compresser, nous aurons besoin de conteneurs dans lesquels elles seront intégrées. La quantité maximale d'informations intégrables dépend largement des propriétés individuelles, mais elle se développe beaucoup plus facilement avec leur nombre. Par conséquent, le format des conteneurs doit être courant, afin que l'utilisateur dispose d'un nombre suffisant pour tirer un minimum d'avantages du processus de "compression".
Dans ce contexte, de bons candidats sont les fichiers graphiques, audio et vidéo. Cependant, en raison de la diversité des différents formats, codecs, etc., il nous reste en pratique un choix limité.
En tenant compte de tout cela, mon choix s'est porté sur le JPEG. Pratiquement tout le monde l'a, il est largement utilisé à la fois à des fins personnelles et professionnelles, et il est presque devenu le format de facto pour la plupart des images.
Quand ?
Suivent des schémas et descriptions techniques sans explications particulières, donc ceux qui le souhaitent peuvent les passer, en faisant défiler jusqu'à la section « Technologies de pointe ».
Caractéristiques générales
Pour intégrer des données quelque part, il faut d'abord déterminer où. Il peut y avoir autant de photographies différentes sur le système de fichiers, parmi lesquelles l'utilisateur peut vouloir n'en utiliser que certaines. Cet ensemble souhaité de conteneurs sera appelé bibliothèque.
Elle se forme dans deux cas : avant la compression et avant la décompression. Dans le premier cas, on peut simplement utiliser un ensemble de noms de fichiers (ou mieux encore, une expression régulière pour eux), mais dans le second cas, quelque chose de plus fiable est nécessaire : l'utilisateur peut les copier et les déplacer au sein du système de fichiers, empêchant ainsi leur identification correcte. Il est donc nécessaire de stocker leurs hachages (un md5 suffira) après toutes les modifications.
La recherche initiale par expression régulière n'a pas de sens à réaliser sur tout le système de fichiers, il suffit d'indiquer un certain répertoire racine. Un fichier d'archive spécial sera également sauvegardé dans ce répertoire, contenant ces hachages ainsi que d'autres métadonnées nécessaires à la restauration ultérieure des informations compressées.
Tout cela est également applicable à toute implémentation de tout algorithme de compression de données par stéganographie. Les processus de compression et de restauration des données peuvent être appelés emballage et déballage.
F5
Maintenant que nous comprenons ce que nous faisons et pourquoi, il reste à décrire l'algorithme pour atteindre cet objectif. Rappelons-nous du processus de codage d'un fichier JPEG (merci à la wiki de la bibliothèque nationale de Bauman) :
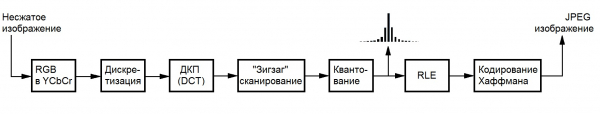
En le regardant, il est préférable de faire tout de suite quelques remarques :
- La taille d'un fichier JPEG peut être considérée comme optimale, même sans essayer de le compresser avec WinRAR ;
- Seule l'information stockée (celle provenant de la transformation en cosinus discrète, DCT) peut être modifiée afin d'assurer une performance acceptable.
- Pour éviter de perdre des données à une échelle visible pour l'utilisateur, il est nécessaire de faire un minimum de modifications sur chaque image individuelle ;
Un ensemble entire d'algorithmes conviendrait à ces conditions, que l'on peut consulter . Le plus avancé d'entre eux est l'algorithme de l'auteur Andreas Westfeld, travaillant avec les coefficients DCT de la composante de luminosité (l'œil humain étant le moins sensible à ses changements). Son schéma général lorsqu'il travaille avec un fichier JPEG existant est illustré par le schéma suivant :
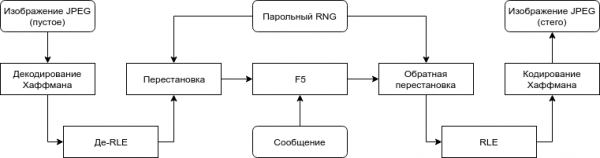
Le bloc F5 utilise une méthode avancée d'insertion basée sur le codage matriciel. Pour plus de détails sur cette méthode et l'algorithme lui-même, le lecteur peut se référer au lien ci-dessus. Ce qui nous intéresse en premier lieu, c'est le fait qu'avec son aide, on peut apporter moins de modifications lors de l'insertion d'une même quantité d'information, d'autant plus que la taille du conteneur utilisé est grande. De plus, pour exécuter l'algorithme, il suffit de procéder à des opérations simples de (dé)codage Huffman et RLE.
Les modifications elles-mêmes portent sur les coefficients entiers et consistent à réduire leur valeur absolue de un, ce qui permet, en théorie, d'utiliser F5 pour la compression des données. En effet, un coefficient réduit par sa valeur absolue occupera probablement moins de bits après le codage Huffman en raison de la distribution statistique des valeurs dans JPEG.
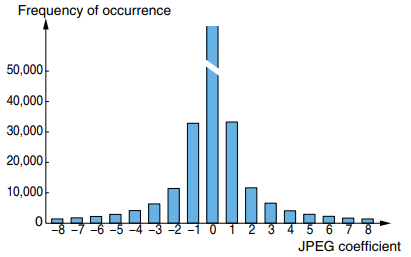
En cas de formation d'un zéro (appelé réduction), la quantité d'information stockée diminuera de sa taille, car l'ancien coefficient autonome deviendra une partie de la séquence RLE codée de zéros :
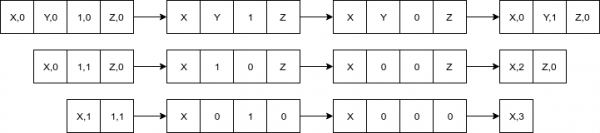
Modifications
La protection des données et leur compression sont des tâches orthogonales, il est donc possible d'ignorer la permutation secrète du mot de passe de l'algorithme original. De plus, nous devons savoir exactement comment extraire les données, c'est pourquoi toutes les informations nécessaires à cet effet (quels conteneurs ont été utilisés, dans quel ordre, etc.) doivent être enregistrées dans un fichier séparé et être accessibles en libre lecture par l'archiveur.
L'algorithme original est conçu pour transmettre des messages secrets, il ne fonctionne donc qu'avec un seul conteneur à la fois, supposant que l'utilisateur fera lui-même le découpage en parties si nécessaire. De plus, pour une insertion indépendante dans chaque conteneur, il est nécessaire de savoir à l'avance combien de bits de données placer dans chacun. Ainsi, les coefficients de chaque élément de la bibliothèque devraient être combinés en un seul grand abstrait et traités selon l'algorithme original.
Étant donné que le F5 original permet d'utiliser jusqu'à 12 % de la taille du conteneur, cette modification augmentera également la capacité maximale : « jusqu'à 12 % » de la taille totale de la bibliothèque est supérieure ou égale à la somme de « jusqu'à 12 % » de chacun de ses éléments.
Le schéma général codifié est le suivant :
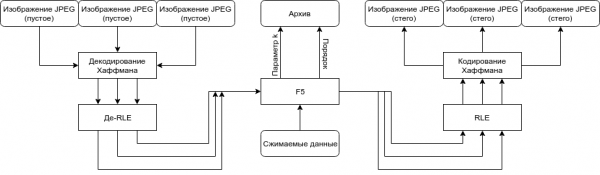
L'algorithme lui-même
Il est temps de décrire l'algorithme de A à Z pour ne pas laisser le lecteur dans l'ignorance :
- L'utilisateur définit les données binaires compressibles M et la bibliothèque L à l'aide d'une expression régulière et d'un répertoire de recherche racine ;
- Dans l'ordre d'apparition dans le FS, les éléments de la bibliothèque forment MC :
- Une série de coefficients C est décodée à partir des données du fichier ;
- MC <- MC | C ;
- Le paramètre k est déterminé à partir de l'inequation terrifiante :
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - On prend successivement
n = (1 << k) - 1les bits de poids faible des éléments non nuls de MC et ils sont écrits dansa:- On calcule la fonction de hachage magique
f, qui mappe un mot de n bitsaen k bitss; - Si
s == 0, alors il n'y a rien à modifier et l'algorithme passe aux coefficients suivants ; - Réduire la valeur absolue du coefficient correspondant au
s-ième bit dans le mota; - Si, à la suite de la réduction, il y a eu une diminution (le coefficient est devenu 0), alors répéter l'étape depuis le début ;
- On calcule la fonction de hachage magique
- Tous les coefficients sont codés en RLE et en Huffman, et écrits dans les fichiers sources ;
- Le paramètre k est écrit dans le fichier d'archive ;
- Pour chaque fichier L, dans l'ordre de leur emplacement d'origine, le hachage MD5 est calculé et écrit dans le fichier d'archive.
Technologies de pointe
La forme naïve de l'algorithme et les implémentations dans d'autres langages de haut niveau (en particulier, avec ramasse-miettes) donneraient de horribles performances, c'est pourquoi j'ai mis en œuvre toutes ces complexités en C pur et effectué plusieurs optimisations tant en rapidité d'exécution qu'en mémoire (vous n'imaginez pas combien ces petites images pèsent sans compression même jusqu'à DCT). Mais même ainsi, initialement, la vitesse d'exécution laissait beaucoup à désirer, donc je ne vais pas décrire tout le processus et les méthodes utilisées.
La portabilité a été atteinte grâce à l'utilisation d'une combinaison des bibliothèques libjpeg, pcre et tinydir, pour cela merci à elles. Par défaut, tout est compilé via un make, c'est pourquoi les utilisateurs de Windows doivent installer un Cygwin ou se débrouiller avec Visual Studio et les bibliothèques eux-mêmes.
La réalisation est disponible sous la forme d'un utilitaire en ligne de commande et d'une bibliothèque. Les intéressés peuvent se référer au fichier readme dans le dépôt GitHub, dont je fournirai le lien à la fin de ce post. Passons maintenant à la description et à la démonstration du fonctionnement.
Comment utiliser?
Avec précaution. Les images utilisées peuvent être déplacées, renommées et copiées à souhait. Cependant, il est impératif de faire preuve d'une extrême vigilance et de ne pas en modifier le contenu. Changer un seul bit entraînera une altération du hash et rendra impossible la récupération des informations.
Supposons qu'après la compilation, nous ayons obtenu un fichier exécutable f5ar. On peut analyser la taille de la bibliothèque pour évaluer ses possibilités d'utilisation avec le drapeau -a: .\/f5ar -a [dossier de recherche] [expression régulière compatible Perl]. L'emballage se fait par la commande .\/f5ar -p [dossier de recherche] [expression régulière compatible Perl] [fichier à empaqueter] [nom de l'archive], et le déballage se fait avec .\/f5ar -u [fichier d'archive] [nom du fichier restauré].
Démonstration de fonctionnement
Pour montrer l'efficacité de la méthode, j'ai téléchargé une collection de 225 photos de chiens totalement gratuites depuis le service . Chacune d'elles possède une qualité légèrement supérieure à celle des photos utilisateur ordinaires, mais néanmoins. Chacune a été réencodée à l'aide de libjpeg, afin d'atténuer l'impact des particularités de l'encodage de la bibliothèque sur la taille totale. Pour signaler le pire exemple de données compressibles, un fichier aléatoire de 36 mètres a été généré avec dd (un peu plus de 5 % de la taille totale), uniformément réparti.
Le processus de test est assez simple :
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Lecture du fichier compressé... ok
Initialisation de l'archive... ok
Analyse de la capacité de la bibliothèque... terminé en 16.8s
Capacité garantie détectée d'environ 48439359 octets
Capacité possible détectée jusqu'à 102618787 octets
Compression... terminée en 32.6s
Sauvegarde de l'archive... ok

$ .\/f5ar -u dogs/dogs.f5ar unpacked
Initialisation de l'archive... ok
Lecture du fichier d'archive... ok
Remplissage de l'archive avec les fichiers... terminé en 1.2s
Décompression... terminée en 17.5s
Écriture des données extraites... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Ou par une capture d'écran pour les amateurs
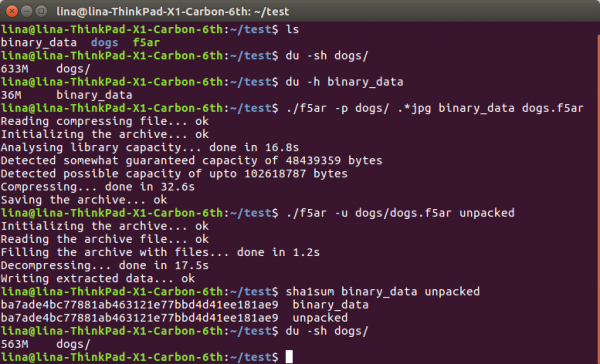
Comme on peut le voir, avec les 633 + 36 == 669 mégaoctets de données sur le disque dur, nous avons abouti à des 563 plus agréables, nous donnant un coefficient de compression d'environ ~1,188. Cette différence radicale s'explique par des pertes très faibles, similaires à celles obtenues lors de l'optimisation des fichiers JPEG par des méthodes classiques (comme tinyjpg). Naturellement, en utilisant la compression stéganographique, les informations ne sont pas simplement "perdues", mais utilisées pour coder d'autres données. De plus, le nombre de coefficients "optimisés" grâce à l'utilisation de F5 est bien moindre que lors de l'optimisation traditionnelle.
Quelles que soient les modifications, elles ne sont absolument pas visibles à l'œil. Sous le spoiler ci-dessous, le lecteur peut évaluer la différence à l'œil nu, ainsi que la valeur obtenue en soustrayant les valeurs de la composante modifiée de l'originale (plus la couleur est atténuée, moins la différence est importante) :
Liens vers des images qui ne sont pas passées sur habrastorage
Original —
Modifié —
Différence —
En conclusion
J'espère avoir réussi à convaincre le lecteur que de telles méthodes sont possibles et ont droit de cité. Néanmoins, acheter un disque dur ou un canal supplémentaire (pour le transfert réseau) peut sembler une solution beaucoup plus simple que d'essayer d'économiser de cette façon. D'un côté, c'est vrai, le développement extensif est souvent plus simple et fiable. Mais d'un autre côté, n'oublions pas l'intensif. Après tout, il n'y a aucune garantie que demain on puisse aller au magasin et acheter un autre disque dur d'un mille téraoctets, alors qu'utiliser ceux qui traînent déjà chez soi, c'est toujours possible.
->
Source : habr.com
