

Contexte
Il s'est avéré qu'un serveur a été attaqué par un virus de ransomware qui, par "un heureux hasard", a partiellement laissé des fichiers .ibd (fichiers de données brutes des tables innodb) intactes, mais a complètement chiffré les fichiers .fpm (fichiers de structure). Ainsi, les .idb pouvaient être classés en :
- recoverables par les moyens et guides standards. Pour de tels cas, il existe d'excellents ;
- tables partiellement chiffrées. Il s'agit principalement de grandes tables, sur lesquelles (d'après ce que j'ai compris), les malfaiteurs n'ont pas eu assez de mémoire vive pour effectuer un chiffrement complet ;
- et des tables complètement chiffrées, qui ne peuvent pas être récupérées.
Déterminer à quel type appartiennent les tables a été possible en ouvrant simplement le fichier dans n'importe quel éditeur de texte avec le bon codage (dans mon cas c'était UTF8) et en vérifiant la présence de champs de texte, par exemple :
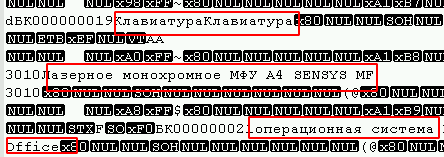
De plus, au début du fichier, on peut observer un grand nombre d'octets nuls, et les virus utilisant un algorithme de chiffrement par blocs (les plus courants) les touchent généralement aussi.

Dans mon cas, les malfaiteurs laissaient à la fin de chaque fichier chiffré une chaîne de 4 octets (1, 0, 0, 0), ce qui a simplifié la tâche. Pour rechercher des fichiers non infectés, un simple script suffisait :
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Ainsi, il a été possible de trouver des fichiers appartenant au premier type. Le second implique un long travail manuel, mais ce qui a été trouvé était déjà suffisant. Tout irait bien, mais il est nécessaire de connaître la structure absolument exacte et (évidemment) il est arrivé qu'il faille travailler avec une table souvent modifiée. Personne ne se souvenait si le type de champ avait changé ou si une nouvelle colonne avait été ajoutée.
Malheureusement, les experts de Debris City n'ont pas pu m'aider dans ce cas, c'est pourquoi cet article est écrit.
Venons-en aux faits
Il existe une structure de table datant de 3 mois qui ne coïncide pas avec celle actuelle (peut-être pour un seul champ, ou peut-être plus). La structure de la table :
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
il faut en extraire :
id_pointINT (11);id_userINT (11);date_débutDATETIME ;date_finDATETIME.
Pour la récupération, une analyse byte par byte du fichier .ibd est utilisée, suivie de sa conversion dans un format plus lisible. Comme il suffit d’analyser des types de données tels que int et datetime pour rechercher ce dont nous avons besoin, cette article ne décrira que ceux-ci, mais il sera parfois fait référence à d'autres types de données qui pourraient aider dans des cas similaires.
Problème 1: dans les champs de types DATETIME et TEXT, il y avait des valeurs NULL, et celles-ci sont simplement ignorées dans le fichier, ce qui a empêché de déterminer la structure pour la récupération dans mon cas. Dans les nouvelles colonnes, la valeur par défaut était nulle, et certaines transactions pouvaient être perdues en raison de la configuration innodb_flush_log_at_trx_commit = 0, donc il aurait fallu plus de temps pour déterminer la structure.
Problème 2: il faut tenir compte du fait que les lignes supprimées via DELETE se trouvent encore dans le fichier ibd, mais lors de l'ALTER TABLE, leur structure ne sera pas mise à jour. En fin de compte, la structure des données peut varier du début à la fin du fichier. Si vous utilisez souvent OPTIMIZE TABLE, vous ne rencontrerez probablement pas ce problème.
Veuillez noter, la version du SGBD influence la façon dont les données sont stockées, et cet exemple peut ne pas fonctionner pour d'autres versions majeures. Dans mon cas, j'ai utilisé la version Windows de mariadb 10.1.24. De plus, bien que vous travailliez avec des tables InnoDB dans mariadb, elles sont en fait , ce qui exclut l'applicabilité de la méthode avec InnoDB mysql.
Analyse du fichier
En python, le type de données affiche les données en unicode au lieu d’un simple ensemble de nombres. Bien qu'il soit possible de considérer le fichier de cette manière, pour plus de commodité, on peut convertir les octets en un format numérique en transformant le tableau d'octets en un tableau normal (list(example_byte_array)). Dans tous les cas, les deux méthodes seront utiles pour l'analyse.
En examinant plusieurs fichiers ibd, on peut rencontrer les suivants :
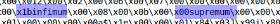
De plus, si l’on divise le fichier par ces mots-clés, on obtient principalement des blocs de données uniformes. Nous utiliserons infimum comme diviseur.
table = table.split("infimum".encode())Observation intéressante, pour les tables avec un petit nombre de données, il existe un indicateur entre infimum et supremum sur le nombre de lignes dans le bloc.
 — table de test avec 1 ligne
 — table de test avec 2 lignes
Le tableau de chaînes table[0] peut être ignoré. Après l'avoir examiné, je n'ai pas réussi à détecter les données brutes des tables. Il est probable que ce bloc serve à stocker des indices et des clés.
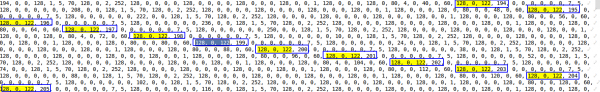
À partir de table[1] et en le convertissant en tableau numérique, on peut déjà constater certaines régularités, à savoir :
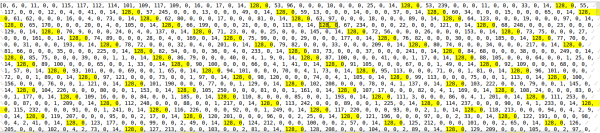
Ce sont des valeurs int stockées sous forme de chaînes. Le premier octet indique si le nombre est positif ou négatif. Dans mon cas, tous les nombres sont positifs. À partir des 3 octets restants, on peut déterminer le nombre en utilisant la fonction suivante. Script :
def find_int(val: str):  # exemple '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Par exemple, 128, 0, 0, 1 = 1, ou 128, 0, 75, 108 = 19308.
La table avait une clé primaire avec auto-incrément, et on peut également la retrouver ici.
En croisant les données des tables de test, il a été révélé que l'objet DATETIME consiste en 5 octets et commence par 153 (qui indique probablement des périodes annuelles). Étant donné que l'intervalle DATTIME est de '1000-01-01' à '9999-12-31', je pense que le nombre d'octets peut varier, mais dans mon cas, les données se situent entre 2016 et 2019, donc on considérera que 5 octets sont suffisants.
Pour déterminer l'heure sans les secondes, les fonctions suivantes ont été écrites. Script :
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Pour l'année et le mois, je n'ai pas réussi à écrire une fonction fonctionnelle, donc j'ai dû coder en dur. Script :
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 / 64 == value[2] / 64:
            return key
    return 0, 0
Je suis sûr que si vous passez un certain temps, cette confusion peut être corrigée.
Ensuite, une fonction qui renvoie un objet datetime à partir d'une chaîne. Script :
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Il a été possible d'identifier des valeurs souvent répétées de int, int, datetime, datetime 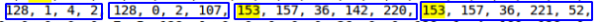 , cela semble être ce dont nous avons besoin. De plus, une telle séquence ne se répète pas deux fois dans la chaîne.
En utilisant une expression régulière, nous extrayons les données nécessaires :
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Notez que lors de la recherche avec cette expression, il ne sera pas possible de déterminer les valeurs NULL dans les champs requis, mais dans mon cas, cela n'est pas critique. Ensuite, dans la boucle, nous parcourons ce qui a été trouvé. Script :
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
En fait, les données du tableau result, ce sont bien les données dont nous avons besoin. ###PS.###
Je comprends que cette méthode ne conviendra pas à tout le monde, mais l'objectif principal de l'article est plutôt d'inciter à l'action que de résoudre tous vos problèmes. Je pense que la solution la plus appropriée serait de commencer à étudier le code source lui-même , mais en raison du temps limité, la méthode actuelle semble être la plus rapide.
Dans certains cas, en analysant le fichier, vous pourrez déterminer la structure approximative et la restaurer par l'une des méthodes standards mentionnées ci-dessus. Cela sera beaucoup plus correct et posera moins de problèmes.
Source : habr.com
