

Bonjour à tous. Je suis administrateur système senior chez OK et je suis responsable du bon fonctionnement du portail. Je souhaite expliquer comment nous avons mis en place un processus de remplacement automatique des disques, puis comment nous avons éliminé l'intervention de l'administrateur de ce processus en le remplaçant par un bot.
Cet article est une sorte de translitération à HighLoad+ 2018
Mise en place du processus de remplacement des disques
D'abord, quelques chiffres
OK est un service géant utilisé par des millions de personnes. Il est géré par environ 7000 serveurs situés dans 4 centres de données différents. Les serveurs contiennent plus de 70 000 disques. Si on les empile, on obtient une tour de plus d'un kilomètre de haut.
Les disques durs sont le composant du serveur qui tombe le plus souvent en panne. À ce niveau, nous devons remplacer environ 30 disques par semaine, et cette procédure est devenue une routine assez désagréable.
Incidents
Dans notre entreprise, un système complet de gestion des incidents a été mis en place. Chaque incident est enregistré dans Jira, puis résolu et analysé. Si un incident a eu un impact sur les utilisateurs, nous nous réunissons forcément pour réfléchir à la manière de réagir plus rapidement dans de tels cas, de minimiser l'impact et bien sûr de prévenir toute récurrence.
Les unités de stockage ne font pas exception. Leur état est surveillé par Zabbix. Nous surveillons les messages dans Syslog pour détecter les erreurs d'écriture/lecture, analysons l'état des RAID HW/SW, et surveillons les informations SMART, en calculant l'usure pour les SSD.
Comment les disques étaient remplacés auparavant
Lorsque Zabbix déclenche un certain avertissement, un incident est créé dans Jira et attribué automatiquement aux ingénieurs concernés dans les centres de données. Nous faisons cela pour tous les incidents matériels, c'est-à-dire ceux qui nécessitent un travail physique sur l'équipement dans le centre de données.
L'ingénieur du centre de données est la personne qui s'occupe des problèmes liés au matériel, responsable de l'installation, de la maintenance et du démontage des serveurs. Dès qu'il reçoit un ticket, l'ingénieur commence à travailler. Dans les baies de disques, il remplace les disques lui-même. Mais s'il n'a pas accès à l'appareil nécessaire, l'ingénieur demande de l'aide aux administrateurs systèmes de garde. Dans un premier temps, il faut retirer le disque de la rotation. Pour cela, des modifications doivent être apportées au serveur, arrêter les applications et démonter le disque.
L'administrateur système de garde est responsable du bon fonctionnement de l'ensemble du portail pendant son service. Il enquête sur les incidents, effectue des réparations et aide les développeurs à accomplir de petites tâches. Il ne s'occupe pas uniquement des disques durs.
Auparavant, les ingénieurs des centres de données communiquaient avec l'administrateur système via un chat. Les ingénieurs envoyaient des liens vers des tickets Jira, l'administrateur les consultait et tenait un journal des travaux dans un bloc-notes. Mais pour ce genre de tâches, les chats sont peu pratiques : l'information y est non structurée et se perd rapidement. De plus, l'administrateur pouvait simplement s'éloigner de l'ordinateur et ne pas répondre aux demandes pendant un certain temps, tandis que l'ingénieur se tenait devant le serveur avec une pile de disques en attendant.
Mais le pire, c'est que les administrateurs ne voyaient pas l'ensemble de la situation : quels incidents de disque existaient, où des problèmes pourraient potentiellement survenir. Cela s'explique par le fait que nous confions tous les incidents HW aux ingénieurs. Oui, il était possible d'afficher tous les incidents sur le tableau de bord de l'administrateur. Mais il y en avait tellement, et l'administrateur n'était impliqué que pour certains d'entre eux.
De plus, l'ingénieur ne pouvait pas correctement établir des priorités, car il ne savait rien sur la destination précise des serveurs, ni sur la répartition des informations sur les supports.
Nouvelle procédure de remplacement
La première chose que nous avons faite, c'est de créer un nouveau type d'incident pour les disques, « HW-disk », et d'y ajouter des champs « nom du périphérique de bloc », « taille » et « type de disque », afin que cette information soit conservée dans le ticket et que nous n'ayons pas à l'échanger constamment dans le chat.
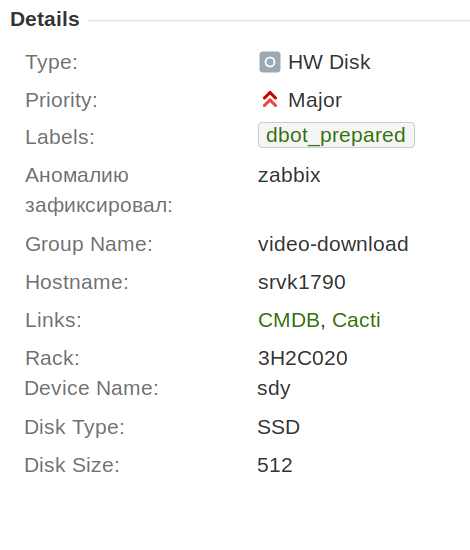
Nous avons également convenu que dans le cadre d'un seul incident, nous ne remplacerions qu'un seul disque. Cela a considérablement simplifié le processus d'automatisation, la collecte de statistiques et le travail par la suite.
En plus de cela, nous avons ajouté un champ « administrateur responsable ». L'administrateur de garde y est automatiquement désigné. C'est très pratique, car l'ingénieur voit toujours qui est responsable. Il n'est pas nécessaire d'aller dans le calendrier pour chercher. C'est ce champ qui a permis de mettre en avant sur le tableau de bord de l'administrateur les tickets pour lesquels son aide pourrait être nécessaire.
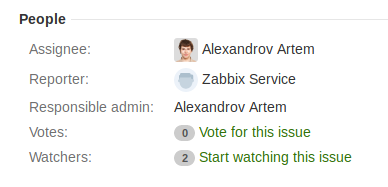
Pour que tous les participants tirent le maximum de bénéfices des innovations, nous avons créé des filtres et des tableaux de bord, et en avons parlé aux équipes. Lorsque les gens comprennent les changements, ils ne s'en éloignent pas comme d'une chose inutile. Il est important pour l'ingénieur de connaître le numéro de rack où se trouve le serveur, la taille et le type de disque. L'administrateur doit, avant tout, comprendre ce qu'est ce groupe de serveurs et quel pourrait être l'effet d'un remplacement de disque.
Avoir des champs et leur affichage est pratique, mais cela ne nous a pas libérés de la nécessité d'utiliser des chats. Nous avons dû changer le flux de travail pour cela.
Auparavant, il était comme ça :
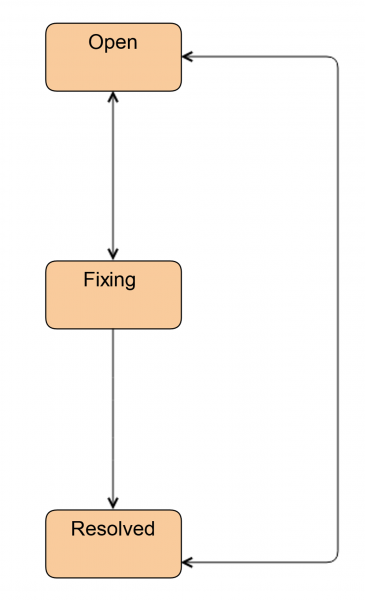
Aujourd'hui, c'est ainsi que continuent de travailler les ingénieurs lorsqu'ils n'ont pas besoin de l'aide de l'administrateur.
La première chose que nous avons faite est d'avoir introduit un nouveau statut Investigate. Ce statut est celui dans lequel le ticket est situé lorsque l'ingénieur n'a pas encore décidé s'il aura besoin d'un administrateur ou non. À travers ce statut, l'ingénieur peut transmettre le ticket à l'administrateur. De plus, nous marquons les tickets dans ce statut lorsque le remplacement du disque est nécessaire, mais que le disque lui-même n'est pas disponible sur le site. Cela peut se produire dans le cas de CDN et de sites distants.
Nous avons également ajouté le statut Prêt. Le ticket passe à ce statut après le remplacement du disque. Cela signifie que tout est déjà fait, mais le HW/SW RAID sur le serveur est en cours de synchronisation. Cela peut prendre assez de temps.
Si un administrateur est impliqué dans le travail, le schéma devient un peu plus compliqué.
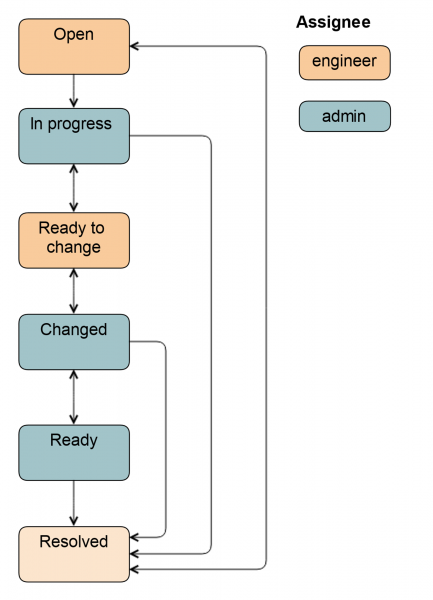
À partir du statut Ouvrir , le ticket peut être transféré à la fois par l'administrateur système et par l'ingénieur. Dans le statut In progress , l'administrateur retire le disque de la rotation pour que l'ingénieur puisse simplement le retirer : il active le voyant, démonte le disque, arrête les applications, en fonction du groupe de serveurs spécifique.
Ensuite, le ticket est transféré à Ready to change: c'est un signal pour l'ingénieur qu'il peut retirer le disque. Tous les champs dans Jira sont déjà remplis, l'ingénieur sait quel type et quelle taille de disque sont nécessaires. Ces données sont renseignées soit automatiquement dans le statut précédent, soit par l'administrateur.
Après le remplacement du disque, le ticket est transféré au statut Changed. On vérifie que le disque approprié a été inséré, une schématisation est effectuée, l'application est lancée et certaines tâches de récupération de données sont réalisées. Le ticket peut également être transféré au statut Prêt, dans ce cas, l'administrateur reste responsable, car c'est lui qui a mis le disque dans la rotation. Le schéma complet ressemble à cela.
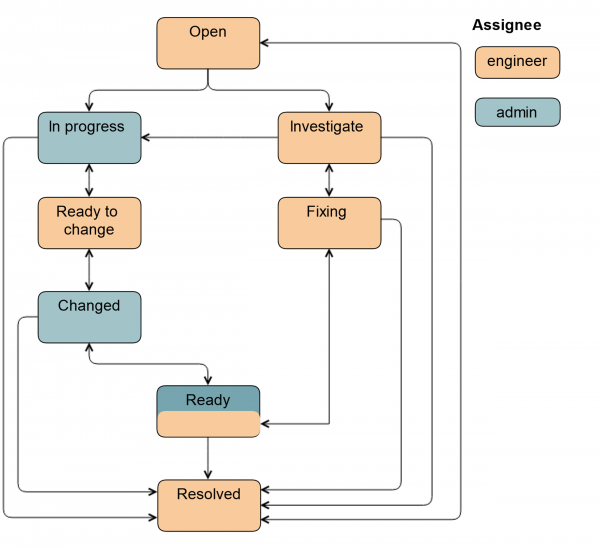
L'ajout de nouveaux champs a considérablement simplifié notre travail. Les équipes commencent à travailler avec des informations structurées, il est devenu clair ce qui doit être fait et à quelle étape. Les priorités sont devenues beaucoup plus pertinentes, car maintenant elles sont définies par l'administrateur.
Nous n'avons plus besoin de discuter dans les chats. Bien sûr, l'administrateur peut envoyer un message à l'ingénieur en disant "il faut remplacer plus rapidement ici", ou "c'est déjà le soir, vas-tu pouvoir remplacer ?". Mais nous ne discutons plus quotidiennement dans les chats à ce sujet.
Les disques sont désormais remplacés par lots. Si l'administrateur arrive un peu plus tôt au travail et qu'il a du temps libre, et qu'aucun incident ne s'est produit, il peut préparer plusieurs serveurs pour le remplacement : marquer les champs, retirer les disques de la rotation et passer la tâche à l'ingénieur. Plus tard, l'ingénieur arrive au centre de données, voit la tâche, prend les disques nécessaires dans le stock et les remplace immédiatement. En conséquence, la vitesse de remplacement a augmenté.
L'expérience acquise lors de la construction du Workflow
- Lors de l'établissement de la procédure, il est nécessaire de collecter des informations provenant de différentes sources.
Certains de nos administrateurs ne savaient pas que les ingénieurs remplacent les disques eux-mêmes. Certains pensaient que la synchronisation du RAID MD était surveillée par les ingénieurs, bien que certains d'entre eux n'avaient même pas accès à cela. Certains ingénieurs principaux le faisaient, mais pas toujours, car le processus n'était décrit nulle part. - La procédure doit être simple et compréhensible.
Il est difficile pour une personne de garder à l'esprit de nombreuses étapes. Les statuts les plus importants dans Jira doivent être affichés sur l'écran principal. On peut les renommer, par exemple, "In progress" peut être appelé "Prêt à changer". Les autres statuts peuvent être cachés dans un menu déroulant pour ne pas être visibles. Mais il est préférable de ne pas restreindre les gens, de leur donner la possibilité de faire la transition.
Expliquez la valeur des innovations. Lorsque les gens comprennent, ils acceptent mieux la nouvelle procédure. Il était très important pour nous que les gens ne cliquent pas sur tout le processus, mais le suivent. Ensuite, nous avons construit l'automatisation sur cette base. - Attendre, analyser, comprendre.
Nous avons mis environ un mois à établir la procédure, la mise en œuvre technique, les réunions et les discussions. Et pour l'implémentation, cela a pris plus de trois mois. J'ai vu comment les gens commencent progressivement à utiliser cette innovation. Au début, il y avait beaucoup de négativité. Mais cela ne dépendait pas du tout de la procédure elle-même, ni de sa mise en œuvre technique. Par exemple, un administrateur utilisait non pas Jira, mais un plugin Jira dans Confluence, et certaines fonctionnalités lui étaient donc inaccessibles. Nous lui avons montré Jira, ce qui a augmenté sa productivité tant sur les tâches générales que sur les remplacements de disques.
Automatisation du remplacement des disques
Nous avons abordé l'automatisation du remplacement des disques plusieurs fois. Nous avions déjà des développements et des scripts, mais ils fonctionnaient soit en mode interactif, soit en mode manuel, nécessitant un démarrage. Ce n'est qu'après l'implémentation de la nouvelle procédure que nous avons compris qu'elle nous manquait vraiment.
Avec le processus de remplacement désormais divisé en étapes, chacune ayant un responsable et une liste d'actions, nous pouvons introduire l'automatisation étape par étape, et non pas en une seule fois. Par exemple, la première étape la plus simple — Ready (vérification de la synchronisation RAID/données) — peut être facilement déléguée à un bot. Une fois que le bot sera un peu formé, nous pourrons lui confier des tâches plus importantes — l'introduction du disque en rotation, etc.
Zoo des configurations
Avant de parler du bot, faisons un petit tour d'horizon de notre zoo d'installations. Tout d'abord, cela est dû à la taille gigantesque de notre infrastructure. Deuxièmement, pour chaque service, nous essayons de choisir la configuration matérielle optimale. Nous avons environ 20 modèles de RAID matériels, principalement LSI et Adaptec, mais on trouve également des modèles HP et DELL de différentes versions. Chaque contrôleur RAID a sa propre utilité de gestion. L'ensemble des commandes et leur sortie peuvent varier de version en version pour chaque contrôleur RAID. Là où le HW-RAID n'est pas utilisé, il peut y avoir du mdraid.
Pratiquement toutes les nouvelles installations sont faites sans redondance de disque. Nous essayons de ne plus utiliser de RAID matériels ou logiciels, car nous sauvegardons nos systèmes au niveau des centres de données, et non des serveurs. Mais bien sûr, il y a beaucoup de serveurs hérités qui doivent être pris en charge.
Dans certains cas, les disques dans les contrôleurs RAID sont connectés en tant que dispositifs bruts, tandis que dans d'autres, le JBOD est utilisé. Il existe des configurations avec un seul disque système dans le serveur, et lorsque celui-ci doit être remplacé, il est nécessaire de redéployer le serveur en installant le système d'exploitation et les applications, et ce avec les mêmes versions. Ensuite, il faut rajouter les fichiers de configuration et lancer les applications. De plus, il y a de nombreux groupes de serveurs où la redondance est effectuée non pas au niveau du système de disques, mais directement dans les applications elles-mêmes.
En tout, nous avons plus de 400 groupes uniques de serveurs, sur lesquels s'exécutent environ 100 applications différentes. Pour couvrir un si grand nombre de variantes, nous avions besoin d'un outil d'automatisation multifonctionnel. Idéalement, avec un DSL simple, afin que même quelqu'un qui ne l'a pas écrit puisse l'utiliser.
Nous avons choisi Ansible car il est sans agent : aucune préparation d'infrastructure n'était nécessaire, ce qui permet un démarrage rapide. De plus, il est écrit en Python, qui est devenu le standard dans l'équipe.
Schéma général
Examinons le schéma général d'automatisation à travers l'exemple d'un incident. Zabbix détecte qu'un disque sdb est défaillant, un déclencheur s'active et un ticket est créé dans Jira. L'administrateur le consulte, comprend qu'il ne s'agit ni d'un doublon ni d'un faux positif, et qu'il faut changer le disque, et il fait passer le ticket à l'état "En cours".
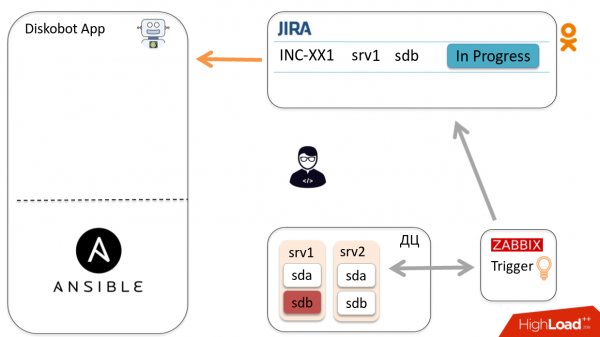
L'application DiskoBot, écrite en Python, interroge périodiquement Jira à la recherche de nouveaux tickets. Elle remarque qu'un nouveau ticket 'En cours' est apparu, un thread correspondant s'active et lance un playbook dans Ansible (cette opération est réalisée pour chaque statut dans Jira). Dans ce cas, le playbook Prepare2change est lancé.
Ansible se connecte à l'hôte, retire le disque de la rotation et rapporte le statut à l'application via des callbacks.
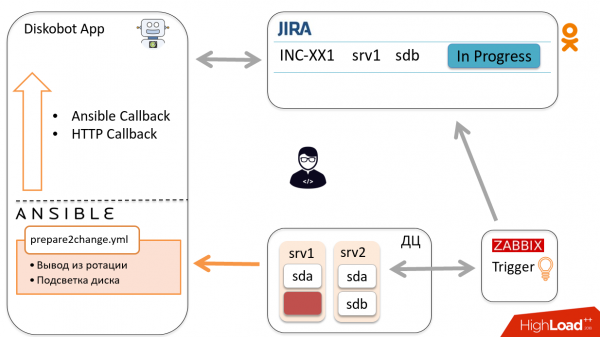
Suite aux résultats, le bot change automatiquement le ticket en "Prêt à changer". L'ingénieur reçoit une notification et se rend au remplacement du disque, puis passe le ticket à l'état "Changé".
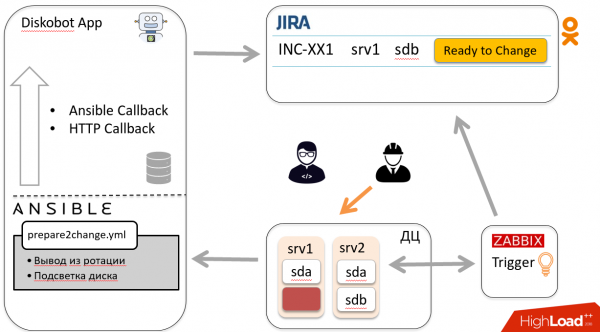
Selon le schéma décrit ci-dessus, le ticket revient au bot, qui lance un autre playbook, accède à l'hôte et réintroduit le disque dans la rotation. Le bot ferme le ticket. Hourra !
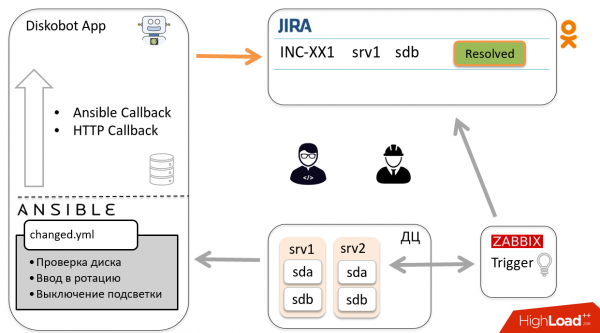
Parlons maintenant de certains composants du système.
Diskobot
Cette application est écrite en Python. Elle sélectionne les tickets de Jira selon le JQL. En fonction du statut du ticket, ce dernier est dirigé vers le gestionnaire approprié, qui à son tour lance le playbook Ansible correspondant au statut.
Le JQL et les intervalles d'interrogation sont définis dans le fichier de configuration de l'application.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Par exemple, parmi les tickets dans le statut In progress, seuls ceux dont les champs Disk size et Device name sont remplis sont sélectionnés. Device name est le nom de l'appareil de stockage nécessaire pour exécuter le playbook. Disk size est nécessaire pour que l'ingénieur sache quelle taille de disque est requise.
De même, parmi les tickets avec le statut Ready, ceux ayant le label dbot_ignore sont filtrés. D'ailleurs, nous utilisons les labels Jira à la fois pour ce genre de filtrage, et pour marquer les tickets en double, ainsi que pour collecter des statistiques.
En cas d'échec du playbook, Jira attribue le label dbot_failed, afin que nous puissions examiner cela ultérieurement.
Interaction avec Ansible
L'application interagit avec Ansible via . Dans playbook_executor, nous passons le nom du fichier et un ensemble de variables. Cela permet de maintenir le projet Ansible sous forme de fichiers yml ordinaires, plutôt que de le décrire dans du code Python.
Également dans Ansible, grâce à *extra_vars*, nous faisons passer le nom de l'appareil de stockage, le statut du ticket, ainsi que l'URL de callback, dans laquelle est cachée la clé de l'incident — elle est utilisée pour le callback en HTTP.
Pour chaque exécution, un inventaire temporaire est généré, composé d'un hôte et d'un groupe auquel cet hôte appartient, afin que les group_vars soient appliqués.
Voici un exemple de tâche, dans laquelle le callback HTTP est implémenté.
Le résultat de l'exécution des playbooks est obtenu grâce à des callbacks. Ils sont de deux types :
- , il fournit des données sur les résultats de l'exécution du playbook. Il décrivit les tâches qui ont été lancées, exécutées avec succès ou échouées. Ce callback est appelé à la fin de l'exécution du playbook.
- Callback HTTP pour obtenir des informations pendant l'exécution du playbook. Dans la tâche Ansible, nous effectuons une requête POST/GET vers notre application.
À travers les callbacks HTTP, des variables définies lors de l'exécution du playbook, que nous souhaitons conserver et utiliser lors de futurs lancements, sont transmises. Ces données sont enregistrées dans sqlite.
Nous laissons également des commentaires et modifions le statut du ticket via le callback HTTP.
Callback HTTP
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Comme beaucoup de tâches similaires, nous l'avons extrait dans un fichier commun et l'incluons au besoin, afin de ne pas le répéter constamment dans les playbooks. Ici, on trouve un callback_url, dans lequel sont intégrés la clé de l'incident et le nom de l'hôte. Lorsque Ansible exécute cette requête POST, le bot comprend qu'elle fait partie d'un tel incident.
Voici un exemple tiré du playbook, où nous avons retiré un disque d'un périphérique MD :
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Cette tâche change le statut du ticket Jira en « Prêt à changer » et ajoute un commentaire. De plus, la variable mdam_data conserve la liste des périphériques md dont le disque a été retiré, tandis que parted_info contient un dump de la partition depuis parted.
Lorsque l'ingénieur insérera un nouveau disque, nous pourrons utiliser ces variables pour restaurer le dump des partitions et également réintroduire le disque dans les périphériques md d'où il a été retiré.
Mode de vérification Ansible
Activer l'automatisation était intimidant. Nous avons donc décidé d'exécuter tous les playbooks en mode
, dans lequel Ansible n'effectue aucune action sur les serveurs, mais les simule seulement.
Cette exécution passe par un module de callback distinct, et le résultat de l'exécution du playbook est enregistré dans Jira sous forme de commentaire.
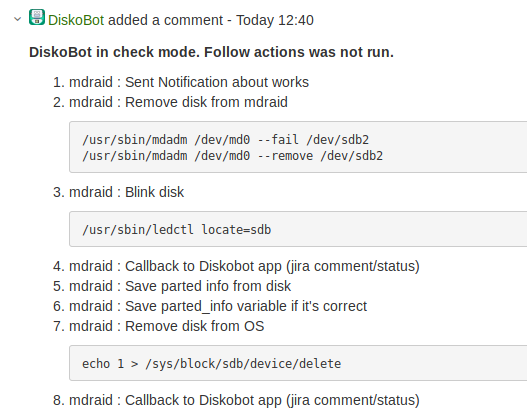
Tout d'abord, cela a permis de valider le fonctionnement du bot et des playbooks. Deuxièmement, cela a accru la confiance des administrateurs envers le bot.
Une fois que nous avons effectué la validation et compris que nous pouvions exécuter Ansible non seulement en mode dry run, nous avons créé dans Jira un bouton Exécuter Diskobot pour exécuter le même playbook avec les mêmes variables sur le même hôte, mais en mode normal.
De plus, le bouton est utilisé pour relancer le playbook en cas d'échec.
Structure des Playbooks
J'ai déjà mentionné qu'en fonction du statut du ticket Jira, le bot exécute différents playbooks.
Tout d'abord, cela permet d'organiser beaucoup plus facilement l'entrée.
Deuxièmement, dans certains cas, c'est tout simplement nécessaire.
Par exemple, lors du remplacement d'un disque système, il faut d'abord aller dans le système de déploiement, créer une tâche, et après un déploiement réussi, le serveur sera accessible par ssh, et il sera possible d'y installer l'application. Si nous devions faire tout cela dans un seul playbook, Ansible ne pourrait pas l'exécuter en raison de l'inaccessibilité de l'hôte.
Nous utilisons des rôles Ansible pour chaque groupe de serveurs. On voit ici comment les playbooks sont organisés dans l'un d'eux.
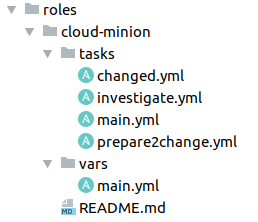
C'est pratique car il est immédiatement clair où se trouvent les différentes tâches. Dans le fichier main.yml, qui sert de point d'entrée pour le rôle Ansible, nous pouvons simplement inclure en fonction du statut du ticket ou des tâches générales nécessaires pour tous, comme le passage par l'identification ou l'obtention d'un jeton.
Investigation.yml
Lancement pour les tickets ayant le statut Investigation et Open. Le plus important pour ce playbook est le nom du dispositif de stockage. Cette information n'est pas toujours disponible.
Pour l'obtenir, nous analysons le résumé Jira, la dernière valeur du déclencheur Zabbix. Il peut contenir le nom du dispositif de stockage - par chance. Sinon, il peut contenir le point de montage, et dans ce cas, il faut aller sur le serveur, le parser et calculer le disque nécessaire. Le déclencheur peut également transmettre une adresse scsi ou une autre information. Mais parfois, il n'y a pas d'indices, et nous devons analyser.
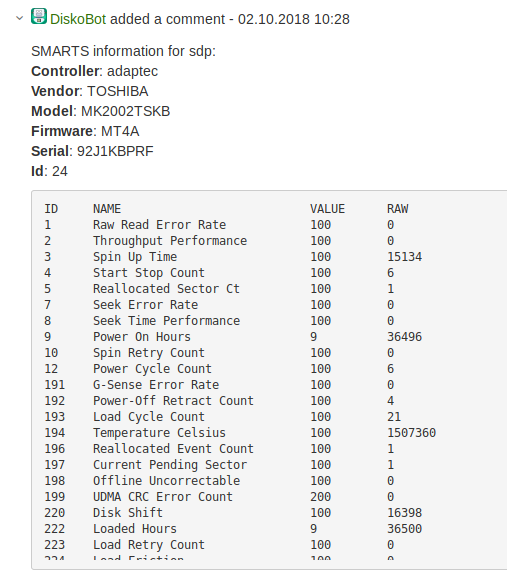
Après avoir identifié le nom du dispositif de stockage, nous collectons des informations sur le type et la taille du disque pour remplir les champs dans Jira. Nous extrayons également les informations sur le fournisseur, le modèle, le firmware, l'ID, SMART, et nous insérons tout cela dans le commentaire du ticket Jira. L'administrateur et l'ingénieur n'ont désormais plus besoin de chercher ces données. 🙂
prepare2change.yml
Retrait du disque de la rotation, préparation au remplacement. C'est l'étape la plus complexe et la plus critique. C'est ici que l'on peut arrêter une application quand elle ne doit pas l'être. Ou retirer un disque qui manquait de réplicas, ce qui affecterait les utilisateurs et entraînerait la perte de données. Ici, nous avons le plus de vérifications et de notifications dans le chat.
Dans le cas le plus simple, il s'agit de retirer un disque d'un RAID HW/MD.
Dans des situations plus complexes (dans nos systèmes de stockage), où la redondance est effectuée au niveau de l'application, il est nécessaire d'accéder à l'application via API, de signaler le retrait du disque, de le désactiver et de lancer la restauration.
Nous sommes actuellement en train de migrer massivement vers , et si le serveur est dans le cloud, Diskobot accède à l'API du cloud, indique qu'il va travailler avec ce minion - le serveur sur lequel les conteneurs sont en cours d'exécution - et demande "migre tous les conteneurs de ce minion". Il active également la mise en surbrillance du disque, afin que l'ingénieur voie immédiatement lequel il doit retirer.
changed.yml
Après le remplacement du disque, nous vérifions d'abord sa disponibilité.
Les ingénieurs ne remplacent pas toujours les nouveaux disques, c'est pourquoi nous avons ajouté une vérification des valeurs SMART qui nous conviennent.
Quels attributs examinons-nousNombre de secteurs réalloués (5) < 100
Nombre de secteurs en attente actuel (107) == 0
Si le disque ne réussit pas le test, l'ingénieur est informé pour un remplacement. Si tout est en ordre, le rétroéclairage s'éteint, le marquage est appliqué et le disque est mis en rotation.
ready.yml
Le cas le plus simple: vérification de la synchronisation HW/SW raid ou fin de la synchronisation des données dans l'application.
API des applications
J'ai mentionné plusieurs fois que le bot accède souvent à l'API des applications. Bien sûr, toutes les applications n'avaient pas les méthodes nécessaires, donc il a fallu les améliorer. Voici les méthodes les plus importantes que nous utilisons:
- Status. Statut du cluster ou du disque pour comprendre s'il peut être utilisé;
- Start/stop. Activation et désactivation du disque;
- Migrate/restore. Migration et restauration des données pendant et après le remplacement.
Leçons tirées d'Ansible
J'aime beaucoup Ansible. Mais souvent, lorsque je regarde différents projets open source et vois comment les gens écrivent des playbooks, cela me fait un peu peur. Des enchevêtrements logiques compliqués de when/loop, manque de flexibilité et d'idempotence en raison d'un usage fréquent de shell/command.
Nous avons décidé de simplifier au maximum en tirant parti de la modularité d'Ansible. Au plus haut niveau se trouvent les playbooks, qui peuvent être écrits par n'importe quel administrateur ou développeur tiers qui connaît un peu Ansible.
- name: Faites clignoter le disque
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Si une certaine logique est difficile à réaliser dans les playbooks, nous la sortons dans un module ou un filtre Ansible. Les scripts peuvent être écrits en Python ou dans n'importe quel autre langage.
Ils sont faciles et rapides à écrire. Par exemple, le module de clignotement du disque, dont l'exemple d'utilisation est donné ci-dessus, se compose de 265 lignes.
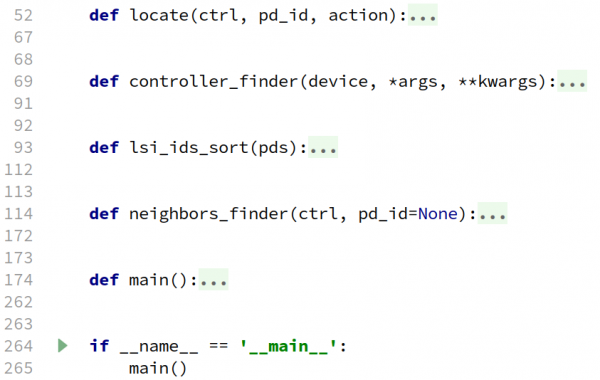
Au niveau le plus bas se trouve la bibliothèque. Pour ce projet, nous avons écrit une application distincte, une sorte d'abstraction sur les RAID matériels et logiciels, qui effectuent les demandes appropriées.
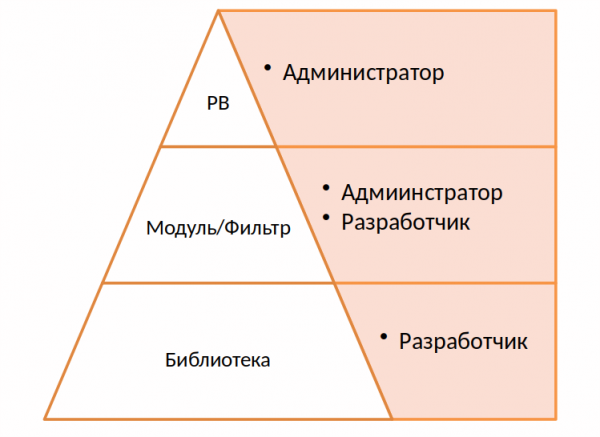
Les points forts d'Ansible sont sa simplicité et ses playbooks clairs. Je pense qu'il faut en profiter et ne pas générer de terribles fichiers yaml avec une énorme quantité de conditions, de code shell et de boucles.
Si vous souhaitez reproduire notre expérience avec l'API Ansible, gardez à l'esprit deux choses:
- Il n'est pas possible de passer un timeout au playbook_executor et au playbook en général. Il existe un timeout pour les sessions ssh, mais pas pour le playbook. Si nous essayons de démonter un disque qui n'existe plus dans le système, le playbook s'exécutera indéfiniment, c'est pourquoi nous avons dû envelopper son lancement dans un wrapper séparé et le terminer par un timeout.
- Ansible fonctionne sur la base de processus fork, donc son API n'est pas thread-safe. Nous exécutons tous nos playbooks en mode mono-thread.
En fin de compte, nous avons réussi à automatiser le remplacement d'environ 80 % des disques. En général, la vitesse de remplacement a doublé. Aujourd'hui, l'administrateur se contente de regarder l'incident et de décider s'il faut remplacer le disque ou non, puis il effectue un seul clic.
Mais maintenant, nous commençons à rencontrer un autre problème : certains nouveaux administrateurs ne savent pas comment remplacer les disques. 🙂
Source : habr.com
