

Nous l'avons fait !
« L'objectif de ce cours est de vous préparer à votre avenir technique. »
 Salut, Habr. Vous vous souvenez de cet article génial (+219, 2588 en favoris, 429k lectures) ?
Eh bien, chez Hamming (oui, oui, lui-même en contrôle et en correction ) il y a tout un , écrit à partir de ses conférences. Nous le traduisons, car le gars sait de quoi il parle.
Ce livre n'est pas seulement sur l'IT, c'est un livre sur le style de pensée des gens incroyablement brillants. « Ce n'est pas simplement un coup de fouet mental; il décrit les conditions qui augmentent les chances de faire un travail exceptionnel. »
Merci à Andrey Pakhomov pour la traduction.
La théorie de l'information a été développée par C.E. Shannon à la fin des années 1940. La direction des Bell Labs insistait pour qu'il l'appelle « théorie de la communication », car c'est un titre beaucoup plus précis. Pour des raisons évidentes, le titre « théorie de l'information » a un impact beaucoup plus fort sur le public, c'est pourquoi Shannon l'a choisi, et c'est celui qui est connu aujourd'hui. Le titre lui-même suggère que la théorie traite de l'information, ce qui la rend importante, alors que nous pénétrons de plus en plus dans l'ère de l'information. Dans ce chapitre, je vais aborder quelques conclusions fondamentales de cette théorie, en présentant des preuves non strictes, mais plutôt des illustrations intuitives de certains énoncés de cette théorie, afin que vous compreniez ce qu'est réellement la « théorie de l'information », comment vous pouvez l'appliquer, et où elle ne s'applique pas.
Tout d'abord, qu'est-ce que « l'information » ? Shannon identifie l'information à l'incertitude. Il a choisi le logarithme négatif de la probabilité d'un événement comme mesure quantitative de l'information que vous obtenez lorsque cet événement avec une probabilité p se produit. Par exemple, si je vous dis qu'il fait brouillard à Los Angeles, alors p est proche de 1, ce qui en gros ne nous donne pas beaucoup d'informations. Mais si je dis qu'il pleut à Monterey en juin, alors ce message comportera de l'incertitude et contiendra plus d'informations. Un événement certain ne contient aucune information, car log 1 = 0.
Arrêtons-nous un peu plus en détail. Shannon pensait que la mesure quantitative de l'information devait être une fonction continue de la probabilité d'un événement p, et pour des événements indépendants, elle devait être additive – la quantité d'information obtenue suite à la réalisation de deux événements indépendants devait être égale à celle obtenue lors de la réalisation d'un événement conjoint. Par exemple, le résultat du lancer d'un dé et d'une pièce de monnaie est généralement considéré comme des événements indépendants. Traduisons ce qui a été dit précédemment en langage mathématique. Si I (p) est la quantité d'information contenue dans un événement ayant une probabilité p, alors, pour un événement conjoint constitué de deux événements indépendants x avec une probabilité p1 et y avec une probabilité p2, nous obtenons
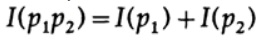
(x et y sont des événements indépendants)
C'est l'équation fonctionnelle de Cauchy, vraie pour tous les p1 et p2. Pour résoudre cette équation fonctionnelle, supposons que
p1 = p2 = p,
cela donne
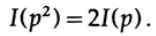
Si p1 = p2 et p2 = p, alors
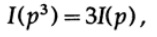
etc. En poursuivant ce processus, en utilisant la méthode standard pour les exponentielles, pour tous les nombres rationnels m/n, il est vrai que
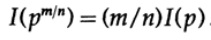
De la continuité supposée de la mesure de l'information, il découle que la fonction logarithmique est la seule solution continue de l'équation fonctionnelle de Cauchy.
Dans la théorie de l'information, il est convenu de prendre la base du logarithme égale à 2, donc un choix binaire contient exactement 1 bit d'information. Par conséquent, l'information est mesurée selon la formule
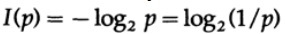
Prenons un moment pour clarifier ce qui s'est passé plus haut. Tout d'abord, nous n'avons toujours pas donné de définition au terme « information », nous avons simplement défini la formule de sa mesure quantifiée.
Deuxièmement, cette mesure dépend de l'incertitude, et bien qu'elle soit suffisamment adaptée aux machines — par exemple, les systèmes téléphoniques, la radio, la télévision, les ordinateurs, etc. — elle ne reflète pas la manière dont un être humain perçoit normalement l'information.
Troisièmement, c'est une mesure relative, elle dépend de l'état actuel de vos connaissances. Si vous regardez un flux de « nombres aléatoires » provenant d'un générateur de nombres aléatoires, vous supposez que chaque nombre suivant est incertain, mais si vous connaissez la formule pour calculer les « nombres aléatoires », le nombre suivant sera connu et, en conséquence, ne contiendra pas d'information.
Ainsi, la définition donnée par Shannon pour l'information convient dans de nombreux cas aux machines, mais ne semble pas correspondre à la compréhension humaine de ce terme. C'est précisément pour cette raison que 'la théorie de l'information' aurait dû être nommée 'la théorie de la communication'. Cependant, il est déjà trop tard pour changer les définitions (qui ont permis à la théorie d'acquérir sa popularité initiale et qui poussent encore les gens à penser que cette théorie traite de 'l'information'), donc nous devons nous en contenter, mais vous devez clairement comprendre à quel point la définition de l'information par Shannon est éloignée de son sens courant. L'information de Shannon traite de quelque chose de complètement différent, à savoir de l'incertitude.
Voilà ce à quoi il faut réfléchir lorsque vous proposez une terminologie. Dans quelle mesure la définition proposée, par exemple, la définition de l'information donnée par Shannon, correspond-elle à votre idée initiale et en quoi diffère-t-elle ? Il n'existe presque aucun terme qui reflète exactement votre vision précédente du concept, mais finalement, c'est la terminologie utilisée qui reflète le sens du concept, donc la formalisation de quelque chose par des définitions claires introduit toujours un certain bruit.
Considérons un système dont l'alphabet est composé de symboles q avec des probabilités pi. Dans ce cas, le nombre moyen d'informations dans le système (sa valeur attendue) est égal à :
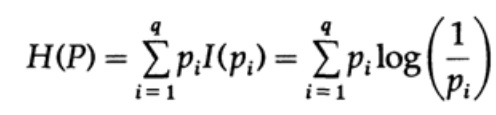
Cela s'appelle l'entropie du système avec une distribution de probabilité {pi}. Nous utilisons le terme 'entropie' parce que la même forme mathématique apparaît en thermodynamique et en mécanique statistique. C'est pourquoi le terme 'entropie' crée autour de lui une certaine aura d'importance, qui, en fin de compte, n'est pas justifiée. La même forme mathématique d'enregistrement ne sous-entend pas une interprétation identique des symboles !
L'entropie de la distribution de probabilité joue un rôle principal dans la théorie du codage. L'inégalité de Gibbs pour deux distributions de probabilité différentes pi et qi est l'une des conséquences importantes de cette théorie. Ainsi, nous devons prouver que
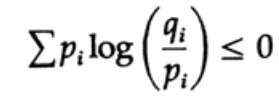
La preuve repose sur un graphique évident, fig. 13.I, qui montre que
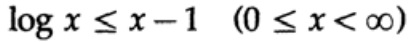
et l'égalité n'est atteinte que pour x = 1. Appliquons l'inégalité à chaque terme de la somme du côté gauche :
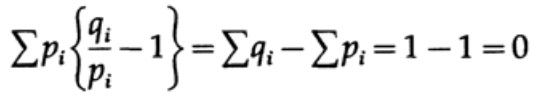
Si l'alphabet du système de communication est composé de q symboles, en supposant la probabilité de transmission de chaque symbole qi = 1/q et en substituant q, nous obtenons de l'inégalité de Gibbs
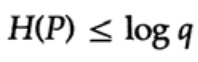
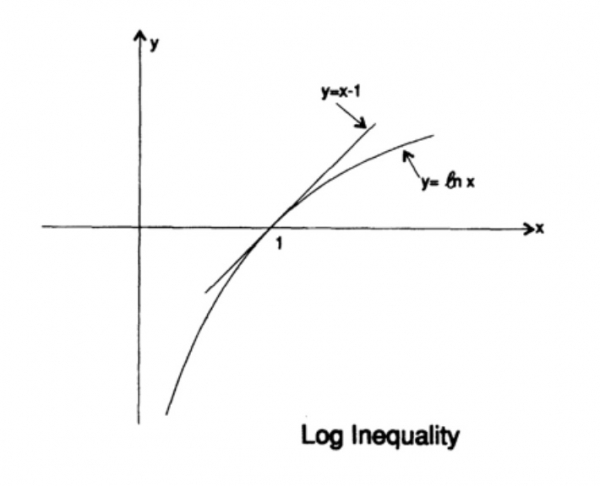
Figure 13.I
Cela signifie que si la probabilité de transmission de tous les q symboles est égale et vaut 1/q, alors l'entropie maximale est ln q, sinon l'inégalité est vérifiée.
Dans le cas d'un code décodable sans ambiguïté, nous avons l'inégalité de Kraft
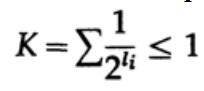
Maintenant, si nous définissons les pseudo-probabilités
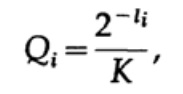
où c'est fini 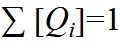 = 1, ce qui découle de l'inégalité de Gibbs,
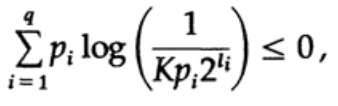
et en appliquant un peu d'algèbre (rappelez-vous que K ≤ 1, donc nous pouvons omettre le terme logarithmique, et éventuellement renforcer l'inégalité plus tard), nous obtendrons
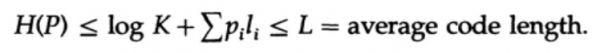
où L est la longueur moyenne du code.
Ainsi, l'entropie constitue une limite inférieure pour tout code symbolique ayant une longueur moyenne de mot-code L. C'est le théorème de Shannon pour un canal sans bruit.
Considérons maintenant le théorème principal sur les contraintes des systèmes de communication où l'information est transmise sous forme de flux de bits indépendants et où du bruit est présent. Il est sous-entendu que la probabilité de transmission correcte d'un bit P > 1/2, et la probabilité que la valeur d'un bit soit inversée lors de la transmission (en cas d'erreur) est Q = 1 - P. Pour simplifier, supposons que les erreurs sont indépendantes et que la probabilité d'erreur est identique pour chaque bit envoyé — c'est-à-dire qu'il y a « bruit blanc » dans le canal de communication.
Le chemin est un long flux de n bits, codés en un seul message — n est une extension dimensionnelle du code unibit. Nous définirons la valeur de n plus tard. Considérons un message composé de n bits comme un point dans un espace à n dimensions. Puisqu'il y a un espace à n dimensions — et pour simplifier, supposons que chaque message a une probabilité d'occurrence identique — il existe M messages possibles (M sera également défini plus tard), par conséquent, la probabilité de tout message justifié est

(émetteur)
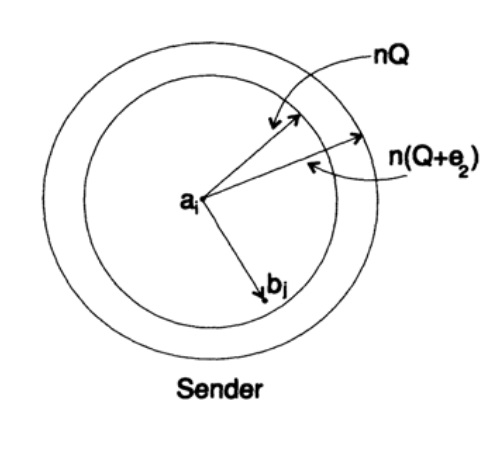
Graphique 13.II
Passons maintenant à l'idée de la bande passante d'un canal. Sans entrer dans les détails, la bande passante d'un canal est définie comme le volume maximum d'informations qui peut être transmis de manière fiable par le canal de communication, en tenant compte de l'utilisation du codage le plus efficace. Il n'y a aucune preuve que plus d'informations puissent être transmises par le canal que sa capacité. Cela peut être prouvé pour un canal symétrique binaire (qui est notre cas). La capacité du canal, lors de l'envoi bit à bit, est donnée par
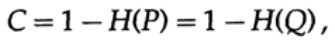
où, comme auparavant, P est la probabilité d'absence d'erreurs pour tout bit envoyé. Lors de l'envoi de n bits indépendants, la capacité du canal est définie comme
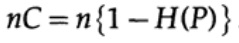
Si nous sommes proches de la bande passante du canal, nous devons envoyer presque autant d'informations pour chacun des symboles ai, i = 1, …, M. Étant donné que la probabilité d'apparition de chaque symbole ai est de 1 / M, nous obtenons
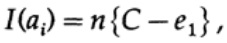
lorsque nous envoyons l'un des M messages également probables ai, nous avons
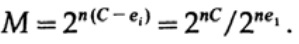
Lors de l'envoi de n bits, nous nous attendons à une incidence de nQ erreurs. En pratique, pour un message constitué de n bits, nous aurons environ nQ erreurs dans le message reçu. Pour de grandes valeurs de n, la variation relative (variation = largeur de la distribution,)
de la distribution du nombre d'erreurs sera de plus en plus étroite avec l'augmentation de n.
Ainsi, du côté de l'émetteur, je prends le message ai à envoyer et dessine une sphère autour de lui avec un rayon
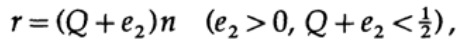
qui est légèrement supérieur à la valeur égale à e2, que le nombre d'erreurs attendu Q, (figure 13.II). Si n est suffisamment grand, il existe une probabilité aussi petite que vous le souhaitez que le point reçu bj du message sorte de cette sphère. Illustrons la situation, telle que je la vois du point de vue de l'émetteur : nous avons tous les rayons allant du message envoyé ai au message reçu bj avec une probabilité d'erreur égale (ou presque égale) à une distribution normale, atteignant son maximum à nQ. Pour toute valeur donnée de e2, il existe un n suffisamment grand, tel que la probabilité que le point reçu bj sorte de ma sphère soit aussi faible que vous le désirez.
Considérons maintenant cette même situation de votre point de vue (fig. 13.III). Du côté du récepteur, il y a une sphère S(r) de même rayon r autour du point reçu bj dans un espace n-dimensionnel, de sorte que si le message reçu bj se trouve à l'intérieur de ma sphère, alors le message que j'ai envoyé ai se trouve à l'intérieur de votre sphère.
Comment peut survenir une erreur ? Une erreur peut se produire dans les cas décrits dans le tableau ci-dessous :
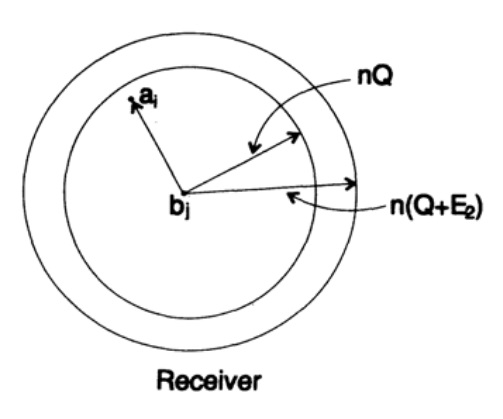
Figure 13.III
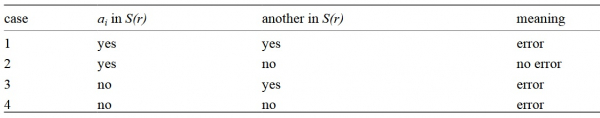
Ici, nous voyons que si dans la sphère construite autour du point reçu il existe au moins un autre point correspondant à un message envoyé non codé possible, alors lors de la transmission une erreur s'est produite, car vous ne pouvez pas déterminer lequel de ces messages a été transmis. Le message envoyé ne contient pas d'erreur seulement si le point qui lui correspond se trouve dans la sphère, et qu'il n'existe pas d'autres points possibles dans ce code qui se trouvent dans la même sphère.
Nous avons une équation mathématique pour la probabilité d'erreur Re, si un message ai a été envoyé.
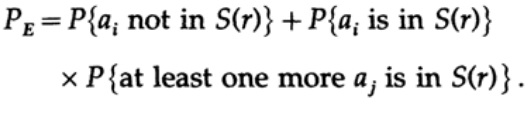
Nous pouvons négliger le premier facteur dans le deuxième terme en le prenant pour 1. Ainsi, nous obtenons l'inégalité.
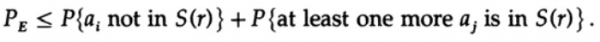
Il est évident que
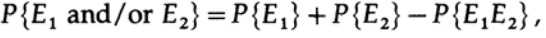
par conséquent
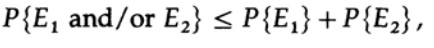
nous l'appliquons de nouveau au dernier terme à droite
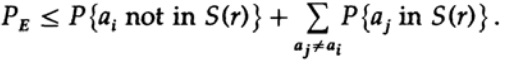
En prenant n suffisamment grand, le premier terme peut être pris aussi petit que souhaité, disons, inférieur à un certain nombre d. Par conséquent, nous avons
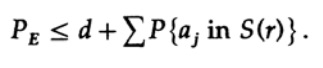
Considérons maintenant comment construire un code de substitution simple pour coder M messages, composés de n bits. Ne sachant pas comment exactement construire le code (les codes de correction d'erreurs n'avaient pas encore été inventés), Shannon a choisi le codage aléatoire. Lancez une pièce pour chacun des n bits dans le message et répétez le processus pour M messages. En tout, il faut effectuer nM lancers de pièce, donc il est possible d'avoir

des dictionnaires de code, ayant une probabilité identique de ½nM. Bien sûr, le processus aléatoire de création d'un dictionnaire de code signifie qu'il existe une probabilité d'apparition de doublons, ainsi que de points de code qui seront proches les uns des autres et, par conséquent, seront une source d'erreurs probables. Il faut démontrer que si cela ne se produit pas avec une probabilité supérieure à tout petit niveau d'erreur choisi, alors n est suffisamment grand.
Le point décisif est que Shannon a moyenné tous les livres de codes possibles pour trouver l'erreur moyenne ! Nous allons utiliser le symbole Av [.] pour désigner la valeur moyenne à partir d'un ensemble de tous les dictionnaires de codes aléatoires possibles. La moyenne selon la constante d, bien sûr, donne une constante, car pour la moyenne, chaque terme correspond à n'importe quel autre terme dans la somme,
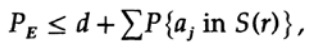
qui peut être augmenté (M–1 devient M )
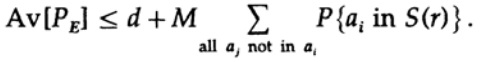
Pour un message donné, en moyennant tous les livres de codes, le codage passe par toutes les valeurs possibles, donc la probabilité moyenne que le point soit dans la sphère est le rapport du volume de la sphère au volume total de l'espace. Le volume de la sphère est à ce moment-là
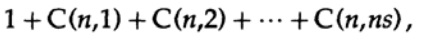
où s=Q+e2 <1/2 et ns doit être un entier.
Le dernier terme à droite est le plus grand dans cette somme. D'abord, estimons sa valeur à l'aide de la formule de Stirling pour les factorielles. Ensuite, nous examinerons le coefficient de diminution du terme qui le précède, notez que ce coefficient augmente en se déplaçant à gauche, et donc nous pouvons : (1) borner la valeur de la somme par la somme d'une progression géométrique avec ce coefficient initial, (2) étendre la progression géométrique avec ns termes à un nombre infini de termes, (3) calculer la somme de la progression géométrique infinie (algèbre standard, rien de substantiel) et finalement obtenir la limite (pour un n suffisamment grand) :
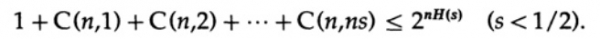
Remarquez comment l'entropie H(s) est apparue dans l'identité binomiale. Notez que le développement en série de Taylor H(s)=H(Q+e2) donne une estimation obtenue en ne tenant compte que de la première dérivée et en ignorant toutes les autres. Rassemblons maintenant l'expression finale :
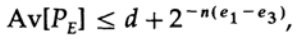
où
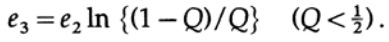
Tout ce que nous devons faire, c'est choisir e2, de sorte que e3 < e1, et alors le dernier terme sera arbitrament petit, pour un n suffisamment grand. Par conséquent, l'erreur moyenne PE peut être rendue arbitrairement petite en ayant une capacité de canal aussi proche que possible de C.
Si la moyenne des valeurs de tous les codes a une erreur suffisamment faible, alors au moins un code doit être approprié, ce qui implique qu'il existe au moins un système de codage adapté. C'est un résultat important obtenu par Shannon - la « théorème de Shannon pour les canaux avec bruit », bien qu'il soit à noter qu'il l'a prouvé pour un cas beaucoup plus général que pour le simple canal symétrique binaire que j'ai utilisé. Pour le cas général, les démonstrations mathématiques sont beaucoup plus complexes, mais les idées ne sont pas tellement différentes, donc très souvent, en prenant des exemples de cas particuliers, on peut révéler la véritable signification du théorème.
Critiquons le résultat. Nous avons répété à maintes reprises : « Pour des n suffisamment grands ». Mais quelle est une valeur n suffisamment grande ? Très, très grande, si vous voulez réellement être à la fois proche de la capacité du canal et vous assurer de la transmission correcte des données ! Tellement grande que, de fait, vous serez contraint d'attendre très longtemps pour accumuler un message de cette quantité de bits afin de pouvoir ensuite le coder. De plus, la taille du dictionnaire de code aléatoire sera tout simplement énorme (car un tel dictionnaire ne peut pas être exprimé de manière plus concise que la liste complète de tous les Mn bits, étant donné que n et M sont très grands) !
Les codes de correction d'erreurs évitent d'attendre un message très long, avec son codage et décodage ultérieurs à travers des livres de codes très volumineux, car ils fuguent ces livres de codes en utilisant à la place des calculs ordinaires. En théorie simple, de tels codes perdent généralement la capacité de se rapprocher de la capacité du canal tout en maintenant un taux d'erreur suffisamment bas, mais lorsque le code corrige un grand nombre d'erreurs, ils montrent de bons résultats. En d'autres termes, si vous réservez une certaine capacité de canal pour la correction d'erreurs, vous devez utiliser cette capacité de correction d'erreur la plupart du temps, c'est-à-dire qu'un grand nombre d'erreurs devraient être corrigées dans chaque message envoyé, sinon vous perdez cette capacité inutilement.
Cependant, le théorème prouvé ci-dessus n'est pas dénué de sens ! Il montre que les systèmes de transmission efficaces doivent utiliser des schémas de codage bien pensés pour de très longues chaînes de bits. Par exemple, les satellites qui ont quitté les planètes externes doivent corriger un nombre croissant d'erreurs dans les blocs de données à mesure qu'ils s'éloignent de la Terre et du Soleil : certains satellites utilisent des panneaux solaires fournissant environ 5 W, d'autres utilisent des sources d'énergie atomiques fournissant à peu près la même puissance. La faible puissance de la source d'énergie, la petite taille des antennes émettrices et des antennes réceptrices sur Terre, ainsi que la grande distance que le signal doit parcourir, exigent tous l'utilisation de codes à haut niveau de correction d'erreurs pour construire un système de communication efficace.
Revenons à l'espace n-dimensionnel que nous avons utilisé dans la preuve ci-dessus. En en discutant, nous avons montré que presque tout le volume de la sphère est concentré autour de la surface externe, de sorte qu'il est presque certain que le signal envoyé se situera à la surface de la sphère construite autour du signal reçu, même pour un rayon relativement petit de cette sphère. Il n'est donc pas surprenant que le signal reçu, après correction d'un nombre arbitrairement élevé d'erreurs, nQ, soit aussi proche que l'on souhaite du signal sans erreurs. La capacité du canal de communication que nous avons examinée précédemment est la clé pour comprendre ce phénomène. Notez que de telles sphères, construites pour les codes de Hamming avec correction d'erreurs, ne se chevauchent pas. Un grand nombre de dimensions pratiquement orthogonales dans l'espace n-dimensionnel montre pourquoi nous pouvons placer M sphères dans l'espace avec un petit chevauchement. Si l'on autorise un petit chevauchement, aussi petit soit-il, qui ne peut entraîner qu'un petit nombre d'erreurs lors du décodage, on peut obtenir un agencement dense de sphères dans l'espace. Hamming garantissait un certain niveau de correction d'erreurs, Shannon une faible probabilité d'erreur, tout en préservant la capacité réelle aussi proche que possible de la capacité du canal de communication, ce que les codes de Hamming ne peuvent pas faire.
La théorie de l'information ne précise pas comment concevoir un système efficace, mais elle indique une direction vers des systèmes de communication efficaces. C'est un outil précieux pour établir des systèmes de communication entre machines, mais, comme mentionné précédemment, elle n'a pas de lien particulier avec la façon dont les gens échangent des informations entre eux. Le degré auquel l'héritage biologique ressemble aux systèmes de communication techniques est tout simplement inconnu, donc à l'heure actuelle, il n'est pas clair dans quelle mesure la théorie de l'information est applicable aux gènes. Il ne nous reste qu'à essayer, et si le succès révèle un caractère machinique de ce phénomène, l'échec mettra en évidence d'autres aspects significatifs de la nature de l'information.
Prenons un petit moment pour nous éloigner du sujet. Nous avons vu que toutes les définitions initiales, dans une certaine mesure, doivent exprimer l'essence de nos croyances fondamentales, mais elles présentent un certain degré de distorsion, et par conséquent, elles se révèlent inapplicables. Traditionnellement, il est admis que, en fin de compte, la définition que nous utilisons détermine en réalité l'essence ; mais cela ne fait que nous indiquer comment traiter les choses et ne nous apporte en aucun cas de sens. L'approche postulationnelle, si fortement approuvée dans les cercles mathématiques, laisse à désirer dans la pratique.
Nous allons maintenant examiner un exemple de tests de QI, où la définition est aussi cyclique que vous le souhaitez, et cela peut vous induire en erreur. Un test est créé, censé mesurer l'intelligence. Par la suite, il est révisé pour être aussi cohérent que possible, puis publié et calibré par un moyen simple afin que l' « intelligence » mesurée soit normalement distribuée (bien sûr selon la courbe de calibration). Toutes les définitions doivent être vérifiées, non seulement lorsqu'elles sont d'abord proposées, mais aussi bien plus tard lorsqu'elles sont utilisées dans les conclusions tirées. Dans quelle mesure les limites des définitions conviennent-elles à la tâche à accomplir ? À quelle fréquence les définitions fournies dans certaines conditions commencent-elles à être appliquées dans des conditions suffisamment différentes ? Cela arrive assez souvent ! Dans les sciences humaines, que vous rencontrerez inévitablement dans votre vie, cela se produit fréquemment.
Ainsi, l'un des objectifs de cette présentation sur la théorie de l'information, en plus de démontrer son utilité, était de vous avertir de ce danger, ou de démontrer comment l'utiliser pour obtenir le résultat souhaité. Il a été remarqué depuis longtemps que les définitions initiales conditionnent fortement ce que vous trouvez finalement, beaucoup plus que cela ne semble. Les définitions initiales exigent une grande attention de votre part, non seulement dans chaque nouvelle situation, mais aussi dans les domaines avec lesquels vous travaillez depuis longtemps. Cela vous permettra de comprendre dans quelle mesure les résultats obtenus sont une tautologie plutôt que quelque chose d'utile.
Une histoire célèbre d'Eddington raconte des personnes qui pêchaient en mer avec un filet. En étudiant la taille des poissons qu'ils avaient attrapés, ils ont déterminé la taille minimale des poissons présents dans la mer ! Leur conclusion était conditionnée par l'outil utilisé, et non par la réalité.
À suivre...
Qui veut aider avec la traduction, la mise en page et l'édition du livre — contactez-moi en privé ou par e-mail à magisterludi2016@yandex.ru
Au fait, nous avons aussi lancé la traduction d'un autre livre génial — )
Nous recherchons particulièrement ceux qui peuvent aider à traduire . (nous traduisons 10 minutes, les 20 premières ont déjà été prises)
Contenu du livre et chapitres traduits
- Intro à The Art of Doing Science and Engineering: Learning to Learn (28 mars 1995)
- « Foundations of the Digital (Discrete) Revolution » (30 mars 1995)
- «Histoire des ordinateurs — Matériel» (31 mars 1995)
- «Histoire des ordinateurs — Logiciel» (4 avril 1995)
- «Histoire des ordinateurs — Applications» (6 avril 1995)
- «Intelligence artificielle — Partie I» (7 avril 1995)
- «Intelligence artificielle — Partie II» (11 avril 1995)
- «Intelligence artificielle III» (13 avril 1995)
- «Espace n-dimensionnel» (14 avril 1995)
- «Théorie de l'information — La représentation de l'information, Partie I» (18 avril 1995)
- «Théorie de l'information — La représentation de l'information, Partie II» (20 avril 1995)
- «Codes de correction d'erreurs» (21 avril 1995)
- «Théorie de l'information» (25 avril 1995)
- «Filtres numériques, Partie I» (27 avril 1995)
- «Filtres numériques, Partie II» (28 avril 1995)
- «Filtres numériques, Partie III» (2 mai 1995)
- «Filtres numériques, Partie IV» (4 mai 1995)
- «Simulation, Partie I» (5 mai 1995)
- «Simulation, Partie II» (9 mai 1995)
- «Simulation, Partie III» (11 mai 1995)
- «Fibres optiques» (12 mai 1995)
- «Enseignement assisté par ordinateur» (16 mai 1995)
- «Mathématiques» (18 mai 1995)
- «Mécanique quantique» (19 mai 1995)
- «Créativité» (23 mai 1995). Traduction :
- «Experts» (25 mai 1995)
- «Données peu fiables» (26 mai 1995)
- «Ingénierie des systèmes» (30 mai 1995)
- «Vous obtenez ce que vous mesurez» (1er juin 1995)
- (2 juin 1995) nous traduisons par morceaux de 10 minutes
- Hamming, «Vous et votre recherche» (6 juin 1995).
Qui veut aider avec la traduction, la mise en page et l'édition du livre — contactez-moi en privé ou par e-mail à magisterludi2016@yandex.ru
Source : habr.com
