

Aujourd'hui, le service « Bitrix24 » ne dispose pas de centaines de gigabits de trafic, ni d'un vaste parc de serveurs (bien qu'il y en ait, bien sûr, un certain nombre). Mais pour de nombreux clients, c'est l'outil principal de travail dans l'entreprise, une application réellement critique pour le business. Donc, des pannes — ce n'est absolument pas possible. Mais que se passe-t-il si une panne survient, mais que le service « ressuscite » si rapidement que personne ne s'en aperçoit ? Et comment réussir à réaliser un failover sans perte de qualité de service ni de clients ? Alexandre Demidov, directeur des services cloud de « Bitrix24 », a expliqué sur notre blog comment le système de sauvegarde a évolué au cours des 7 années d'existence du produit.
Nous avons lancé « Bitrix24 » sous forme de SaaS il y a 7 ans. La principale difficulté, sans doute, était la suivante : avant de le lancer au public sous forme de SaaS, ce produit existait simplement en tant que solution box. Les clients l'achetaient chez nous, l'installaient sur leurs propres serveurs, lançaient un portail d'entreprise — une solution globale pour la communication des employés, le stockage de fichiers, la gestion des tâches, le CRM, tout cela. Et nous avons décidé en 2012 que nous voulions le lancer en tant que SaaS, en gérant nous-mêmes, en garantissant la tolérance aux pannes et la fiabilité. Nous avons acquis de l'expérience en cours de route, parce qu'auparavant, nous n'en avions tout simplement pas — nous n'étions que des fabricants de logiciels, pas des fournisseurs de services.
En lançant le service, nous savions que le plus important était d'assurer la tolérance aux pannes, la fiabilité et la disponibilité constante du service, car si vous avez un site web ordinaire, un magasin par exemple, qui tombe pendant une heure — vous êtes le seul à en souffrir, vous perdez des commandes, vous perdez des clients, mais pour le client lui-même — cela ne lui importe pas beaucoup. Il est bien sûr déçu, mais il va et achète sur un autre site. En revanche, si c'est une application sur laquelle repose tout le travail de l'entreprise, la communication, les décisions, la chose la plus essentielle est de gagner la confiance des utilisateurs, c'est-à-dire de ne pas les décevoir et de ne pas tomber. Parce que tout le travail peut être paralysé si quelque chose à l'intérieur ne fonctionne pas.
Bitrix24 en tant que SaaS
Nous avons assemblé le premier prototype un an avant le lancement public, en 2011. Nous l'avons construit en environ une semaine, l'avons examiné et testé — il fonctionnait même. Autrement dit, on pouvait accéder au formulaire, y entrer le nom du portail, un nouveau portail se déployait, une base d'utilisateurs était créée. Nous l'avons examiné, évalué le produit dans son ensemble, puis nous avons mis un an à le peaufiner. Car nous avions un grand objectif : nous ne voulions pas créer deux bases de code distinctes, nous ne voulions pas maintenir un produit sur site séparément des solutions cloud, — nous voulions faire tout cela dans le cadre d'un seul code.
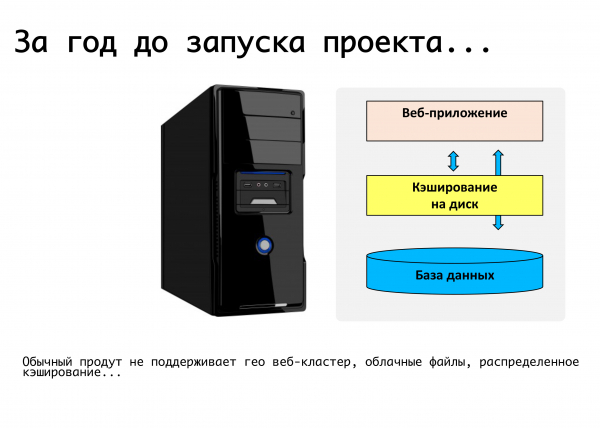
Une application web typique à l'époque consistait en un seul serveur, sur lequel tournait un code php, une base mysql, les fichiers étaient téléchargés, des documents, des images étaient placés dans un dossier upload – et tout cela fonctionnait. Malheureusement, il est impossible de lancer un service web critique sur cette base. La mise en cache distribuée n'est pas prise en charge, la réplication des bases de données n'est pas non plus supportée.
Nous avons formulé les exigences : il s'agit de la capacité à se déployer dans différents emplacements, à prendre en charge la réplication, et idéalement à être réparti dans différents centres de données géographiquement dispersés. Séparer la logique du produit et, en propre, le stockage des données. Être capable de se mettre à l'échelle dynamiquement selon la charge, et même sortir la partie statique. De ces considérations sont nées les exigences du produit que nous avons finalement développé tout au long de l'année. Au cours de cette période, dans la plateforme, qui est devenue unique — pour les solutions sur site, pour notre propre service — nous avons mis en place le support des éléments nécessaires. Le support de la réplication mysql au niveau même du produit : c'est-à-dire que le développeur, qui écrit le code — ne doit pas se préoccuper de la façon dont ses requêtes sont réparties, il utilise notre api, et nous savons bien répartir les requêtes d'écriture et de lecture entre les masters et les slaves.
Nous avons mis en place un support au niveau du produit pour différents systèmes de stockage d'objets cloud : Google Storage, Amazon S3 — en plus, le support d'OpenStack Swift. Cela a donc été pratique tant pour nous en tant que service, que pour les développeurs qui travaillent avec la solution sur site : s'ils utilisent simplement notre api pour travailler, ils ne se préoccupent pas de l'endroit où le fichier final sera stocké, que ce soit localement sur le système de fichiers ou s'il ira dans un stockage d'objets.
Au final, nous avons immédiatement décidé de nous réserver au niveau d'un centre de données entier. En 2012, nous avons entièrement démarré sur Amazon AWS, car nous avions déjà de l'expérience avec cette plateforme - notre propre site y était hébergé. Ce qui nous attirait, c'était que dans chaque région d'Amazon, il existe plusieurs zones de disponibilité - en gros, (dans leur terminologie) plusieurs centres de données, qui sont plus ou moins indépendants les uns des autres et nous permettent de nous réserver au niveau d'un centre de données entier : si celui-ci venait à tomber en panne, les bases sont répliquées en master-master, les serveurs d'applications web sont réservés, et la partie statique est stockée dans un espace de stockage objet s3. La charge est équilibrée - à l'époque, c'était avec l'elb d'Amazon, mais un peu plus tard, nous sommes passés à nos propres équilibreurs de charge, car nous avions besoin d'une logique plus complexe.
Ce que nous voulions, nous l'avons eu...
Toutes les choses de base que nous voulions assurer - la résilience des serveurs eux-mêmes, des applications web, des bases de données - tout fonctionnait bien. Le scénario le plus simple : si l'une de nos applications web tombe en panne, tout est simple - elles sont retirées de l'équilibrage.
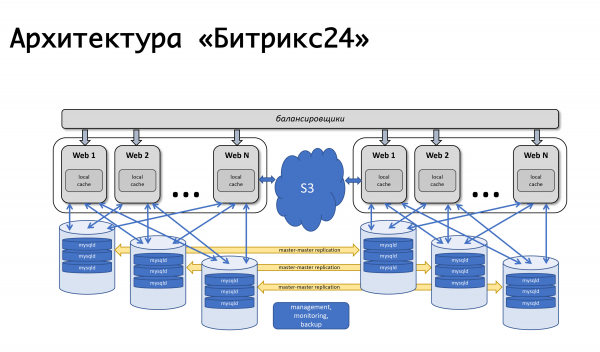
Les machines en panne étaient marquées par l'équilibreur de charge (à l'époque, c'était l'elb d'Amazon) comme unhealthy, et la distribution de la charge était arrêtée. L'autoscaling d'Amazon fonctionnait : lorsque la charge augmentait, de nouvelles machines étaient ajoutées au groupe d'autoscaling, et la charge était répartie sur ces nouvelles machines - tout était bien. Avec nos équilibreurs, la logique est à peu près la même : si quelque chose arrive au serveur d'applications, nous retirons les requêtes, éliminons ces machines, lançons de nouvelles et continuons à travailler. Le schéma a légèrement évolué au fil des ans, mais il continue de fonctionner : il est simple, clair, et sans complications.
Nous travaillons partout dans le monde, les pics de charge des clients sont absolument différents, et, en toute honnêteté, nous devons avoir la possibilité d'effectuer des opérations de maintenance sur n'importe quel composant de notre système à tout moment - sans que les clients ne s'en aperçoivent. C'est pourquoi nous avons la possibilité de mettre hors ligne la base de données, tout en redistribuant la charge sur le deuxième centre de données.
Comment tout cela fonctionne-t-il ? — Nous redirigeons le trafic vers un centre de données opérationnel : si c'est une défaillance du centre de données, cela se fait entièrement ; si ce sont nos travaux planifiés sur une base particulière, nous redirigeons une partie du trafic de ces clients vers le second centre de données, tout en suspendant la réplication. Si de nouvelles machines sont nécessaires pour les applications web en raison de l'augmentation de la charge sur le deuxième centre de données, elles démarrent automatiquement. Les travaux sont terminés, la réplication est rétablie et nous ramenons toute la charge. Si nous devons effectuer des travaux simultanés dans le deuxième DC, par exemple, installer des mises à jour système ou modifier les paramètres dans la deuxième base de données, nous faisons essentiellement la même chose, mais dans l'autre sens. En cas de défaillance, nous agissons simplement : dans le système de surveillance, nous utilisons le mécanisme des event-handlers. Si plusieurs vérifications échouent et que le statut passe à critique, ce handler s'active, celui qui peut exécuter une logique spécifique. Pour chaque base, nous avons spécifié quel serveur est le failover pour elle, et où rediriger le trafic en cas d'indisponibilité. Nous avons, par tradition, utilisé Nagios ou ses variantes. En principe, de tels mécanismes existent dans presque tous les systèmes de surveillance ; pour l'instant, nous n'utilisons rien de plus complexe, mais cela pourrait évoluer un jour. Actuellement, la surveillance se déclenche en cas d'indisponibilité et peut rediriger quelque chose.
Avons-nous tout réservé ?
Nous avons de nombreux clients aux États-Unis, beaucoup de clients en Europe, et beaucoup de clients plus proches de l'Est — au Japon, à Singapour, etc. Bien sûr, une grande part des clients se trouve en Russie. Cela signifie que nous travaillons dans plusieurs régions. Les utilisateurs souhaitent une réponse rapide, il y a des exigences en matière de conformité avec diverses lois locales, et dans chaque région, nous prévoyons deux centres de données, ainsi que d'autres services qui, encore une fois, sont pratiques à placer au sein d'une même région — pour les clients qui exercent leurs activités dans cette région. Les gestionnaires REST et les serveurs d'autorisation sont moins critiques pour le fonctionnement global du client, il est donc possible de basculer avec un léger délai acceptable. Cependant, nous ne voulons pas réinventer la roue concernant leur surveillance et leur gestion. C'est pourquoi nous essayons d'utiliser au maximum les solutions existantes, au lieu de développer une certaine expertise en produits supplémentaires. Nous utilisons parfois simplement un basculement au niveau DNS, et nous déterminons la disponibilité du service avec le même DNS. Amazon dispose d'un service appelé Route 53, mais ce n'est pas simplement un DNS où l'on peut entrer des enregistrements — il est beaucoup plus flexible et pratique. Grâce à lui, vous pouvez créer des services géo-distribués avec géolocalisation, où vous définissez d'où provient le client et lui fournissez les enregistrements appropriés — cela permet de construire des architectures de basculement. Les mêmes vérifications de l'état peuvent être configurées directement dans Route 53 : vous définissez les points de terminaison à surveiller, les métriques, et les protocoles à utiliser pour déterminer la « disponibilité » du service — TCP, HTTP, HTTPS ; vous spécifiez la fréquence des vérifications qui détermineront si le service est en ligne ou non. Et dans le DNS, vous indiquez ce qui sera primaire, ce qui sera secondaire, où basculer en cas de défaillance lors des vérifications de santé dans Route 53. Tout cela peut être fait avec d'autres outils, mais ce qui est pratique, c'est qu'une fois configuré, vous n'avez plus besoin de vous soucier des vérifications ou des basculements : tout fonctionne de manière autonome.
Le premier « mais »: comment et avec quoi faut-il sauvegarder route 53 ? On ne sait jamais, si quelque chose lui arrivait. Heureusement, nous n'avons jamais eu ce problème, mais je vais expliquer pourquoi nous avons considéré qu'il fallait tout de même effectuer une sauvegarde. Ici, nous nous préparons à l'avance. Plusieurs fois par jour, nous faisons une exportation complète de toutes les zones que nous avons dans route 53. L'API d'Amazon permet de les renvoyer facilement en JSON, et nous avons mis en place plusieurs serveurs de sauvegarde où nous les convertissons, les exportons sous forme de fichiers de configuration et avons, en gros, une configuration de sauvegarde. En cas de problème, nous pouvons la déployer rapidement manuellement, sans perdre les données des paramètres DNS.
Deuxième « mais »: qu'est-ce qui n'est pas encore sauvegardé dans cette image ? L'équilibreur de charge lui-même ! La répartition des clients par région est faite de manière très simple. Nous avons des domaines bitrix24.ru, bitrix24.com, .de — actuellement, il y en a environ 13 différents qui fonctionnent dans diverses zones. Nous en sommes arrivés à la conclusion suivante : dans chaque région, il y a ses propres équilibreurs de charge. C'est plus simple de répartir par région, en fonction de la charge réseau maximale. Si une défaillance se produit au niveau d'un seul équilibreur de charge, il est simplement mis hors service et retiré du DNS. En cas de problème avec un groupe d'équilibreurs de charge, ils sont sauvegardés sur d'autres sites, et la bascule entre eux se fait grâce à la même route53, car avec un TTL court, le basculement se produit au maximum en 2, 3, 5 minutes.
Troisième « mais »: qu'est-ce qui n'est pas encore sauvegardé ? S3, c'est vrai. En hébergeant les fichiers que nous stockons chez les utilisateurs dans S3, nous croyions sincèrement qu'il était infaillible et qu'il n'était pas nécessaire de rien sauvegarder là-dedans. Mais l'histoire montre que cela se passe différemment. En fait, Amazon décrit S3 comme un service fondamental, car Amazon lui-même utilise S3 pour stocker des images de machines, des configurations, des AMI, des snapshots… Et si S3 tombe, comme cela s'est déjà produit au cours de ces 7 ans où nous exploitons bitrix24, cela entraîne une multitude de problèmes — l'impossibilité de démarrer des machines virtuelles, des pannes dans le fonctionnement de l'API, etc.
Un incident avec S3 peut arriver — cela s'est déjà produit. C'est pourquoi nous avons décidé de suivre la démarche suivante : il y a quelques années, il n'y avait pas de solutions de stockage objet publiques sérieuses en Russie, et nous envisagions de créer quelque chose de notre propre initiative… Heureusement, nous ne l'avons pas fait, car nous aurions été perdus dans une expertise que nous ne maîtrisons pas, et nous aurions certainement commis des erreurs. Aujourd'hui, des solutions de stockage compatibles avec S3 existent chez Mail.ru, Yandex et d'autres fournisseurs. Nous en sommes venus à la conclusion que nous souhaitons avoir, d'une part, une redondance, et d'autre part, la possibilité de travailler avec des copies locales. Pour la région spécifiquement russe, nous utilisons le service Mail.ru Hotbox, qui est compatible avec S3 via une API. Nous n'avons pas eu besoin d'apporter des modifications majeures au code de l'application, et nous avons mis en place le mécanisme suivant : S3 dispose de déclencheurs qui s'activent lors de la création ou de la suppression d'objets, et Amazon propose un service appelé Lambda — cela permet d'exécuter du code en mode serverless, qui s'exécutera lors des déclenchements de ces événements.
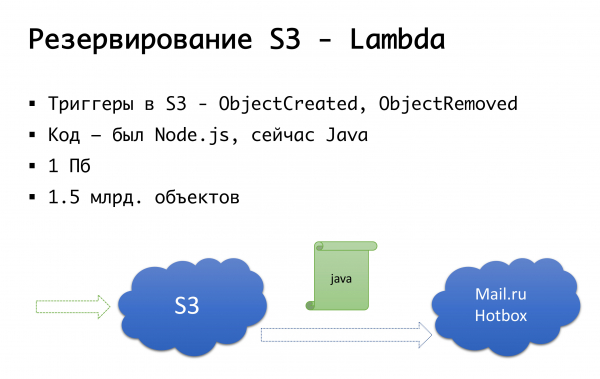
Nous avons fait cela très simplement : lorsque notre déclencheur s'active, nous exécutons un code qui copie l'objet dans le stockage Mail.ru. Pour lancer pleinement le travail avec des copies locales des données, nous avons également besoin d'une synchronisation inverse, afin que les clients situés dans le segment russe puissent travailler avec un stockage plus proche d'eux. Mail est sur le point de finaliser les déclencheurs dans son stockage — il sera bientôt possible d'exécuter une synchronisation inverse au niveau de l'infrastructure, pour l'instant nous le faisons dans notre propre code. Si nous voyons qu'un client a téléchargé un fichier, nous plaçons un événement dans la file d'attente à notre niveau de code, nous le traitons et effectuons la réplication inverse. Ce qui pose problème : si nous travaillons avec nos objets en dehors de notre produit, c'est-à-dire avec des outils externes, cela ne sera pas pris en compte. C'est pourquoi nous attendons que les déclencheurs au niveau du stockage soient implémentés, afin que peu importe où nous exécutons le code, l'objet qui nous parvient soit copié dans l'autre sens.
Au niveau du code, nous définissons pour chaque client les deux stockages : l'un est considéré comme principal, l'autre comme de sauvegarde. Si tout fonctionne bien, nous travaillons avec le stockage le plus proche de nous : c'est-à-dire que nos clients qui sont chez Amazon utilisent S3, tandis que ceux qui opèrent en Russie utilisent Hotbox. Si un drapeau est activé, un failover doit se connecter et nous redirigeons les clients vers un autre stockage. Nous pouvons fixer ce drapeau indépendamment par régions et les basculer. En pratique, nous ne l'avons pas encore utilisé, mais ce mécanisme est prévu et nous pensons que lorsque ce besoin de basculement se présentera, il sera utile. Cela nous est déjà arrivé une fois.
Oh, Amazon vous a lâchés...
Ce mois d'avril marque l'anniversaire du début des blocages de Telegram en Russie. Le fournisseur le plus touché par cela est Amazon. Malheureusement, ce sont les entreprises russes qui ont le plus souffert, celles qui opéraient à l'échelle mondiale.
Si l'entreprise est mondiale et que la Russie représente un très petit segment pour elle, 3-5% - il est possible, d'une manière ou d'une autre, de faire des sacrifices.
Si c'est une entreprise purement russe, je suis convaincu qu'il faut s'installer localement - c'est juste plus pratique et confortable pour les utilisateurs, le risque sera plus faible.
Et si c'est une entreprise qui opère à l'échelle mondiale, avec à peu près autant de clients en Russie que dans le reste du monde ? La connectivité des segments est importante, et ils doivent interagir d'une manière ou d'une autre.
Fin mars 2018, le Roskomnadzor a envoyé une lettre aux plus grands opérateurs, annonçant leur intention de bloquer plusieurs millions d'IP d'Amazon pour bloquer... le messager Zello. Merci à ces mêmes fournisseurs - ils ont réussi à faire fuiter la lettre, et il est devenu clair que la connectivité avec Amazon pourrait s'effondrer. C'était un vendredi, nous avons paniqué et nous sommes dirigés vers nos collègues de servers.ru, en leur disant : « Les amis, nous avons besoin de plusieurs serveurs qui ne seront pas en Russie, ni chez Amazon, mais par exemple, quelque part à Amsterdam », pour pouvoir mettre en place nos propres serveurs d'une manière ou d'une autre. vpn Et un proxy pour certains endpoints auxquels nous ne pouvons pas du tout accéder, par exemple les endpoints de S3 — nous ne pouvons pas essayer de déployer un nouveau service et obtenir une autre adresse IP, nous devons quand même y accéder. En quelques jours, nous avons configuré ces serveurs, les avons mis en marche et, au moment du début des blocages, nous étions préparés. Curieusement, le RKN, après avoir observé le tohu-bohu et la panique soulevée, a déclaré : « Non, nous n'allons rien bloquer pour l'instant ». (Mais c'était précisément jusqu'à ce qu'ils commencent à bloquer Telegram.) En configurant des moyens de contournement et en réalisant qu'aucun blocage n'était en cours, nous n'avons néanmoins pas pris la peine de le démonter. Juste au cas où.
Et donc, en 2019, nous vivons en effet sous des conditions de blocage. Hier soir, je regardais : environ un million d'adresses IP continuent d'être bloquées. En revanche, Amazon a été presque entièrement débloqué, atteignant jusqu'à 20 millions d'adresses en pic... En réalité, la situation est telle qu'il se peut qu'il n'y ait pas de bonne connectivité. Soudainement. Elle peut faire défaut pour des raisons techniques — incendies, excavateurs, tout ça. Ou, comme nous l'avons vu, pas uniquement pour des raisons techniques. Donc, quelqu'un de grand et de sérieux, avec ses propres AS, peut probablement gérer cela autrement, — direct connect et d'autres choses déjà au niveau L2. Mais dans un cas simple, comme nous ou des plus petits, il est préférable de disposer de sauvegardes au niveau des serveurs, déployés ailleurs, avec des VPN préconfigurés, des proxies, pour pouvoir rapidement changer la configuration dans les segments où la connectivité est critique pour vous. Cela nous a été utile à plusieurs reprises lorsque les blocages d'Amazon ont commencé, nous avons utilisé cela, dans le pire des cas, pour faire passer le trafic S3, mais cela s'est réglé progressivement.
Et comment assurer la redondance... d'un fournisseur entier ?
Actuellement, nous n'avons pas de scénario en cas de défaillance complète d'Amazon. Nous avons un scénario similaire pour la Russie. Nous étions hébergés en Russie par un fournisseur, chez qui nous avions choisi d'avoir plusieurs sites. Il y a un an, nous avons rencontré un problème : même si ce sont deux centres de données, il peut y avoir des problèmes au niveau de la configuration réseau du fournisseur qui impacteront tout de même les deux centres. Nous pouvons avoir des interruptions sur les deux sites. Bien sûr, cela s'est produit. Nous avons finalement révisé notre architecture interne. Elle n'a pas beaucoup changé, mais pour la Russie, nous avons maintenant deux sites, qui ne sont pas hébergés par un seul fournisseur, mais par deux différents. Si une chose tombe en panne chez l'un, nous pouvons nous rediriger vers l'autre.
Hypothétiquement, nous envisageons pour Amazon la possibilité de faire de la réservation au niveau d'un autre fournisseur ; peut-être Google, ou peut-être quelqu'un d'autre... Mais jusqu'à présent, nous avons observé dans la pratique que lorsqu'il y a des pannes chez Amazon au niveau d'une zone de disponibilité, des pannes touchant tout un région sont des événements assez rares. Par conséquent, nous avons une idée théorique de ce que nous pourrions faire en réservant "Amazon - pas Amazon", mais pour l'instant, cela n'existe pas en pratique.
Quelques mots sur l'automatisation
L'automatisation est-elle toujours nécessaire ? Il convient de rappeler ici l'effet Dunning-Kruger. Sur l'axe « x », nos connaissances et expériences que nous acquérons, et sur l'axe « y » — notre confiance dans nos actions. Au début, nous ne savons rien et nous ne sommes pas du tout confiants. Ensuite, nous savons un peu et devenons méga-confiants — c'est ce qu'on appelle le « pic de la bêtise », bien illustré par l'image « l'ignorance et le courage ». Ensuite, nous avons un peu appris et sommes prêts à entrer dans la bataille. Puis nous trébuchons sur des pièges sérieux, nous entrons dans la vallée du désespoir, où nous croyons savoir quelque chose, mais en réalité nous ignorons beaucoup de choses. Ensuite, au fur et à mesure que nous acquérons de l'expérience, nous gagnons en confiance.
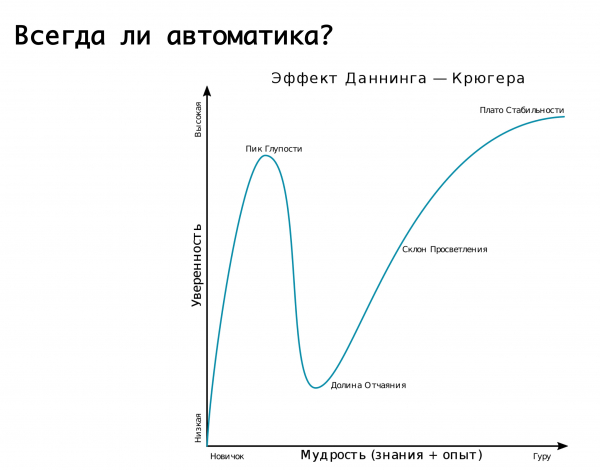
Notre logique concernant les divers basculements automatiques en cas d'incidents est très bien décrite par ce graphique. Nous avons commencé — nous n'avions aucune compétence, presque tous les travaux étaient effectués manuellement. Puis nous avons réalisé qu'il était possible d'automatiser tout cela pour, en quelque sorte, dormir sur nos deux oreilles. Et soudain, nous tombons sur des problèmes majeurs : des faux positifs se déclenchent, et nous faisons basculer le trafic à droite à gauche alors qu'en réalité, cela ne devrait pas être fait. Par conséquent, la réplication se casse ou quelque chose d'autre, et voici la vallée du désespoir. Ensuite, nous en arrivons à la compréhension qu'il faut avoir du discernement. Il est donc judicieux de se fier à l'automatisation tout en anticipant la possibilité de faux déclenchements. Mais ! si les conséquences peuvent être désastreuses, il vaut mieux laisser cela aux équipes de garde, aux ingénieurs de garde qui s'assureront, vérifieront qu'il y a réellement un problème et effectueront les actions nécessaires manuellement...
Conclusion
En 7 ans, nous sommes passés de la panique totale à la compréhension qu'il n'y a pas de problèmes, mais seulement des tâches à résoudre. Lorsque vous construisez un service, regardez-le d'un point de vue global, évaluez tous les risques qui peuvent survenir. Si vous les voyez tout de suite, anticipez les options de redondance et la possibilité de construire une infrastructure résiliente, car tout point pouvant tomber en panne et rendre le service inutilisable le fera nécessairement. Et même si vous pensez que certains éléments de l'infrastructure ne tomberont pas en panne — comme le s3, gardez à l'esprit qu'ils pourraient le faire. Ayez au moins une idée théorique sur ce que vous ferez avec eux si quelque chose se produit. Ayez un plan pour gérer les risques. Lorsque vous envisagez de tout faire automatiquement ou manuellement, évaluez les risques : que se passera-t-il si l'automatisation commence à tout basculer — cela ne conduira-t-il pas à une situation encore pire qu'une panne ? Peut-être qu'il faut parfois trouver un compromis raisonnable entre l'utilisation de l'automatisation et la réaction d'un ingénieur de garde, qui évaluera la situation réelle et décidera s'il faut basculer quelque chose immédiatement ou
Un compromis raisonnable entre le perfectionnisme et les ressources réelles, le temps, l'argent que vous pouvez consacrer au schéma que vous aurez finalement.
Ce texte est une version augmentée et étendue du rapport d'Alexandre Demidov lors de la conférence. .
Source : habr.com
