

Récemment, qui montre plutôt bien la tendance de l'apprentissage automatique ces dernières années. En bref : le nombre de startups dans le domaine de l'apprentissage automatique a fortement chuté au cours des deux dernières années.
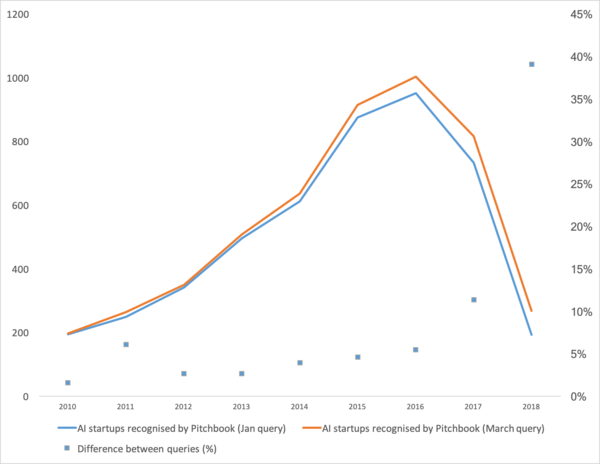
Alors, parlons de « la bulle a-t-elle éclaté », « comment vivre maintenant » et discutons d'où vient finalement ce phénomène.
Pour commencer, parlons de ce qui a été le moteur de cette courbe. D'où vient-elle ? Vous vous souvenez probablement de l'apprentissage automatique en 2012 lors du concours ImageNet. C'est le premier événement mondial ! Cependant, en réalité, ce n'est pas le cas. Et la montée de la courbe commence un peu plus tôt. Je la diviserais en plusieurs moments.
- L'année 2008 marque l'apparition du terme « Big Data ». Les vrais produits ont commencé à partir de 2010. Les Big Data sont directement liés à l'apprentissage automatique. Sans Big Data, il n'est pas possible d'assurer le bon fonctionnement des algorithmes qui existaient à l'époque. Et ce ne sont pas des réseaux neuronaux. Avant 2012, les réseaux neuronaux étaient l'affaire d'une minorité marginale. Cependant, c'est à ce moment-là que d'autres algorithmes, qui existaient déjà depuis des années, voire des décennies, ont commencé à fonctionner : (1963, 1993), (1995), (2003),… Les startups de cette époque étaient principalement liées au traitement automatique des données structurées : caisses, utilisateurs, publicité, et bien d'autres.
La dérivée de cette première vague est un ensemble de frameworks, tels que XGBoost, CatBoost, LightGBM, etc.
- En 2011-2012, ont remporté plusieurs compétitions de reconnaissance d'images. Leur utilisation réelle a pris un certain temps. Je dirais que les startups et solutions massivement réfléchies ont commencé à apparaître en 2014. Il a fallu deux ans pour digérer le fait que les réseaux neuronaux fonctionnent en réalité, pour créer des frameworks conviviaux qui pouvaient être installés et lancés dans un délai raisonnable, et pour développer des méthodes qui stabilisent et accélèrent le temps de convergence.
Les réseaux convolutionnels ont permis de résoudre des tâches de vision par ordinateur : classification d'images et d'objets sur une image, détection d'objets, reconnaissance d'objets et de personnes, amélioration des images, etc.
- 2015-2017. Période de boom des algorithmes et des projets liés aux réseaux récurrents ou à leurs analogues (LSTM, GRU, TransformerNet, etc.). Des algorithmes de reconnaissance automatique de la parole et des systèmes de traduction automatique efficaces ont vu le jour. En partie, ils sont basés sur des réseaux convolutifs pour l'extraction de caractéristiques fondamentales. En partie sur la collecte de grands ensembles de données de haute qualité.
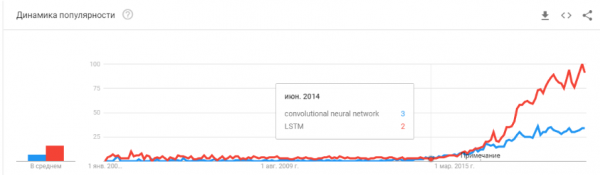
« La bulle a éclaté ? L'engouement est-il exagéré ? Ont-ils disparu comme le blockchain ? »
Eh bien oui ! Demain, Siri cessera de fonctionner sur votre téléphone, et après-demain, Tesla ne saura pas faire la différence entre un virage et un kangourou.
Les réseaux neuronaux sont déjà en action. Ils sont présents dans des dizaines d'appareils. Ils permettent réellement de gagner de l'argent, changent le marché et notre monde. L'engouement prend une forme légèrement différente :
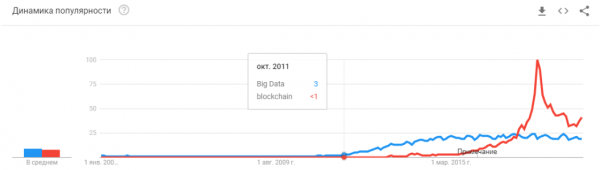
Tout simplement, les réseaux neuronaux ont cessé d'être quelque chose de nouveau. Oui, beaucoup de gens ont des attentes trop élevées. Mais un grand nombre d'entreprises ont appris à appliquer des réseaux neuronaux et à créer des produits sur cette base. Les réseaux neuronaux offrent de nouvelles fonctionnalités, permettent de réduire le nombre de postes de travail et de diminuer le coût des services :
- Les entreprises de production intègrent des algorithmes pour analyser les défauts sur les chaînes de montage.
- Les exploitations agricoles achètent des systèmes pour surveiller les vaches.
- Moissonneuses automatiques.
- Centres d'appel automatisés.
- Filtres dans SnapChat. (au moins quelque chose de valable !)
Mais le plus important, et ce n'est pas si évident : « Il n'y a plus d'idées nouvelles, ou elles ne rapporteront pas de capital instantanément. » Les réseaux neuronaux ont résolu des dizaines de problèmes. Et ils continueront à en résoudre davantage. Toutes les idées évidentes qui existaient ont engendré de nombreux startups. Mais tout ce qui était à la surface a déjà été réuni. Au cours des deux dernières années, je n'ai rencontré aucune nouvelle idée pour l'application des réseaux neuronaux. Aucun nouvel angle d'approche (bon, il y a quelques complications avec les GAN, mais c'est tout).
Chaque nouvelle startup devient de plus en plus complexe. Elle exige déjà plus de deux personnes formant un réseau neuronal sur des données ouvertes. Elle nécessite des programmeurs, des serveurs, une équipe d'annotation, un soutien complexe, etc.
Comme conséquence, le nombre de startups diminue. Alors que la production augmente. Besoin d'ajouter la reconnaissance de plaques d'immatriculation ? Il y a des centaines de spécialistes sur le marché avec une expérience pertinente. Vous pouvez embaucher quelqu'un et en quelques mois votre employé mettra en place un système. Ou acheter une solution existante. Mais créer une nouvelle startup ? C'est de la folie !
Il est nécessaire de créer un système de suivi des visiteurs : pourquoi payer pour de nombreuses licences alors que l'on peut développer le sien en 3-4 mois, adapté à son entreprise ?
Les réseaux neuronaux suivent actuellement le même chemin que de nombreuses autres technologies.
Vous vous souvenez comment le concept de « développeur de sites » a évolué depuis 1995 ? Tant que le marché n'est pas saturé de spécialistes. Il y a très peu de professionnels. Mais je parie qu'en 5-10 ans, il n'y aura pas de grande différence entre un programmeur Java et un développeur de réseaux neuronaux. Les deux types de spécialistes seront présents en quantité sur le marché.
Il y aura simplement des classes de tâches pour lesquelles les réseaux neuronaux seront utilisés. Une tâche apparaît — vous engagez un spécialiste.
« Et après ? Où est l'intelligence artificielle promise ? »
Il y a ici un petit mais intéressant dilemme :)
Le stack technologique que nous avons aujourd'hui, visiblement, ne nous conduira pas à l'intelligence artificielle après tout. Les idées, leur nouveauté — ont en grande partie épuisé leur potentiel. Discutons de ce qui maintient le niveau actuel de développement.
Restrictions
Commençons par les voitures autonomes. Il semble qu'il soit clair qu'il est possible de créer des voitures complètement autonomes avec les technologies d'aujourd'hui. Mais combien d'années cela prendra-t-il ? Ce n'est pas clair. Tesla estime que cela se produira dans quelques années —
Il existe de nombreux autres , qui évaluent cela à 5-10 ans.
Probablement, selon moi, dans 15 ans, l'infrastructure des villes changera elle-même de telle sorte que l'apparition de voitures autonomes deviendra inévitable, faisant partie intégrante de celle-ci. Mais cela ne peut pas être considéré comme de l'intelligence. La Tesla moderne est en réalité une chaîne de production très complexe de filtrage des données, de recherche et de ré-apprentissage. Ce sont des règles-règles-règles, la collecte de données et des filtres (voici j'ai écrit un peu plus en détail à ce sujet, ou regardez avec la marque).
Le premier problème
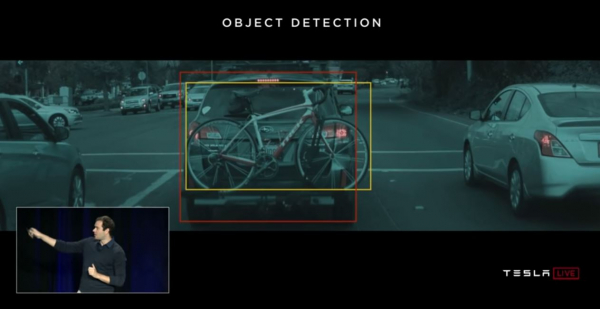
Et c'est ici que nous voyons le premier problème fondamental. Les grandes données. C'est exactement ce qui a engendré la vague actuelle de réseaux neuronaux et d'apprentissage automatique. Aujourd'hui, pour réaliser quelque chose de complexe et automatique, il faut beaucoup de données. Pas juste beaucoup, mais énormément. Des algorithmes automatisés pour leur collecte, leur étiquetage et leur utilisation sont nécessaires. Si nous voulons que la machine identifie des camions contre le soleil, nous devons d'abord collecter un nombre suffisant. Si nous voulons que la machine ne perde pas la tête en voyant un vélo attaché au porte-vélos, il faut encore plus d'échantillons.
Mais un seul exemple ne suffira pas. Des centaines ? Des milliers ?
Le deuxième problème
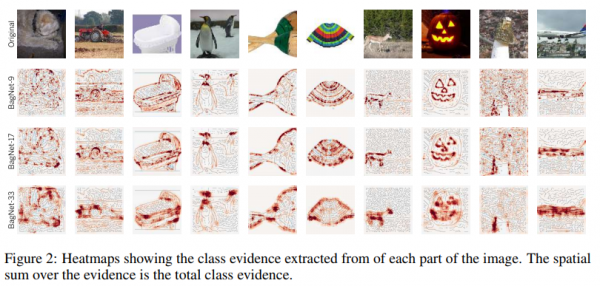
Le deuxième problème — la visualisation de ce que notre réseau neuronal a compris. C'est une tâche très complexe. Peu de gens comprennent encore comment cela peut être visualisé. Voici quelques articles assez récents, ce ne sont que quelques exemples, même s'ils sont éloignés :
la focalisation sur les textures. Cela montre bien sur quoi le réseau a tendance à se concentrer et ce qu'il perçoit comme information de base.
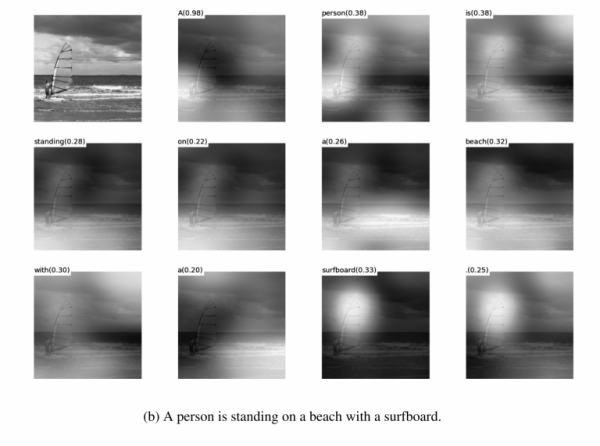
l'attention lors des . En réalité, l'attention peut souvent être utilisée précisément pour montrer ce qui a déclenché une telle réaction du réseau. J'ai vu des outils dans ce sens pour le débogage et les solutions produits. Il existe de nombreux articles sur ce sujet. Mais plus les données sont complexes, plus il est difficile de comprendre comment parvenir à une visualisation stable.
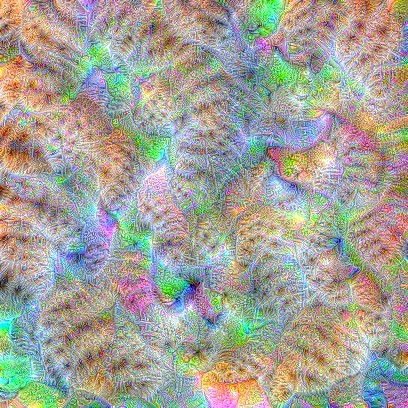
Et oui, le bon vieux truc de « regarde ce qu'il y a à l'intérieur du réseau dans les ». Ces images étaient populaires il y a 3-4 ans, mais tout le monde a rapidement compris que ces images sont belles, mais n'ont pas beaucoup de sens.
Je n'ai pas mentionné des dizaines d'autres astuces, méthodes, hacks, recherches sur la façon de représenter les entrailles du réseau. Ces outils fonctionnent-ils ? Aident-ils à rapidement comprendre quel est le problème et déboguer le réseau ?.. Extraire les derniers pourcents ? Eh bien, à peu près comme ça :
Vous pouvez consulter n'importe quel concours sur Kaggle. Et la description de la manière dont les gens réalisent leurs solutions finales. Nous avons accumulé 100-500-800 millions de modèles et cela a fonctionné !
Bien sûr, j'exagère. Mais ces approches ne donnent pas de réponses rapides et directes.
Avec suffisamment d'expérience, en essayant différentes options, on peut émettre un verdict sur la raison pour laquelle votre système a pris une telle décision. Mais corriger le comportement du système sera difficile. Installer une rustine, déplacer le seuil, ajouter un ensemble de données, prendre un autre réseau backend.
Le troisième problème
Le troisième problème fondamental — les réseaux apprennent non pas la logique, mais la statistique. Statistiquement, cela :
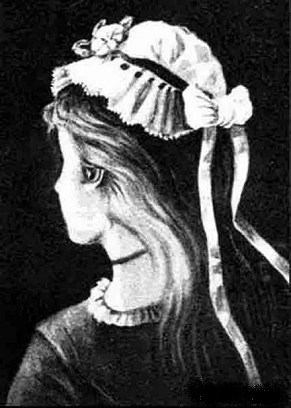
Logiquement, ce n'est pas très ressemblant. Les réseaux de neurones n'apprennent rien de complexe, à moins qu'on ne les y contraigne. Ils apprennent toujours les caractéristiques les plus simples. Y a-t-il des yeux, un nez, une tête ? Cela signifie que c'est un visage ! Ou donne un exemple où les yeux ne signifieraient pas un visage. Et encore une fois — des millions d'exemples.
Il y a beaucoup de place au fond
Je dirais que ce sont précisément ces trois problèmes globaux qui limitent aujourd'hui le développement des réseaux de neurones et de l'apprentissage machine. Partout où ces problèmes ne limitent pas — cela est déjà activement utilisé.
Est-ce la fin ? Les réseaux de neurones se sont-ils bloqués ?
On ne sait pas. Mais bien sûr, tout le monde espère que ce n'est pas le cas.
Il existe de nombreuses approches et directions pour résoudre les problèmes fondamentaux que j'ai évoqués ci-dessus. Mais jusqu'à présent, aucune de ces approches n'a permis de réaliser quelque chose de fondamentalement nouveau, de résoudre quelque chose qui n'avait pas encore été résolu. Jusqu'à présent, tous les projets fondamentaux sont basés sur des approches stables (Tesla), ou restent des projets expérimentaux d'institutions ou de sociétés (Google Brain, OpenAI).
Pour parler en termes simples, la direction principale est la création d'une certaine représentation de haut niveau des données d'entrée. Dans un certain sens, "mémoire". L'exemple le plus simple de la mémoire est les différents "Embedding" — représentations des images. Par exemple, tous les systèmes de reconnaissance faciale. Le réseau apprend à obtenir d'un visage une représentation stable qui ne dépend pas de l'angle, de l'éclairage, de la résolution. En essence, le réseau minimise la métrique "visages différents - loin" et "identiques - près".
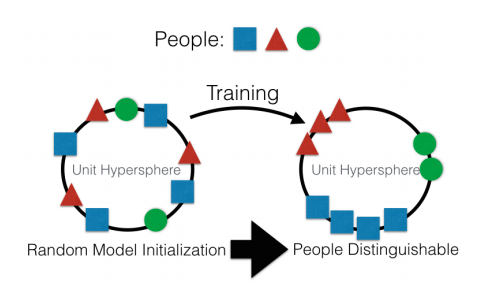
Pour un tel apprentissage, il faut des dizaines et des centaines de milliers d'exemples. Mais le résultat porte certains éléments de "One-shot Learning". Maintenant, nous n'avons plus besoin de centaines de visages pour mémoriser une personne. Un seul visage suffit, et tout — nous !
Mais il y a un petit problème... Le réseau ne peut apprendre que des objets assez simples. En essayant de distinguer non pas des visages, mais par exemple "les gens par leurs vêtements" (la tâche ) — la qualité s'effondre de plusieurs ordres de grandeur. Et le réseau ne peut plus apprendre des changements d'angle assez évidents.
Et apprendre sur des millions d'exemples — c'est aussi un peu une distraction.
Il y a des travaux sur la réduction significative des choix. Par exemple, je peux immédiatement me rappeler l'un des premiers travaux sur OneShot Learning :
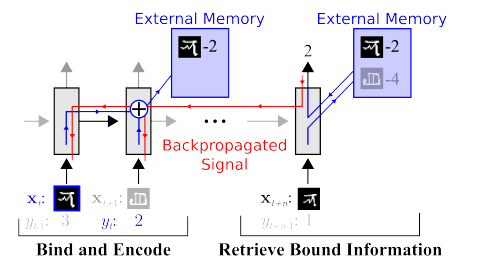
Il existe beaucoup de tels travaux, par exemple ou ou .
Un des inconvénients est que l'apprentissage fonctionne généralement bien sur des exemples simples, les "exemples MNIST". Mais lorsqu'on passe à des problèmes plus complexes, il faut une plus grande base, un modèle d'objets, ou un peu de magie.
En fait, les travaux sur l'apprentissage One-Shot sont un sujet très intéressant. On trouve beaucoup d'idées. Mais la plupart du temps, les deux problèmes que j'ai mentionnés (pré-entraînement sur un énorme ensemble de données / instabilité sur des données complexes) compliquent beaucoup l'apprentissage.
D'un autre côté, les GAN conviennent au sujet de l'Embedding — des réseaux antagonistes génératifs. Vous avez sûrement lu plein d'articles à ce sujet sur Habré., ,)
Une caractéristique des GAN est la formation d'un certain espace interne d'états (qui est en fait le même Embedding), ce qui permet de dessiner une image. Cela peut être , cela peut être .
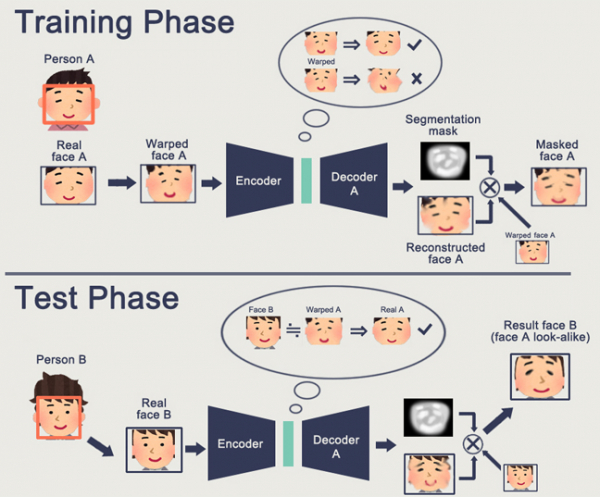
Le problème des GAN est que plus l'objet généré est complexe, plus il est difficile de le décrire en termes de "générateur-discriminateur". En conséquence, les seules applications réelles des GAN qui sont sur toutes les lèvres sont DeepFake, qui, encore une fois, manipulent les représentations faciales (pour lesquelles il existe une énorme base).
J'ai rencontré très peu d'autres applications utiles. En général, ce sont des gadgets qui retouchent des images.
Et encore une fois. Personne ne comprend comment cela nous permettra d'avancer vers un avenir radieux. Représenter la logique/l'espace dans un réseau neuronal est bien. Mais il faut un énorme nombre d'exemples, nous ne comprenons pas comment le réseau neuronal représente cela en lui-même, nous ne comprenons pas comment faire en sorte que le réseau neuronal mémorise une représentation réellement complexe.
L'apprentissage par renforcement est une approche totalement différente. Vous vous souvenez sûrement comment Google a battu tout le monde au Go. Les récentes victoires dans Starcraft et Dota. Mais ici, tout n'est pas si rose et prometteur. Le mieux pour parler de l'apprentissage par renforcement et de ses complexités est .
Pour résumer brièvement ce que l'auteur a écrit :
- Les modèles prêts à l'emploi ne conviennent pas / fonctionnent mal dans la plupart des cas
- Les tâches pratiques peuvent être résolues plus facilement par d'autres moyens. Boston Dynamics n'utilise pas l'apprentissage par renforcement en raison de sa complexité / imprévisibilité / complexité des calculs.
- Pour que l'apprentissage par renforcement fonctionne, une fonction complexe est nécessaire. Il est souvent difficile de créer / écrire cette fonction.
- Il est difficile de former des modèles. Il faut passer beaucoup de temps à optimiser et à sortir des optimums locaux.
- Par conséquent, il est difficile de reproduire le modèle, qui est instable avec les moindres modifications.
- Souvent, il est victime de surapprentissage sur des tendances aléatoires, jusqu'à un générateur de nombres aléatoires.
Le point clé est que le RL ne fonctionne pas encore en production. Google a quelques expériences à ce sujet ( , ). Mais je n'ai vu aucun système produit.
Mémoire. Le principal inconvénient de tout ce qui a été décrit ci-dessus est le manque de structure. L'une des approches pour résoudre ce problème est de fournir à un réseau de neurones un accès à une mémoire distincte. Cela lui permet d'enregistrer et de réenregistrer les résultats de ses actions. Ainsi, le réseau de neurones peut être défini par l'état actuel de cette mémoire. C'est très similaire aux processeurs et ordinateurs classiques.
La plus connue et populaire — de DeepMind :
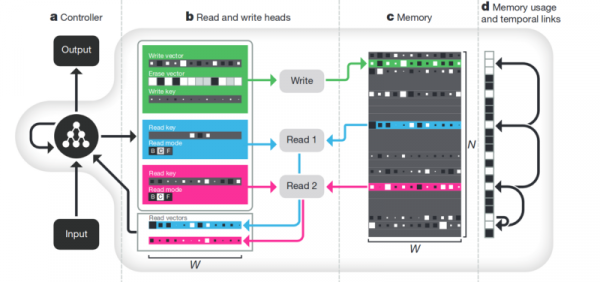
On a l'impression que c'est la clé pour comprendre l'intelligence ? Mais plutôt non. Le système a toujours besoin d'un immense volume de données pour l'entraînement. Et il fonctionne principalement avec des données tabulées structurées. Pendant ce temps, lorsque Facebook un problème similaire, ils ont choisi la voie « oublions la mémoire, simplement rendons le réseau de neurones plus complexe et augmentons le nombre d'exemples — et il s'auto-apprendra ».
Démêlage. Une autre façon de créer une mémoire significative est de prendre les mêmes embeddings, mais d'introduire des critères supplémentaires lors de l'entraînement qui permettraient de distinguer des « sens ». Par exemple, nous voulons entraîner un réseau de neurones à différencier le comportement d'une personne dans un magasin. Si nous suivions le chemin standard — nous devrions créer une dizaine de réseaux. L'un cherche la personne, le second détermine ce qu'elle fait, le troisième son âge, le quatrième — son sexe. Une logique distincte examine la partie du magasin où elle se trouve/est formée à cela. Le troisième détermine sa trajectoire, etc.
Ou, s'il y avait une quantité infinie de données, on pourrait entraîner un seul réseau sur tous les résultats possibles (évidemment, il est impossible d'accumuler un tel volume de données).
L'approche de décentelgment nous dit : formons le réseau pour qu'il puisse lui-même différencier les concepts. Pour qu'il puisse créer un embedding à partir de la vidéo où une région définirait l'action, une autre - la position au sol dans le temps, une autre - la taille de la personne, et une autre encore - son sexe. Lors de l'entraînement, nous souhaiterions ne pas donner presque d'indices au réseau concernant ces concepts clés, mais qu'il puisse lui-même identifier et regrouper les régions. Il existe assez peu d'articles sur ce sujet (certains d'entre eux , , ) et, en général, ils sont assez théoriques.
Cependant, cette direction devrait, au moins théoriquement, résoudre les problèmes énumérés au début.
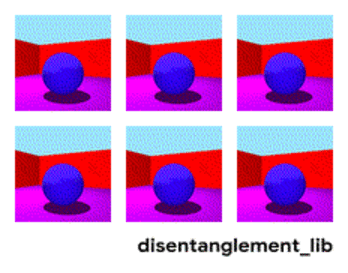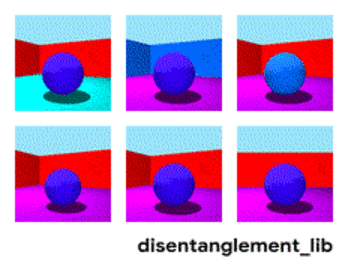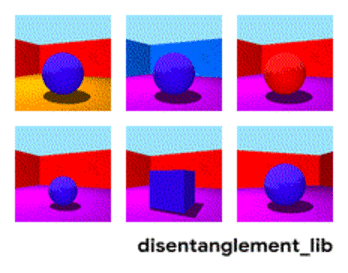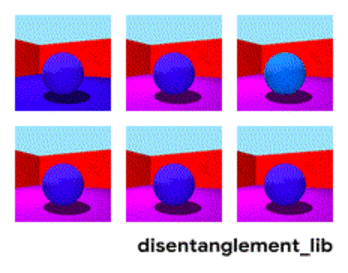
Décomposition de l'image par les paramètres « couleur des murs/couleur du sol/forme de l'objet/couleur de l'objet/etc. »
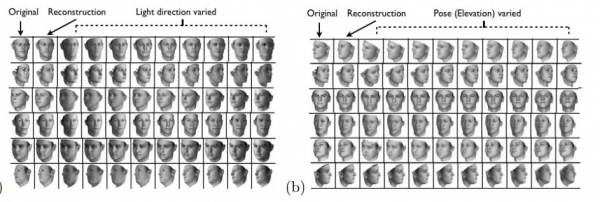
Décomposition du visage par les paramètres « taille, sourcils, orientation, couleur de la peau, etc. »
Autre
Il existe de nombreuses autres directions moins mondiales qui permettent d'une manière ou d'une autre de réduire les bases, de travailler avec des données plus hétérogènes, etc.
Attention. Il n'est probablement pas utile de le distinguer comme une méthode séparée. C'est simplement une approche qui renforce les autres. De nombreux articles y sont consacrés (,,). Le sens de l'attention est de renforcer la réaction du réseau sur des objets significatifs lors de l'entraînement. Souvent par le biais d'une directive externe, ou d'un petit réseau externe.
Simulation 3D. Si on crée un bon moteur 3D, on peut souvent couvrir 90 % des données d'entraînement (j'ai même vu un exemple où presque 99 % des données étaient couvertes par un bon moteur). Il existe de nombreuses idées et astuces pour faire fonctionner un réseau entraîné sur un moteur 3D avec des données réelles (Fine tuning, style transfer, etc.). Mais il est souvent beaucoup plus difficile de créer un bon moteur que de rassembler des données. Des exemples de moteurs créés :
Entraînement de robots (, )
Formation des produits en magasin (mais dans les deux projets que nous avons réalisés, nous avons pu nous passer de cela).
Entraînement chez Tesla (encore une fois, la vidéo mentionnée ci-dessus).
Conclusions
Tout l'article représente, en quelque sorte, des conclusions. Probablement, le message principal que je voulais faire passer est : « la période de grâce est terminée, les réseaux neuronaux ne fournissent plus de solutions simples ». Maintenant, il faut travailler dur pour construire des solutions complexes. Ou travailler en réalisant des recherches scientifiques complexes.
En réalité, le sujet est discutable. Peut-être que les lecteurs ont des exemples plus intéressants ?
Source : habr.com
