

Bonjour ! Je m'appelle Vadim Madison, je dirige le développement de la System Platform d'Avito. Cela a déjà été mentionné plusieurs fois, notre entreprise passe d'une architecture monolithique à une architecture microservices. Il est temps de partager comment nous avons transformé notre infrastructure pour tirer le meilleur parti des microservices sans nous perdre dans le processus. Découvrez comment le PaaS nous aide, comment nous avons simplifié le déploiement et rendu la création d'un microservice possible en un seul clic – lisez la suite. Tout ce que je décris ci-dessous n'est pas encore entièrement mis en œuvre chez Avito, mais fait partie de l'évolution de notre plateforme.
(Et à la fin de cet article, je parlerai de l'opportunité de participer à un séminaire de trois jours animé par l'expert en architecture microservices Chris Richardson).
Comment nous sommes arrivés aux microservices
Avito est l'une des plus grandes plateformes de petites annonces au monde, avec plus de 15 millions de nouvelles annonces publiées chaque jour. Notre backend traite plus de 20 000 requêtes par seconde. Nous avons maintenant plusieurs centaines de microservices.
Nous développons l'architecture microservices depuis plusieurs années. Comment cela se fait exactement – nos collègues en parlent en détail dans notre section lors de RIT++ 2017. Lors de CodeFest 2017 (voir ), Sergey Orlov et Mikhail Prokopchuk ont expliqué en détail pourquoi nous avions besoin de passer aux microservices et quel rôle Kubernetes a joué à cet égard. Maintenant, nous faisons tout pour réduire au minimum les coûts de scalabilité qui sont inhérents à cette architecture.
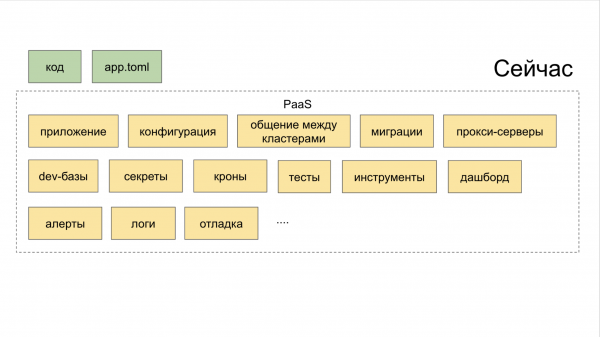
Au départ, nous n'avons pas créé un écosystème qui nous aide de manière exhaustive dans le développement et le lancement des microservices. Nous avons simplement collecté des solutions open source efficaces, les avons lancées sur nos serveurs et avons demandé aux développeurs de se familiariser avec elles. Au final, les développeurs se retrouvaient à devoir naviguer entre une dizaine de plateformes (tableaux de bord, services internes), ce qui renforçait leur désir de coder de manière traditionnelle, dans le monolithe. En vert sur les schémas ci-dessous, nous avons indiqué ce que les développeurs font de leurs propres mains, et en jaune, l'automatisation.
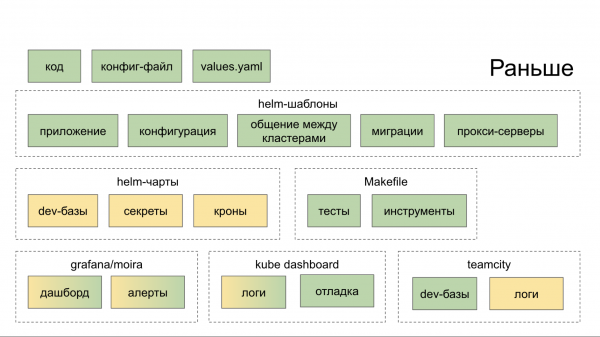
Désormais, dans l'outil CLI PaaS, un nouveau service se crée avec une seule commande, suivi de deux autres pour ajouter une nouvelle base de données et déployer en étape.
Comment surmonter l'ère de la « fragmentation microservices »
Avec une architecture monolithique, pour garantir la cohérence des modifications dans le produit, les développeurs devaient comprendre ce qui se passait chez leurs voisins. Avec la nouvelle architecture, les contextes des services ne dépendent plus les uns des autres.
De plus, pour que l'architecture microservices soit efficace, il est nécessaire de mettre en place de nombreux processus, à savoir :
• journalisation;
• traçage des requêtes (Jaeger);
• agrégation des erreurs (Sentry);
• statuts, messages, événements de Kubernetes (traitement de flux d'événements);
• race limit / circuit breaker (vous pouvez utiliser Hystrix);
• contrôle de la connectivité des services (nous utilisons Netramesh);
• surveillance (Grafana);
• compilation (TeamCity);
• communication et notifications (Slack, email);
• suivi des tâches; (Jira)
• rédaction de la documentation.
Pour que le système ne perde pas son intégrité et reste efficace au fur et à mesure de son extension, nous avons repensé l'organisation du travail des microservices chez Avito.
Comment nous gérons les microservices
Pour appliquer une « politique unique » parmi les nombreux microservices d'Avito, nous avons recours à :
- la séparation de l'infrastructure en couches;
- le concept de Platform as a Service (PaaS);
- la surveillance de tout ce qui concerne les microservices.
Les niveaux d'abstraction de l'infrastructure comprennent trois couches. Passons de la supérieure à la inférieure.
A. Supérieure — service mesh. Au départ, nous avons essayé Istio, mais il s'est avéré qu'il consomme trop de ressources, ce qui, à nos volumes, revient trop cher. Par conséquent, l'ingénieur principal de l'équipe d'architecture, Alexandre Loukiantchenko, a développé sa propre solution — (disponible en open source), que nous utilisons actuellement en production et qui consomme plusieurs fois moins de ressources qu'Istio (mais ne fait pas tout ce qu'Istio peut offrir).
B. Intermédiaire — Kubernetes. Nous y déployons et exploitons les microservices.
C. Inférieure — bare metal. Nous n'utilisons pas le cloud et des choses comme OpenStack, nous sommes entièrement sur bare metal.
Tous les niveaux sont réunis par PaaS. Et cette plateforme se compose, à son tour, de trois parties.
I. Générateurs, gérés via un utilitaire CLI. C'est ce qui aide le développeur à créer un microservice correctement et avec un minimum d'efforts.
II. Collecteur global avec surveillance de tous les outils via un tableau de bord commun.
III. Stockage. Il s'intègre avec des planificateurs qui déclenchent automatiquement les actions importantes. Grâce à ce système, aucune tâche n'est laissée de côté simplement parce que quelqu'un a oublié de se fixer une tâche dans Jira. Pour cela, nous utilisons un outil interne appelé Atlas.
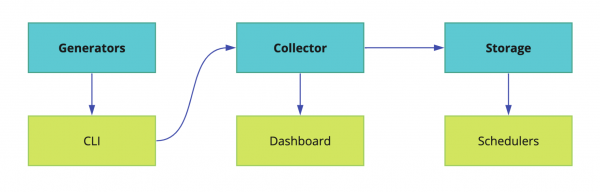
La mise en œuvre des microservices chez Avito se fait également selon un schéma unique, ce qui simplifie le contrôle à chaque étape du développement et de la publication.
Comment fonctionne le pipeline standard de développement d'un microservice
En termes généraux, la chaîne de création d'un microservice se présente comme suit :
CLI-push → Intégration Continue → Bake → Déploiement → Tests automatisés → Tests Canary → Squeeze Testing → Production → Maintenance.
Passons en revue cette chaîne dans cet ordre précis.
CLI-push
• Création de microservice.
Nous avons longtemps travaillé pour apprendre à chaque développeur à créer des microservices. Nous avons notamment rédigé des instructions détaillées dans Confluence. Mais les schémas ont changé et été complétés. Au final, un goulot d'étranglement s'est formé au début du processus : le lancement des microservices prenait beaucoup plus de temps que prévu, et des problèmes survenaient fréquemment lors de leur création.
Finalement, nous avons créé un utilitaire CLI simple qui automatise les étapes principales de création d'un microservice. En fait, il remplace le premier git push. Voici ce qu'il fait précisément.
— Crée un service à partir d'un modèle — étape par étape, en mode « assistant ». Nous avons des modèles pour les principaux langages de programmation backend d'Avito : PHP, Golang et Python.
— Déploie un environnement pour le développement local sur une machine donnée avec une seule commande — Minikube se lance, et les charts Helm sont générés et déployés automatiquement dans le Kubernetes local.
— Connecte la base de données nécessaire. Le développeur n'a pas besoin de connaître l'IP, le login et le mot de passe pour accéder à la base de données souhaitée — que ce soit localement, en stage ou en production. De plus, la base de données est déployée immédiatement en configuration résiliente et avec équilibrage de charge.
— Effectue elle-même une build live. Supposons qu'un développeur ait modifié quelque chose dans le microservice via son IDE. L'utilitaire détecte les modifications dans le système de fichiers et reconstruit l'application (pour Golang) et redémarre. Pour PHP, nous passons simplement le répertoire à l'intérieur du conteneur et le live-reload se fait automatiquement.
— Génère des tests automatiques. Sous forme de modèles, mais tout de même utilisables.
• Déploiement du microservice.
Déployer un microservice était auparavant un peu compliqué. Il fallait impérativement :
I. Dockerfile.
II. Configuration.
III. Helm chart, qui est lui-même volumineux et inclut :
— les charts eux-mêmes ;
— les modèles ;
— des valeurs spécifiques tenant compte de différents environnements.
Nous avons éliminés les douleurs liées à la réécriture des manifestes Kubernetes, et ils sont maintenant générés automatiquement. Mais surtout, nous avons simplifié le déploiement au maximum. Maintenant, nous avons un Dockerfile, et toute la configuration est écrite par le développeur dans un seul et court fichier app.toml.
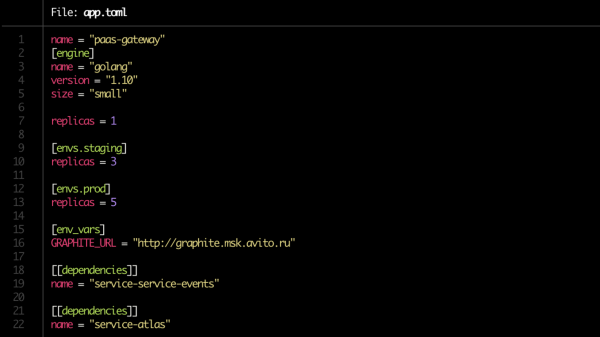
Et dans le fichier app.toml lui-même, c'est maintenant une question de minutes. Nous indiquons combien de copies du service déployer (sur le serveur de développement, sur la mise en scène, en production), et précisons ses dépendances. Notez la ligne size = «small» dans le bloc [engine]. C'est la limite qui sera attribuée au service via Kubernetes.
Ensuite, sur la base de la configuration, tous les Helm charts nécessaires sont générés automatiquement et les connexions aux bases de données créées.
• Validation de base. Ces vérifications sont également automatisées.
Il est nécessaire de surveiller :
— s'il y a un Dockerfile ;
— s'il y a un app.toml ;
— s'il y a de la documentation ;
— si les dépendances sont en ordre ;
— si les règles d'alerte sont définies.
Concernant ce dernier point : le propriétaire du service indique lui-même quelles métriques produit surveiller.
• Préparation de la documentation.
C'est toujours un point problématique. En théorie, c'est le plus évident, mais en même temps, c'est le maillon de chaîne le plus souvent «oublié», donc vulnérable.
Il est nécessaire d'avoir une documentation pour chaque microservice. Elle comprend les éléments suivants.
I. Brève description du service. Littéralement quelques phrases sur ce qu'il fait et à quoi il sert.
II. Lien vers le diagramme d'architecture. Il est important qu'à première vue, on puisse comprendre facilement, par exemple, si vous utilisez Redis pour le caching ou comme stockage principal de données en mode persistant. Chez Avito, c'est pour l'instant un lien vers Confluence.
III. Runbook. Un court guide sur le démarrage du service et ses spécificités.
IV. FAQ, où il serait bon de prévoir les problèmes que vos collègues pourraient rencontrer lors de l'utilisation du service.
V. Description des endpoints pour l'API. Si vous n'indiquez pas de destinations, vos collègues, dont les microservices sont liés aux vôtres, devront presque sûrement en payer les conséquences. Actuellement, nous utilisons Swagger et notre solution appelée brief pour cela.
VI. Étiquettes. Ou des marqueurs qui montrent à quel produit, fonctionnalité ou département de l'entreprise appartient le service. Ils aident à comprendre rapidement, par exemple, si vous ne développez pas une fonctionnalité que vos collègues ont lancée pour le même business unit la semaine dernière.
VII. Propriétaire ou propriétaires du service. Dans la plupart des cas, il ou ils peuvent être déterminés automatiquement grâce à PaaS, mais pour être sûr, nous demandons au développeur de les indiquer manuellement.
Enfin, il est bon de revoir la documentation, à l'instar d'une code review.
Intégration Continue
- Préparation des dépôts.
- Création d'un pipeline dans TeamCity.
- Attribution des droits.
- Recherche des propriétaires du service. C'est un schéma hybride : étiquetage manuel et automatisation minimale de PaaS. Un schéma entièrement automatisé peut échouer lors du transfert de services vers la prise en charge d'une autre équipe de développement ou, par exemple, si le développeur du service a été licencié.
- Enregistrement du service dans Atlas (voir ci-dessus). Avec tous ses propriétaires et dépendances.
- Vérification des migrations. Nous vérifions s'il n'y a pas parmi elles des éléments potentiellement dangereux. Par exemple, l'une d'elles contient un alter table ou quelque chose d'autre capable d'interrompre la compatibilité du schéma de données entre différentes versions du service. Dans ce cas, la migration n'est pas exécutée et est mise en attente - PaaS doit signaler au propriétaire du service quand il sera sûr de l'appliquer.
— c'est un outil pour la construction coordonnée de logiciels à partir de plusieurs dépôts, développé pour le projet ns‑3.
La prochaine étape est l'emballage des services avant le déploiement.
- Construction de l'application. Classiquement, dans une image Docker.
- Génération de charts Helm pour le service lui-même et les ressources qui lui sont associées. Y compris pour les bases de données et le cache. Ils sont créés automatiquement en fonction de la configuration app.toml, qui a été formée à l'étape CLI-push.
- Création de tickets aux administrateurs pour l'ouverture des ports (lorsque cela est nécessaire).
- Exécution des tests unitaires et calcul de la couverture du code.. Si la couverture du code est inférieure au seuil requis, il est fort probable que le service ne passera pas la phase de déploiement. S'il est à la limite du tolérable, un coefficient « pessimisant » sera attribué au service : en l'absence d'amélioration des indicateurs au fil du temps, le développeur recevra une notification indiquant qu'il n'y a pas de progrès concernant les tests (et qu'il faudrait faire quelque chose à ce sujet).
- Prise en compte des limitations de mémoire et de CPU. Nous écrivons principalement des microservices en Golang et les déployons dans Kubernetes. Cela implique une particularité liée à Golang : par défaut, lorsque vous exécutez, tous les cœurs de la machine sont utilisés, à moins que la variable GOMAXPROCS ne soit explicitement définie. Lorsque plusieurs services de ce type sont lancés sur une même machine, ils commencent à se concurrencer pour les ressources, se gênant mutuellement. Les graphiques ci-dessous montrent comment le temps d'exécution varie lorsque l'application est lancée sans concurrence et en mode de compétition pour les ressources. (Les fichiers sources des graphiques sont disponibles. ).
Temps d'exécution, moins c'est mieux. Maximum : 643 ms, minimum : 42 ms. Photo cliquable.
Temps par opération, moins c'est mieux. Maximum : 14091 ns, minimum : 151 ns. Photo cliquable.
À l'étape de préparation de la build, vous pouvez définir cette variable explicitement ou utiliser la bibliothèque des gars d'Uber.
Déployer
• Vérification des conventions. Avant de commencer à livrer les builds du service dans les environnements prévus, il est nécessaire de vérifier ce qui suit :
— Endpoints API.
— Conformité des réponses des endpoints API au schéma.
— Format des logs.
— Réglage des en-têtes lors des requêtes au service (cela est actuellement effectué par netramesh)
— Réglage d'un marqueur de propriétaire lors de l'envoi de messages dans le bus d'événements. Cela est nécessaire pour suivre la connectivité des services à travers le bus. Il est possible d'envoyer dans le bus des données idempotentes, ne renforçant pas la connectivité des services (ce qui est bien), ainsi que des données métier, qui renforcent la connectivité des services (ce qui est très problématique !). Et au moment où cette connectivité devient un problème, comprendre qui écrit et lit le bus aide à bien séparer les services.
Pour l'instant, il n'y a pas beaucoup de conventions chez Avito, mais leur nombre augmente. Plus il y a d'accords de ce type dans une forme compréhensible et pratique pour l'équipe, plus il est facile de maintenir la cohérence entre les microservices.
Tests synthétiques
• Test dans un environnement contrôlé. Pour cela, nous utilisons actuellement l'open source . D'abord, il enregistre la charge réelle sur le service, puis — dans un circuit fermé — il l'émule.
• Test de charge. Nous essayons d'optimiser la performance de tous nos services. Et chaque version de chaque service doit être soumise à des tests de charge — cela nous permet de comprendre la performance actuelle du service et la différence avec les versions précédentes. Si après une mise à jour, la performance du service a chuté de 50 %, c'est un signal clair pour ses propriétaires : il faut plonger dans le code et corriger la situation.
Nous nous basons sur les données collectées, par exemple, pour implémenter correctement l'auto-scaling et, finalement, comprendre dans quelle mesure le service est scalable.
Lors des tests de charge, nous vérifions si la consommation des ressources respecte les limites fixées. Nous mettons particulièrement l'accent sur les extrêmes.
a) Nous examinons la charge globale.
— Trop faible — il est probable que quelque chose ne fonctionne pas du tout si la charge a soudainement chuté plusieurs fois.
— Trop élevée — une optimisation est requise.
b) Nous examinons le seuil en RPS.
Nous regardons ici la différence entre la version actuelle et la précédente ainsi que le nombre total. Par exemple, si le service génère 100 rps — cela signifie soit qu'il est mal écrit, soit que c'est sa spécificité, mais dans tous les cas, c'est une raison de prêter une attention particulière au service.
Si au contraire le RPS est trop élevé, il se peut qu'il y ait un bug et qu'un de ses endpoints ait cessé d'exécuter la charge utile, et se contente simplement de déclencher quelque chose. return true;
Tests Canary
Après avoir passé les tests synthétiques, nous testons le fonctionnement du microservice sur un petit nombre d'utilisateurs. Nous commençons prudemment, avec une fraction minuscule de l'audience prévue du service — moins de 0,1 %. À ce stade, il est très important que les bonnes métriques techniques et produit soient mises en place dans le monitoring, afin qu'elles montrent le problème dans le service le plus rapidement possible. La durée minimale d'un test canary est de 5 minutes, et la durée principale est de 2 heures. Pour les services complexes, nous réglons le temps manuellement.
Nous analysons :
— des métriques spécifiques au langage, en particulier les workers php-fpm;
— les erreurs dans Sentry;
— les statuts des réponses;
— le temps de réponse (response time), exact et moyen;
— la latence;
— les exceptions, traitées et non traitées;
— les métriques produit.
Test de Compression
Les tests de compression sont également appelés tests par « extrusion ». Cette méthode a été introduite par Netflix. Le principe est que nous remplissons d'abord une instance avec un véritable trafic jusqu'à saturation, ce qui nous permet de définir son plafond. Nous ajoutons ensuite une autre instance et chargeons ce groupe à nouveau jusqu'à son maximum ; nous observons leur capacité maximale et la différence avec le premier « squeeze ». Nous ajoutons alors une instance à la fois et calculons les régularités dans les variations.
Les données des tests par « extrusion » sont également accumulées dans une base de métriques commune, où nous enrichissons soit les résultats de la charge artificielle, soit nous les remplaçons entièrement par des « synthétiques ».
Production
• Mise à l'échelle. Lors du déploiement d'un service en production, nous surveillons comment il se met à l'échelle. Surveiller uniquement les indicateurs CPU, selon notre expérience, n'est pas efficace. La mise à l'échelle automatique avec le benchmarking RPS fonctionne en théorie, mais uniquement pour certains services, comme le streaming en ligne. Nous nous concentrons donc d'abord sur les métriques produits spécifiques à l'application.
En fin de compte, lors de la mise à l'échelle, nous analysons :
— les indicateurs CPU et RAM,
— le nombre de requêtes en attente,
— le temps de réponse,
— les prévisions basées sur des données historiques accumulées.
Lors de la mise à l'échelle d'un service, il est également important de surveiller ses dépendances, afin que nous ne mettions pas en échelle le premier service de la chaîne tandis que ceux auxquels il fait appel s'effondrent sous la charge. Pour établir une charge acceptable pour l'ensemble du pool de services, nous examinons les données historiques du service dépendant « le plus proche » (en tenant compte de la combinaison des indicateurs CPU et RAM avec les métriques spécifiques à l'application) et les comparons avec les données historiques du service d'initialisation, et ainsi de suite à travers toute la « chaîne des dépendances », du haut vers le bas.
Maintenance
Une fois que le microservice est opérationnel, nous pouvons y attacher des déclencheurs.
Voici des situations typiques où les déclencheurs se déclenchent.
— Des migrations potentiellement dangereuses ont été détectées.
— Des mises à jour de sécurité ont été publiées.
— Le service n'a pas été mis à jour depuis longtemps.
— La charge sur le service a considérablement diminué ou certaines de ses métriques produits sortent de la norme.
— Le service ne respecte plus les nouvelles exigences de la plateforme.
Une partie des triggers est responsable de la stabilité du fonctionnement, une autre sert de fonction de maintenance du système, par exemple, un service n'a pas été déployé depuis longtemps et son image de base a cessé de passer les vérifications de sécurité.
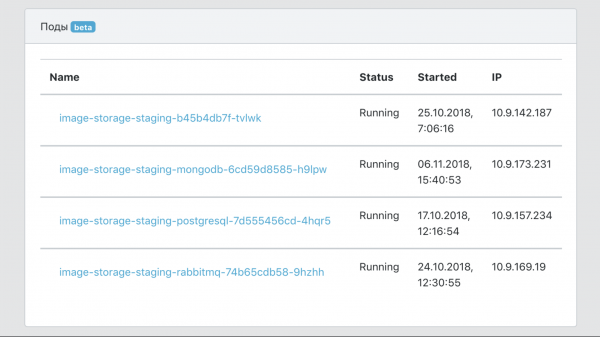
Tableau de bord
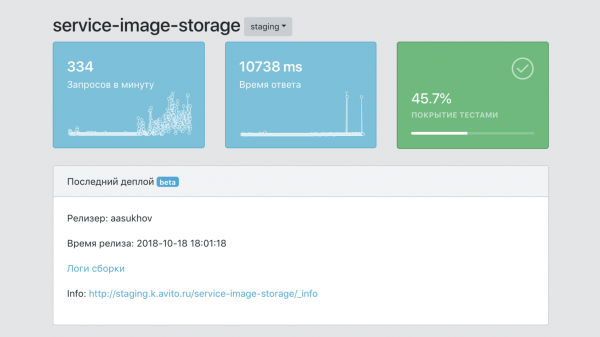
En résumé, le tableau de bord est le panneau de contrôle de notre PaaS.
- Un point d'information unique sur le service, avec des données sur sa couverture de tests, le nombre de ses images, le nombre de copies en production, les versions, etc.
- Un outil de filtrage des données par services et labels (marqueurs d'appartenance à des unités commerciales, fonctionnalité produit, etc.)
- Un outil d'intégration avec des outils d'infrastructure pour le traçage, la journalisation, la surveillance.
- Un point de documentation unique pour les services.
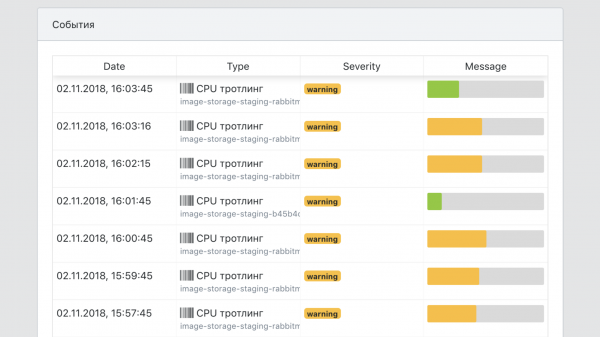
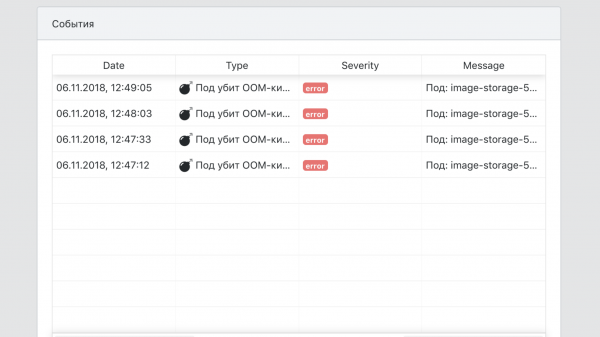
- Un point de vue unique sur tous les événements des services.
Au total
Avant l'implémentation de PaaS, un nouveau développeur pouvait passer plusieurs semaines à se familiariser avec tous les outils nécessaires pour déployer un microservice en production : Kubernetes, Helm, dans nos spécificités internes TeamCity, la configuration de la connexion aux bases de données et aux caches en mode tolérant aux pannes, etc. Maintenant, cela prend quelques heures — lire le quickstart et réaliser le service lui-même.
J'ai fait une présentation sur ce sujet pour HighLoad++ 2018, vous pouvez la consulter. et .
Une piste bonus pour ceux qui ont lu jusqu'à la fin.
Nous, chez Avito, organisons une formation interne de trois jours pour les développeurs par , un expert en architecture de microservices. Nous souhaitons offrir la possibilité d'y participer à l'un des lecteurs de ce post. Le programme de la formation est disponible.
La formation se déroulera du 5 au 7 août à Moscou. Ce sont des jours ouvrables qui seront complètement occupés. Le déjeuner et la formation se dérouleront dans nos bureaux, et le participant choisi devra payer son transport et son hébergement.
Vous pouvez postuler pour y participer . De votre part, une réponse à la question de savoir pourquoi vous devez participer à la formation et des informations sur la façon de vous contacter. Répondez en anglais, car Chris choisira lui-même le participant qui ira à la formation.
Nous annoncerons le nom du participant à la formation par une mise à jour de ce post et sur les réseaux sociaux d'Avito pour les développeurs (AvitoTech sur , , ) au plus tard le 19 juillet.
Source : habr.com
