

Bonjour, membres de Habr ! Ce livre est destiné à tout développeur souhaitant comprendre le traitement de flux. Maîtriser la programmation distribuée facilitera l'apprentissage de Kafka et de Kafka Streams. Il serait utile de connaître le framework Kafka, mais ce n'est pas obligatoire : je vous expliquerai tout ce qu'il faut savoir. Tant les développeurs expérimentés que les débutants pourront grâce à ce livre maîtriser la création d'applications intéressantes pour le traitement de flux en utilisant la bibliothèque Kafka Streams. Les développeurs Java de niveau intermédiaire et avancé, déjà familiarisés avec des concepts tels que la sérialisation, apprendront à appliquer leurs compétences pour développer des applications Kafka Streams. Le code source du livre est écrit en Java 8 et utilise de manière significative la syntaxe des expressions lambda de Java 8, donc être capable de travailler avec des fonctions lambda (même dans un autre langage de programmation) vous sera utile.
Extrait. 5.3. Agrégation et opérations fenêtres
Dans cette section, nous allons explorer les parties les plus prometteuses de Kafka Streams. Jusqu'à présent, nous avons examiné les aspects suivants de Kafka Streams :
- création de topologies de traitement ;
- utilisation des états dans les applications de flux ;
- exécution des jointures de flux de données ;
- différences entre les flux d'événements (KStream) et les flux de mise à jour (KTable).
Dans les exemples suivants, nous allons rassembler tous ces éléments. De plus, vous découvrirez les opérations fenêtres — une autre excellente fonctionnalité des applications de flux. Notre premier exemple sera une agrégation simple.
5.3.1. Agrégation du volume des ventes d'actions par secteur industriel
L'agrégation et le regroupement sont des outils essentiels lors du travail avec des données de flux. L'examen des enregistrements individuels à mesure qu'ils arrivent s'avère souvent insuffisant. Pour extraire des informations supplémentaires à partir des données, il est nécessaire de les regrouper et de les combiner.
Dans cet exemple, vous serez dans la peau d'un trader intraday qui doit suivre le volume des ventes d'actions des entreprises dans plusieurs secteurs industriels. Plus précisément, vous vous intéresserez aux cinq entreprises ayant les volumes de vente d'actions les plus élevés dans chacun des secteurs industriels.
Pour réaliser une telle agrégation, plusieurs étapes seront nécessaires pour convertir les données au format requis (en termes généraux).
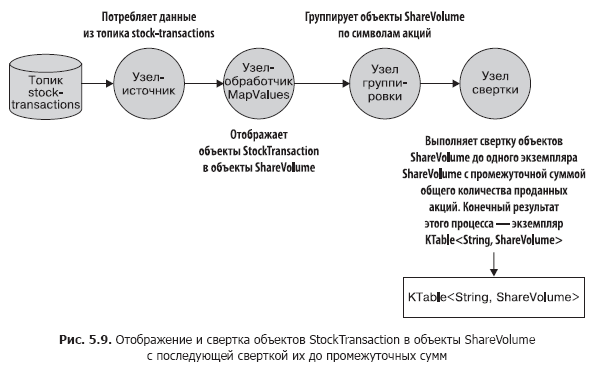
- Créer une source basée sur un sujet publiant des informations brutes sur le commerce des actions. Nous devrons mapper l'objet de type StockTransaction à un objet de type ShareVolume. Le fait est que l'objet StockTransaction contient des métadonnées sur les ventes, et nous avons uniquement besoin des données concernant le nombre d'actions vendues.
- Regrouper les données ShareVolume par symboles d'actions. Après avoir regroupé par symboles, il est possible de réduire ces données à des totaux intermédiaires des volumes de ventes d'actions. Il convient de noter que la méthode KStream.groupBy renvoie une instance de type KGroupedStream. Et pour obtenir une instance de KTable, il suffit d'appeler ensuite la méthode KGroupedStream.reduce.
Qu'est-ce que l'interface KGroupedStream ?
Les méthodes KStream.groupBy et KStream.groupByKey renvoient une instance de KGroupedStream. KGroupedStream est une représentation intermédiaire d'un flux d'événements après regroupement par clés. Il n'est pas du tout destiné à être utilisé directement. Au lieu de cela, KGroupedStream est utilisé pour des opérations d'agrégation, dont le résultat est toujours un KTable. Et puisque le résultat des opérations d'agrégation est un KTable et que le stockage d'état est utilisé, il se peut que toutes les mises à jour ne soient pas envoyées plus loin dans le pipeline.
La méthode KTable.groupBy renvoie un KGroupedTable similaire — une représentation intermédiaire d'un flux de mises à jour regroupées par clé.
Faisons une petite pause et regardons la fig. 5.9, qui montre ce que nous avons atteint. Cette topologie devrait déjà vous être familière.
Jetons maintenant un coup d'œil au code pour cette topologie (vous pouvez le trouver dans le fichier src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.2).
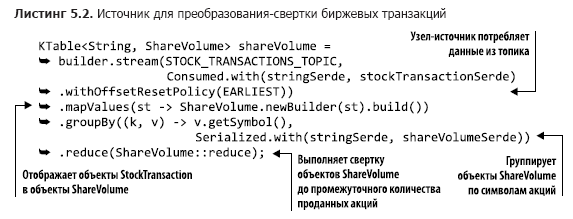
Le code fourni se distingue par sa concision et le grand nombre d'actions effectuées en quelques lignes. Dans le premier paramètre de la méthode builder.stream, vous pouvez remarquer quelque chose de nouveau : la valeur de l'énumération AutoOffsetReset.EARLIEST (il existe également LATEST), définie à l'aide de la méthode Consumed.withOffsetResetPolicy. Avec ce type d'énumération, vous pouvez spécifier la stratégie de réinitialisation des offsets pour chaque KStream ou KTable, qui a la priorité sur le paramètre de réinitialisation des offsets de la configuration.
GroupByKey et GroupBy
Dans l'interface KStream, il existe deux méthodes pour regrouper des enregistrements : GroupByKey et GroupBy. Les deux renvoient un KGroupedTable, vous pouvez donc vous poser la question : quelle est la différence entre elles et quand utiliser l'une ou l'autre ?
La méthode GroupByKey est utilisée lorsque les clés dans KStream sont déjà non vides. De plus, le drapeau « nécessite un re-séquençage » n'a jamais été activé.
La méthode GroupBy suppose que vous avez modifié les clés pour le regroupement, donc le drapeau de re-séquençage est défini sur true. L'exécution après la méthode GroupBy de jointures, d'agrégations, etc. entraînera un re-séquençage automatique.
Résumé : il est préférable d'utiliser GroupByKey chaque fois que possible, plutôt que GroupBy.
Les méthodes mapValues et groupBy sont claires, regardons donc la méthode sum() (que vous pouvez trouver dans le fichier src/main/java/bbejeck/model/ShareVolume.java) (listing 5.3).
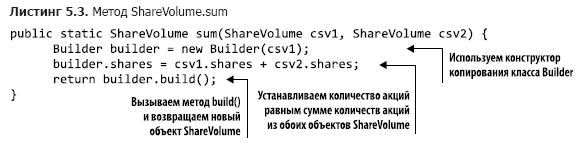
La méthode ShareVolume.sum retourne la somme intermédiaire du volume des ventes d'actions, et le résultat de toute la chaîne de calculs est un objet KTable. Maintenant, vous comprenez le rôle de KTable. En réceptionnant des objets ShareVolume, la dernière mise à jour valide est conservée dans l'objet KTable correspondant. Il est important de ne pas oublier que toutes les mises à jour sont reflétées dans le shareVolumeKTable précédent, mais pas toutes sont transmises ultérieurement.
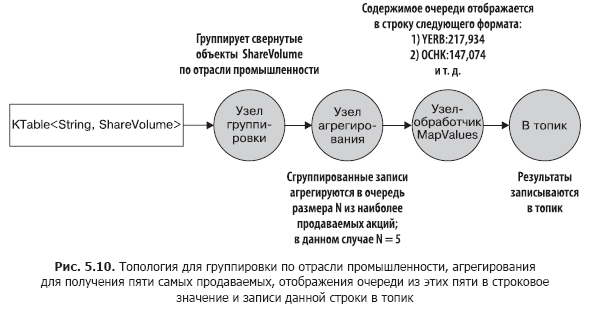
Ensuite, à l'aide de ce KTable, nous effectuons une agrégation (par le nombre d'actions vendues) pour obtenir les cinq entreprises avec le plus grand volume de ventes d'actions dans chaque secteur. Nos actions seront similaires aux actions lors de la première agrégation.
- Effectuer une autre opération groupBy pour regrouper les objets ShareVolume par secteurs d'activité.
- Commencer à sommer les objets ShareVolume. Cette fois, l'objet d'agrégation est une file d'attente de priorité de taille fixe. Dans cette file d'attente de taille fixe, seules cinq entreprises avec le plus grand nombre d'actions vendues sont conservées.
- Convertir les files d'attente du point précédent en une valeur de chaîne et retourner les cinq entreprises les plus vendues en termes d'actions par secteur d'activité.
- Écrire les résultats sous forme de chaîne dans le topic.
La figure 5.10 montre le graphique de la topologie du mouvement des données. Comme vous pouvez le voir, le deuxième cercle de traitement est assez simple.
Maintenant que vous avez bien compris la structure de ce deuxième cercle de traitement, vous pouvez consulter son code source (vous le trouverez dans le fichier src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.4).
Dans cet initialiseur, il y a une variable fixedQueue. C'est un objet utilisateur — un adaptateur pour java.util.TreeSet, qui est utilisé pour suivre les N résultats les plus importants dans l'ordre décroissant du nombre d'actions vendues.
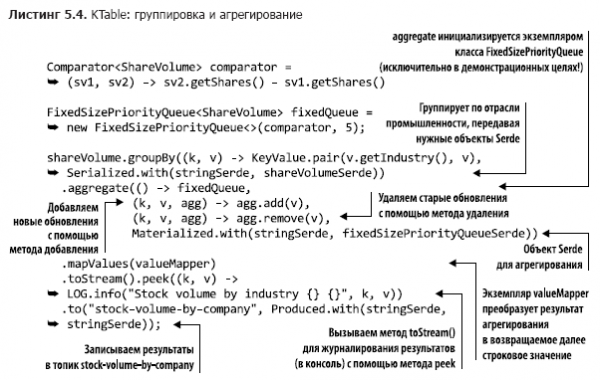
Vous avez déjà rencontré les appels groupBy et mapValues, donc nous ne les aborderons pas ici (nous appelons la méthode KTable.toStream, car la méthode KTable.print est considérée comme obsolète). Mais vous n'avez pas encore vu la version KTable de la méthode aggregate(), alors nous allons consacrer un peu de temps à sa discussion.
Comme vous le savez, KTable se distingue par le fait que les enregistrements avec des clés identiques sont considérés comme des mises à jour. KTable remplace l'ancien enregistrement par un nouveau. L'agrégation se produit de la même manière : les derniers enregistrements avec une clé unique sont agrégés. Lorsqu'un enregistrement arrive, il est ajouté à une instance de la classe FixedSizePriorityQueue à l'aide d'un accumulateur (le deuxième paramètre dans l'appel de la méthode aggregate), mais si un autre enregistrement avec la même clé existe déjà, l'ancien enregistrement est supprimé à l'aide d'un déduiseur (le troisième paramètre dans l'appel de la méthode aggregate).
Tout cela signifie que notre agrégateur, FixedSizePriorityQueue, n'agrège pas toutes les valeurs avec une même clé, mais conserve la somme glissante des quantités des N types d'actions les plus vendus. Chaque enregistrement entrant contient le nombre total d'actions vendues jusqu'à présent. KTable vous donnera des informations sur les actions des entreprises qui se vendent le plus en ce moment, l'agrégation glissante de chaque mise à jour n'est pas nécessaire.
Nous avons appris à faire deux choses importantes :
- grouper les valeurs dans KTable par une clé commune ;
- effectuer sur ces valeurs regroupées des opérations utiles, telles que la réduction et l'agrégation.
Être capable d'effectuer ces opérations est important pour comprendre le sens des données circulant à travers l'application Kafka Streams et déterminer quelle information elles transportent.
Nous avons également rassemblé certains des concepts clés discutés précédemment dans ce livre. Au chapitre 4, nous avons évoqué l'importance d'un état local résilient pour une application de streaming. Le premier exemple de ce chapitre a démontré pourquoi l'état local est si important : il permet de suivre les informations que vous avez déjà vues. L'accès local permet d'éviter les latences réseau, ce qui rend l'application plus performante et plus résiliente aux erreurs.
Lors de l'exécution de toute opération de réduction ou d'agrégation, il est nécessaire d'indiquer le nom du magasin d'état. Les opérations de réduction et d'agrégation retournent une instance de KTable, et KTable utilise le magasin d'état pour remplacer les anciens résultats par les nouveaux. Comme vous l'avez vu, toutes les mises à jour ne sont pas envoyées plus loin dans le pipeline, et c'est important car les opérations d'agrégation sont destinées à obtenir des informations finales. Si vous n'utilisez pas l'état local, KTable enverra toutes les résultats d'agrégation et de réduction.
Voyons maintenant l'exécution d'opérations telles que l'agrégation sur une période de temps spécifique — ce que l'on appelle les opérations de fenêtrage (windowing operations).
5.3.2. Opérations de fenêtrage
Dans la section précédente, nous avons découvert les opérations de réduction et d'agrégation « glissantes ». L'application effectuait une réduction continue du volume des ventes d'actions, suivie de l'agrégation des cinq actions les plus vendues sur le marché.
Parfois, de telles agrégations et réductions continues des résultats sont nécessaires. D'autres fois, il est requis d'effectuer des opérations uniquement sur une période de temps définie. Par exemple, calculer combien d'opérations boursières ont été effectuées sur les actions d'une entreprise spécifique au cours des 10 dernières minutes. Ou combien d'utilisateurs ont cliqué sur la nouvelle bannière publicitaire au cours des 15 dernières minutes. L'application peut effectuer ces opérations plusieurs fois, mais avec des résultats relatifs uniquement aux périodes de temps spécifiées (fenêtres temporelles).
Comptage des transactions boursières par acheteur
Dans l'exemple suivant, nous allons suivre les transactions boursières de plusieurs traders — soit de grandes organisations, soit des financiers indépendants astucieux.
Il existe deux raisons possibles pour un tel suivi. L'une d'elles est la nécessité de savoir ce que les leaders du marché achètent/vendent. Si ces grands acteurs et investisseurs avertis voient des opportunités se présenter, il est judicieux de suivre leur stratégie. La seconde raison concerne le désir de déceler tout signe potentiel de transactions illégales utilisant des informations internes. Pour cela, il vous faudra analyser la corrélation entre de grands pics de vente et d'importants communiqués de presse.
Ce suivi comprend les étapes suivantes :
- la création d'un flux de lecture à partir du topic stock-transactions ;
- le regroupement des enregistrements entrants par identifiant d'acheteur et symbole boursier. L'appel de la méthode groupBy retourne une instance de la classe KGroupedStream ;
- le retour de données par KGroupedStream.windowedBy, un flux de données limité par une fenêtre temporelle, permettant d'effectuer une agrégation par fenêtres. Selon le type de fenêtre, cela retourne soit un TimeWindowedKStream, soit un SessionWindowedKStream ;
- le comptage des transactions pour l'opération d'agrégation. Le flux de données par fenêtre détermine si un enregistrement spécifique est pris en compte dans ce comptage ;
- l'enregistrement des résultats dans un topic ou leur affichage dans la console pendant le développement.
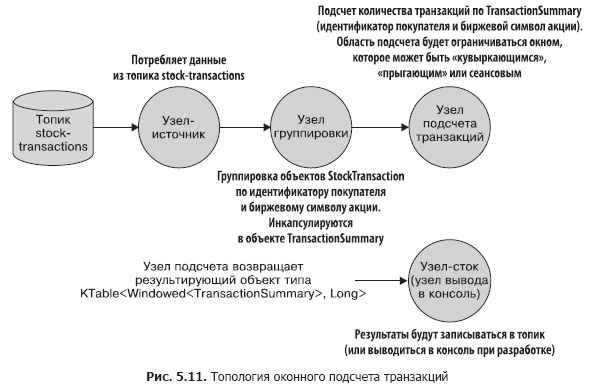
La topologie de cette application est simple, mais une illustration claire n'est pas superflue. Regardons la figure 5.11.
Nous examinerons ensuite la fonctionnalité des opérations par fenêtres et le code associé.
Types de fenêtres
Dans Kafka Streams, il existe trois types de fenêtres :
- de session ;
- «tumbling» ;
- glissantes/«hopping».
Le choix dépend des exigences métiers. Les fenêtres «tumbling» et «hopping» sont limitées dans le temps, tandis que les limites des fenêtres de session sont liées aux actions des utilisateurs — la durée de la ou des sessions est définie uniquement par l'activité de l'utilisateur. Il faut garder à l'esprit que tous les types de fenêtres se basent sur les marques de date/heure des enregistrements, et non sur l'heure système.
Nous allons ensuite réaliser notre topologie avec chacun des types de fenêtres. Le code complet sera fourni uniquement dans le premier exemple, pour les autres types de fenêtres, rien ne changera, sauf le type de l'opération de fenêtre.
Fenêtres de session
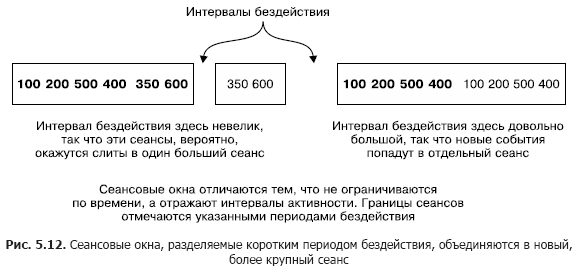
Les fenêtres de session diffèrent considérablement de tous les autres types de fenêtres. Elles ne sont pas limitées tant par le temps que par l'activité de l'utilisateur (ou l'activité de l'entité que vous souhaitez suivre). Les fenêtres de session sont délimitées par des périodes d'inactivité.
La figure 5.12 illustre le concept des fenêtres de session. Une session plus courte fusionnera avec la session à sa gauche. En revanche, la session à sa droite sera distincte, car elle succède à une longue période d'inactivité. Les fenêtres de session reposent sur les actions des utilisateurs, mais utilisent des horodatages des enregistrements pour déterminer à quelle session appartient un enregistrement.
Utilisation des fenêtres de session pour le suivi des transactions boursières
Nous utiliserons les fenêtres de session pour capturer des informations sur les transactions boursières. La mise en œuvre des fenêtres de session est présentée dans le listing 5.5 (qui peut être trouvé dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
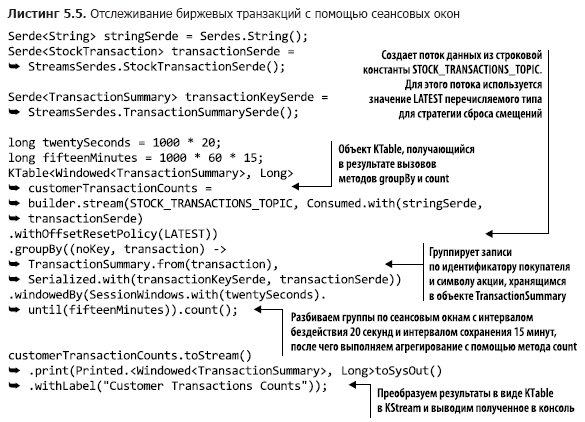
La plupart des opérations de cette topologie vous sont déjà familières, donc il n'est pas nécessaire de les examiner à nouveau ici. Mais il y a quelques nouveaux éléments que nous allons discuter.
Lors de toute opération groupBy, une opération d'agrégation (agrégation, réduction ou comptage) est généralement effectuée. On peut effectuer une agrégation cumulative avec un total accumulé, ou une agrégation de fenêtre, qui prend en compte les enregistrements dans une fenêtre temporelle définie.
Le code du listing 5.5 réalise un comptage des transactions dans les fenêtres de session. À la figure 5.13, ces actions sont analysées étape par étape.
Avec l'appel windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)), nous créons une fenêtre de session avec un intervalle d'inactivité de 20 secondes et un intervalle de conservation de 15 minutes. Un intervalle d'inactivité de 20 secondes signifie que l'application inclura tout enregistrement reçu dans les 20 secondes suivant la fin ou le début de la session actuelle dans la session actuelle (active).
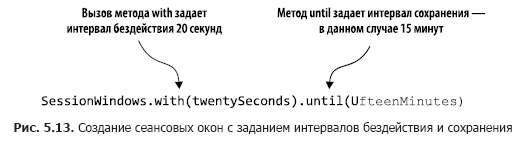
Ensuite, nous précisons quelle opération d'agrégation doit être effectuée dans la fenêtre de session — dans ce cas, le comptage. Si l'enregistrement entrant dépasse le délai d'inactivité (de chaque côté de l'horodatage), l'application crée une nouvelle session. L'intervalle de conservation signifie maintenir la session pour une certaine période et permet des données tardives dépassant la période d'inactivité de la session, mais qui peuvent encore être jointes. De plus, le début et la fin de la nouvelle session résultant de la fusion correspondent à l'horodatage le plus ancien et le plus récent.
Examinons quelques enregistrements de la méthode de comptage pour voir comment les sessions fonctionnent (tableau 5.1).
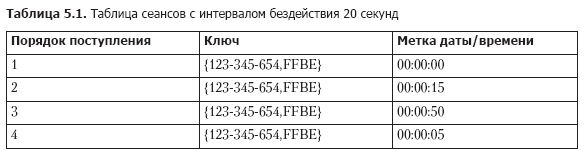
Lors de la réception des enregistrements, nous recherchons les sessions existantes avec la même clé, dont le temps de fin est inférieur à l'horodatage actuel — le délai d'inactivité — et le temps de début est supérieur à l'horodatage actuel + le délai d'inactivité. En tenant compte de cela, quatre enregistrements du tableau 5.1 sont fusionnés en une seule session comme suit.
1. Le premier enregistrement est reçu, donc le temps de début est égal à l'heure de fin et est 00:00:00.
2. Ensuite, l'enregistrement 2 arrive, et nous recherchons des sessions se terminant au plus tard à 23:59:55 et commençant au plus tard à 00:00:35. Nous trouvons l'enregistrement 1 et fusionnons les sessions 1 et 2. Nous prenons le temps de début de la session 1 (le plus ancien) et le temps de fin de la session 2 (le plus récent), de sorte que notre nouvelle session commence à 00:00:00 et se termine à 00:00:15.
3. L'enregistrement 3 arrive, nous recherchons des sessions entre 00:00:30 et 00:01:10 et ne trouvons aucune. Nous ajoutons la deuxième session pour la clé 123-345-654,FFBE, commençant et se terminant à 00:00:50.
4. L'enregistrement 4 arrive, et nous recherchons des sessions entre 23:59:45 et 00:00:25. Cette fois, les deux sessions — 1 et 2 — sont trouvées. Les trois sessions sont toutes fusionnées en une seule, avec un temps de début à 00:00:00 et un temps de fin à 00:00:15.
Il est important de retenir les points suivants tirés de cette section :
- les sessions ne sont pas des fenêtres de taille fixe. La durée d'une session est déterminée par l'activité dans la période de temps donnée ;
- les horodatages dans les données déterminent si un événement appartient à une session existante ou à une période d'inactivité.
Nous discuterons ensuite d'une autre variante des fenêtres — les fenêtres « roulantes ».
Les fenêtres « roulantes »
Les fenêtres « tumbling » capturent des événements qui se produisent au cours d'un intervalle de temps défini. Imaginez que vous devez capturer toutes les transactions boursières d'une entreprise toutes les 20 secondes, de sorte que vous collectez tous les événements pendant cette période. À la fin de l'intervalle de 20 secondes, la fenêtre « tumble » et passe à un nouvel intervalle d'observation de 20 secondes. La figure 5.14 illustre cette situation.
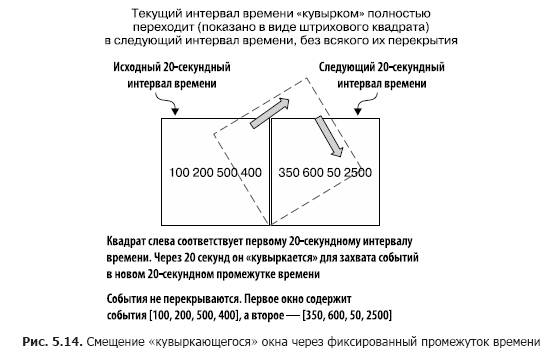
Comme vous pouvez le voir, tous les événements reçus au cours des 20 dernières secondes sont inclus dans la fenêtre. À la fin de cette période, une nouvelle fenêtre est créée.
Le listing 5.6 montre le code illustrant l'utilisation des fenêtres « tumbling » pour capturer toutes les 20 secondes les transactions boursières (vous pouvez le trouver dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
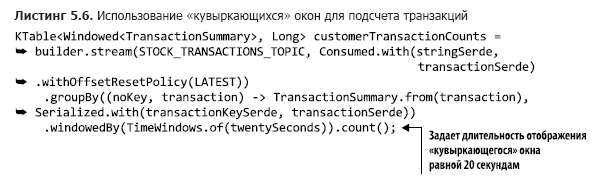
Grâce à ce petit changement dans l'appel de la méthode TimeWindows.of, il est possible d'utiliser une fenêtre « tumbling ». Dans cet exemple, il n'y a pas d'appel à la méthode until(), ce qui signifie que l'intervalle de conservation par défaut, qui est de 24 heures, sera utilisé.
Enfin, il est temps de passer à la dernière variante de fenêtres : les fenêtres « hopping ».
Fenêtres glissantes (« hopping »)
Les fenêtres glissantes « hopping » sont similaires aux fenêtres « tumbling », mais avec une légère différence. Les fenêtres glissantes ne attendent pas la fin du temps imparti avant de créer une nouvelle fenêtre pour traiter les événements récents. Elles lancent de nouveaux calculs après un intervalle d'attente qui est plus court que la durée de la fenêtre.
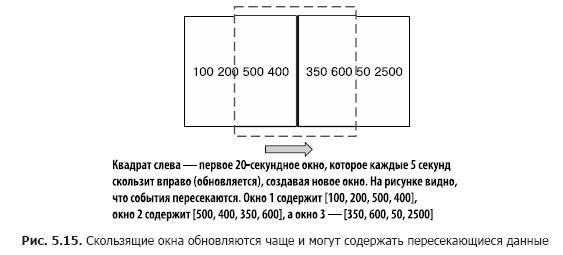
Pour illustrer les différences entre les fenêtres « tumbling » et « hopping », revenons à l'exemple de comptage des transactions boursières. Notre objectif reste de compter le nombre de transactions, mais nous ne voulons pas attendre toute la durée avant de mettre à jour le compteur. Au lieu de cela, nous allons mettre à jour le compteur par intervalles de temps plus courts. Par exemple, nous continuerons de compter le nombre de transactions toutes les 20 secondes, mais nous mettrons à jour le compteur toutes les 5 secondes, comme le montre la fig. 5.15. Cela nous donne trois fenêtres de résultats avec des données qui se chevauchent.
Le listing 5.7 montre le code pour définir les fenêtres glissantes (vous pouvez le trouver dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
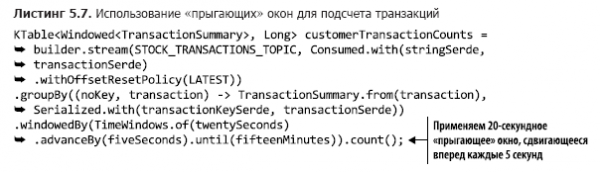
Une fenêtre « titubante » peut être transformée en fenêtre « sautante » en ajoutant l'appel de la méthode advanceBy(). Dans l'exemple donné, l'intervalle de conservation est de 15 minutes.
Vous avez vu dans cette section comment limiter les résultats d'agrégation par des fenêtres temporelles. En particulier, voici les trois choses que vous devriez retenir de cette section :
- la taille des fenêtres de session n'est pas limitée par une période de temps, mais par l'activité des utilisateurs ;
- les fenêtres « titubantes » fournissent un aperçu des événements sur une période donnée ;
- la durée de vie des fenêtres « sautantes » est fixe, mais elles sont souvent mises à jour et peuvent contenir des enregistrements qui se chevauchent dans toutes les fenêtres.
Nous allons maintenant voir comment transformer un KTable en KStream pour effectuer une jointure.
5.3.3. Jointure d'objets KStream et KTable
Dans le chapitre 4, nous avons discuté de la jointure de deux objets KStream. Maintenant, nous allons apprendre à joindre KTable et KStream. Cela peut être nécessaire pour la simple raison suivante. KStream est un flux d’enregistrements, et KTable est un flux de mises à jour d’enregistrements, mais parfois, il peut être nécessaire d'ajouter un contexte supplémentaire au flux d'enregistrements à l'aide de mises à jour de KTable.
Prenons des données sur le nombre de transactions boursières et joignons-les aux actualités boursières selon les secteurs d'activité concernés. Voici ce que nous devons faire pour atteindre cet objectif en tenant compte du code existant.
- Transformer l'objet KTable contenant les données sur le nombre de transactions boursières en KStream tout en remplaçant la clé par une clé indiquant le secteur d'activité correspondant à ce symbole boursier.
- Créer un objet KTable en lisant les données d'un sujet sur les actualités boursières. Ce nouveau KTable sera catégorisé par secteurs d'activité.
- Joindre les mises à jour des actualités avec les informations sur le nombre de transactions boursières par secteur d'activité.
Maintenant, voyons comment mettre en œuvre ce plan d'action.
Transformation de KTable en KStream
Pour transformer un KTable en KStream, il est nécessaire de procéder comme suit.
- Appeler la méthode KTable.toStream().
- En appelant la méthode KStream.map, remplacer la clé par le nom du secteur d'activité, puis extraire à partir de l'instance Windowed l'objet TransactionSummary.
Nous allons enchaîner ces opérations de la manière suivante (le code peut être trouvé dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
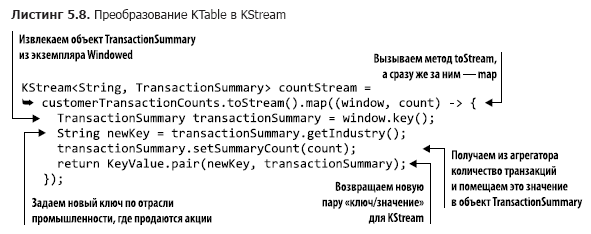
Puisque nous effectuons l'opération KStream.map, le re-partitionnement pour l'instance KStream retournée est automatiquement effectué lors de son utilisation dans une jointure.
Nous avons terminé le processus de transformation, maintenant nous devons créer un objet KTable pour lire les nouvelles du marché.
Créer un KTable pour les nouvelles du marché.
Heureusement, créer un objet KTable nécessite juste une ligne de code (ce code peut être trouvé dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.9).
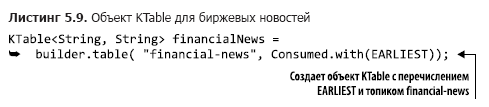
Il convient de noter qu'aucun objet Serde n'est nécessaire car des Serde de chaînes sont utilisés dans les configurations. De plus, grâce à l'utilisation de l'énumération EARLIEST, la table est remplie avec des enregistrements dès le début.
Nous pouvons maintenant passer à l'étape finale — la jointure.
Jointure des mises à jour d'actualités avec les données sur le nombre de transactions.
La création de la jointure ne pose pas de difficultés. Nous utiliserons une jointure gauche au cas où il n'y aurait pas de nouvelles du marché pour l'industrie correspondante (le code requis peut être trouvé dans le fichier src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.10).
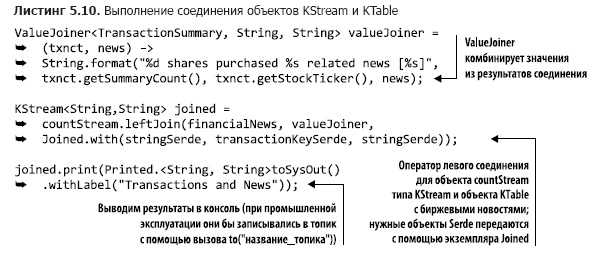
Cette opération leftJoin est assez simple. Contrairement aux jointures du chapitre 4, la méthode JoinWindow n'est pas utilisée car lors de la jointure KStream-KTable, il n'y a qu'un seul enregistrement pour chaque clé dans le KTable. Cette jointure n'est pas limitée dans le temps : l'enregistrement est soit dans le KTable, soit il n'y est pas. En résumé, avec des objets KTable, on peut enrichir KStream avec des données de référence moins fréquemment mises à jour.
Passons maintenant à une manière plus efficace d'enrichir les événements provenant de KStream.
5.3.4. Objets GlobalKTable.
Comme vous l'avez compris, il existe un besoin d'enrichir les flux d'événements ou d'y ajouter du contexte. Dans le chapitre 4, vous avez vu des jointures entre deux objets KStream, et dans la section précédente, la jointure entre KStream et KTable. Dans tous ces cas, il est nécessaire de re-partitionner le flux de données lors de la mappage des clés à un nouveau type ou valeur. Parfois, le re-partitionnement est effectué explicitement, et parfois Kafka Streams le fait automatiquement. Le re-partitionnement est nécessaire car les clés ont changé et les enregistrements doivent se trouver dans de nouvelles partitions, sinon la jointure sera impossible (ce qui a été discuté au chapitre 4, section "Re-partitionnement des données", sous-section 4.2.4).
La re-sécurisation a un coût
La re-sécurisation nécessite des coûts supplémentaires — des ressources supplémentaires pour créer des sujets intermédiaires, stocker des données dupliquées dans un autre sujet ; cela implique également une augmentation de la latence due aux opérations d'écriture et de lecture de ce sujet. De plus, si vous devez effectuer des jointures sur plus d'un aspect ou dimension, il faut organiser ces jointures en chaîne, mapper les enregistrements avec de nouvelles clés et répéter le processus de re-sécurisation.
Jointure avec des ensembles de données de plus petite taille
Dans certains cas, le volume de données de référence prévu pour la jointure est relativement faible, de sorte que les copies complètes peuvent tenir localement sur chacun des nœuds. Pour de telles situations, Kafka Streams prévoit une classe GlobalKTable.
Les instances de GlobalKTable sont uniques, car l'application réplique toutes les données sur chaque nœud. Étant donné que toutes les données sont présentes sur chaque nœud, il n'est pas nécessaire de partitionner le flux d'événements par la clé des données de référence pour qu'il soit accessible à toutes les partitions. Avec les objets GlobalKTable, il est également possible d'effectuer des jointures sans clé. Revenons à l'un des exemples précédents pour illustrer cette capacité.
Jointure d'objets KStream avec des objets GlobalKTable
Dans la sous-section 5.3.2, nous avons effectué une agrégation temporelle des transactions boursières par client. Les résultats de cette agrégation ressemblaient à ceci :
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Bien que ces résultats correspondent à l'objectif visé, il serait plus pratique d'afficher également le nom du client et le nom complet de l'entreprise. Pour ajouter le nom de l'acheteur et le nom de l'entreprise, des jointures standard peuvent être effectuées, mais cela nécessitera deux mappings de clés et une re-partition. Avec GlobalKTable, ces opérations peuvent être évitées.
Pour ce faire, nous allons utiliser l'objet countStream de l'extrait 5.11 (le code correspondant peut être trouvé dans le fichier src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), en le joignant à deux objets GlobalKTable.
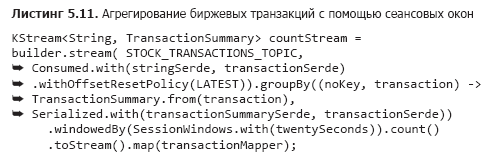
Nous en avons déjà discuté précédemment, donc je ne vais pas me répéter. Mais je tiens à noter que le code dans la fonction toStream().map a été abstrait dans un objet-fonction pour des raisons de lisibilité, au lieu d'utiliser une expression lambda intégrée.
L'étape suivante consiste à déclarer deux instances de GlobalKTable (le code correspondant se trouve dans le fichier src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listing 5.12).
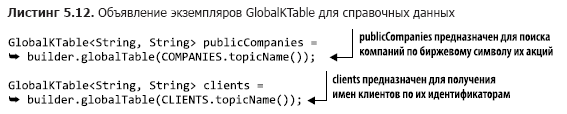
Notez que les noms des topics sont décrits à l'aide de types énumérés.
Maintenant que nous avons préparé tous les composants, il ne reste plus qu'à écrire le code pour la jointure (que vous pouvez trouver dans le fichier src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listing 5.13).
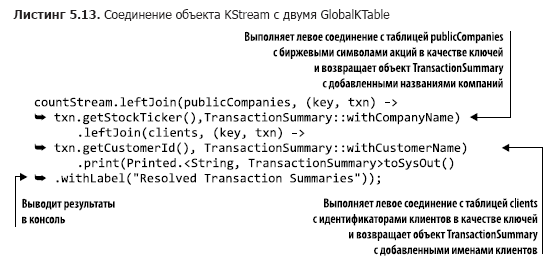
Bien que ce code contienne deux jointures, elles sont organisées sous forme de chaîne, car aucun des résultats n'est utilisé individuellement. Les résultats sont affichés à la fin de l'opération entière.
Lorsque vous exécuterez l'opération de jointure ci-dessus, vous obtiendrez des résultats de ce type :
{customer='Barney, Smith' company="Exxon", transactions= 17}L'essence n'a pas changé, mais ces résultats sont plus lisibles.
Si l'on considère le chapitre 4, vous avez déjà vu plusieurs types de jointures en action. Elles sont répertoriées dans le tableau 5.2. Ce tableau reflète les capacités de jointure pertinentes pour la version 1.0.0 de Kafka Streams ; dans les prochaines versions, il pourrait y avoir des changements.
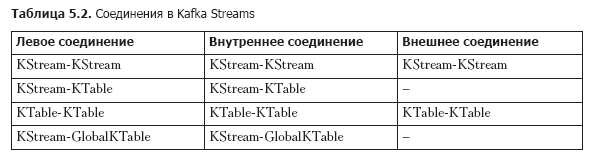
En conclusion, rappelons l'essentiel : vous pouvez joindre des flux d'événements (KStream) et des flux de mises à jour (KTable) à l'aide d'un état local. De plus, si la taille des données de référence n'est pas trop grande, vous pouvez utiliser l'objet GlobalKTable. GlobalKTable réplique toutes les partitions sur chacun des nœuds de l'application Kafka Streams, garantissant ainsi l'accessibilité de toutes les données, quel que soit le partitionnement associé à la clé.
Nous allons maintenant découvrir une fonctionnalité de Kafka Streams qui permet d'observer les changements d'état sans consommer de données depuis un topic Kafka.
5.3.5. État accessible aux requêtes
Nous avons déjà réalisé plusieurs opérations impliquant un état et avons toujours affiché les résultats dans la console (à des fins de développement) ou les avons enregistrés dans un topic (pour des fins de production). Lors de l'enregistrement des résultats dans un topic, il est nécessaire d'utiliser un consommateur Kafka pour les consulter.
La lecture des données à partir de ces sujets peut être considérée comme une forme de vues matérialisées. Pour nos besoins, nous pouvons utiliser la définition d'une vue matérialisée provenant de « Wikipédia » : « ... un objet physique de base de données contenant les résultats de l'exécution d'une requête. Par exemple, il peut s'agir d'une copie locale de données distantes, ou d'un sous-ensemble de lignes et/ou de colonnes d'une table ou des résultats d'une jointure, ou d'un tableau croisé obtenu par agrégation » (https://fr.wikipedia.org/wiki/Vue_matrialise).
Kafka Streams permet également d'effectuer des requêtes interactives sur les magasins d'état, ce qui permet de lire directement ces vues matérialisées. Il est important de noter que les requêtes sur les magasins d'état sont des opérations en lecture seule. Cela signifie que vous n'avez pas à craindre de rendre l'état incohérent lors du traitement des données par l'application.
La possibilité d'effectuer des requêtes directement sur les magasins d'état est très importante. Cela signifie qu'il est possible de créer des applications — des tableaux de bord — sans avoir à d'abord récupérer les données du consommateur Kafka. Cela améliore également l'efficacité de l'application, car il n'est pas nécessaire de réécrire les données :
- en raison de la localité des données, on peut y accéder rapidement ;
- la duplication des données est évitée, car elles ne sont pas enregistrées dans un stockage externe.
Le principal point que je voudrais que vous reteniez est qu'il est possible d'exécuter des requêtes directement sur l'état depuis l'application. On ne saurait trop souligner les capacités que cela vous offre. Plutôt que de consommer des données à partir de Kafka et de stocker des enregistrements dans une base de données pour l'application, on peut effectuer des requêtes sur les magasins d'état avec le même résultat. Les requêtes directes sur les magasins d'état signifient moins de code (absence de consommateur) et moins de logiciels (absence de besoin d'une table de base de données pour stocker les résultats).
Nous avons couvert une quantité importante d'informations dans ce chapitre, nous allons donc suspendre notre discussion sur les requêtes interactives aux magasins d'état pour le moment. Mais ne vous inquiétez pas : au chapitre 9, nous allons créer une simple application - un tableau de bord avec des requêtes interactives. Pour démontrer les requêtes interactives et les possibilités de les intégrer dans les applications Kafka Streams, nous utiliserons certains des exemples de ce chapitre et du précédent.
Résumé
- Les objets KStream représentent des flux d'événements, comparables à des inserts dans une base de données. Les objets KTable représentent des flux de mises à jour, ils ressemblent davantage à des mises à jour dans une base de données. La taille de l'objet KTable ne croît pas, les anciennes entrées sont remplacées par les nouvelles.
- Les objets KTable sont nécessaires pour les opérations d'agrégation.
- Avec les opérations de fenêtres, vous pouvez segmenter les données agrégées en fonction de plages de temps.
- Grâce aux objets GlobalKTable, vous pouvez accéder aux données de référence à n'importe quel endroit de l'application, indépendamment du partitionnement par sections.
- Des jointures peuvent avoir lieu entre les objets KStream, KTable et GlobalKTable.
Jusqu'à présent, nous avons concentré notre attention sur la création d'applications Kafka Streams en utilisant le DSL KStream de haut niveau. Bien que l'approche de haut niveau permette de créer des programmes propres et concis, son utilisation représente un compromis certain. Travailler avec le DSL KStream signifie réduire la concision du code au profit d'un contrôle moindre. Dans le chapitre suivant, nous examinerons l'API bas niveau des nœuds de traitement et essayerons d'autres compromis. Les programmes deviendront plus longs que ce qu'ils étaient jusqu'à présent, mais nous aurons la possibilité de créer pratiquement n'importe quel nœud de traitement dont nous pourrions avoir besoin.
→ Vous pouvez en savoir plus sur le livre sur
→ Pour les membres de Habr, une réduction de 25% avec le coupon - Kafka Streams
→ Après le paiement de la version papier du livre, un livre électronique est envoyé par e-mail.
Source : habr.com
