

Dans cet article, je vais vous parler de la façon dont le projet sur lequel je travaille est passé d'un grand monolithe à un ensemble de microservices.
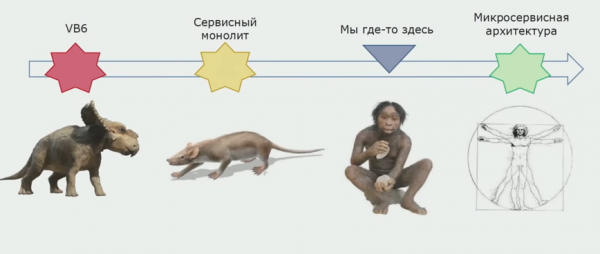
Le projet a commencé son histoire il y a longtemps, au début des années 2000. Les premières versions ont été écrites en Visual Basic 6. Au fil du temps, il est devenu clair que le développement dans ce langage serait difficile à maintenir à l'avenir, car l'IDE et le langage lui-même évoluent lentement. À la fin des années 2000, il a été décidé de passer à un C# plus prometteur. La nouvelle version a été développée parallèlement à l'ancienne, de plus en plus de code étant écrit en .NET. Le backend en C# était initialement orienté vers une architecture de services, mais durant le développement, des bibliothèques communes étaient utilisées, et les services étaient lancés dans un même processus. Cela a donné un applicatif que nous appelions « monolithe de services ».
L'un des rares avantages de cette combinaison était la possibilité pour les services de s'appeler mutuellement via une API externe. Il y avait des incitations claires à passer à une architecture de services plus correcte, et à terme, à une architecture microservices.
Nous avons commencé notre travail de décomposition vers 2015. Bien que nous n'ayons pas encore atteint un état idéal — il reste des parties du grand projet qui sont déjà difficiles à appeler des monolithes, mais qui ne ressemblent pas non plus à des microservices. Cependant, les progrès sont significatifs.
C'est ce dont je parlerai dans cet article.
Contenu
Architecture et problèmes de la solution existante
À l'origine, l'architecture était la suivante : l'UI était une application distincte, la partie monolithique était écrite en Visual Basic 6, et l'application .NET était un ensemble de services interconnectés fonctionnant avec une base de données assez importante.
Inconvénients de la solution précédente
Point de défaillance unique
Nous avions un point unique de défaillance : l'application .NET s'exécutait dans un seul processus. Si l'un des modules échouait, l'ensemble de l'application tombait, et il fallait la redémarrer. Étant donné que nous automatisons un grand nombre de processus pour différents utilisateurs, une défaillance dans l'un d'eux empêchait tout le monde de travailler pendant un certain temps. Et en cas d'erreur logicielle, la redondance ne servait à rien.
File d'attente des améliorations
Ce défaut est plutôt organisationnel. Notre application compte de nombreux clients, et tous souhaitent l'améliorer le plus rapidement possible. Auparavant, il était impossible de le faire en parallèle, et tous les clients faisaient la queue. Ce processus suscita des frustrations au sein de l'entreprise, car ils devaient prouver que leur tâche avait de la valeur. Pendant ce temps, l'équipe de développement passait du temps à organiser cette file d'attente. Cela prenait beaucoup de temps et d'énergie, et le produit ne pouvait finalement pas évoluer aussi rapidement que souhaité.
Utilisation non optimale des ressources
Lors de l'hébergement des services dans un processus unique, nous copions toujours intégralement la configuration d'un serveur à l'autre. Nous souhaitions héberger les services les plus chargés séparément, afin de ne pas gaspiller les ressources, et obtenir une gestion plus flexible de notre schéma de déploiement.
Difficulté à intégrer les technologies modernes
Un problème connu de tous les développeurs : il y a un désir d'intégrer des technologies modernes dans le projet, mais aucune possibilité. Avec une solution monolithique importante, toute mise à jour de la bibliothèque actuelle, sans parler d'un passage à une nouvelle, devient une tâche assez complexe. Il faut longtemps prouver à l'équipe que cela apportera plus d'avantages que de stress.
Complexité de la livraison des changements
C'était le problème le plus sérieux — nous publiions des versions tous les deux mois.
Chaque version se transformait en véritable catastrophe pour la banque, malgré les tests et les efforts des développeurs. L'entreprise comprenait qu'une partie de la fonctionnalité ne fonctionnerait pas au début de la semaine. Les développeurs, quant à eux, savaient qu'ils allaient faire face à une semaine d'incidents sérieux.
Le désir de changer la situation était partagé par tous.
Attentes vis-à-vis des microservices
Livraison des composants selon leur disponibilité. Livraison des composants au fur et à mesure de leur préparation grâce à la décomposition de la solution et à la séparation des différents processus.
De petites équipes produit. C'est important, car il est difficile de gérer une grande équipe travaillant sur un ancien monolithe. Une telle équipe doit suivre un processus strict, tandis qu'on aspire à plus de créativité et d'indépendance. Cela ne peut être permis qu'aux petites équipes.
Isolation des services dans des processus distincts. Idéalement, nous aimerions isoler dans des conteneurs, mais un grand nombre de services écrits en .NET Framework ne s'exécutent que sous Windows. Des services sur .NET Core émergent, mais ils sont encore peu nombreux.
Flexibilité de déploiement. Nous aimerions combiner les services comme cela est nécessaire pour nous, et non comme le code l'impose.
Utilisation de nouvelles technologies. C'est intéressant pour tout programmeur.
Problèmes de transition
Bien sûr, si décomposer un monolithe en microservices était facile, il n'y aurait pas besoin d'en parler lors des conférences et d'écrire des articles. Ce processus comporte de nombreux pièges; je vais décrire les principaux qui nous ont gênés.
Le premier problème caractéristique de la plupart des monolithes : la cohérence de la logique métier. Lorsque nous écrivons un monolithe, nous souhaitons réutiliser nos classes pour éviter d'écrire du code inutile. En passant aux microservices, cela devient un problème : tout le code est assez rigidement lié, rendant difficile la séparation des services.
Au moment où nous avons commencé à travailler, il y avait plus de 500 projets dans le référentiel et plus de 700 000 lignes de code. C'est une solution suffisamment grande et le deuxième problème. Prendre la décision de le diviser en microservices s'est révélé impossible.
Le troisième problème — manque d'infrastructure nécessaire. En fait, nous étions engagés dans une copie manuelle du code source sur les serveurs.
Comment passer du monolithe aux microservices
Dédoublage des microservices
Tout d'abord, nous avons immédiatement défini que la séparation des microservices est un processus itératif. On exigeait toujours de nous de mener parallèlement le développement des tâches commerciales. Comment nous allons procéder techniquement — c'est notre problème. Nous nous préparions donc à un processus itératif. Il n'y a pas d'autre moyen si vous avez une grande application qui n'est pas initialement prête à être réécrite.
Quelles méthodes utilisons-nous pour isoler les microservices?
Première méthode — extraire les modules existants en tant que services. À cet égard, nous avons eu de la chance : il y avait déjà des services configurés qui utilisaient le protocole WCF. Ils étaient répartis dans des assemblies distinctes. Nous les transfusions séparément, ajoutant à chaque assembly un petit module de démarrage. Ce dernier était écrit avec l'incroyable bibliothèque Topshelf, qui permet de lancer l'application à la fois en tant que service et en tant que console. C'est pratique pour le débogage, car aucun projet supplémentaire dans la solution n'est nécessaire.
Les services étaient liés par la logique métier, car ils utilisaient des assemblies communes et manipulaient une base de données partagée. Il était difficile de les qualifier de microservices au sens strict. Cependant, nous pouvions établir ces services séparément, dans des processus différents. Cela a déjà permis de réduire l'influence qu'ils exercent les uns sur les autres, diminuant ainsi les problèmes liés au développement parallèle et au point de défaillance unique.
L'assembly avec l'hôte ne nécessite qu'une ligne de code dans la classe Program. Nous avons caché l'utilisation de Topshelf dans une classe auxiliaire.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
La deuxième méthode de définition des microservices : les créer pour résoudre de nouveaux problèmes. Si le monolithe ne grandit pas dans ce cas, c'est déjà un bon signe, cela signifie que nous avançons dans la bonne direction. Pour des tâches nouvelles, nous essayions de créer des services distincts. Quand c'était possible, nous formions des services plus "canoniques", qui gèrent complètement leur propre modèle de données, et possèdent leur propre base de données.
Comme beaucoup d'autres, nous avons commencé par des services d'authentification et d'autorisation. Ils conviennent parfaitement à cet usage. Ils sont indépendants, en général, possèdent un modèle de données distinct. Ils n'interagissent pas avec le monolithe, seulement celui-ci les sollicite pour résoudre certaines tâches. Ces services peuvent servir de point de départ pour la transition vers une nouvelle architecture, pour affiner l'infrastructure, essayer certaines approches liées aux bibliothèques réseau, etc. Dans notre organisation, il n'y a pas d'équipes qui n'ont pas réussi à créer un service d'authentification.
La troisième méthode de définition des microservices, qui nous concerne, est un peu spécifique à nous. C'est l'extraction de la logique métier de la couche UI. Notre application principale UI est desktop, et, tout comme le backend, elle est écrite en C#. Les développeurs font parfois des erreurs et déplacent vers l'UI des parties de la logique qui devraient exister dans le backend et être réutilisées.
Si l'on regarde un exemple réel du code de la partie UI, on peut voir que la majeure partie de cette solution contient de la véritable logique métier, qui est utile dans d'autres processus, pas seulement pour construire des formulaires UI.
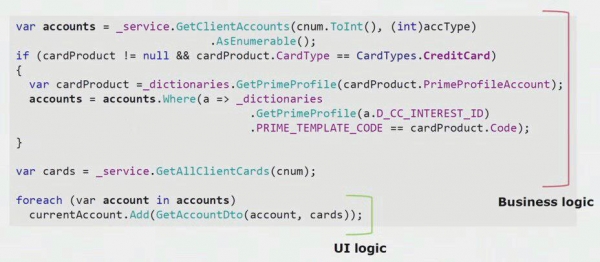
Il n'y a que les dernières lignes de véritable logique UI. Nous l'avons transférée sur le serveur afin de pouvoir la réutiliser, réduisant ainsi l'UI et atteignant une architecture correcte.
La quatrième et plus importante méthode d'extraction des microservices, qui permet de réduire le monolithe, est l'extraction des services existants avec une refonte. Lorsque nous extrayons des modules existants tels quels, le résultat n'est pas toujours satisfaisant pour les développeurs, et le processus métier depuis la création de la fonctionnalité peut être obsolète. Grâce au refactoring, nous pouvons supporter un nouveau processus métier, car les exigences commerciales changent constamment. Nous pouvons améliorer le code source, éliminer les défauts connus, créer un modèle de données de meilleure qualité. Cela apporte de nombreux avantages.
La séparation des services avec refonte est inextricablement liée au concept de contexte limité. Ce concept vient du design orienté domaine. Il signifie une zone du modèle de domaine où tous les termes d'un langage commun sont clairement définis. Prenons l'exemple du contexte des assurances et des factures. Nous avons une application monolithique et il est nécessaire de travailler sur la facture dans le domaine des assurances. Nous nous attendons à ce que le développeur trouve dans un autre assemblage la classe existante « Facture », établisse un lien vers celle-ci depuis la classe « Assurance », et nous obtiendrons un code fonctionnel. Le principe DRY sera respecté, et la tâche sera accomplie plus rapidement grâce à l'utilisation de code existant.
Il s'avère que les contextes des comptes et des assurances sont liés. Lorsque de nouvelles exigences apparaîtront, ce lien compliquera le développement, augmentant ainsi la complexité d'une logique métier déjà complexe. Pour résoudre ce problème, il est nécessaire d'identifier les limites entre les contextes dans le code et d'éliminer leurs violations. Par exemple, pour le contexte des assurances, il sera probablement suffisant d'avoir un numéro de compte de 20 chiffres de la banque centrale et la date d'ouverture du compte.
Pour séparer ces contextes limités et commencer le processus d'extraction de microservices d'une solution monolithique, nous avons adopté une approche consistant à créer des API externes à l'intérieur de l'application. Si nous savions qu'un module devait devenir un microservice ou se modifier dans le cadre du processus, nous faisions immédiatement appel à la logique appartient à un autre contexte limité via des appels externes, par exemple, via REST ou WCF.
Nous avons décidé fermement de ne pas éviter le code qui nécessiterait de réaliser des transactions distribuées. Dans notre cas, il s'est avéré relativement facile de respecter cette règle. Nous n'avons jusqu'à présent pas rencontré de situations où des transactions distribuées strictes seraient réellement nécessaires - il suffit d'avoir une cohérence finale entre les modules.
Considérons un exemple concret. Nous avons un concept d'orchestrateur - un pipeline qui traite l'entité "demande". Il crée successivement un client, un compte et une carte bancaire. Si le client et le compte sont créés avec succès, mais la création de la carte échoue, la demande ne passe pas au statut "réussie" et reste au statut "carte non créée". À l'avenir, une activité en arrière-plan la reprendra et la finira. Le système se trouve pendant un certain temps dans un état d'incohérence, mais cela ne nous dérange pas fondamentalement.
Dans le cas où une situation se présenterait où il serait nécessaire de sauvegarder certaines données de manière cohérente, nous opterons probablement pour une agrégation du service afin de traiter cela en un seul processus.
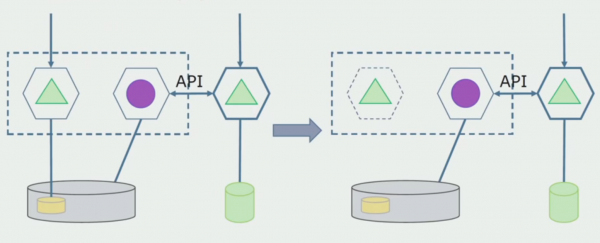
Considérons un exemple d'extraction d'un microservice. Comment peut-on l'amener relativement en toute sécurité en production ? Dans cet exemple, nous avons une partie distincte du système - un module de gestion des paies, dont l'un des segments de code que nous aimerions transformer en microservice.
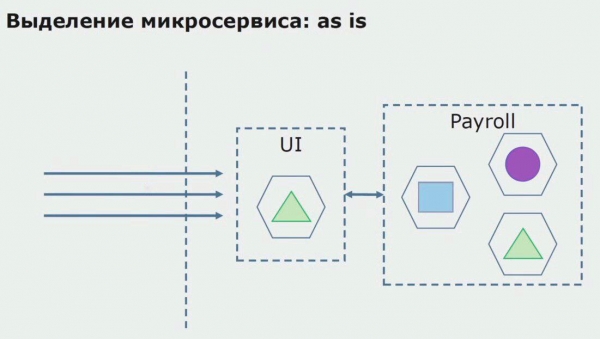
Tout d'abord, nous créons un microservice en réécrivant le code. Nous améliorons certains aspects qui ne nous convenaient pas. Nous mettons en œuvre de nouvelles exigences métier du client. Nous ajoutons une API Gateway dans le lien entre l'interface utilisateur et le backend, qui assurera le passage des appels.
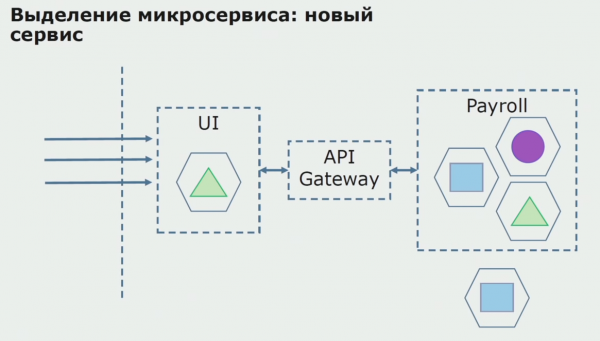
Ensuite, nous déployons cette configuration en production, mais dans un état pilote. La plupart de nos utilisateurs continuent d'utiliser les anciens processus métier. Pour les nouveaux utilisateurs, nous développons une nouvelle version de l'application monolithique, qui ne contient plus ce processus. En essence, nous faisons fonctionner en pilote le lien entre le monolithe et le microservice.
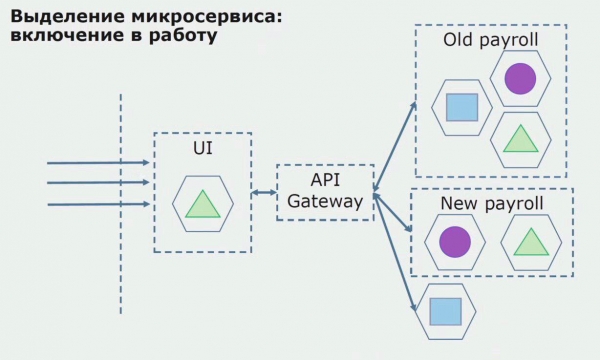
Lors du succès du pilote, nous réalisons que la nouvelle configuration est réellement fonctionnelle, nous pouvons retirer l'ancien monolithe de l'équation et laisser la nouvelle configuration à la place de l'ancienne solution.
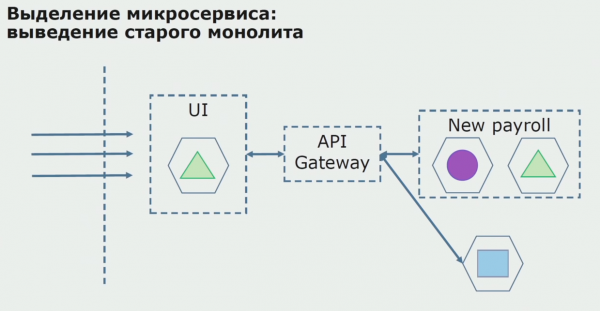
En résumé, nous utilisons pratiquement toutes les méthodes existantes de séparation du code source du monolithe. Toutes permettent de réduire la taille des parties de l'application et de les migrer vers de nouvelles bibliothèques, améliorant ainsi la qualité du code source.
Travailler avec la BDD
La base de données est plus difficile à séparer que le code source, car elle contient non seulement le schéma actuel, mais aussi des données historiques accumulées.
Notre base de données, comme beaucoup d'autres, avait un autre inconvénient majeur : une taille énorme. Cette base de données a été conçue selon la logique métier complexe du monolithe, et des liens se sont accumulés entre les tables de différents contextes limités.
Dans notre cas, pour couronner le tout (grande base de données, nombreux liens, frontières parfois floues entre les tables), nous avons rencontré un problème courant dans de nombreux grands projets : l'utilisation du modèle de base de données partagée. Les données étaient extraites des tables via des vues, répliquées et chargées dans d'autres systèmes où cette réplique était nécessaire. En conséquence, nous ne pouvions pas déplacer les tables vers un schéma séparé, car elles étaient activement utilisées.
La séparation est facilitée par ce découpage en contextes limités dans le code. Cela nous donne généralement une bonne idée de la manière dont nous séparons les données au niveau de la base de données. Nous comprenons quelles tables appartiennent à un contexte limité et lesquelles en appartiennent à un autre.
Nous avons appliqué deux méthodes globales de séparation de base de données : la séparation des tables existantes et la séparation avec refonte.
La séparation des tables existantes est une méthode qui convient bien lorsque la structure des données est de qualité, répond aux exigences commerciales et satisfait tout le monde. Dans ce cas, nous pouvons extraire les tables existantes dans un schéma distinct.
La séparation avec refonte est nécessaire lorsque le modèle commercial a beaucoup changé et que les tables ne nous satisfont plus du tout.
Séparation des tables existantes. Nous devons déterminer ce que nous allons séparer. Sans cette connaissance, rien ne fonctionnera, et la séparation des contextes limités dans le code nous aidera ici. En règle générale, si l'on peut comprendre les limites des contextes dans le code source, il devient clair quelles tables doivent figurer dans la liste à séparer.
Imaginons que nous avons une solution dans laquelle deux modules d'un monolithe interagissent avec une seule base de données. Nous devons faire en sorte qu'un module interagisse uniquement avec le segment de tables à séparer, tandis que l'autre commence à interagir avec lui via une API. Pour commencer, il suffit que seules des écritures passent par l'API. C'est une condition nécessaire pour que nous puissions parler de l'indépendance des microservices. Les relations en lecture peuvent rester tant qu'il n'y a pas de problème majeur.
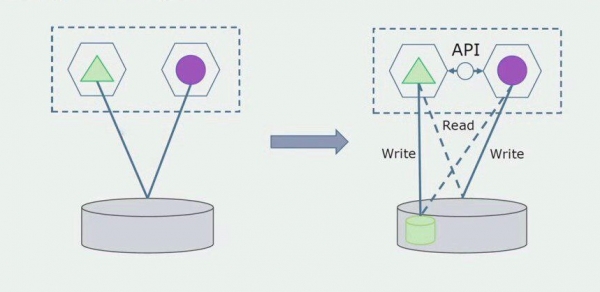
L'étape suivante consiste à extraire le segment de code qui travaille avec les tables à séparer, avec ou sans refonte, dans un microservice distinct et à le lancer dans un processus ou un conteneur séparé. Ce sera un service distinct avec une connexion à la base de données du monolithe et aux tables qui ne lui sont pas directement liées. Le monolithe interagit encore en lecture avec la partie séparée.
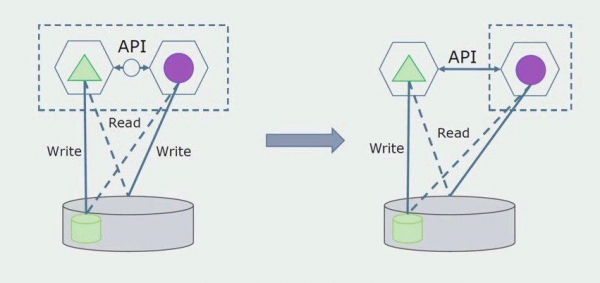
Plus tard, nous supprimerons cette connexion, ce qui signifie que la lecture des données de l'application monolithique à partir des tables séparées sera également transférée vers l'API.
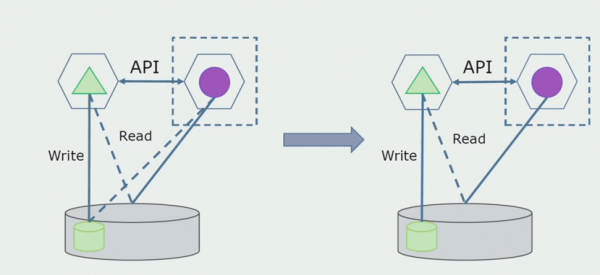
Ensuite, nous extrairons des tables de la base de données commune qui ne sont utilisées que par le nouveau microservice. Nous pouvons déplacer les tables dans un schéma distinct ou même dans une base de données physique distincte. Il reste une relation en lecture entre le microservice et la base de données du monolithe, mais cela n'est pas problématique ; dans cette configuration, il peut fonctionner encore longtemps.
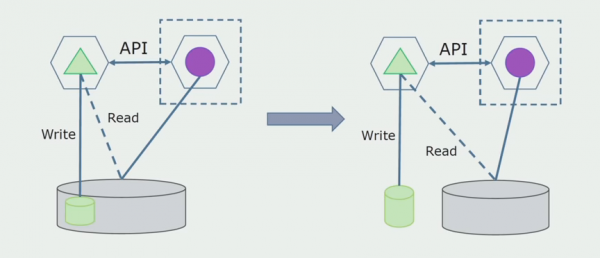
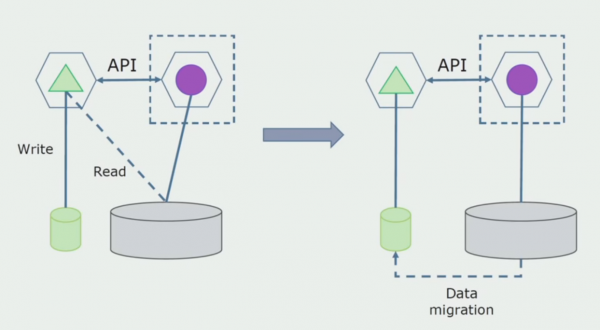
La dernière étape consiste à éliminer complètement toutes les connexions. Dans ce cas, nous pourrions avoir besoin d'une migration des données depuis la base de données principale. Parfois, nous voudrons réutiliser certaines données ou répertoires répliqués de systèmes externes dans plusieurs bases. Cela se produit périodiquement chez nous.
Une section avec traitement. Cette méthode est très similaire à la première, mais elle se déroule dans l'ordre inverse. Nous créons immédiatement une nouvelle base de données et un nouveau microservice qui interagit avec le monolithe via l'API. Cependant, il reste un ensemble de tables de la base de données que nous souhaitons supprimer ultérieurement. Nous n'en aurons plus besoin, dans le nouveau modèle, nous l'avons remplacé.
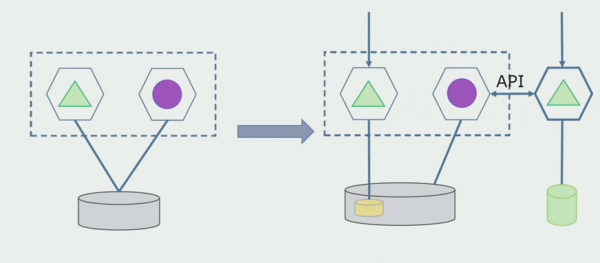
Pour que ce schéma fonctionne, nous aurons probablement besoin d'une période de transition.
Ensuite, il y a deux approches possibles.
Premier: nous dupliquons toutes les données dans les nouvelles et anciennes bases. Dans ce cas, nous avons une redondance des données, ce qui peut poser des problèmes de synchronisation. Mais nous pouvons avoir deux clients différents. L'un travaillera avec la nouvelle version, l'autre avec l'ancienne.
Deuxième: nous séparons les données selon un critère commercial. Par exemple, nous avions 5 produits dans le système qui sont stockés dans l'ancienne base de données. Le sixième, dans le cadre de la nouvelle tâche commerciale, est placé dans la nouvelle base de données. Cependant, nous allons avoir besoin d'une API Gateway qui synchronisera ces données et indiquera au client d'où et quoi prendre.
Les deux approches fonctionnent, choisissez en fonction de la situation.
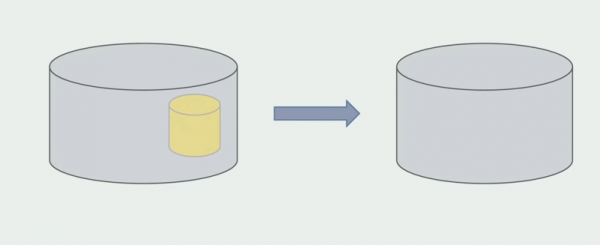
Après avoir vérifié que tout fonctionne, la partie du monolithe qui travaille avec les anciennes structures de la base de données peut être désactivée.
La dernière étape consistera à supprimer les anciennes structures de données.
En résumé, nous pouvons dire que nous avons des problèmes avec la base de données : il est difficile de travailler avec par rapport au code source, la séparation est plus compliquée, mais cela peut et doit être fait. Nous avons trouvé certaines méthodes qui permettent de le faire de manière relativement sûre, car il est plus facile de commettre une erreur avec les données qu'avec le code source.
Travail sur le code source
Voici à quoi ressemblait le schéma du code source lorsque nous avons commencé à analyser le projet monolithique.
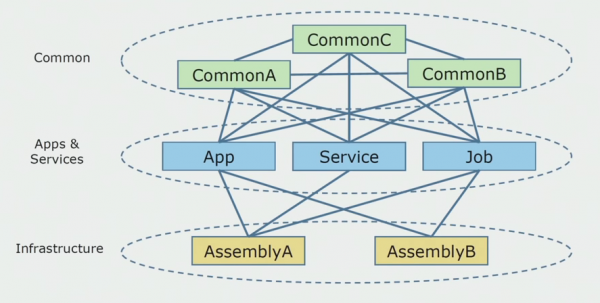
Elle peut être divisée conditionnellement en trois couches. Il s'agit de la couche des modules, plugins, services et activités exécutables. En fait, ce sont des points d'entrée au sein d'une solution monolithique. Toutes étaient solidement reliées par la couche Common. Elle contenait la logique métier utilisée en commun par les services, et de nombreuses interconnexions. Chaque service et plugin utilisait jusqu'à 10 ensembles communs ou plus, selon leur taille et la conscience des développeurs.
Nous avons eu de la chance, nous avions des bibliothèques d'infrastructure qui pouvaient être utilisées séparément.
Il arrivait parfois que certains objets Common ne relèvent en fait pas de cette couche, mais soient des bibliothèques d'infrastructure. Cela était résolu par un renommage.
Les contextes limités ont suscité le plus de préoccupations. Il arrivait que 3 à 4 contextes soient mélangés dans un même ensemble Common et s'utilisent mutuellement dans le cadre des mêmes fonctions commerciales. Il était nécessaire de comprendre où cela pouvait être divisé et selon quelles frontières, et quoi faire ensuite avec le mappage de cette division sur les ensembles de code source.
Nous avons formulé plusieurs règles pour le processus de séparation du code.
Première: nous ne souhaitions plus partager la logique métier entre les services, activités et plugins. Nous voulions rendre la logique métier indépendante dans le cadre des microservices. D'un autre côté, les microservices, dans l'idéal, sont perçus comme des services qui existent complètement indépendamment. Je pense que cette approche est quelque peu gaspillée, et il est difficile de l'atteindre, car, par exemple, les services en C# seront de toute façon connectés par la bibliothèque standard. Notre système est écrit en C#, d'autres technologies n'ont pas encore été utilisées. Par conséquent, nous avons décidé que nous pouvions nous permettre d'utiliser des ensembles techniques communs. L'essentiel est qu'il n'y ait aucun fragment de logique métier dans ceux-ci. Si vous avez un wrapper pratique pour l'ORM que vous utilisez, alors le copier d'un service à l'autre est très coûteux.
Notre équipe est passionnée par le design orienté domaine, c'est pourquoi l'« architecture en oignon » nous convient parfaitement. La base de nos services n'est pas la couche d'accès aux données, mais un assemblage avec la logique métier, qui contient uniquement la logique commerciale et est dépourvue de liens avec l'infrastructure. Ainsi, nous pouvons améliorer indépendamment l'assemblage de domaine pour résoudre les problèmes liés aux frameworks.
À ce stade, nous avons rencontré notre premier problème majeur. Le service devait se référer à un seul assemblage de domaine, la logique devant être indépendante, et le principe DRY nous posait un réel problème. Les développeurs souhaitaient éviter la duplication en réutilisant des classes d'assemblages voisins, mais cela a entraîné un nouveau couplage entre les domaines. Nous avons analysé les résultats et décidé que le problème pouvait également résider dans la structure de stockage du code source. Nous avions un grand référentiel contenant tout le code source. Il était très difficile de construire une Solution pour l'ensemble du projet sur une machine locale. Par conséquent, des petites solutions séparées étaient créées pour certaines parties du projet, et personne n'interdisait d'y ajouter un assemblage Common ou de domaine afin de le réutiliser. Le seul outil qui nous empêchait de le faire était la revue de code. Mais parfois, même cela échouait.
Nous avons donc commencé à passer à un modèle avec des référentiels séparés. La logique métier a cessé de fuir d'un service à l'autre, et les domaines sont devenus véritablement indépendants. Les contextes limités sont maintenus de manière plus claire. Comment réutilisons-nous les bibliothèques d'infrastructure dans ce cas ? Nous les avons isolées dans un référentiel distinct, puis placées dans des paquets Nuget, que nous avons ajoutés à Artifactory. Pour toute modification, la construction et la publication se font automatiquement.
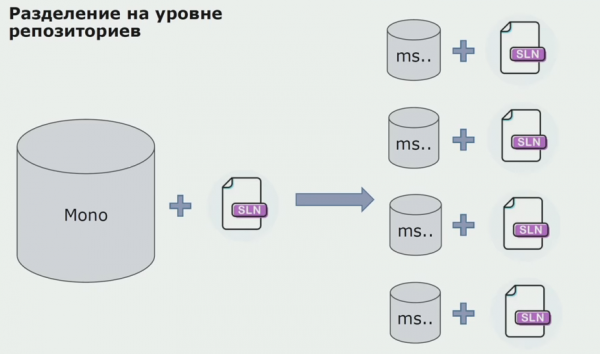
Nos services se réfèrent désormais aux paquets d'infrastructure internes tout comme aux externes. Nous téléchargeons les bibliothèques externes depuis Nuget. Pour travailler avec Artifactory, où nous stockions ces paquets, nous avons utilisé deux gestionnaires de paquets. Dans les petits référentiels, nous avons également utilisé Nuget. Dans les référentiels avec plusieurs services, nous avons utilisé Paket, qui assure une meilleure cohérence des versions entre les modules.
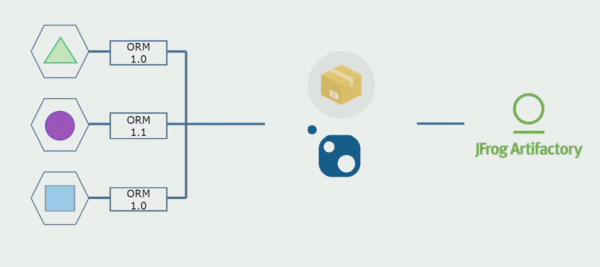
Ainsi, en travaillant sur le code source, en modifiant légèrement l'architecture et en divisant les dépôts, nous rendons nos services plus indépendants.
Problèmes d'infrastructure
La plupart des inconvénients liés à la transition vers les microservices sont associés à l'infrastructure. Vous aurez besoin d'un déploiement automatisé et de nouvelles bibliothèques pour gérer l'infrastructure.
Installation manuelle dans les environnements
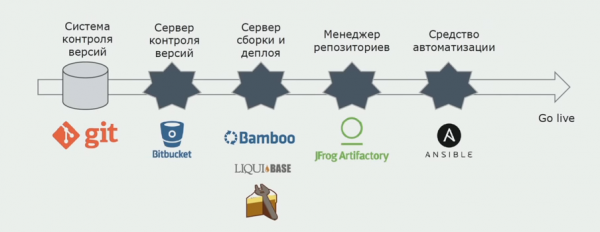
À l'origine, nous installions les solutions d'environnement à la main. Pour automatiser ce processus, nous avons créé un pipeline CI/CD. Nous avons opté pour un processus de livraison continue, car le déploiement continu est encore inacceptable du point de vue des processus commerciaux. Ainsi, le déploiement en production se fait par un bouton, tandis que les tests sont automatisés.
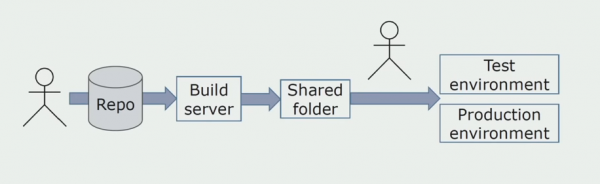
Nous utilisons Atlassian, Bitbucket pour le stockage des codes sources et Bamboo pour la compilation. Nous aimons écrire des scripts de compilation en Cake, car c'est le même langage que C#. Les paquets arrivent prêts dans Artifactory, et Ansible les déploie automatiquement sur les serveurs de test, où ils peuvent ensuite être testés immédiatement.
Journalisation séparée
À l'époque, l'une des idées du monolithe était de garantir une journalisation conjointe. Nous devions également comprendre comment gérer les journaux séparés qui se trouvent sur les disques. Nos journaux sont écrits dans des fichiers texte. Nous avons décidé d'utiliser la pile ELK standard. Nous n'avons pas écrit directement dans ELK via des fournisseurs, mais avons convenu de peaufiner les journaux texte et d'y enregistrer les ID de traçage sous forme d'identifiant, en ajoutant le nom du service, afin que ces journaux puissent ensuite être analysés.
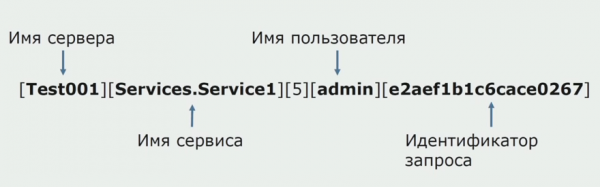
Avec Filebeat, nous avons la possibilité de collecter nos journaux de serveurs, puis de les transformer, d'utiliser Kibana pour construire des requêtes dans l'interface utilisateur et de voir comment les appels se sont déroulés entre les services. Cela est grandement facilité par l'ID de traçage.
Tests et débogage des services interconnectés
Au départ, nous ne comprenions pas complètement comment déboguer les services que nous développions. Avec le module monolithique, c'était simple, nous le lancions sur notre machine locale. Nous avons d'abord essayé de faire de même avec les microservices, mais parfois, pour exécuter pleinement un microservice, il faut également lancer plusieurs autres, ce qui s'avère peu pratique. Nous avons compris qu'il était nécessaire de passer à un modèle où nous laissons sur la machine locale uniquement le service ou les services que nous souhaitons déboguer. Les autres services sont utilisés à partir de serveurs ayant la même configuration que la production. Après débogage, lors des tests, seuls les services modifiés sont déployés sur le serveur de test pour chaque tâche. Ainsi, la solution est testée dans l'état où elle se trouvera à l'avenir en production.
Il existe des serveurs sur lesquels ne se trouvent que les versions de production des services. Ces serveurs sont nécessaires en cas d'incidents, pour vérifier la livraison avant le déploiement et pour des formations internes.
Nous avons ajouté un processus de test automatique en utilisant la bibliothèque populaire Specflow. Les tests sont lancés automatiquement via NUnit immédiatement après le déploiement à partir d'Ansible. Si la couverture de la tâche est entièrement automatisée, il n'est pas nécessaire de faire des tests manuels. Cependant, il arrive parfois qu'un test manuel supplémentaire soit nécessaire. Pour déterminer quels tests exécuter pour une tâche spécifique, nous utilisons des tags dans Jira.
De plus, le besoin de tests de charge a augmenté, auparavant ils n'étaient réalisés que dans de rares cas. Pour lancer les tests, nous utilisons JMeter, pour leur stockage — InfluxDB, et pour la création de graphiques du processus — Grafana.
Qu'avons-nous accompli ?
Tout d'abord, nous nous sommes débarrassés du concept de 'release'. Les énormes releases de deux mois ont disparu, lorsque ce mastodonte était déployé en environnement de production, perturbant temporairement les processus métiers. Aujourd'hui, nous déployons les services en moyenne tous les 1,5 jours, en les regroupant, car ils entrent en production après accord.
Dans notre système, il n'y a pas de pannes fatales. Si nous publions un microservice avec une erreur, alors la fonctionnalité associée sera défaillante, mais toutes les autres fonctionnalités ne seront pas affectées. Cela améliore considérablement l'expérience utilisateur.
Nous pouvons gérer le schéma de déploiement. Il est possible de distinguer des groupes de services séparément du reste de la solution, si nécessaire.
De plus, nous avons considérablement réduit le problème des longues files d'attente de modifications. Nous avons constitué des équipes produits distinctes qui travaillent avec une partie des services de manière autonome. Ici, le processus Scrum fonctionne déjà assez bien. Une équipe spécifique peut avoir un propriétaire de produit distinct qui lui fixe des tâches.
Résumé
- Les microservices sont bien adaptés pour la décomposition de systèmes complexes. Au cours du processus, nous commençons à comprendre ce qu'il y a dans notre système, quels contextes restreints existent et où se trouvent leurs frontières. Cela permet de répartir correctement les modifications entre les modules et d'éviter de rendre le code confus.
- Les microservices offrent des avantages organisationnels. On en parle souvent uniquement en tant qu'architecture, mais toute architecture existe pour répondre aux besoins de l'entreprise, et non pour elle-même. Par conséquent, nous pouvons dire que les microservices sont bien adaptés aux tâches effectuées par de petites équipes, étant donné que Scrum est très populaire actuellement.
- La séparation est un processus itératif. On ne peut pas simplement prendre une application et la diviser en microservices. Le produit résultant sera probablement non fonctionnel. Lors de l'extraction de microservices, il est avantageux de réécrire l'ancien code existant, c'est-à-dire de le transformer en code qui nous plaît et qui répond mieux aux besoins de l'entreprise en termes de fonctionnalités et de rapidité.
Une petite mise en garde : les coûts de transition vers les microservices sont suffisamment importants. Beaucoup de temps a été consacré à résoudre les problèmes d'infrastructure. Par conséquent, si vous avez une petite application qui ne nécessite pas de mise à l'échelle spécifique, si vous n'avez pas un grand nombre de clients luttant pour l'attention et le temps de votre équipe, alors peut-être que les microservices ne sont pas ce dont vous avez besoin aujourd'hui. C'est assez cher. Si vous commencez le processus avec des microservices, les coûts initiaux seront plus élevés que si le même projet était démarré avec le développement d'un monolithe.
P.S. Une narration plus émotionnelle (comme si cela vous concernait personnellement) - à propos de .
Voici la version complète de la présentation.
Source : habr.com
