

Exprimer des choses que les mots ne peuvent pas transmettre ; ressentir toute une gamme d'émotions s'entrelacant dans un tourbillon de sentiments ; se détacher de la terre, du ciel et même de l'univers tout entier en se lançant dans un voyage sans cartes, sans routes, sans panneaux ; inventer, raconter et vivre une histoire entière qui restera toujours unique et inimitable. Tout cela est possible grâce à la musique — un art qui existe depuis des milliers d'années et qui enchante nos oreilles et nos cœurs.
Cependant, la musique, ou plutôt les œuvres musicales, peuvent servir non seulement à un plaisir esthétique, mais également à transmettre des informations codées destinées à un appareil et invisibles pour l'auditeur. Aujourd'hui, nous allons découvrir une recherche très inhabituelle, dans laquelle des doctorants de l'École polytechnique fédérale de Zurich ont réussi à intégrer discrètement certaines données dans des œuvres musicales, ce qui fait de la musique un canal de transmission de données. Comment ont-ils réalisé leur technologie, en quoi les mélodies avec et sans données intégrées diffèrent-elles, et que révèlent les tests pratiques ? Nous allons le découvrir dans le rapport des chercheurs. C'est parti.
Fondement de l'étude
Les chercheurs appellent leur technologie la technique acoustique de transmission de données. Lorsqu'un haut-parleur joue une mélodie modifiée, l'humain la perçoit comme ordinaire, tandis qu'un smartphone, par exemple, peut lire les informations codées entre les lignes, ou plutôt entre les notes, si l'on peut s'exprimer ainsi. L'aspect le plus important dans la mise en œuvre de cette méthode de transmission de données est, selon les scientifiques (le fait qu’ils soient encore doctorants ne les empêche pas d'être des chercheurs), la rapidité et la fiabilité de la transmission tout en maintenant un bon niveau de ces paramètres, quelle que soit la piste audio choisie. La psychoacoustique, qui étudie les aspects psychologiques et physiologiques de la perception sonore par l'homme, aide à relever ce défi.
Le cœur de la transmission acoustique de données peut être décrit par l'OFDM (multiplexage par répartition orthogonale de la fréquence), qui, avec l'adaptation des porteuses à la musique d'origine au fil du temps, permet d'exploiter au maximum le spectre de fréquence transmis pour la transmission d'informations. Grâce à cela, une vitesse de transmission de 412 bits/s a été atteinte sur une distance allant jusqu'à 24 mètres (taux d'erreur < 10%). Des expériences pratiques menées avec 40 volontaires ont confirmé qu'il est pratiquement impossible de percevoir la différence entre la mélodie originale et celle dans laquelle des informations ont été intégrées.
Où peut-on appliquer cette technologie en pratique ? Les chercheurs ont leur propre réponse : pratiquement tous les smartphones modernes, ordinateurs portables et autres dispositifs portables sont équipés de microphones, et dans de nombreux endroits publics (cafés, restaurants, centres commerciaux, etc.), il existe des haut-parleurs diffusant de la musique d'ambiance. On peut intégrer, par exemple, des données pour se connecter au réseau Wi-Fi sans avoir besoin d'effectuer des actions supplémentaires.
Les caractéristiques générales de la transmission acoustique de données sont désormais claires, passons à l'étude détaillée de la structure de ce système.
Description du système
L'incorporation des données dans la mélodie se fait par le biais du masquage de fréquence. Au cours des intervalles de temps, les fréquences de masquage sont identifiées, et les porteuses OFDM, proches de ces éléments de masquage, sont remplies de données.
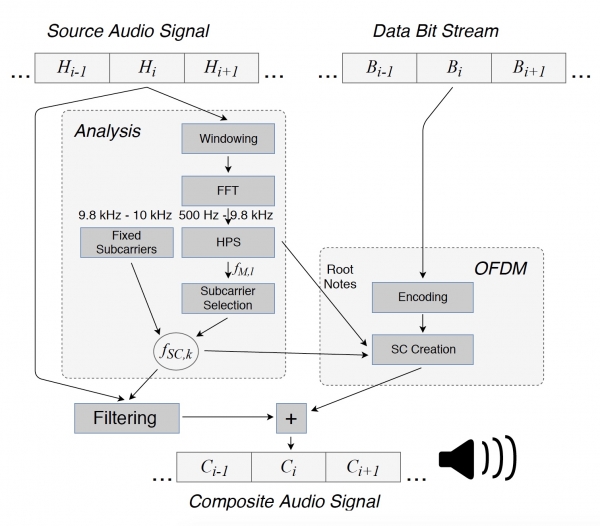
Image n°1 : conversion du fichier source en signal composite (mélodie + données), transmis par les haut-parleurs.
Tout d'abord, le signal audio source est divisé en segments successifs pour analyse. Chaque segment (Hi) de L = 8820 échantillons, soit 200 ms, est multiplié par une fenêtre* pour minimiser les effets de bord.
Fenêtre* — fonction de pondération utilisée pour gérer les effets causés par la présence de lobes latéraux dans les évaluations spectrales.
Ensuite, les fréquences dominantes du signal source ont été détectées dans la plage de 500 Hz à 9,8 kHz, ce qui a permis d'obtenir les fréquences masquantes fM,l pour ce segment. En complément, des données ont été transmises dans une petite gamme de 9,8 à 10 kHz pour déterminer la position des sous-porteuses dans le récepteur. La limite supérieure de la plage de fréquences utilisée a été fixée à 10 kHz en raison de la faible sensibilité des microphones de smartphone aux hautes fréquences.
Les fréquences masquantes étaient déterminées pour chaque segment analysé de manière individuelle. À l'aide de la méthode HPS (spectrum harmonique de produits), trois fréquences dominantes ont été établies, puis arrondies aux notes les plus proches de l'échelle chromatique harmonique. C'est ainsi que les notes fondamentales fF,i = 1…3 ont été obtenues, se situant entre les touches C0 (16,35 Hz) et B0 (30,87 Hz). Étant donné que ces notes fondamentales étaient trop basses pour être utilisées dans la transmission de données, leurs octaves supérieures ont été calculées dans la plage de 500 Hz … 9,8 kHz sous la forme 2kfF,i. Beaucoup de ces fréquences (fO,l1) se sont révélées plus prononcées en raison de la nature de l'HPS.
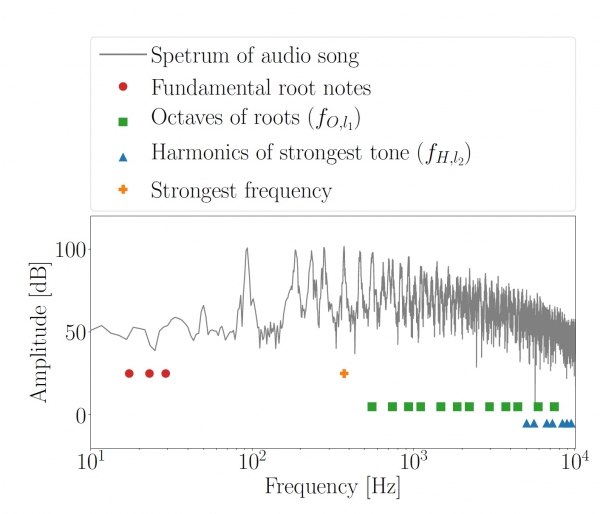
Image n°2 : octaves calculées fO,l1 pour les notes fondamentales et les harmoniques fH,l2 du ton le plus fort.
L'ensemble des octaves et des harmoniques a été utilisé comme fréquences masquantes, sur la base desquelles les fréquences de sous-porteuse OFDM fSC,k ont été déterminées. Deux sous-porteuses ont été insérées en dessous et au-dessus de chaque fréquence masquante.
Ensuite, le spectre du segment audio Hi a été filtré aux fréquences des sous-porteuses fSC,k. À partir des bits d'information dans Bi, un symbole OFDM a été créé, permettant ainsi au segment composite Ci d'être transmis via le haut-parleur. Les amplitudes et les phases des sous-porteuses doivent être choisies de manière à ce que le récepteur puisse extraire les données transmises, tandis que l'auditeur ne remarque pas de changements dans la mélodie.
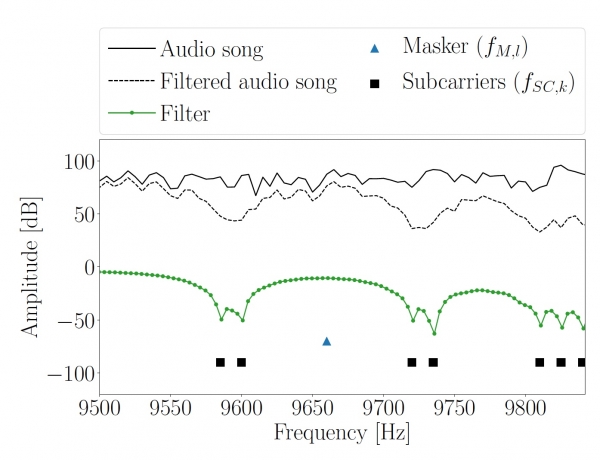
Image n°3 : section du spectre et fréquences des sous-porteuses du segment Hi de la mélodie d'origine.
Lorsque le signal audio contenant des informations codées est reproduit par des haut-parleurs, le microphone de l'appareil récepteur l'enregistre. Pour localiser les positions initiales des symboles OFDM intégrés, les enregistrements doivent d'abord être soumis à un filtrage en bande. Cela permet d'extraire la plage de fréquences supérieures, où il n'y a pas de signaux musicaux perturbateurs entre les porteuses. On peut trouver le début des symboles OFDM à l'aide du préfixe cyclique.
Après avoir détecté le début des symboles OFDM, le récepteur obtient des informations sur les notes les plus dominantes en décodant la plage de fréquences supérieures. De plus, l'OFDM est assez résistant aux interférences de sources à bande étroite, car elles n'affectent que certaines des porteuses.
Essais pratiques
Comme source de mélodies modifiées, un haut-parleur KRK Rokit 8 a été utilisé, tandis que le récepteur était un smartphone Nexus 5X.
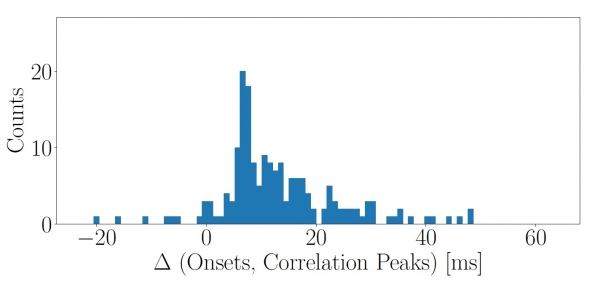
Image n° 4 : différence entre les manifestations réelles de l'OFDM et les pics de corrélation mesurés en intérieur à une distance de 5 m entre le haut-parleur et le microphone.
La plupart des points OFDM se situent dans une plage de 0 à 25 ms, il est donc possible de trouver un début acceptable à l'intérieur du préfixe cyclique de 66,6 ms. Les chercheurs notent que le récepteur (dans cette expérience, le smartphone) prend en compte que les symboles OFDM sont reproduits périodiquement, ce qui améliore leur détection.
La première chose à vérifier était l'influence de la distance sur le taux d'erreurs de bit (BER). Pour cela, trois tests ont été réalisés dans différents types de pièces : un couloir avec moquette, un bureau avec du linoléum au sol et une salle de classe avec un sol en bois.
La chanson « And The Cradle Will Rock » du groupe Van Halen a été choisie comme « sujet d'essai ».
Le volume était réglé de manière à ce que le niveau sonore mesuré par le smartphone à une distance de 2 m du haut-parleur soit de 63 dB.
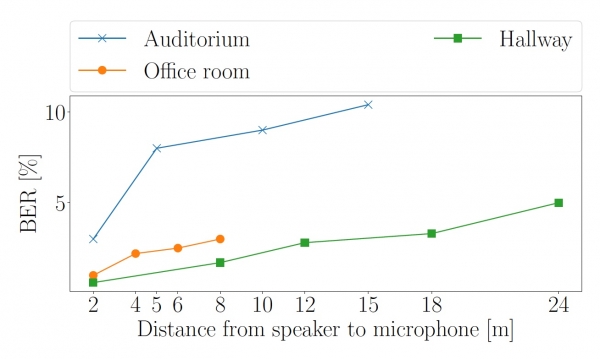
Image n° 5 : taux de BER en fonction de la distance entre le haut-parleur et le microphone (ligne bleue - salle de classe, verte - couloir, orange - bureau).
Dans le couloir, un son de 40 dB était capté par le smartphone à une distance allant jusqu'à 24 mètres du haut-parleur. Dans la salle de classe, à 15 m, le son était de 55 dB, et dans le bureau, à 8 mètres, le niveau de son perçu par le smartphone atteignait 57 dB.
Étant donné que l'auditoire et le bureau sont plus réverbérants, les échos tardifs des symboles OFDM dépassent la longueur du préfixe cyclique, augmentant ainsi le BER.
Réverbération* — diminution progressive de l'intensité sonore en raison de ses multiples réflexions.
Les chercheurs ont ensuite démontré la polyvalence de leur système en l'appliquant à six chansons de trois genres différents (voir tableau ci-dessous).
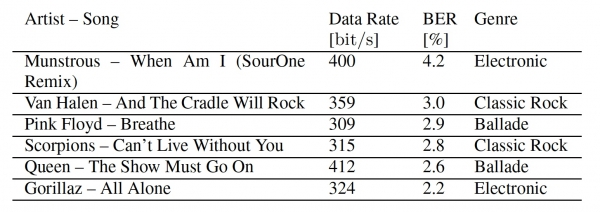
Tableau n°1 : Chansons utilisées dans les tests.
Les données du tableau nous permettent également de voir les débits et les taux d'erreur par bit pour chaque chanson. Les débits varient car la BPSK différentielle (manipulation de phase) fonctionne mieux lorsque les mêmes sous-porteurs sont utilisés. Cela est possible lorsque les segments voisins contiennent les mêmes éléments de masquage. Les chansons continuellement fortes fournissent une base optimale pour le masquage des données, car les fréquences de masquage sont plus prononcées dans une large gamme de fréquences. La musique à changement rapide peut seulement partiellement masquer les symboles OFDM en raison de la longueur fixe de la fenêtre d'analyse.
Ensuite, les tests du système ont été réalisés par des personnes censées déterminer quelle mélodie était originale et laquelle avait été modifiée par l'information insérée. Pour cela, des extraits de 12 secondes des chansons du tableau n°1 ont été placés sur un site dédié.
Dans la première expérience (E1), chaque participant recevait soit un extrait modifié, soit un extrait original à écouter, et devait décider si cet extrait était original ou modifié. Dans la seconde expérience (E2), les participants pouvaient écouter autant de fois qu'ils le souhaitaient les deux versions, puis décider laquelle était l'originale et laquelle était modifiée.
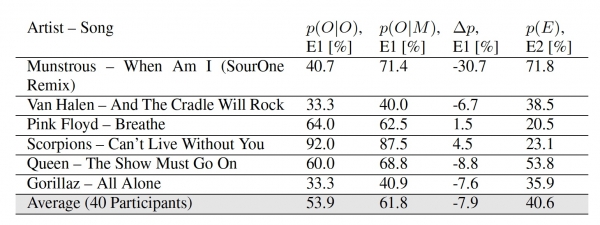
Tableau n°2 : Résultats des expériences E1 et E2.
Les résultats de la première expérience comprennent deux indicateurs : p(O|O) — pourcentage de participants ayant correctement identifié la mélodie originale et p(O|M) — pourcentage de participants ayant identifié la version modifiée de la mélodie comme originale.
Il est intéressant de noter que certains participants, selon les chercheurs, trouvaient certaines mélodies modifiées plus originales que l'original lui-même. Les résultats des deux expériences indiquent que l'auditeur moyen ne remarquera pas la différence entre une mélodie ordinaire et celle dans laquelle des données ont été incrustées.
Naturellement, les mélomanes et les musiciens pourront détecter certaines inexactitudes et éléments suspects dans les mélodies modifiées, mais ces éléments ne sont pas assez significatifs pour provoquer un inconfort.
Et maintenant, nous pouvons nous aussi participer à l'expérience. Ci-dessous, deux versions de la même mélodie sont présentées — l'originale et la modifiée. Entendez-vous la différence ?
vs
Pour une compréhension plus approfondie des nuances de l'étude, je recommande de consulter le groupe de recherche.
Vous pouvez également télécharger un fichier ZIP contenant les fichiers audio des mélodies originales et modifiées utilisées dans l'étude à .
Épilogue
Dans ce travail, des doctorants de l'École polytechnique fédérale de Zurich ont décrit un système incroyable de transmission de données à travers la musique. Pour cela, ils ont utilisé le masquage fréquentiel, permettant d'incorporer des données dans la mélodie jouée par un haut-parleur. Cette mélodie est perçue par le microphone de l'appareil, qui reconnaît les données cachées et les décode, tandis que l'auditeur moyen ne remarquera aucune différence. À l'avenir, les chercheurs prévoient de développer leur système en recherchant des méthodes plus sophistiquées pour intégrer des données dans l'audio.
Quand quelqu'un invente quelque chose d'inhabituel, et surtout de fonctionnel, nous sommes toujours ravis. Mais ce qui nous fait encore plus plaisir, c'est que cette invention a été créée par de jeunes gens. La science n'a pas de limites d'âge. Et si la jeunesse trouve la science ennuyeuse, cela signifie qu'elle n'est pas présentée sous le bon angle. Comme nous le savons, la science est un monde fascinant qui ne cesse jamais d'étonner.
Hors sujet du vendredi :
Puisque nous avons parlé de musique, et plus précisément de rock, voici un beau voyage à travers les territoires du rock.
Queen, «Radio Ga Ga» (1984).
Merci de votre attention, restez curieux et passez tous un excellent week-end, les amis ! 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenus intéressants ? Soutenez-nous en passant une commande ou en recommandant à vos amis. 30% de réduction pour les utilisateurs de Habr sur un équivalent unique des serveurs d'entrée de gamme, conçu spécialement pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd à moitié prix ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
