

En juin de cette année, dans la petite ville suisse de Rapperswil, s'est tenue pour la dixième fois un événement appelé . Cette fois-ci, plus de cinq cents passionnés de Haskell, des débutants aux pères fondateurs du langage, s'y sont réunis. Bien que les organisateurs qualifient cet événement de hackathon, ce n'est pas une conférence ou un hackathon au sens classique. Son format est différent de ceux des programmateurs traditionnels. Nous avons entendu parler de ZuriHac par un heureux hasard, y avons participé et maintenant nous estimons qu'il est de notre devoir de parler de cette découverte atypique !
Alconost s'occupe professionnellement de
Cet article a été rédigé par deux étudiants en troisième année du programme « Mathématiques appliquées et informatique » de la HSE - Saint-Pétersbourg : Vasily Alferov et Yelizaveta Vasilenko. Notre passion pour la programmation fonctionnelle a commencé pour nous deux avec le cycle de conférences de D. N. Moskvin lors de notre deuxième année à l'université. Actuellement, Vasily participe au programme Google Summer of Code, où il travaille sur la mise en œuvre de graphes algébriques en Haskell sous la direction de l'équipe du projet . Yelizaveta a appliqué les compétences acquises en programmation fonctionnelle dans son travail de cours, consacré à la mise en œuvre de l'algorithme d'anti-unification avec une application ultérieure en théorie des types.
Format de l'événement
Le public cible comprend les propriétaires de projets open source, les programmeurs souhaitant contribuer à leur développement, les chercheurs en programmation fonctionnelle et simplement les passionnés de Haskell. Cette année, à l'université HSR Hochschule für Technik Rapperswil, plus de cinquante développeurs de projets open source en Haskell du monde entier se sont rassemblés pour parler de leurs produits et intéresser de nouvelles personnes à leur développement.
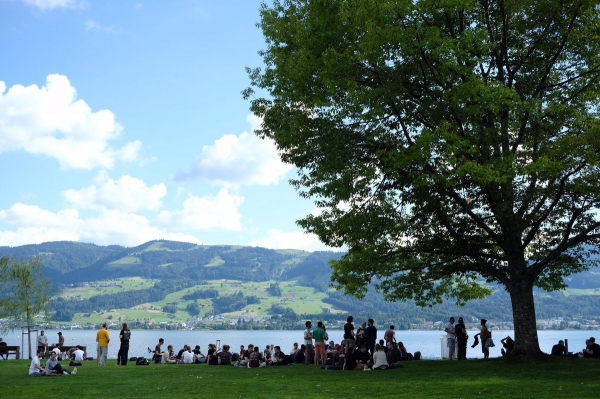
Photos de Twitter
Le processus est très simple : il faut d'abord rédiger quelques phrases sur son projet et les envoyer aux organisateurs, qui publieront les informations sur votre projet sur la page de l'événement. De plus, au cours de la première journée, les auteurs des projets ont trente secondes pour expliquer brièvement sur scène ce sur quoi ils travaillent et ce qu'il faut faire. Ensuite, les personnes intéressées recherchent les auteurs et posent des questions détaillées sur les tâches.
Nous n'avons pas encore de projets ouverts en propre, mais nous voulons vraiment contribuer à ceux qui existent déjà, c'est pourquoi nous nous sommes inscrits en tant que participants ordinaires. Pendant trois jours, nous avons travaillé avec deux groupes de développeurs. Il s'avère que l'apprentissage collaboratif du code et la communication en direct rendent l'interaction entre les auteurs de projets et les contributeurs très productive – lors de ZuriHac, nous avons pu explorer de nouveaux domaines pour nous et aider deux équipes complètement différentes en résolvant une tâche dans chaque projet.
En plus de la précieuse pratique, plusieurs conférences et ateliers ont également été présentés lors de ZuriHac. Deux conférences, en particulier, nous ont marqué. Lors de la première, Andreï Mokhov de l'Université de Newcastle a parlé des foncteurs applicatifs sélectifs — une classe de types qui devrait constituer un intermédiaire entre les foncteurs applicatifs et les monades. Lors de l'autre conférence, l'un des fondateurs de Haskell, Simon Peyton Jones, a expliqué comment fonctionne l'inférence de types dans le compilateur GHC.
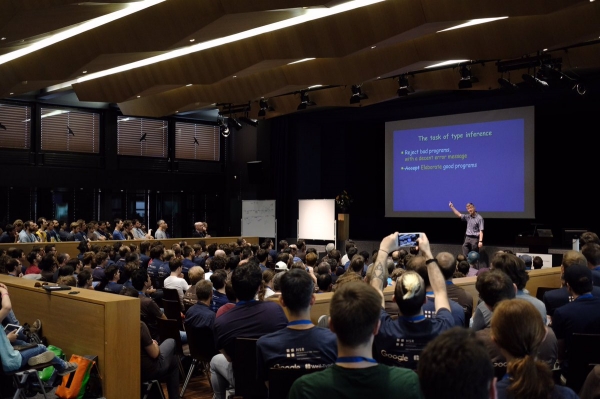
Conférence de Simon Peyton Jones. Photo tirée de Twitter.
Les ateliers organisés pendant le hackathon étaient divisés en trois catégories selon le niveau de préparation des participants. Les tâches proposées aux participants rejoignant le développement des projets étaient également marquées avec des niveaux de difficulté. Une communauté restreinte mais solidaire de programmeurs fonctionnels accueille avec plaisir les débutants. Cependant, pour comprendre les conférences d'Andreï Mokhov et Simon Peyton Jones, le cours de programmation fonctionnelle suivi à l'université nous a été très utile.
Pour les participants ordinaires comme pour les auteurs de projets, l'inscription à l'événement est gratuite. Nous avons soumis nos candidatures au début de juin, après quoi nous avons été rapidement transférés de la liste d'attente à la liste de participants confirmés.
Maintenant, nous allons parler des projets auxquels nous avons participé durant leur développement.
Pandoc
— c'est un convertisseur universel de documents textuels, en fait — de tout format à n'importe quel autre. Par exemple, de docx en pdf, ou de Markdown en MediaWiki. Son auteur, John MacFarlane, est professeur de philosophie à l'Université de Californie à Berkeley. En général, Pandoc est assez connu, et certains de nos amis ont été surpris d'apprendre que Pandoc est écrit en Haskell.
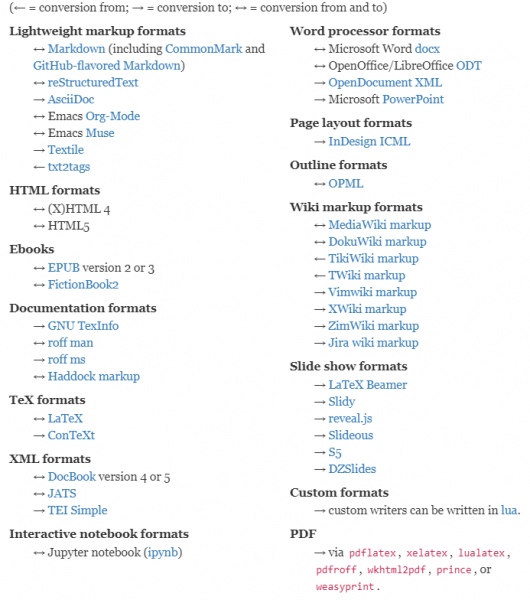
Liste des formats de documents pris en charge par Pandoc. Il y a aussi un graphique entier sur le site, mais cette image ne peut pas être insérée dans l'article.
Bien sûr, Pandoc ne propose pas de conversion directe pour chaque paire de formats. Pour prendre en charge un si vaste éventail de transformations, une solution architecturale standard est utilisée : tout d'abord, le document entier est traduit en une représentation intermédiaire interne spéciale, puis un document dans un autre format est généré à partir de cette représentation interne. Les développeurs appellent cette représentation interne « AST », qui signifie Abstract Syntax Tree, ou . On peut facilement voir la représentation intermédiaire : il suffit de définir le format de sortie comme « native »
$ cat example.html
<h1>Hello, World!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Bonjour,",Space,Str "Monde!"]]
Les lecteurs qui ont au moins un peu travaillé avec Haskell peuvent supposer, à partir de ce petit exemple, que Pandoc est écrit en Haskell : le résultat de cette commande est une représentation des structures internes de Pandoc sous forme de chaîne, créée de manière similaire à ce qui est généralement fait en Haskell, par exemple, dans la bibliothèque standard.
Ainsi, ici, on peut voir que la représentation interne est une structure récursive, où chaque nœud interne contient une liste. Par exemple, au niveau le plus élevé, il y a une liste avec un seul élément : un en-tête de premier niveau avec les attributs « hello-world », [], []. À l'intérieur de cet en-tête se trouve une liste composée de la chaîne « Hello, », d'un espace et de la chaîne « World ! ».
Comme on peut le voir, la représentation interne ne diffère pas beaucoup de l'HTML. Elle représente un arbre, où chaque nœud interne fournit des informations sur la mise en forme de ses descendants, tandis que les feuilles contiennent le contenu du document.
Si l'on descend au niveau de l'implémentation concrète, le type de données pour le document entier est défini comme suit :
data Pandoc = Pandoc Meta [Block]Ici, Block représente effectivement les sommets internes mentionnés ci-dessus, tandis que Meta contient des métadonnées sur le document, comme le titre, la date de création, les auteurs – pour différents formats, cela varie, et Pandoc s'efforce de conserver ces informations lors de la conversion d'un format à l'autre.
Presque tous les constructeurs de type Block — comme Header ou Para (paragraphe) — acceptent, en tant qu'arguments, des attributs et une liste de nœuds de niveau inférieur — généralement de type Inline. Par exemple, Space ou Str sont des constructeurs de type Inline, et la balise HTML
se transforme également en son propre Inline spécial. Nous ne voyons pas l'intérêt de donner la définition complète de ces types, mais nous notons qu'elle peut être consultée ici. .
Il est intéressant de noter que le type Pandoc est un monoïde. Cela signifie qu'il existe un document vide, et que les documents peuvent être additionnés entre eux. C'est pratique lors de l'écriture de Readers — on peut diviser un document en parties selon une logique arbitraire, analyser chacune séparément, puis rassembler le tout en un seul document. La méta-information sera collectée de toutes les parties du document en même temps.
Lors de la conversion, disons, de LaTeX à HTML, un module spécial appelé LaTeXReader transforme d'abord le document d'entrée en AST, puis un autre module appelé HTMLWriter convertit l'AST en HTML. Grâce à cette architecture, il n'est pas nécessaire d'écrire un nombre quadratique de conversions — il suffit d'écrire un Reader et un Writer pour chaque nouveau format, et toutes les paires de conversions possibles seront automatiquement prises en charge.
Il est clair que cette architecture présente également des inconvénients, prévus depuis longtemps par des experts en architecture logicielle. Le plus significatif est le coût des modifications de l'arbre syntaxique. Si le changement est suffisamment important, il faudra modifier le code dans tous les Readers et Writers. Par exemple, l'un des défis auxquels les développeurs de Pandoc sont confrontés est de prendre en charge des formats de tableau complexes. Actuellement, Pandoc ne gère que les tableaux les plus simples, avec en-tête, colonnes et valeur dans chaque cellule. Par exemple, l'attribut colspan en HTML sera simplement ignoré. L'une des raisons de ce comportement est l'absence d'un schéma unique de représentation des tableaux dans tous ou au moins de nombreux formats — il n'est donc pas clair sous quelle forme les tableaux doivent être stockés dans la représentation interne. Mais même après avoir choisi une représentation spécifique, il faudra modifier tous les Readers et Writers prenant en charge le travail avec les tableaux.
Le langage Haskell a été choisi non seulement par l'amour des auteurs pour la programmation fonctionnelle. Haskell est connu pour ses larges possibilités de traitement de texte. Un exemple en est la bibliothèque — une bibliothèque qui utilise activement les concepts de la programmation fonctionnelle — monoïdes, monades, foncteurs applicatifs et alternatifs — pour écrire des analyzeurs arbitraires. Toute la puissance de Parsec peut être vue dans HaskellWiki, où un analyseur complet d'un langage de programmation impératif simple est présenté. Évidemment, Parsec est également largement utilisé dans Pandoc.
Pour résumer brièvement, les monades sont utilisées pour le parsing séquentiel, où une chose vient d'abord, puis une autre. Par exemple, dans cet exemple :
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Il faut d'abord lire l'espace, puis l'énoncé — qui a aussi le type Parser Stmt.
Les foncteurs alternatifs sont utilisés pour revenir en arrière en cas d'échec de parsing. Par exemple,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Cela signifie qu'il faut essayer de lire soit l'énoncé entre parenthèses, soit de tenter successivement de lire plusieurs énoncés.
Les foncteurs applicatifs sont principalement utilisés comme des raccourcis pour les monades. Par exemple, supposons que la fonction tok lit un token (c'est une fonction réelle de LaTeXReader). Regardons cette combinaison
const tok tokElle lira deux tokens à la suite et renverra le premier d'entre eux.
Pour toutes ces classes, Haskell dispose de jolis opérateurs symboliques, rendant la programmation des Readers similaire à de l'art ASCII. Admirez ce remarquable code.
Nos tâches étaient liées à LaTeXReader. La tâche de Vassili était de gérer les commandes mbox et hbox, utiles lors de la rédaction de paquets en LaTeX. Elizabeth était responsable du support de la commande epigraph, permettant de formater des épigraphes dans des documents LaTeX.
Hatrace
Dans les systèmes d'exploitation de type UNIX, l'appel système ptrace est souvent implémenté. Il est utile pour le débogage et la simulation d'environnements de programmes, permettant de suivre les appels système effectués par un programme. Par exemple, l'outil très utile strace utilise dans son fonctionnement précisément ptrace.
Hatrace est une bibliothèque qui fournit une interface pour ptrace en Haskell. Le problème est que ptrace lui-même est assez complexe et l'utiliser directement est plutôt difficile, surtout depuis des langages fonctionnels.
Lors de son lancement, Hatrace fonctionne comme strace et accepte des arguments similaires. Sa différence avec strace est qu'il s'agit également d'une bibliothèque qui offre une interface plus simple que simplement ptrace.
Avec Hatrace, nous avons déjà repéré un bogue désagréable dans le compilateur Haskell GHC — lorsqu'il est tué à un moment inapproprié, il génère des fichiers objets incorrects et ne les recompresse pas lors du redémarrage. Le scriptage sur les appels système a permis de reproduire l'erreur de manière fiable en un seul lancement, alors que les terminaisons aléatoires prenaient environ deux heures pour reproduire l'erreur.
Nous avons ajouté des interfaces d'appels système à la bibliothèque — Élisabeth a ajouté brk, et Vasily a ajouté mmap. Grâce à notre travail, il est désormais plus simple et précis d'utiliser les arguments de ces appels système en utilisant la bibliothèque.
Source : habr.com
