

L'été, la réduction de l'activité des acheteurs et de l'intensité des changements d'infrastructure des projets web est quelque chose de traditionnel, nous dit le Capitaine Évidence. Simplement parce que même les informaticiens, parfois, partent en vacances. Et les CTO aussi. C'est donc plus difficile pour ceux qui restent à leur poste, mais ce n'est pas le sujet du jour : peut-être que c'est justement pour cela que l'été est la meilleure période pour réfléchir calmement au schéma de sauvegarde existant et dresser un plan pour l'améliorer. Et l'expérience d'Egor Andreyev de [AdminDivision] vous sera utile à cet égard. , dont il a parlé lors de la conférence .
Lors de la construction de sites de secours, il existe plusieurs pièges dans lesquels on peut tomber. Et il est absolument inacceptable d'y tomber. Ce qui nous nuit dans tout cela, comme dans bien d'autres domaines, c'est le perfectionnisme et… la paresse. Nous essayons de tout faire parfaitement, alors qu'il n'est pas nécessaire de tout rendre parfait ! Il faut juste faire certaines choses, mais bien les faire, jusqu'au bout, pour qu'elles fonctionnent correctement.
Le basculement n'est pas un gadget amusant « juste pour le plaisir » ; c'est un outil qui doit faire une seule chose : réduire le temps d'arrêt, afin que le service et l'entreprise perdent moins d'argent. Dans toutes les méthodes de sauvegarde, je propose de se demander dans quel contexte se trouvent l'argent.
Le premier piège: lorsque nous construisons de grands systèmes fiables et que nous nous occupons de la sauvegarde, nous réduisons le nombre de pannes. C'est une terrible illusion. En fait, lorsque nous nous occupons de la sauvegarde, le nombre de pannes augmente probablement. Et si nous faisons tout correctement, nous réduirons le temps d'arrêt au total. Il y aura plus de pannes, mais elles se produiront avec moins de coûts. Qu'est-ce que la sauvegarde ? — c'est une complication du système. Toute complication est négative : elle nous donne plus de petites pièces, plus de roues dentées, en un mot, plus d'éléments — et donc, un risque de rupture plus grand. Et elles vont effectivement se casser. Et cela arrivera plus souvent. Un exemple simple : disons que nous avons un site utilisant PHP et MySQL, et qu'il doit être rapidement sauvegardé.
D'accord (c) Nous prenons la deuxième plateforme, construisons un système identique... La complexité devient deux fois plus grande — nous avons deux entités. De plus, nous ajoutons une certaine logique de transfert de données d'une plateforme à l'autre — c'est-à-dire la réplication des données, la copie de la statique, et ainsi de suite. Ainsi, la logique de réplication — elle est généralement très complexe, et donc, la complexité globale du système peut être non pas 2, mais 3, 5, ou même 10 fois plus grande.
Le deuxième piège: lorsque nous construisons de véritables systèmes complexes, nous imaginons ce que nous voulons obtenir à la fin. Voilà : nous voulons obtenir un système super fiable qui fonctionne sans aucun temps d'arrêt, qui bascule en une demi-seconde (ou mieux encore, instantanément), et nous commençons à concrétiser nos rêves. Mais ici aussi, il y a un détail : plus le temps de basculement souhaité est court, plus la logique du système devient complexe. Plus nous devrons rendre cette logique complexe, plus le système aura tendance à tomber en panne. Et on peut se retrouver dans une situation très désagréable : nous essayons de toutes nos forces de réduire le temps d'arrêt, alors qu'en réalité, nous compliquons les choses, et lorsque quelque chose ne va pas, le temps d'arrêt sera finalement plus long. On se surprend souvent à penser : eh bien... il valait mieux ne pas avoir de redondance. Il valait mieux que tout fonctionne seul avec un temps d'arrêt compréhensible.
Comment peut-on lutter contre cela ? Il faut arrêter de se mentir, arrêter de se flatter en pensant que nous allons construire une fusée spatiale, mais comprendre de manière adéquate combien de temps le projet peut effectivement être en attente. Et en fonction de ce temps maximum, nous choisirons en fait les méthodes dont nous disposerons pour augmenter la fiabilité de notre système.
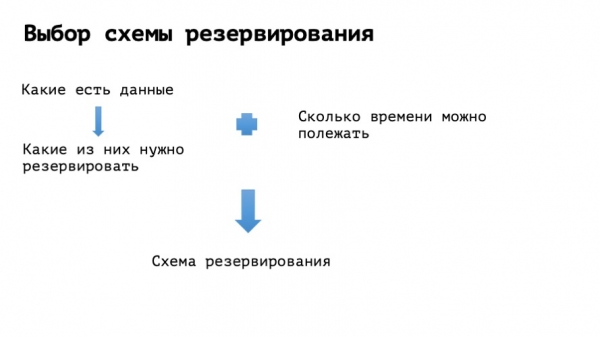
Il est temps de raconter des « histoires de la vraie vie »… de la vie, bien sûr.
Exemple numéro un
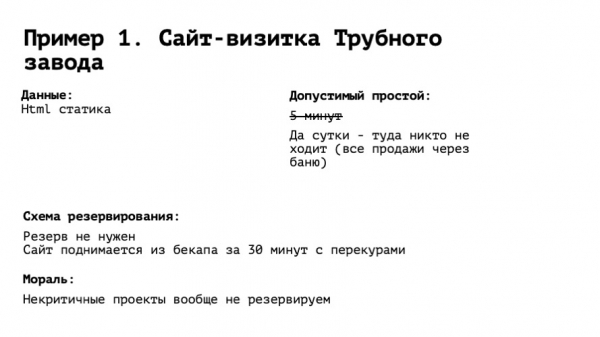
Imaginez un site vitrine pour l'usine de tuyauterie numéro 1 de la ville de N. Il est écrit en lettres géantes — USINE DE TUYAUTERIE N° 1. Juste en dessous — le slogan : « Nos tuyaux sont les tuyaux les plus ronds de N ». Et en bas, le numéro de téléphone du directeur général et son nom. Nous comprenons qu'il est nécessaire de réserver — c'est très important ! Commençons à analyser de quoi cela se compose. C'est de l'HTML statique — c'est-à-dire quelques images où le directeur est, en fait, assis à une table dans un sauna avec son partenaire, discutant d'une nouvelle affaire. Nous commençons à penser au temps d'arrêt. Une pensée nous traverse : il faut rester là cinq minutes, pas plus. Et voici la question : combien de ventes ont été réalisées sur notre site ? Combien, combien ? Que signifie « zéro » ? En effet, cela veut dire que les quatre affaires de l'année dernière ont été conclues à la même table, avec les mêmes personnes, avec qui ils vont au sauna et s'assoient à la table. Nous comprenons qu'il ne se passera rien de terrible même si le site reste inactif pendant un jour.
En se basant sur ces éléments, nous avons un jour pour mettre cette histoire en place. Nous commençons à réfléchir au schéma de réservation. Et nous choisissons le schéma de réservation le plus idéal pour cet exemple : nous ne faisons pas de réservation. Tout cela peut être mis en place par n'importe quel administrateur en trente minutes, pauses comprises. Installer le serveur web, déposer les fichiers — tout simplement. Cela fonctionnera. Il n'est pas nécessaire de surveiller quoi que ce soit, rien ne nécessite une attention particulière. Ainsi, la conclusion du premier exemple est assez claire : les services pour lesquels aucune réservation n'est nécessaire — cela ne nécessite pas de réservation.
Exemple numéro deux
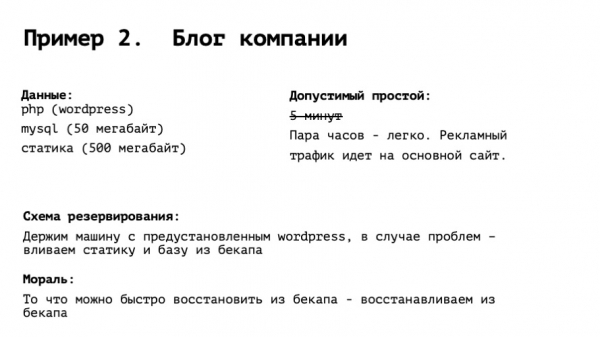
Blog de l'entreprise : des rédacteurs spécialement formés publient des nouvelles, par exemple, nous avons participé à une telle exposition, ou nous avons lancé un nouveau produit, etc. Supposons qu'il s'agit d'un PHP standard avec WordPress, une petite base de données et un peu de statique. Naturellement, il est évident que nous ne pouvons pas rester inactifs : « pas plus de cinq minutes ! », tout cela. Mais réfléchissons un peu plus. Que fait ce blog ? Il reçoit du trafic de Yandex et de Google grâce à certaines requêtes, de manière organique. Super. Et les ventes sont-elles liées à cela d'une quelconque manière ? Révélation : pas vraiment. Le trafic publicitaire va vers le site principal, qui est sur une autre machine. Nous commençons à réfléchir à un schéma de sauvegarde du blog. En toute logique, il doit être réactivé en quelques heures, et il serait bon de s'y préparer. Il serait raisonnable de prendre une machine dans un autre centre de données, d'y installer l'environnement, c'est-à-dire le serveur web, PHP, WordPress, MySQL, et de le laisser inactif. Au moment où nous réalisons que tout est cassé, il faut faire deux choses : déployer un dump mysql de 50 Mo, qui se chargera en une minute, et restaurer un certain nombre d'images depuis la sauvegarde. Cela ne prendra pas non plus beaucoup de temps. Ainsi, en une demi-heure, tout cela est opérationnel. Pas de réplications, ou par pitié, de basculement automatique. Conclusion : ce que nous pouvons rapidement restaurer depuis la sauvegarde n'a pas besoin d'être sauvegardé.
Exemple numéro trois, un peu plus complexe
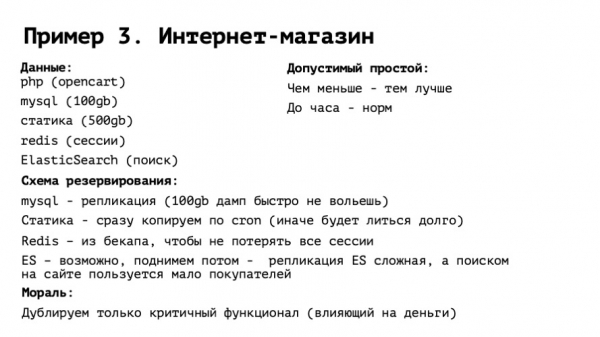
Boutique en ligne. PHP avec open heart légèrement modifié, MySQL avec une base solide. Pas mal de statique (après tout, une boutique en ligne a de jolies images HD et tout le reste), Redis pour les sessions et Elasticsearch pour la recherche. Nous commençons à penser au temps d'arrêt. Et ici, il est évidemment clair qu'il est impossible que la boutique en ligne soit inactive pendant un jour sans douleur. Plus elle est inactive, plus nous perdons d'argent. Il est temps d'accélérer. Et à quel point ? Je suppose que si nous restons inactifs pendant une heure, personne ne perdra la tête. Oui, nous perdrons quelque chose, mais si nous nous acharnons, cela ne fera qu'empirer. Nous déterminons le schéma de temps d'arrêt acceptable par heure.
Comment peut-on tout cela réserver ? Une machine est nécessaire dans tous les cas : une heure, c'est plutôt peu. Mysql : ici, une réplication est requise, une réplication active, car en une heure, 100 Go de dump ne passeront probablement pas. Statique, images : encore une fois, en une heure, 500 Go pourraient ne pas être transférés à temps. Il serait donc préférable de copier immédiatement les images. Redis : c'est ici que la situation devient plus intéressante. Les sessions se trouvent dans Redis — nous ne pouvons tout simplement pas le supprimer. Car ce ne serait pas idéal : tous les utilisateurs se retrouveraient déconnectés, leurs paniers seraient vidés, etc. Les gens seraient contraints de ressaisir leur identifiant et leur mot de passe, et beaucoup risquent d'abandonner leurs achats. Encore une fois, cela fera chute du taux de conversion. D'un autre côté, Redis, tel qu'il est, avec les derniers utilisateurs connectés, n'est probablement pas nécessaire non plus. Et un bon compromis serait de prendre Redis et de le restaurer à partir d'une sauvegarde, d'hier, ou, s'il est sauvegardé chaque heure, d'une heure auparavant. Heureusement, sa restauration à partir d'une sauvegarde ne nécessite que la copie d'un fichier. Et l'histoire la plus fascinante concerne Elasticsearch. Qui a déjà mis en place la réplication MySQL ? Qui a déjà mis en place la réplication Elasticsearch ? Et chez qui cela a-t-il bien fonctionné par la suite ? Ce que je veux dire, c'est que nous voyons dans notre système une sorte d'entité. Elle semble utile — mais elle est complexe.
C'est compliqué dans le sens où nos collègues ingénieurs n'ont pas d'expérience avec cela. Ou ils ont une expérience négative. Ou alors nous comprenons que c'est une technologie assez nouvelle avec des subtilités ou des défauts. Nous pensons... Mince, elastic est aussi volumineux, il prend aussi beaucoup de temps à restaurer depuis la sauvegarde, que faire ? Nous comprenons que elastic est utilisé pour la recherche dans notre cas. Et comment notre boutique en ligne vend-elle ? Nous allons chez les marketeurs, leur demandons d'où viennent les gens. Ils répondent : « 90 % viennent directement sur la fiche produit depuis Yandex-Market ». Et soit ils achètent, soit non. Donc, la recherche n'est nécessaire que pour 10 % des utilisateurs. Et maintenir la réplication d'elastic, surtout entre différents centres de données dans différentes zones, comporte vraiment beaucoup de subtilités. Quelle est la solution ? Nous mettons elastic sur une plateforme réservée et nous ne faisons rien avec. Si cela traîne, nous pourrions éventuellement le relancer un jour, mais rien n'est sûr. En gros, la conclusion est plus ou moins la même : les services qui n'affectent pas l'argent, nous ne les réservons pas, encore une fois. Afin de garder le schéma plus simple.
Exemple numéro quatre, encore plus compliqué
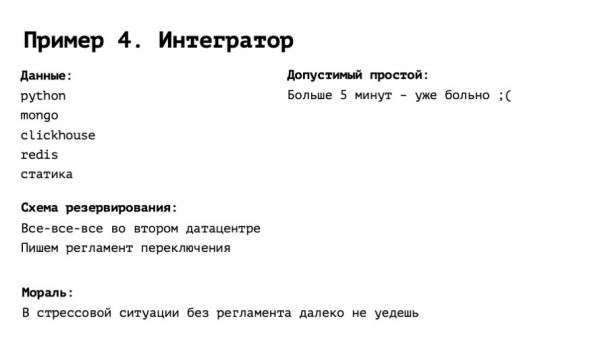
Integrateur : vente de fleurs, appel de taxi, vente de produits, en gros, tout ce que vous voulez. Une chose sérieuse qui fonctionne 24/7 pour un grand nombre d'utilisateurs. Avec une pile intéressante et complète, où il y a des bases intéressantes, des solutions, une forte charge, et surtout, il est douloureux qu'elle soit en panne pendant plus de 5 minutes. Non seulement parce que les gens n’achèteront pas, mais parce qu’ils verront que ça ne fonctionne pas, seront déçus et pourraient ne jamais revenir.
D'accord. Cinq minutes. Que faisons-nous avec ça ? Dans ce cas, nous bâtissons sérieusement, avec tous les moyens, une véritable plateforme de secours, avec réplication de tout et n'importe quoi, et éventuellement, nous automatisons au maximum le basculement vers cette plateforme. Et en plus de cela, il ne faut pas oublier de faire une chose importante : en fait, rédiger un règlement de basculement. Le règlement, même si vous avez tout automatisé, peut être très simple. Genre « lancer ce scénario ansible », « cocher cette case dans route 53 » et ainsi de suite - mais cela doit être une liste précise d'actions.
Tout semble clair. Passer la réplication — c'est une tâche triviale, ou elle peut se faire toute seule. Réécrire le nom de domaine dans le DNS — c'est dans la même veine. Le problème, c'est que lorsque ce type de projet échoue, la panique s'installe, et même les meilleurs administrateurs peuvent en être affectés. Sans une instruction claire « ouvrez le terminal, allez ici, l'adresse de notre serveur est toujours celle-ci », il est difficile de respecter un délai de 5 minutes pour la réanimation. De plus, lorsque nous utilisons cette procédure, il est facile d'enregistrer des modifications dans l'infrastructure, par exemple, et d'ajuster la procédure en conséquence.
Cependant, si le système de sauvegarde est très complexe et qu'à un moment donné nous avons commis une erreur, nous pourrions également compromettre notre site de secours et, de plus, transformer les données en citrouille sur les deux sites — ce serait vraiment triste.
Exemple numéro cinq, pure hardcore.
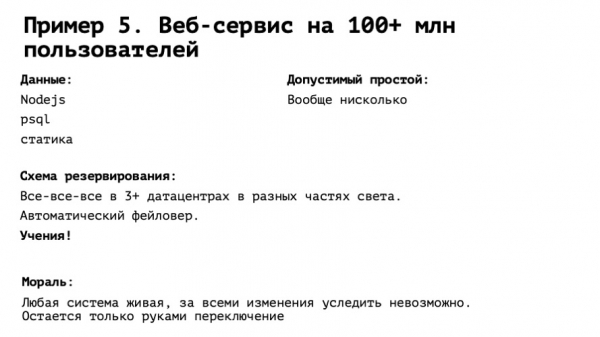
Un service international avec des centaines de millions d'utilisateurs à travers le monde. Tous les fuseaux horaires possibles, haute charge au maximum, ne pas tomber est impératif. Une minute — et ce sera triste. Que faire ? Sauvegarder, encore une fois, de manière exhaustive. Nous avons fait tout ce qui a été dit dans le précédent exemple, et un peu plus. C'est un monde idéal, et notre infrastructure — elle correspond à tous les critères du DevOps IaaC. Tout est dans Git, il suffit d'appuyer sur un bouton.
Que manque-t-il ? Juste une chose — des exercices. Sans eux, c'est impossible. On pourrait penser que tout va parfaitement, que tout est sous contrôle. Nous appuyons sur le bouton, tout se passe. Même si cela est vrai — et nous savons que ce n'est pas le cas — notre système interagit avec d'autres systèmes. Par exemple, il y a le DNS de Route 53, le stockage S3, l'intégration avec diverses API. Rien ne peut être prévu dans cette expérience théorique. Et tant que nous n'avons pas vraiment tiré le levier — nous ne saurons pas si cela fonctionne ou non.
C'est probablement tout. Ne soyez pas paresseux et ne poussez pas trop loin. Et que l'uptime soit avec vous !
Source : habr.com
