

3. Options de structure lors de l'utilisation des globaux
Une structure telle qu'un arbre orienté a différents cas particuliers. Examinons ceux qui ont une valeur pratique lors du travail avec les globaux.
3.1 Cas particulier 1. Un nœud sans branches
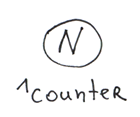 Les globaux peuvent être utilisés non seulement comme un tableau, mais aussi comme des variables ordinaires. Par exemple, comme compteur :
Set ^counter = 0  ; initialiser le compteur
Set id=$Increment(^counter) ;  incrémentation atomique
Dans ce cas, le global, en plus de la valeur, peut également avoir des branches. Un ne s'exclut pas de l'autre.
3.2 Cas particulier 2. Un sommet et plusieurs branches
En général, c'est une base de données clé-valeur classique. Et si nous conservons un tuple de valeurs comme valeur, nous obtiendrons une simple table avec une clé primaire.
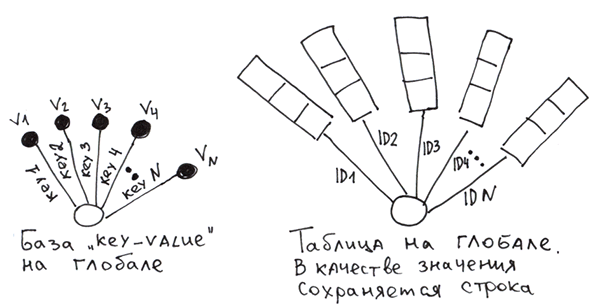
Pour réaliser une table sur des globaux, nous devrons former nous-mêmes des chaînes à partir des valeurs des colonnes, puis les sauvegarder dans le global par clé primaire. Pour pouvoir relire et séparer à nouveau la chaîne en colonnes, on peut utiliser :
- des caractères séparateurs.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - un schéma rigide, où chaque champ occupe un nombre de bytes prédéfini. Comme cela se fait dans les bases de données relationnelles.
- une fonction spéciale $LB (disponible dans Cache), qui compose une chaîne à partir des valeurs.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Ce qui est intéressant, c'est qu'il n'est pas difficile, sur les globaux, de créer quelque chose de similaire aux index secondaires dans les bases de données relationnelles. Appelons ces structures des globaux index. Un global index est un arbre auxiliaire pour une recherche rapide dans les champs qui ne font pas partie des clés primaires du global principal. Pour le remplir et l'utiliser, il faut écrire du code supplémentaire.
Créons un global index sur la première colonne.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Nous devrons maintenant consulter le global pour une recherche rapide d'informations dans la première colonne. ^i et trouver les clés primaires (id) correspondantes à la valeur requise de la première colonne.
Lors de l'insertion d'une valeur, nous pouvons immédiatement créer les globaux pour la valeur et les globaux index pour les champs nécessaires. Et pour plus de sécurité, nous allons encapsuler le tout dans une transaction.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Détails sur comment faire des M , .
Ces tables fonctionneront aussi rapidement que dans les bases de données traditionnelles (voire plus rapidement), si les fonctions d'insertion/mise à jour/suppression de lignes sont écrites en COS/M et compilées.J'ai vérifié cette affirmation avec des tests de INSERT et SELECT massifs sur une table à deux colonnes, y compris l'utilisation des commandes TSTART et TCOMMIT (transactions).
Je n'ai pas testé des scénarios plus complexes avec un accès concurrent et des transactions parallèles.
Sans utiliser de transactions, la vitesse des insertions était de 778 361 insertions/seconde sur un million de valeurs.
Avec 300 millions de valeurs — 422 141 insertions/seconde.
Avec des transactions — 572 082 insertions/seconde pour 50 millions d'insertions. Toutes les opérations ont été effectuées à partir de code M compilé.
Les disques durs sont ordinaires, pas des SSD. RAID5 avec Write-back. Processeur Phenom II 1100T.
Pour des tests similaires sur une base de données SQL, il faut écrire une procédure stockée qui réalisera des insertions en boucle. Lors des tests sur MySQL 5.5 (avec stockage InnoDB) par cette méthode, je n'ai obtenu que des chiffres ne dépassant pas 11K insertions par seconde.
Oui, la mise en œuvre des tables sur des globales semble plus complexe que dans les bases de données relationnelles. C'est pourquoi les bases de données industrielles sur des globales ont un accès SQL pour faciliter le travail avec des données tabulaires.
 En fait, si le schéma de données ne change pas souvent, la vitesse d'insertion n'est pas critique et toute la base peut facilement être représentée sous forme de tables normalisées, il est donc plus simple de travailler avec SQL, car il offre un niveau d'abstraction plus élevé.
 Dans ce cas particulier, je voulais montrer que les globales peuvent servir de constructeur pour créer d'autres bases de données.. Comme un assembleur, sur lequel on peut écrire d'autres langages. Voici des exemples de la manière dont on peut créer des analogues sur des globales
Si vous devez créer une base de données non standard avec un minimum d'efforts, il vaut la peine de se tourner vers des globales.
3.3 Cas particulier 3. Arbre à deux niveaux, chaque nœud de deuxième niveau ayant un nombre fixe de branches.
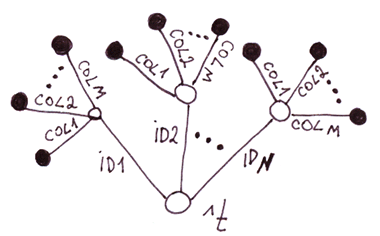 Vous l'avez probablement deviné : il s'agit d'une implémentation alternative de tables sur des globales. Comparons cette implémentation avec la précédente.
Tables sur un arbre à deux niveaux vs. sur un arbre à un seul niveau.
Inconvénients
Avantages
- Plus lent pour l'insertion, car il faut établir un nombre de nœuds égal au nombre de colonnes.
- Plus d'espace disque utilisé. En effet, les index globaux (dans le sens des index de tableaux) avec les noms de colonnes occupent de l'espace sur le disque et sont dupliqués pour chaque ligne.
- Un accès plus rapide aux valeurs des colonnes individuelles, car il n'est pas nécessaire d'analyser la ligne. D'après mes tests, c'est plus rapide de 11,5 % avec 2 colonnes et encore plus avec un plus grand nombre de colonnes.
- Plus facile de modifier le schéma de données
- Un code plus visuel
Conclusion : un goût personnel. Puisque la vitesse est l'un des principaux avantages des index globaux, il n'est presque pas logique d'utiliser cette implémentation, car elle risque de ne pas être plus rapide que les tables dans les bases de données relationnelles.
3.4 Cas général. Arbres et arbres ordonnés
Toute structure de données qui peut être représentée sous forme d'arbre s'intègre parfaitement aux index globaux.
3.4.1 Objets avec sous-objets
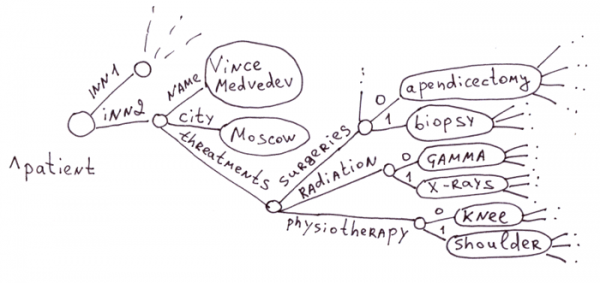
C'est le domaine traditionnel d'application des index globaux. Dans le domaine médical, il y a un grand nombre de maladies, de médicaments, de symptômes et de méthodes de traitement. Créer une table avec un million de champs pour chaque patient est peu rationnel. D'autant plus que 99 % des champs seront vides.
Imaginez une base de données SQL à partir de tables : « patient » ~ 100 000 champs, « médicament » — 100 000 champs, « thérapie » — 100 000 champs, « complications » — 100 000 champs, etc. Ou bien, il est possible de créer une base de données avec des milliers de tables, chacune pour un type de patient spécifique (et ils peuvent se chevaucher !), de traitement, de médicament, et encore des milliers de tables pour les relations entre ces tables.
Les index globaux conviennent parfaitement à la médecine, car ils permettent de créer pour chaque patient une description précise de son dossier médical, des différentes thérapies, des effets des médicaments, sous forme d'arbre, sans gaspiller d'espace disque supplémentaire sur des colonnes vides, comme ce serait le cas avec une approche relationnelle.
 Avec les index globaux, il est facile de créer une base de données contenant des informations sur les individus, où il est important de collecter et de systématiser un maximum d'informations variées sur le client. Cela est demandé dans les domaines de la médecine, de la banque, du marketing, des archives et d'autres secteurs.
.
Il est indéniable qu'il est également possible d'émuler un arbre en SQL avec seulement quelques tables (, ,,,,,,,,,), cependant, cela est beaucoup plus complexe et fonctionnera plus lentement. En essence, il faudrait écrire un global fonctionnant sur des tables et cacher tout le travail avec les tables sous une couche d'abstraction. Il est incorrect d'émuler une technologie de bas niveau (globales) avec des moyens de haut niveau (SQL). Cela n'est pas pratique.
Il n'est pas secret que modifier le schéma de données sur d'énormes tables (ALTER TABLE) peut prendre un temps considérable. MySQL, par exemple, effectue ALTER TABLE ADD|DROP COLUMN par une copie complète des informations de l'ancienne vers la nouvelle table (j'ai testé les moteurs MyISAM, InnoDB). Ce qui peut mettre en pause une base de données en production avec des milliards d'enregistrements pendant des jours, voire des semaines.
 Modifier la structure des données, si nous utilisons des globales, ne nous coûte rien. À tout moment, nous pouvons ajouter de nouvelles propriétés nécessaires à n'importe quel objet, à n'importe quel niveau de la hiérarchie. Les changements liés au renommage de branches peuvent être exécutés en arrière-plan sur une base de données opérationnelle.
C'est pourquoi, quand il s'agit de stocker des objets avec un grand nombre de propriétés optionnelles, les globales sont un excellent choix.
De plus, je rappelle que l'accès à n'importe quelle propriété est instantané, car dans un global tous les chemins représentent des B-trees.
Les bases de données basées sur des globales, en général, sont une forme de bases de données orientées documents, avec la possibilité de stocker des informations hiérarchiques. Ainsi, dans le domaine du stockage des dossiers médicaux, les globales peuvent rivaliser avec les bases de données orientées documents. Mais ce n'est pas tout à fait cela.Prenons par exemple MongoDB. Dans ce domaine, elle est inférieure aux globales pour les raisons suivantes :
- La taille du document. L'unité de stockage est un texte au format JSON (plus précisément BSON) d'une taille maximale d'environ 16 Mo. Cette restriction est spécifiquement mise en place pour que la base JSON ne ralentisse pas lors du parsing si elle contient un énorme document JSON, et qu'on accède ensuite à ses champs. Ce document doit concentrer toutes les informations sur le patient. Nous savons tous à quel point les dossiers patients peuvent être volumineux. La taille maximale du dossier de 16 Mo met immédiatement un frein aux patients dont le dossier comprend des fichiers d'IRM, des scans X et d'autres examens. Dans une branche d'un global, on peut avoir des informations allant jusqu'à des giga-octets et téra-octets. En principe, nous pourrions nous arrêter là, mais je vais continuer.
- Le temps de prise de conscience/de changement/de suppression des nouvelles propriétés dans la carte du patient. Une telle base de données doit charger l'intégralité de la carte en mémoire (ce qui représente un grand volume !), analyser le BSON, ajouter/modifier/supprimer un nouveau nœud, mettre à jour les index, empaqueter en BSON et sauvegarder sur le disque. Pour le global, il suffit de se référer à une propriété spécifique et d'effectuer des manipulations avec.
- Rapiditié d'accès à des propriétés individuelles. Avec de nombreuses propriétés dans le document et sa structure multNiveaux, l'accès aux propriétés individuelles sera plus rapide grâce à la nature B-tree de chaque chemin dans le global. En revanche, en BSON, il faudra analyser le document de manière linéaire pour trouver la propriété désirée.
3.3.2 Tableaux associatifs
Les tableaux associatifs (même avec des tableaux imbriqués) se prêtent parfaitement aux globals. Par exemple, un tel tableau en PHP se représentera dans la première image de la section 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apendicectomie", "biopsie"),
    "radiation" => array("gamma", "rayons X"),
    "physiothérapie" => array("genou", "épaule")
  )
);
3.3.3 Documents hiérarchiques : XML, JSON
Ils peuvent également être facilement stockés dans les globals. Le stockage peut se faire de différentes manières.
colonnes
La manière la plus simple de déployer XML dans des globals est de stocker les attributs des balises dans les nœuds. Et si un accès rapide aux attributs des balises est nécessaire, nous pouvons les déplacer dans des branches distinctes.
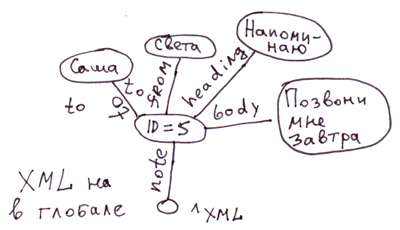
<note id="5">
<to>Vassya</to>
<from>Sveta</from>
<heading>Rappel</heading>
<body>Appelle-moi demain !</body>
</note>
Le code correspondant sera le suivant :
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Rappel"
Set ^xml("note","body")="Appelle-moi demain !"
Remarque : Pour XML, JSON, tableaux associatifs, on peut imaginer de nombreuses manières de représentation dans les globals. Dans ce cas, nous n'avons pas réfléchi à l'ordre des balises imbriquées dans la balise note. Dans le global ^xml les balises imbriquées seront affichées par ordre alphabétique. Pour refléter strictement l'ordre, on peut utiliser, par exemple, une telle représentation :
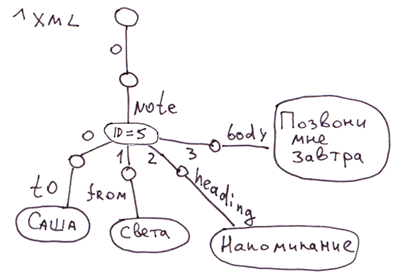
JSON.
La première image de la section 3.3.1 montre la représentation de ce document JSON :
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "treatments": {
    "surgeries": ["apendicectomie", "biopsie"],
    "radiation": ["gamma", "rayons X"],
    "physiothérapie": ["genou", "épaule"]
  },
};
3.3.4 Structures identiques liées par des relations hiérarchiques
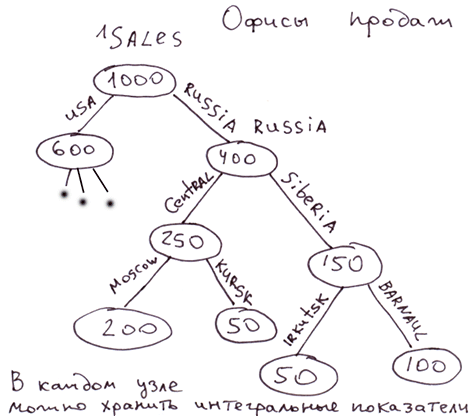
Exemples : structure des bureaux de vente, position des personnes dans une structure MLM, base de débuts en échecs.
Base des débuts. On peut utiliser l'évaluation de la force du coup comme valeur d'index pour le global. Ainsi, pour choisir le coup le plus fort, il suffira de choisir la branche avec le poids le plus élevé. Dans le global, toutes les branches à chaque niveau seront triées par force du coup.
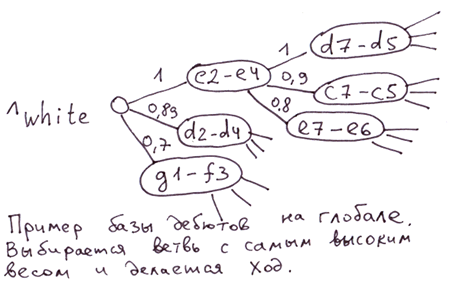
Structure des bureaux de vente, structure des personnes en MLM. Dans les nœuds, on peut stocker certaines valeurs de mise en cache reflétant les caractéristiques de l'ensemble de l'arbre sous-jacent. Par exemple, le volume de vente de cet arbre. À tout moment, nous pouvons obtenir un chiffre reflétant les réalisations de n'importe quelle branche.
4. Dans quels cas est-il le plus avantageux d'utiliser des globals
La première colonne présente les cas où vous obtiendrez un gain de vitesse significatif en utilisant des globals, et la deuxième où le développement ou le modèle de données sera simplifié.
Vitesse
Facilité de traitement/présentation des données
- Insertion [avec tri automatique à chaque niveau], [indexation par la clé principale]
- Suppression des sous-arbres
- Objets avec une masse de propriétés imbriquées, nécessitant un accès individuel
- Structure hiérarchique avec possibilité de parcourir les branches filles depuis n'importe quelle, même inexistante
- Parcours des sous-arbres en profondeur
- Objets/entités avec un nombre énorme de propriétés/entités optionnelles [et/ou imbriquées]
- Données sans schéma (schema-less). Quand de nouvelles propriétés peuvent souvent apparaître et que les anciennes disparaissent.
- Il est nécessaire de créer une base de données non standard.
- Bases de chemins et arbres de décisions. Quand les chemins sont commodément représentés sous forme d'arbre.
- Suppression de structures hiérarchiques sans utiliser la récursion
Suite .
Avertissement: Cet article et mes commentaires à son sujet représentent mon avis et ne reflètent pas la position officielle de l'entreprise InterSystems.
Source : habr.com
