

Les véritables épées à deux tranchants des bases de données — les globals — sont bien connues, mais peu de gens savent encore les utiliser efficacement ou ne maîtrisent pas cette super-arme.
Si l'on utilise les globals pour résoudre des tâches où ils excellent réellement, il est possible d'obtenir des résultats exceptionnels. Que ce soit en termes de performance ou de simplicité de la solution., ).
Les globals sont une manière spéciale de stocker et de traiter des données, complètement différente des tables SQL. Ils sont apparus en 1966 dans le langage (évolution — , ensuite COS) dans les bases de données médicales et sont encore , ainsi qu'ils ont pénétré d'autres domaines, où la fiabilité et la haute performance sont requises : finances, trading, etc.
Les globals dans les SGBD modernes supportent les transactions, la journalisation, la réplication, et le partitionnement. C'est-à-dire qu'on peut construire des systèmes modernes, fiables, distribués et rapides sur eux.
Les globals ne vous limitent pas aux contraintes du modèle relationnel. Ils offrent la liberté de concevoir des structures de données optimisées pour des tâches spécifiques. Pour de nombreuses applications, une utilisation judicieuse des globals peut être véritablement une arme secrète, offrant des performances dont les développeurs d'applications relationnelles ne peuvent que rêver.
Les globals en tant que méthode de stockage des données peuvent être utilisés dans de nombreux langages de programmation modernes, qu'ils soient de haut ou de bas niveau. C'est pourquoi dans cet article, je vais me concentrer précisément sur les globals, et non sur le langage dont ils sont issus.
2. Comment fonctionnent les globals
Commençons par examiner comment fonctionnent les globals et quels sont leurs points forts. On peut considérer les globals sous différents angles. Dans cette partie de l'article, nous allons les considérer comme des arbres. Ou comme des stockages de données hiérarchiques.
En termes simples, un global est un tableau persistant. Un tableau qui est automatiquement sauvegardé sur disque.
Il est difficile d'imaginer quelque chose de plus simple pour le stockage de données. En code (dans les langages COS/M), il ne se distingue d'un tableau associatif classique que par le symbole ^ placé avant le nom.
Pour sauvegarder des données dans un global, il n'est pas nécessaire d'apprendre le langage de requêtes SQL, les commandes pour travailler avec eux sont très simples. On peut les apprendre en une heure.
Commençons par l'exemple le plus simple. Un arbre à un niveau avec 2 branches. Les exemples sont écrits en COS.
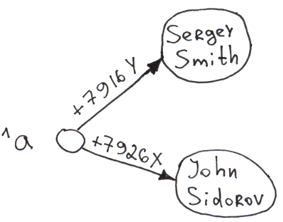
Set ^a("+7926X") = "John Sidorov"
Set ^a("+7916Y") = "Sergey Smith"
Lors de l'insertion d'informations dans le global (commande Set), trois choses se produisent automatiquement :
- Sauvegarde des données sur le disque.
- Indexation. Ce qui est entre parenthèses est une clé (dans la littérature anglophone — «subscript»), et ce qui est à droite du signe égal est une valeur («node value»).
- Tri. Les données sont triées par clé. Lors de la traversée du tableau, le premier élément sera «Sergey Smith», et le deuxième «John Sidorov». Lors de la récupération de la liste des utilisateurs depuis le global, la base ne perd pas de temps à trier. De plus, il est possible de demander l'affichage d'une liste triée à partir de n'importe quelle clé, même inexistante (l'affichage commencera par la première clé réelle qui suit celle qui n'existe pas).
Toutes ces opérations se produisent incroyablement rapidement. Sur un ordinateur domestique, j'obtenais des valeurs allant jusqu'à 750 000 insertions/seconde dans un seul processus. Sur des processeurs multicœurs, les valeurs peuvent atteindre d'insertions/seconde.
Bien sûr, la vitesse d'insertion en elle-même ne signifie pas grand-chose. Par exemple, il est possible d'écrire très rapidement des informations dans des fichiers textes — c'est ainsi que fonctionne le traitement de Visa. Mais dans le cas des globals, nous obtenons un stockage structuré et indexé, avec lequel il est possible de travailler facilement et rapidement par la suite.

- Le plus grand atout des globals est la rapidité d'insertion de nouveaux nœuds.
- Les données dans le global sont toujours indexées. Leur traversée tant au niveau qu'en profondeur de l'arbre est toujours rapide.
Ajoutons quelques branches supplémentaires au deuxième et au troisième niveau dans le global.
Set ^a("+7926X", "city") = "Moscou"
Set ^a("+7926X", "city", "street") = "Req Square"
Set ^a("+7926X", "age") = 25
Set ^a("+7916Y", "city") = "Londres"
Set ^a("+7916Y", "city", "street") = "Baker Street"
Set ^a("+7916Y", "age") = 36 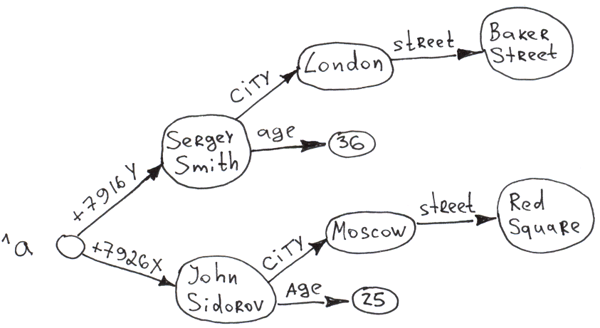
Il est évident que sur la base des globals, il est possible de construire des arbres multicouches. De plus, l'accès à n'importe quel nœud est pratiquement instantané grâce à l'auto-indexation lors de l'insertion. Et à chaque niveau de l'arbre, toutes les branches sont triées par clé.
Comme on peut le voir, l'information peut être stockée tant dans la clé que dans la valeur. La longueur totale de la clé (somme des longueurs de tous les index) peut atteindre , et les valeurs pour Caché. Le nombre de niveaux dans l'arbre (le nombre de dimensions) est de 31.
Un autre point intéressant. Il est possible de construire un arbre sans définir les valeurs des nœuds des niveaux supérieurs.
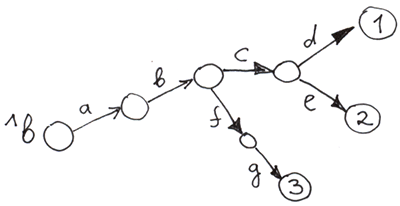
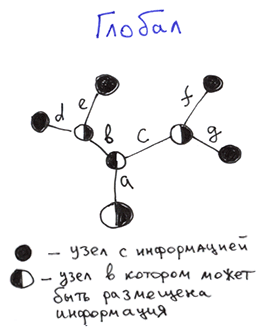
Définir ^b("a", "b", "c", "d") = 1
Définir ^b("a", "b", "c", "e") = 2
Définir ^b("a", "b", "f", "g") = 3
Les cercles vides sont des nœuds auxquels aucune valeur n'est attribuée.
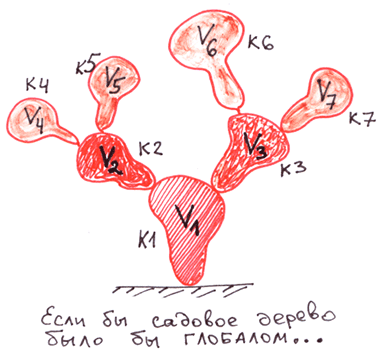
Pour mieux comprendre les globales, comparons-les à d'autres arbres : aux arbres fruitiers et aux arbres des systèmes de fichiers.
Comparons les arbres sur les globales aux structures hiérarchiques les plus familières : aux arbres ordinaires qui poussent dans les jardins et les champs, ainsi qu'aux systèmes de fichiers.
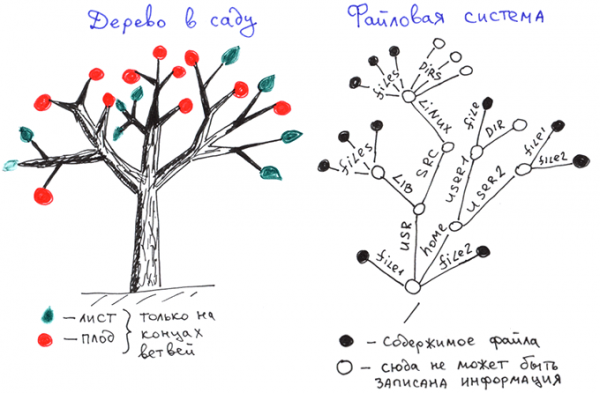
Comme nous le voyons avec les arbres fruitiers, les feuilles et les fruits ne se trouvent qu'à l'extrémité des branches.
Dans les systèmes de fichiers, les informations sont stockées uniquement à l'extrémité des branches qui sont des noms de fichiers complets.
Voici la structure des données globales.
 Différences :
- Nœuds internes : Les informations dans une globale peuvent être stockées dans chaque nœud, et pas seulement à l'extrémité des branches.
- Nœuds externes : Une globale doit obligatoirement avoir des valeurs définies à l'extrémité des branches, ce qui n'est pas le cas pour les arbres FS et les arbres fruitiers.
En ce qui concerne certains nœuds internes, on peut dire que la structure d'une globale est un sur-ensemble de la structure des arbres de noms dans les systèmes de fichiers et les arbres fruitiers, c'est-à-dire plus flexible.
De manière générale, une globale représente un arbre ordonné avec la possibilité de stocker des données dans chaque nœud.
Pour mieux comprendre le fonctionnement des globales, imaginons ce qu'il en serait si les concepteurs de systèmes de fichiers utilisaient une approche similaire à celle des globales pour le stockage d'informations ?
- À la suppression d'un seul fichier dans un répertoire, le répertoire serait automatiquement supprimé, ainsi que tous les répertoires supérieurs ne contenant que ce répertoire nouvellement supprimé.
- Le besoin de répertoires disparaîtrait. Il y aurait simplement des fichiers avec des sous-fichiers et des fichiers sans sous-fichiers. Si l'on compare à un arbre ordinaire, chaque branche deviendrait un fruit.

- Des éléments tels que les fichiers README.txt pourraient disparaître. Tout ce qui devait être dit sur le contenu d'un répertoire pourrait être inscrit dans le fichier du répertoire lui-même. Dans l'espace des chemins, le nom d'un fichier est indistinguable de celui d'un répertoire, donc il pourrait n'y avoir que des fichiers.
- La vitesse de suppression des répertoires avec des sous-répertoires et des fichiers augmenterait considérablement. De nombreuses fois, des articles sont apparus sur Habr sur la durée et la difficulté de supprimer des millions de petits fichiers (, ). Cependant, si l'on crée un système de fichiers pseudo sur les Globals, cela prendra des secondes, voire des fractions de seconde. Lorsque j'ai testé la suppression de sous-arbres sur mon ordinateur personnel, j'ai pu supprimer de 96 à 341 millions de nœuds d'un arbre à deux niveaux en une seconde sur HDD (pas sur SSD). Il s'agit de la suppression d'une partie de l'arbre, et non de la simple suppression de tout le fichier avec les Globals.

La suppression de sous-arbres est une autre grande force des Globals. La récursivité n'est pas nécessaire pour cela. Cela se produit incroyablement rapidement.
Dans notre arbre, cela pourrait être fait avec la commande Kill.
Kill ^a("+7926X") 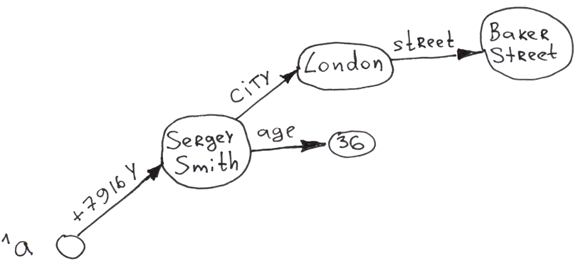
Pour mieux comprendre quelles actions nous pouvons effectuer sur les Globals, voici un tableau succinct.
Commandes et fonctions principales pour travailler avec les Globals dans COS
Définir des branches jusqu'au nœud (si elles ne sont pas déjà définies) et la valeur du nœud
Copier un sous-arbre
Supprimer un sous-arbre
Supprimer la valeur d'un nœud spécifique. Le sous-arbre sortant du nœud n'est pas touché.
Parcours complet de l'arbre avec approfondissement
Parcours des branches d'un nœud spécifique
Vérifier si le nœud est défini
Incrémentation atomique de la valeur d'un nœud. Pour éviter les lectures et écritures, pour ACID. Il est récemment recommandé de passer à
Merci de votre attention, nous sommes prêts à répondre à vos questions.
Avertissement: Cet article et mes commentaires à son sujet représentent mon avis et ne reflètent pas la position officielle de l'entreprise InterSystems.
Suite . Vous découvrirez quels types de données peuvent être affichés sur les Globals et dans quelles tâches ils apportent le maximum de bénéfice.
Source : habr.com
