

Note de traduction.: Nous vous présentons des détails techniques sur les raisons de la récente interruption du service cloud, géré par les créateurs de Grafana. C'est un exemple classique de la façon dont une nouvelle fonctionnalité, apparemment très utile, conçue pour améliorer la qualité de l'infrastructure… peut causer des dommages si les nombreux aspects de son utilisation en production ne sont pas pris en compte. Il est remarquable d'avoir des matériaux comme celui-ci, qui permettent d'apprendre non seulement de ses propres erreurs. Les détails sont dans la traduction de ce texte du vice-président produit de Grafana Labs.
Le vendredi 19 juillet, le service Hosted Prometheus dans Grafana Cloud a cessé de fonctionner pendant environ 30 minutes. Je présente mes excuses à tous les clients qui ont souffert de cette panne. Notre objectif est de fournir les outils nécessaires à la surveillance, et nous comprenons que leur indisponibilité complique votre vie. Nous prenons cet incident très au sérieux. Dans cette note, nous expliquons ce qui s'est passé, comment nous avons réagi et ce que nous faisons pour éviter que cela ne se reproduise.
Contexte
Le service Grafana Cloud Hosted Prometheus est basé sur — un projet CNCF visant à créer un service Prometheus évolutif horizontalement, hautement disponible et multi-tenant. L'architecture Cortex se compose d'un ensemble de microservices distincts, chacun remplissant sa propre fonction : réplication, stockage, requêtes, etc. Cortex est en développement actif, avec constamment de nouvelles fonctionnalités et une performance améliorée. Nous déployons régulièrement de nouvelles versions de Cortex dans les clusters afin que nos clients puissent bénéficier de ces fonctionnalités - heureusement, Cortex peut être mis à jour sans temps d'arrêt.
Pour des mises à jour sans temps d'arrêt, le service Ingester de Cortex nécessite une réplique supplémentaire de l'Ingester pendant le processus de mise à jour. (Note de traduction.: — le composant de base de Cortex. Sa tâche est de collecter un flux constant d'échantillons, de les regrouper en chunks Prometheus et de les stocker dans une base de données comme DynamoDB, BigTable ou Cassandra.) Cela permet aux anciens Ingester d'envoyer les données actuelles aux nouveaux Ingester. Il convient de noter que les Ingester sont gourmands en ressources. Pour leur fonctionnement, il est nécessaire de disposer de 4 cœurs et de 15 Go de mémoire par pod, c'est-à-dire 25 % de la puissance processeur et de la mémoire de la machine de base dans le cas de nos clusters Kubernetes. En général, nous avons souvent beaucoup plus de ressources inutilisées dans le cluster que les 4 cœurs et 15 Go de mémoire, nous pouvons donc facilement déployer ces Ingester supplémentaires pendant les mises à jour.
Cependant, il arrive souvent qu'aucune des machines n'ait ces 25 % de ressources non utilisées pendant le fonctionnement normal. Et nous ne cherchons pas à en avoir : le CPU et la mémoire seront toujours utiles pour d'autres processus. Pour résoudre ce problème, nous avons décidé de tirer parti de . L'idée est d'attribuer aux Ingester une priorité plus élevée qu'aux autres microservices (sans état). Quand nous avons besoin de déployer un Ingester supplémentaire (N+1), nous déplaçons temporairement d'autres pods plus petits. Ces pods sont déplacés vers des ressources libres sur d'autres machines, laissant suffisamment de « trou » pour lancer l'Ingester supplémentaire.
Le jeudi 18 juillet, nous avons déployé quatre nouveaux niveaux de priorité dans nos clusters : critique, un, moyenne et basse. Ils ont été testés sur un cluster interne sans trafic client pendant environ une semaine. Par défaut, les pods sans priorité définie avaient moyenne la priorité, une classe avec haute priorité a été attribuée aux Ingester. Critique était réservé à la surveillance (Prometheus, Alertmanager, node-exporter, kube-state-metrics, etc.). Notre config est ouverte et le PR peut être consulté .
Incident
Le vendredi 19 juillet, un des ingénieurs a lancé un nouveau cluster Cortex dédié pour un client majeur. La configuration de ce cluster n'incluait pas les nouvelles priorités des pods, donc toutes les nouvelles pods se voyaient assignées la priorité par défaut — moyenne.
Le cluster Kubernetes manquait de ressources pour le nouveau cluster Cortex, et le cluster de production Cortex existant n'avait pas été mis à jour (les Ingester sont restés sans haute priorité). Étant donné que les Ingester du nouveau cluster avaient par défaut moyenne la priorité, tandis que les pods existants en production ne disposaient d'aucune priorité, les Ingester du nouveau cluster ont écarté les Ingester du cluster de production Cortex existant.
Le ReplicaSet pour l'Ingester évincé dans le cluster de production a détecté un pod évincé et a créé un nouveau pod pour maintenir le nombre de répliques défini. Le nouveau pod a été attribué par défaut moyenne une priorité, et un autre Ingester "ancien" dans la production a perdu des ressources. Le résultat a été un processus en cascade, qui a conduit à l'éviction de tous les pods avec Ingester pour les clusters de production de Cortex.
Les Ingester sont persistants et conservent des données pendant les 12 heures précédant. Cela nous permet de les compresser plus efficacement avant de les écrire dans un stockage à long terme. Pour cela, Cortex shard les données par séries, utilisant une table de hachage distribuée (DHT), et réplique chaque série sur trois Ingester avec une cohérence de quorum de style Dynamo. Cortex n'écrit pas de données dans les Ingester qui sont déconnectés. Ainsi, lorsque de nombreux Ingester quittent le DHT, Cortex ne peut pas assurer une réplication suffisante des enregistrements, et ceux-ci "échouent".
Détection et résolution
Les nouvelles alertes Prometheus basées sur le "budget d'erreurs" (error-budget-based — des détails apparaîtront dans un futur article) ont commencé à tirer la sonnette d'alarme quatre minutes après le début de la déconnexion. Au cours des cinq minutes suivantes, nous avons diagnostiqué et amplifié le cluster Kubernetes sous-jacent pour héberger à la fois les nouveaux et les anciens clusters de production.
Encore cinq minutes plus tard, les anciens Ingester ont réussi à écrire leurs données, tandis que les nouveaux ont démarré, et les clusters Cortex étaient à nouveau accessibles.
Dix minutes supplémentaires ont été nécessaires pour diagnostiquer et corriger des erreurs de type out-of-memory (OOM) des serveurs proxy inverses d'authentification situés devant Cortex. Les erreurs OOM étaient causées par une augmentation découragée du QPS (considérant que c'était dû à des requêtes excessivement agressives venant des serveurs Prometheus du client).
Conséquences
La durée totale de l'indisponibilité a été de 26 minutes. Aucune donnée n'a été perdue. Les Ingester ont réussi à charger toutes les données en mémoire dans le stockage à long terme. Pendant la déconnexion, les serveurs Prometheus des clients ont mis en mémoire tampon les (remote) enregistrements via basée sur le WAL (créée par de Grafana Labs) et ont réitéré les enregistrements échoués après la panne.
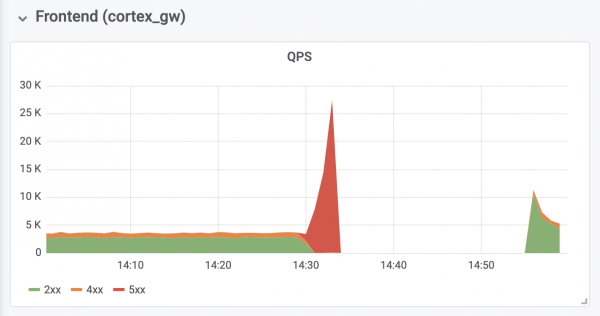
Les opérations d'écriture du cluster de production
Conclusions
Il est important de tirer des leçons de cet incident et de prendre les mesures nécessaires pour éviter sa récurrence.
En repensant à cela, il convient de reconnaître que nous n'aurions pas dû définir par défaut moyenne la priorité tant que tous les Ingester étaient en production un en priorité. De plus, il aurait fallu prévoir à l'avance leur haute priorité. Maintenant, tout est corrigé. Nous espérons que notre expérience aidera d'autres organisations envisageant d'utiliser des priorités de pods dans Kubernetes.
Nous ajouterons un niveau de contrôle supplémentaire sur le déploiement de tout objet supplémentaire dont la configuration est globale au cluster. À l'avenir, de tels changements seront évalués pardeun plus grand nombre de personnes. En outre, la modification qui a conduit à l'échec était jugée trop insignifiante pour un document de projet distinct — elle n'a été discutée que dans un problème GitHub. Dorénavant, tous les changements de configuration similaires seront accompagnés d'une documentation de projet appropriée.
Enfin, nous automatiserons le redimensionnement du serveur proxy inverse d'authentification pour éviter les OOM lors de la surcharge, que nous avons vécue, et analyserons les paramètres par défaut de Prometheus liés au rollback et au scaling, afin d'éviter à l'avenir des problèmes similaires.
L'échec que nous avons rencontré a également eu des conséquences positives : ayant à disposition les ressources nécessaires, Cortex s'est automatiquement rétabli sans intervention supplémentaire. Nous avons également acquis une expérience précieuse avec — notre nouveau système d'agrégation de logs — qui a permis de s'assurer que tous les Ingester se comportaient correctement pendant et après l'échec.
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com
