

Au cours des dernières années, les bases de données de séries temporelles (Time-series databases) sont passées d'une curiosité (spécialement utilisée soit dans des systèmes de surveillance ouverts (liée à des solutions spécifiques), soit dans des projets Big Data) à un « produit de consommation courante ». En Russie, nous devons remercier Yandex et ClickHouse pour cela. Avant cela, si vous deviez stocker un grand volume de données de séries temporelles, vous deviez soit accepter de mettre en place une monstrueuse pile Hadoop et de la maintenir, soit d'interagir avec des protocoles spécifiques à chaque système.
Il peut sembler qu'en 2019, un article sur laquelle TSDB utiliser se résumerait à une seule phrase : « utilisez simplement ClickHouse ». Mais… il y a des nuances.
En effet, ClickHouse se développe activement, sa base d'utilisateurs s'élargit, et le soutien est très actif, mais ne sommes-nous pas devenus des prisonniers du succès public de ClickHouse, qui a éclipsé d'autres solutions peut-être plus efficaces/fiables ?
Au début de l'année dernière, nous avons retravaillé notre propre système de surveillance, au cours de laquelle la question de choisir une base appropriée pour le stockage des données s'est posée. Je souhaite raconter ici l'histoire de ce choix.
Définition du problème
Tout d'abord — une introduction nécessaire. Pourquoi avons-nous besoin d'un système de surveillance propre et comment était-il structuré ?
Nous avons commencé à offrir des services de support en 2008, et en 2010, il est devenu clair qu'il était difficile d'agréger les données sur les processus au sein de l'infrastructure client avec les solutions existantes à l'époque (nous parlons, hélas, de Cacti, Zabbix et de Graphite en développement).
Nos principales exigences étaient :
- le support (à l'époque — dizaines, et à terme — des centaines) de clients au sein d'un seul système tout en ayant un système de gestion des alertes centralisé ;
- la flexibilité dans la gestion du système d'alertes (escalade des alertes entre les intervenants, prise en compte des plannings, base de connaissances) ;
- la possibilité d'une détaillé des graphiques (Zabbix produisait alors des graphiques sous forme d'images) ;
- un stockage de longue durée d'un grand nombre de données (un an ou plus) et la possibilité de les extraire rapidement.
Dans cet article, nous nous intéressons au dernier point.
En ce qui concerne le stockage, les exigences étaient les suivantes :
- le système doit fonctionner rapidement ;
- il serait souhaitable que le système ait une interface SQL ;
- le système doit être stable et avoir une base d'utilisateurs active et un support (nous avons déjà été confrontés à la nécessité de maintenir des systèmes comme MemcacheDB, qui n’est plus développé, ou le stockage distribué MooseFS, dont le bug tracker était en chinois : nous ne souhaitons pas revivre cette histoire pour notre projet) ;
- conformité au théorème CAP : Consistance (nécessaire) — les données doivent être à jour, nous ne voulons pas que le système de gestion des alertes ne reçoive pas de nouvelles données et génère des alertes sur l'absence de données pour tous les projets ; Tolérance aux partitions (nécessaire) — nous ne voulons pas avoir un système de Split Brain ; Disponibilité (non critique, en cas d’existence d’une réplique active) — nous pouvons nous-mêmes passer au système de secours en cas de panne, par le code.
Étrangement, à l'époque, la solution idéale pour nous était MySQL. Notre structure de données était très simple : id du serveur, id du compteur, timestamp et valeur ; la récupération rapide des données chaudes était assurée par la grande taille du buffer pool, tandis que la récupération des données historiques était réalisée via SSD.
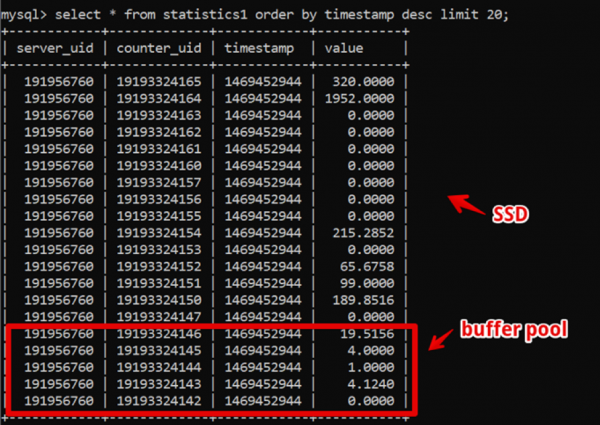
Ainsi, nous avons réussi à extraire des données fraîches des deux dernières semaines, avec une précision à la seconde en 200 ms avant le moment de l’affichage complet des données, et nous avons vécu avec ce système assez longtemps.
Entre-temps, le temps passait et la quantité de données augmentait. En 2016, le volume des données atteignait des dizaines de téraoctets, ce qui représentait un coût significatif dans le cadre de stockage SSD loués.
À ce moment-là, les bases de données colonne connues ont commencé à se répandre activement, et nous avons commencé à y penser sérieusement : dans les bases de données colonne, les données sont stockées, comme on peut le comprendre, par colonnes, et si l'on regarde nos données, il est facile de voir un grand nombre de doublons, qui pourraient, si l'on utilisait une base de données colonne, être compressés.
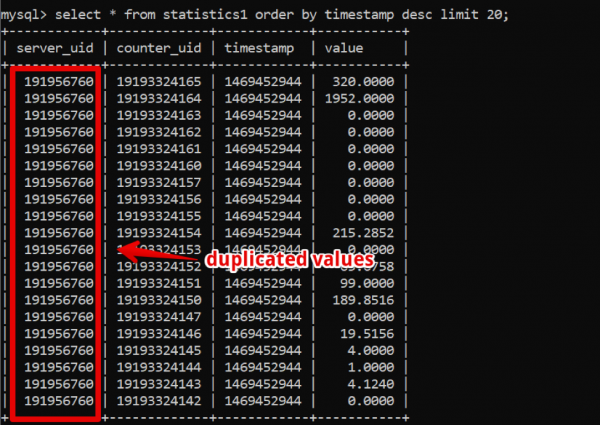
Cependant, le système clé pour le travail de l’entreprise continuait à fonctionner de manière stable, et nous ne souhaitions pas expérimenter un passage à autre chose.
En 2017, lors de la conférence Percona Live à San José, les développeurs de Clickhouse se sont peut-être présentés pour la première fois. À première vue, le système semblait prêt pour la production (après tout, Yandex.Metrica est une production sérieuse), le support était rapide et simple, et surtout, l'exploitation était facile. Depuis 2018, nous avons entamé le processus de migration. Mais à cette époque, il y avait de nombreuses solutions TSDB « matures » et éprouvées, et nous avons décidé de consacrer du temps considérable à comparer les alternatives pour nous assurer qu'il n'y avait pas de solutions alternatives à Clickhouse qui répondent à nos exigences.
En plus des exigences déjà mentionnées pour le stockage, de nouvelles exigences sont apparues :
- le nouveau système doit garantir au minimum des performances équivalentes à celles de MySQL sur le même matériel ;
- le stockage du nouveau système doit occuper beaucoup moins d'espace ;
- La base de données doit toujours être facile à gérer ;
- nous voulions minimiser les modifications de l'application lors du changement de base de données.
Quels systèmes avons-nous commencé à envisager
Apache Hive/Apache Impala
Le vieux et éprouvé stack Hadoop. En gros, c'est une interface SQL construite au-dessus du stockage de données dans des formats propriétaires sur HDFS.
Avantages.
- Avec une exploitation stable, il est très facile de scalabilité des données.
- Il existe des solutions de stockage en colonnes (moins d'espace).
- Exécution très rapide des tâches parallélisées en présence de ressources.
Inconvénients.
- C'est Hadoop, et c'est compliqué à exploiter. Si nous ne sommes pas prêts à prendre une solution prête à l'emploi dans le cloud (et nous ne sommes pas prêts en raison des coûts), l'ensemble du stack devra être assemblé et maintenu par les administrateurs, ce que nous préférerions éviter.
- Les données sont agrégées .
Cependant :
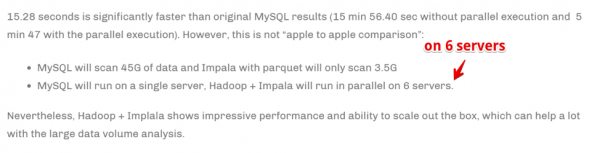
La vitesse est atteinte en scalant le nombre de serveurs de calcul. En d'autres termes, si nous sommes une grande entreprise, nous faisons de l'analyse et il est crucial pour notre activité d'agréger les informations le plus rapidement possible (même au prix de l'utilisation d'un grand nombre de ressources de calcul), cela pourrait être notre choix. Mais nous n'étions pas prêts à multiplier par plusieurs fois notre parc matériel pour la vitesse d'exécution des tâches.
Druid/Pinot
Déjà beaucoup plus orienté TSDB, mais encore une fois — stack Hadoop.
Oui .
En quelques mots : Druid/Pinot semblent mieux que Clickhouse dans les cas où :
- Vous avez une nature de données hétérogène (dans notre cas, nous enregistrons uniquement des séries temporelles de métriques serveur, il s'agit essentiellement d'une seule table. Mais il peut y avoir d'autres cas d'utilisation : des séries temporelles d'équipements, des séries temporelles économiques, etc. - chacune avec sa propre structure, qui doit être agrégée et traitée).
- Cependant, il y a beaucoup de ces données.
- Les tables et les données avec des séries temporelles apparaissent et disparaissent (c'est-à-dire qu'un certain ensemble de données arrive, est analysé puis supprimé).
- Il n'y a pas de critère clair selon lequel les données peuvent être partitionnées.
Dans les cas contraires, ClickHouse se montre plus performant, et c'est notre cas.
ClickHouse
- Semblable à SQL.
- Facile à gérer.
- Les gens disent qu'il fonctionne.
Il figure sur la liste restreinte des tests.
InfluxDB
Une alternative étrangère à ClickHouse. Parmi les inconvénients : la haute disponibilité n'est présente que dans la version commerciale, mais doit être comparée.
Il figure sur la liste restreinte des tests.
Cassandra
D'une part, nous savons que des systèmes de surveillance tels que, par exemple, l'utilisent pour stocker des séries temporelles métriques. ou OkMeter. Cependant, il y a des spécificités.
Cassandra n'est pas une base de données colonne dans son sens habituel. Elle ressemble davantage à une base de données ligne, mais chaque ligne peut avoir un nombre différent de colonnes, ce qui facilite l'organisation d'une représentation en colonnes. Dans ce sens, il est clair qu'avec une limite de 2 milliards de colonnes, il est possible de stocker certaines données précisément dans les colonnes (comme les séries temporelles). Par exemple, MySQL a une limite de 4096 colonnes et il est facile de rencontrer l'erreur de code 1117 si l'on essaie de faire la même chose.
Le moteur Cassandra est conçu pour le stockage de grandes quantités de données dans un système distribué sans maître. Dans le cadre du théorème CAP, Cassandra favorise principalement l'AP, c'est-à-dire la disponibilité des données et la résistance à la partition. Ainsi, cet outil peut être idéal si l'on a besoin d'écrire principalement dans cette base de données et de la lire de manière assez occasionnelle. Il est donc logique d'utiliser Cassandra comme un système de stockage 'froid'. C'est-à-dire comme un endroit de stockage fiable et à long terme pour de grands ensembles de données historiques qui sont rarement nécessaires, mais qui peuvent être récupérées si besoin. Cependant, pour une vision complète, nous allons également tester ce système. Mais, comme je l'ai dit précédemment, je n'ai pas le désir de réécrire activement le code pour la solution de base de données choisie, donc nous allons le tester de manière quelque peu limitée — sans adapter la structure de la base aux spécificités de Cassandra.
Prometheus
Par curiosité, nous avons décidé de tester la performance du stockage Prometheus — simplement pour comprendre si nous sommes plus rapides que les solutions actuelles ou plus lents et dans quelle mesure.
Méthodologie et résultats du test
Ainsi, nous avons testé 5 bases de données dans les 6 configurations suivantes : ClickHouse (1 nœud), ClickHouse (table distribuée sur 3 nœuds), InfluxDB, Mysql 8, Cassandra (3 nœuds) et Prometheus. Le plan de test est le suivant :
- nous chargeons des données historiques sur une semaine (840 millions de valeurs par jour ; 208 000 métriques) ;
- nous générons une charge d'écriture (nous avons examiné 6 modes de charge, voir ci-dessous) ;
- parallèlement à l'écriture, nous effectuons périodiquement des sélections, en émulant les requêtes d'un utilisateur travaillant avec des graphiques. Pour ne pas compliquer les choses, nous choisissons des données sur 10 métriques (c'est exactement le nombre sur le graphique CPU) pour une semaine.
Nous générons une charge, en émulation du comportement de notre agent de surveillance, qui envoie des valeurs à chaque métrique toutes les 15 secondes. Dans ce cadre, il nous intéresse de varier :
- le nombre total de métriques auxquelles des données sont écrites ;
- l'intervalle d'envoi des valeurs à une métrique ;
- la taille du lot.
Concernant la taille du lot. Étant donné que presque toutes nos bases de données testées ne recommandent pas de charger des insertions individuelles, nous aurons besoin d'un relais qui collecte les métriques entrantes et les groupe par quantité suffisante pour les écrire dans la base par insertion par lot.
De plus, pour mieux comprendre comment interpréter ensuite les données obtenues, imaginons que nous n'envoyons pas simplement une multitude de métriques, mais que ces métriques sont organisées en serveurs — avec 125 métriques par serveur. Ici, le serveur est simplement une entité virtuelle — juste pour comprendre que, par exemple, 10 000 métriques correspondent à environ 80 serveurs.
Et donc, en tenant compte de tout cela, voici nos 6 modes de charge pour la base de données en mode écriture :
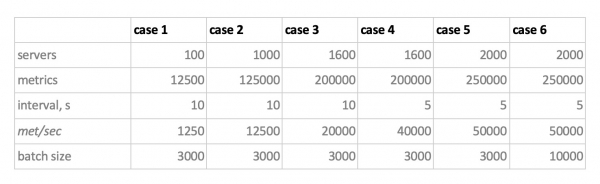
Il y a deux aspects à considérer. Tout d'abord, pour Cassandra, ces tailles de batch se sont révélées trop grandes; là, nous avons utilisé des valeurs de 50 ou 100. Deuxièmement, comme Prometheus fonctionne strictement en mode pull, c'est-à-dire qu'il va chercher lui-même les données des sources de métriques (et même pushgateway, malgré son nom, ne change pas fondamentalement la situation), les charges correspondantes ont été réalisées à l'aide d'une combinaison de configurations statiques.
Les résultats des tests sont les suivants :
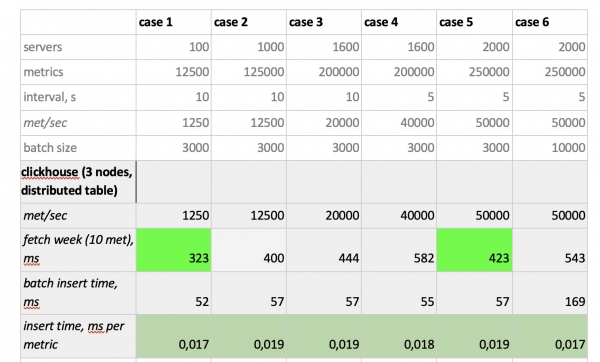
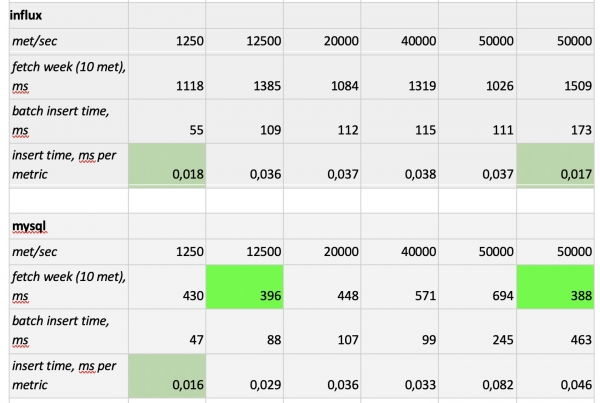
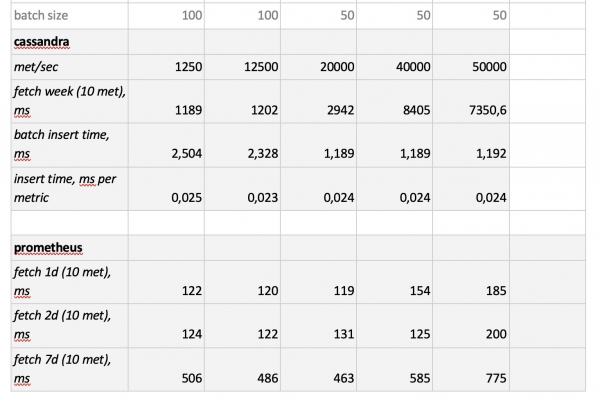
Il convient de noter: des sélections incroyablement rapides de Prometheus, des sélections terriblement lentes de Cassandra, des sélections inacceptablement lentes d'InfluxDB ; ClickHouse a remporté la victoire en termes de vitesse d'écriture, et Prometheus ne participe pas à la compétition car il fait l'insertion lui-même en interne et nous ne mesurons rien.
En fin de compte: ClickHouse et InfluxDB se sont le mieux comportés, mais il n'est possible de construire un cluster Influx que sur la base de la version Entreprise, qui coûte de l'argent, tandis que ClickHouse est gratuit et développé en Russie. Il est logique qu'aux États-Unis, le choix se porte probablement sur InfluxDB, tandis qu'ici, c'est en faveur de ClickHouse.
Source : habr.com
