

Bienvenue, Habr !
Nous avons été les premiers à introduire le thème sur le marché russe et nous continuons son développement. En particulier, nous avons trouvé intéressant le sujet de l'interaction entre Kafka et . Un article général (et plutôt prudent) sur ce sujet a été publié sur le blog de la société Confluent en octobre dernier, écrit par Gwen Shapira. Aujourd'hui, nous souhaitons attirer votre attention sur un article plus récent, d'avril, de Johann Gyger, qui, bien qu'il ait posé une question dans le titre, traite le sujet de manière plus concrète, accompagnant le texte de liens intéressants. Pardonnez-nous cette traduction libre de « chaos monkey », si vous le pouvez !
Introduction
Kubernetes est destiné à fonctionner avec des charges de travail sans état. En général, ces charges de travail se présentent sous forme d'architecture à microservices, elles sont légères, se prêtent bien à la scalabilité horizontale, obéissent aux principes des applications en 12 facteurs, permettent de travailler avec des disjoncteurs (circuit breakers) et des chaos monkeys.
Kafka, de l'autre côté, agit essentiellement comme une base de données distribuée. Ainsi, lors de son utilisation, vous devez gérer l'état, qui est beaucoup plus lourd qu'un microservice. Kubernetes prend en charge les charges de travail avec état, mais, comme l'indique Kelsey Hightower dans ses deux tweets, il faut les manipuler avec précaution :
Certains pensent que si l'on déploie Kubernetes sur une charge de travail avec état, cela devient une base de données complètement gérée, capable de rivaliser avec RDS. Ce n'est pas le cas. Peut-être qu'avec suffisamment d'efforts, en ajoutant des composants supplémentaires et en engageant une équipe d'ingénieurs SRE, il serait possible de construire une RDS sur Kubernetes.
Je recommande toujours d'exercer une extrême prudence lors du déploiement de charges de travail avec état sur Kubernetes. La plupart de ceux qui se demandent si « je peux exécuter des charges de travail avec état sur Kubernetes » n'ont pas suffisamment d'expérience avec Kubernetes et souvent pas avec la charge de travail en question.
Alors, faut-il lancer Kafka sur Kubernetes ? Une question inverse est : Kafka fonctionnera-t-il mieux sans Kubernetes ? C'est pourquoi je veux souligner dans cet article comment Kafka et Kubernetes se complètent, et quels pièges peuvent se présenter lors de leur combinaison.
Temps d'exécution
Parlons d'une chose fondamentale : l'environnement d'exécution tel quel.
Processus
Les courtiers Kafka sont pratiques pour travailler avec le CPU. TLS peut introduire certains coûts. Cela dit, les clients Kafka peuvent solliciter davantage le CPU s'ils utilisent le chiffrement, mais cela n'affecte pas les courtiers.
Mémoire
Les courtiers Kafka consomment de la mémoire. La taille de la mémoire heap JVM est généralement limitée à 4-5 Go, mais vous aurez également besoin de beaucoup de mémoire système, car Kafka utilise activement le cache de pages. Dans Kubernetes, définissez correctement les limites des conteneurs sur les ressources et les demandes.
Stockage de données
Le stockage de données dans des conteneurs est éphémère – les données sont perdues lors du redémarrage. Pour les données de Kafka, vous pouvez utiliser un volume, et l'effet sera similaire : les données de votre courtier seront perdues après l'arrêt. Vos messages peuvent quand même être conservés sur d'autres courtiers en tant que répliques. Donc, après le redémarrage, le courtier en panne doit d'abord répliquer toutes les données, et ce processus peut prendre un certain temps. emptyDirC'est pourquoi il est recommandé d'utiliser un stockage de données persistant. Qu'il s'agisse d'un stockage persistant non local avec un système de fichiers XFS ou, plus précisément, ext4. N'utilisez pas NFS. Je vous préviens. NFS versions v3 ou v4 ne fonctionneront pas. En résumé, le courtier Kafka s'arrêtera s'il ne peut pas supprimer le répertoire contenant les données en raison d'un problème de 'renommages stupides', problématique sous NFS. Si je ne vous ai pas encore convaincu, lisez très attentivement
cet article. .
Réseau
Comme pour la plupart des systèmes distribués, la performance de Kafka dépend fortement du fait que les latences réseau soient minimales et la bande passante maximale. N'essayez pas de placer tous les courtiers sur le même nœud, car cela réduira la disponibilité. Si un nœud Kubernetes échoue, l'ensemble du cluster Kafka échouera également. Évitez également de répartir le cluster Kafka sur plusieurs centres de données. Il en va de même pour le cluster Kubernetes. Un bon compromis dans ce cas est de choisir différentes zones de disponibilité.
Configuration
Manifestes standard
Le site de Kubernetes dispose d'un sur la configuration de ZooKeeper à l'aide de manifestes. Étant donné que ZooKeeper fait partie de Kafka, c'est un bon point de départ pour se familiariser avec les concepts de Kubernetes qui s'appliquent ici. Une fois que vous les aurez compris, vous pourrez utiliser les mêmes concepts avec le cluster Kafka.
- Sous: un pod est l'unité déployable minimale dans Kubernetes. Un pod contient votre charge de travail et correspond à un processus dans votre cluster. Un pod peut contenir un ou plusieurs conteneurs. Chaque serveur ZooKeeper dans l'ensemble et chaque courtier dans le cluster Kafka fonctionneront dans un pod distinct.
- StatefulSet: un StatefulSet est un objet Kubernetes qui gère plusieurs charges de travail à état, et ces charges nécessitent de la coordination. Les StatefulSets offrent des garanties concernant le partage d'ordre des pods et leur unicité.
- Services sans tête: les services permettent de découpler les pods des clients à l'aide d'un nom logique. Kubernetes s'occupe alors de l'équilibrage de charge. Cependant, lors des opérations avec des charges de travail à état, comme avec ZooKeeper et Kafka, les clients doivent communiquer avec une instance spécifique. C'est ici que les services sans tête sont utiles : dans ce cas, le client aura toujours un nom logique, mais il ne sera pas nécessaire de s'adresser directement au pod.
- Volume pour le stockage à long terme: de tels volumes sont nécessaires pour la configuration de stockage à long terme de blocs non locaux, comme mentionné ci-dessus.
Sur fournit un ensemble complet de manifestes qui facilitent le démarrage avec Kafka sur Kubernetes.
Diagrammes Helm
Helm est un gestionnaire de paquets pour Kubernetes, comparable aux gestionnaires de paquets pour les systèmes d'exploitation comme yum, apt, Homebrew ou Chocolatey. Il facilite l'installation de paquets logiciels prédéfinis, décrits dans les graphiques Helm. Un graphique Helm bien conçu simplifie une tâche complexe : comment configurer correctement tous les paramètres pour utiliser Kafka sur Kubernetes. Il existe plusieurs graphiques Kafka : le officiel se trouve , il y en a un de , un autre de .
Les opérateurs
Étant donné que Helm présente certains inconvénients, un autre outil connaît un grand succès : les opérateurs Kubernetes. Un opérateur ne se contente pas d'emballer des logiciels pour Kubernetes, mais vous permet également de déployer ces logiciels et de les gérer.
Dans la liste deux opérateurs pour Kafka sont mentionnés. L'un d'eux est . Avec Strimzi, il est facile de mettre en place un cluster Kafka en quelques minutes. Pour la plupart, aucune configuration n'est nécessaire, de plus, l'opérateur offre certaines fonctionnalités intéressantes, comme le chiffrement TLS de type « point à point » à l'intérieur du cluster. Confluent fournit également .
Performance
Il est très important de tester les performances en fournissant à votre instance Kafka installée des points de contrôle. De tels tests peuvent vous aider à identifier d'éventuels goulets d'étranglement avant que les problèmes ne surviennent. Heureusement, Kafka propose déjà deux outils pour tester les performances : kafka-producer-perf-test.sh et kafka-consumer-perf-test.sh. Assurez-vous de les utiliser activement. Pour référence, vous pouvez vous référer aux résultats décrits par Jay Kreps, ou vous orienter vers Amazon MSK par Stéphane Maarek.
Opérations
Surveillance
La transparence dans le système est très importante - sinon, vous ne comprendrez pas ce qui se passe. Aujourd'hui, il existe un solide ensemble d'outils permettant le suivi basé sur des métriques de style cloud-native. Deux outils populaires pour cela sont Prometheus et Grafana. Prometheus peut collecter des métriques de tous les processus Java (Kafka, Zookeeper, Kafka Connect) à l'aide de l'exportateur JMX - de la manière la plus simple. Si vous ajoutez les métriques cAdvisor, vous serez en mesure de disposer d'une image plus complète des ressources utilisées dans Kubernetes.
Strimzi propose un exemple très pratique de tableau de bord Grafana pour Kafka. Il visualise les métriques clés, comme les secteurs non répliqués ou ceux qui sont hors ligne. Tout y est très clair. Ces métriques sont complétées par des informations sur l'utilisation des ressources et la performance, ainsi que des indicateurs de stabilité. Ainsi, vous obtenez une surveillance de base du cluster Kafka sans effort !
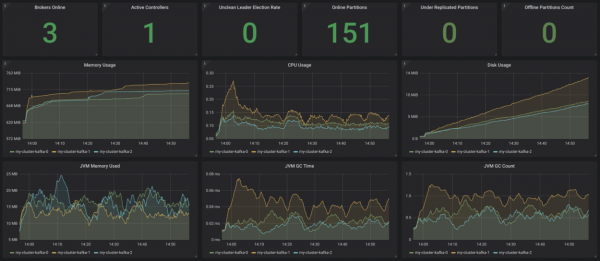
Source :
Il serait judicieux de compléter cela par une surveillance des clients (métriques pour les consommateurs et producteurs), ainsi que par une surveillance de la latence (pour cela, il y a ) et une surveillance complète – pour cela, utilisez .
Journalisation
La journalisation est une autre tâche essentielle. Assurez-vous que tous les conteneurs de votre installation Kafka enregistrent des logs dans stdout et stderr, et veillez à ce que votre cluster Kubernetes agrége tous les logs dans une infrastructure de journalisation centrale, comme .
Vérification de la fonctionnalité
Kubernetes utilise des probes de « vivacité » (liveness) et de disponibilité (readiness) pour vérifier si vos pods fonctionnent correctement. Si la vérification de vivacité échoue, Kubernetes arrêtera ce conteneur, puis le redémarrera automatiquement si la politique de redémarrage est définie en conséquence. Si la vérification de disponibilité échoue, Kubernetes isolera ce pod des requêtes. Ainsi, dans de telles situations, aucune intervention manuelle n'est nécessaire, ce qui est un grand avantage.
Déploiement des mises à jour
Les StatefulSet prennent en charge les mises à jour automatiques : en choisissant la stratégie RollingUpdate, chaque pod Kafka sera mis à jour un par un. Cela permet de réduire la durée des interruptions à zéro.
Mise à l’échelle
La mise à l'échelle d'un cluster Kafka est une tâche complexe. Cependant, dans Kubernetes, il est très simple de mettre à l'échelle des pods à un certain nombre de réplicas, ce qui signifie que vous pouvez définir de manière déclarative autant de brokers Kafka que vous le souhaitez. Le plus difficile dans ce cas est la réaffectation des secteurs après une montée en charge ou avant une réduction de charge. Encore une fois, Kubernetes vous aidera avec cette tâche.
Administration
Les tâches liées à l'administration de votre cluster Kafka, notamment la création de sujets et la réaffectation de partitions, peuvent être effectuées à l'aide des scripts shell disponibles, en ouvrant l'interface de ligne de commande dans vos pods. Cependant, cette solution n'est pas très élégante. Strimzi prend en charge la gestion des sujets via un autre opérateur. Il y a encore des améliorations à apporter.
Sauvegarde et restauration
La disponibilité de Kafka dépendra également de celle de Kubernetes. Si votre cluster Kubernetes tombe, dans le pire des cas, le cluster Kafka tombera aussi. Selon la loi de Murphy, cela se produira inévitablement et vous perdrez des données. Pour réduire le risque, il est essentiel de bien réfléchir à la stratégie de sauvegarde. Vous pouvez utiliser MirrorMaker, une autre option consiste à utiliser S3 comme décrit dans ce de Zalando.
Conclusion
Pour les petits ou moyens clusters Kafka, il est certainement judicieux d'utiliser Kubernetes, car cela offre une flexibilité supplémentaire et simplifie le travail avec les opérateurs. Si vous faites face à des exigences non fonctionnelles très strictes concernant la latence et/ou la bande passante, il serait peut-être préférable d'envisager une autre option de déploiement.
Source : habr.com
