

Les systèmes d'information modernes sont suffisamment complexes. En grande partie, leur complexité provient de la complexité des données qu'ils manipulent. La complexité des données réside souvent dans la diversité des modèles de données utilisés. Par exemple, lorsque les données deviennent « grandes », l'une des caractéristiques qui pose des problèmes n'est pas seulement leur volume, mais aussi leur variété.
Si vous ne trouvez pas encore de faille dans les raisonnements, continuez à lire.
Contenu
Persistance polyglotte
Ce qui a été dit ci-dessus amène à constater qu'il est parfois nécessaire, même au sein d'un même système, d'utiliser plusieurs SGBD différents pour le stockage des données et la résolution de diverses tâches de traitement, chacun supportant son propre modèle de données. Sous l'influence de M. Fowler, une série de livres connus et l'un des du Manifeste Agile, cette situation a été qualifiée de stockage multivarié (« polyglot persistence »).
Fowler donne également l'exemple suivant d'organisation du stockage des données dans une application pleinement fonctionnelle et très chargée dans le domaine du commerce électronique.
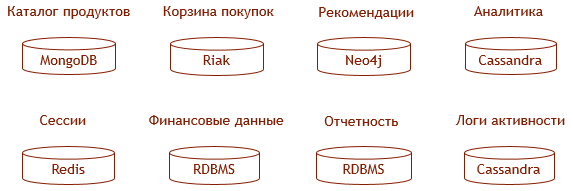
Cet exemple est certes quelque peu exagéré, mais certaines réflexions en faveur du choix d'un SGBD particulier pour un objectif donné peuvent être trouvées, par exemple, .
Il est clair qu'être le gardien d'un tel zoo n'est pas facile.
- Le volume de code effectuant la sauvegarde des données augmente proportionnellement au nombre de SGBD utilisés ; le volume de code synchronisant les données — mieux vaut qu'il ne soit pas proportionnel au carré de ce nombre.
- Les coûts liés à la garantie des caractéristiques enterprise (scalabilité, tolérance aux pannes, haute disponibilité) de chacun des SGBD utilisés augmentent de manière exponentielle.
- Il est impossible d'assurer les caractéristiques enterprise du sous-système de stockage dans son ensemble — en particulier la transactionnalité.
Du point de vue du directeur du zoo, tout se présente ainsi :
- Augmentation exponentielle des coûts des licences et de l'assistance technique auprès du fournisseur de SGBD.
- L'augmentation des effectifs et des délais.
- Pertes financières directes ou sanctions en raison d'un manque de cohérence des données.
Il y a une augmentation significative du coût total de possession du système (TCO). Existe-t-il une solution à la situation de « stockage multivarié » ?
Multimodélisation
Le terme « stockage multivarié » est entré dans le langage courant en 2011. La prise de conscience des problèmes liés à cette approche et la recherche de solutions ont pris plusieurs années, et en 2015, les analystes de Gartner ont formulé la réponse :
- Dans «»:
L'avenir des SGBD, de leurs architectures et de leurs usages — la multimodalité.
- Dans «»:
Les principaux SGBD opérationnels proposeront plusieurs modèles — relationnels et non relationnels — au sein d'une plateforme unique.
Il semble qu'une fois de plus, les analystes de Gartner ne se soient pas trompés dans leurs prévisions. Si vous allez sur la page avec le des SGBD sur DB-Engines, vous pouvez voir que lademajorité de ses leaders se positionnent justement comme des SGBD multimodaux. Cela peut également être observé sur la page de tout classement spécifique.
Le tableau ci-dessous présente les SGBD — leaders dans chaque classement spécifique, déclarant leur multimodalité. Pour chaque SGBD, le modèle initial soutenu (qui était autrefois le seul) est indiqué, accompagné des modèles maintenant supportés. On trouve également des SGBD qui se positionnent comme « initialement multimodaux », n'ayant selon les créateurs aucune ancienne modèle hérité.
| SGBD | Modèle initial | Modèles additionnels |
|---|---|---|
| Oracle | Relationnel | Graphique, document |
| MS SQL | Relationnel | Graphique, document |
| PostgreSQL | Relationnel | Graphique*, document |
| MarkLogic | Document | Graphique, relationnel |
| MongoDB | Document | Clé-valeur, graphique* |
| DataStax | Wide-column | Document, graphique |
| Redis | Clé-valeur | Document, graphique* |
| ArangoDB | — | Graphique, document |
| OrientDB | — | Graphique, document, relationnel |
| Azure CosmosDB | — | Graphique, document, relationnel |
Notes sur le tableau
Les énoncés marqués d'un astérisque dans le tableau nécessitent des réserves :
- Le SGBD PostgreSQL ne prend pas en charge le modèle de données graphique, cependant, un produit , tel qu'AgensGraph, le prend en charge.
- Concernant MongoDB, il est plus correct de parler de la présence d'opérateurs graphiques dans le langage de requête (, ), plutôt que d'une prise en charge du modèle graphique, bien que, bien sûr, leur introduction ait nécessité certaines optimisations au niveau du stockage physique en direction de la prise en charge du modèle graphique.
- En ce qui concerne Redis, il s'agit d'une extension .
Pour chaque classe, nous montrerons comment la prise en charge de plusieurs modèles est mise en œuvre dans les SGBD de cette classe. Nous considérerons principalement les modèles relationnels, documentaires et graphiques, en montrant comment les « manquements » sont mis en œuvre à travers des exemples de SGBD spécifiques.
SGBD multimodèles basés sur un modèle relationnel
Les principaux SGBD aujourd'hui sont relationnels. La prévision de Gartner ne pourrait pas être considérée comme réalisée si les SGBDR ne montraient pas des avancées en direction de la multimodalité. Et ils le font. Les considérations suggérant qu'un SGBD multimodal est comme un couteau suisse, avec lequel il est difficile de faire quelque chose de bien, peuvent immédiatement être adressées à Larry Ellison.
Cependant, l'auteur préfère la mise en œuvre de la multimodalité dans Microsoft SQL Server, à travers laquelle le support des modèles documentaire et graphique sera décrit.
Modèle documentaire dans MS SQL Server
Concernant comment le support du modèle documentaire est réalisé dans MS SQL Server, deux excellents articles ont déjà été publiés sur Habr, je me contenterai d'un bref résumé et commentaire :
La manière de prendre en charge le modèle documentaire dans MS SQL Server est assez typique pour les SGBD relationnels : les documents JSON sont suggérés pour être stockés dans des champs texte normaux. Le soutien du modèle documentaire consiste à fournir des opérateurs spéciaux pour analyser ce JSON :
- pour extraire des valeurs scalaires des attributs,
- pour extraire des sous-documents.
Le deuxième argument des deux opérateurs est une expression dans une syntaxe similaire à JSONPath.
De manière abstraite, on peut dire que les documents ainsi stockés ne sont pas des « entités de première classe » dans le SGBD relationnel, contrairement aux tuples. En particulier, dans MS SQL Server, il n'existe actuellement pas d'index sur les champs des documents JSON, ce qui rend difficiles les opérations de jointure de tables par ces valeurs, et même la sélection de documents par ces valeurs. Néanmoins, il est possible de créer une colonne calculée basée sur un tel champ et un index sur celle-ci.
De plus, MS SQL Server offre la possibilité de construire facilement un document JSON à partir du contenu des tables à l'aide de l'opérateur — une possibilité, d'une certaine manière opposée au stockage ordinaire. Il est clair que quelle que soit la vitesse de la base de données relationnelle, cette approche contredit l'idéologie des bases de données documentaires, qui stockent essentiellement des réponses prêtes à des requêtes populaires, et ne peut résoudre que des problèmes de commodité de développement, mais pas de performance.
Enfin, MS SQL Server permet de résoudre une tâche inverse à la construction de documents : on peut décomposer le JSON en tables grâce à . Si le document n'est pas tout à fait plat, il faudra utiliser CROSS APPLY.
Modèle graphique dans MS SQL Server
Le support du modèle de graphe (LPG) est également réalisé dans Microsoft SQL Server de manière tout à fait : il est proposé d'utiliser des tables spéciales pour stocker les nœuds et pour stocker les arêtes du graphe. Ces tables sont créées en utilisant les expressions CREATE TABLE AS NODE et CREATE TABLE AS EDGE respectivement.
Les tables du premier type ressemblent à des tables ordinaires pour stocker des enregistrements, avec la seule différence externe que la table contient un champ système $node_id — un identifiant unique dans la base de données pour le nœud du graphe.
De même, les tables du second type ont des champs système $from_id et $to_id, les enregistrements dans ces tables définissent clairement les relations entre les nœuds. Pour stocker les relations de chaque type, une table séparée est utilisée.
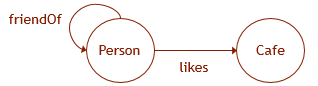 Illustrons cela par un exemple. Supposons que les données graphiques ont un schéma tel que sur l'image ci-jointe. Alors, pour créer la structure correspondante dans la base de données, il faut exécuter les requêtes DDL suivantes :
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
La spécificité principale de telles tables réside dans le fait qu'il est possible d'utiliser des motifs graphiques dans les requêtes avec une syntaxe semblable à Cypher (bien que «*» etc. ne soient pas encore supportés). Sur la base des mesures de performance, on peut également supposer que la manière dont les données sont stockées dans ces tables est différente du mécanisme de stockage dans les tables ordinaires et optimisée pour exécuter de telles requêtes graphiques.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
De plus, il est assez difficile de ne pas utiliser ces motifs graphiques en travaillant avec de telles tables, car dans les requêtes SQL classiques pour résoudre des tâches similaires, il faudrait fournir des efforts supplémentaires pour obtenir les identifiants 'graphiques' des nœuds systèmes ($node_id, $from_id, $to_id; pour cette même raison, les requêtes d'insertion de données ne sont pas présentées ici car jugées trop encombrantes).
En résumé de la description des mises en œuvre des modèles documentaires et graphiques dans MS SQL Server, je soulignerais que de telles implémentations d'un modèle au-dessus d'un autre ne semblent pas réussir avant tout d'un point de vue de conception linguistique. Un langage doit être étendu par un autre, les langages ne sont pas entièrement 'orthogonaux', les règles de combinaison peuvent être assez étranges.
SGBD multimodèles basés sur un modèle documentaire
Dans cette section, je souhaite illustrer la mise en œuvre de la multimodalité dans les SGBD documentaires en prenant l'exemple de l'une des moins populaires d'entre elles, MongoDB (comme mentionné, elle ne dispose que d'opérateurs graphiques conditionnels $lookup et $graphLookup, qui ne fonctionnent pas sur les collections sharded), mais plutôt sur un SGBD plus mature et 'd'entreprise'. .
Ainsi, supposons que la collection contienne un ensemble de documents XML de la forme suivante (MarkLogic permet également de stocker des documents JSON) :
John
  Smith
Modèle relationnel dans MarkLogic
Une représentation relationnelle de la collection de documents peut être créée à l'aide de (le contenu des éléments value dans l'exemple ci-dessous peut être un XPath arbitraire) :
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
On peut adresser une requête SQL à la vue créée (par exemple, via ODBC) :
SELECT name, surname FROM Person WHERE name="John"Malheureusement, la représentation relationnelle créée à l'aide du modèle de mappage est en lecture seule. Lors du traitement d'une requête à celle-ci, MarkLogic tentera d'utiliser . Auparavant, MarkLogic avait aussi des représentations relationnelles limitées, entièrement et accessibles en écriture, mais elles sont désormais considérées comme obsolètes.
Modèle graphique dans MarkLogic
Avec le support du modèle de graphes (RDF), tout se passe à peu près de la même manière. Encore une fois grâce à il est possible de créer une représentation RDF d'une collection de documents de l'exemple ci-dessus :
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Une requête SPARQL peut être adressée au graphe RDF obtenu :
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Contrairement à la modélisation relationnelle, le modèle de graphe dans MarkLogic est pris en charge de deux autres manières :
- La base de données peut être un véritable entrepôt de données RDF standalone (dans ce cas, les triplets seront appelés par opposition à ceux décrits ci-dessus ).
- Le RDF dans un format spécifique peut être simplement inséré dans des documents XML ou JSON (et les triplets seront alors appelés ). Cela constitue probablement une alternative aux mécanismes
idrefetc.
Une bonne compréhension de la façon dont tout cela fonctionne vraiment dans MarkLogic est fournie par , dans ce sens elle est de bas niveau, bien que son objectif soit plutôt inverse : tenter de s'abstraire du modèle de données utilisé, assurer un travail cohérent avec les données dans différents modèles, la transactionnalité, etc.
SGBD multimodèles « sans modèle principal »
Il existe également des bases de données qui se positionnent comme étant initialement multimodèles, sans aucune modèle principal hérité. Parmi elles, on trouve , (depuis 2018, l'entreprise développeuse appartient à SAP) et (un service dans le cadre de la plateforme cloud Microsoft Azure).
En réalité, les modèles principaux dans ArangoDB et OrientDB existent. Dans les deux cas, ce sont des modèles de données propres qui sont des généralisations du modèle documentaire. Les généralisations consistent principalement à faciliter la possibilité d'effectuer des requêtes tant graphiques que relationnelles.
Ces modèles sont les seuls disponibles pour utilisation dans les SGBD mentionnés, et leurs propres langages de requête sont conçus pour travailler avec eux. Il est indéniable que ces modèles et SGBD sont prometteurs, cependant, l'absence de compatibilité avec des modèles et langages standard rend impossible leur utilisation dans des systèmes hérités — leur remplacement des SGBD déjà utilisés est donc compliqué.
Concernant ArangoDB et OrientDB, un excellent article a déjà été publié sur Habr : .
ArangoDB
ArangoDB annonce la prise en charge du modèle de données en graphes.
Les nœuds du graphe dans ArangoDB sont des documents ordinaires, tandis que les arêtes sont des documents d'un type spécial, comportant en plus des champs système ordinaires (_key, _id, _rev) des champs système _from et _to. Les documents dans les SGBD documentaires sont traditionnellement regroupés dans des collections. Les collections de documents représentant des arêtes dans ArangoDB sont appelées collections d'arêtes. À noter que les documents des collections d'arêtes sont également des documents, ce qui permet aux arêtes dans ArangoDB de servir aussi de nœuds.
Données d'origine
Considérons une collection persons, dont les documents se présentent comme suit :
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Supposons également qu'il existe une collection cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Alors la collection likes pourrait ressembler à ceci :
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Requêtes et résultats
Une requête dans le style graphique en utilisant le langage AQL d'ArangoDB, renvoyant de manière lisible pour l'homme des informations sur qui aime quel café, se présente comme suit :
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
Dans un style relationnel, où nous calculons plutôt les relations que nous ne les stockons, cette requête pourrait être réécrite comme suit (à noter qu'il serait possible de se passer de la collection likes ) :
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Le résultat sera le même dans les deux cas :
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
D'autres requêtes et résultats
Si le format de résultat ci-dessus semble plus caractéristique d'une base de données relationnelle que d'une base de données orientée document, vous pouvez essayer cette requête (ou vous pouvez utiliser ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Le résultat ressemblera à ceci :
[
  { "person" : "Alice" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
La mise en œuvre du modèle graphique au-dessus d'une base de données orientée document dans OrientDB repose sur les documents ayant, en plus de valeurs scalaires relativement standard, des valeurs de types tels que LINK, LINKLIST, LINKSET, LINKMAP et LINKBAG. Les valeurs de ces types sont des références ou des collections de références à documents.
L'identifiant attribué par le système à un document a un "sens physique", indiquant la position de l'enregistrement dans la base, et ressemble à ceci : @rid : #3:16. Ainsi, les valeurs des propriétés de lien sont plutôt des pointeurs (comme dans le modèle graphique) et non des conditions de sélection (comme dans le relationnel).
Tout comme dans ArangoDB, dans OrientDB, les arêtes sont représentées par des documents séparés (bien que, s'il n'y a pas de propriétés pour une arête, elle peut être , et il n'y aura pas de document correspondant).
Données d'origine
Dans un format rapproché de de la base OrientDB, les données de l'exemple précédent pour ArangoDB ressembleraient à ceci :
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Personne",
      "name": "Alice",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Personne",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Café",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Café",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Comme nous le voyons, les sommets conservent également des informations sur les arêtes entrantes et sortantes. Lors de la L'API Document pour la cohérence des liens doit être surveillé manuellement, tandis que l'API Graph prend en charge cette tâche. Mais voyons à quoi ressemble une requête à OrientDB dans des langages de requête « bruts », non intégrés aux langages de programmation.
Requêtes et résultats
Une requête équivalente à celle de l'exemple pour ArangoDB ressemble à ceci dans OrientDB :
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Le résultat sera obtenu sous la forme suivante :
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Si le format du résultat semble encore trop « relationnel », il faut supprimer la ligne avec :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Le langage de requête d'OrientDB peut être caractérisé comme SQL avec des insertions similaires à Gremlin. La version 2.2 a introduit une forme de requête semblable à Cypher, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Le format du résultat sera le même que dans la requête précédente. Réfléchissez à ce qu'il faut enlever pour le rendre plus « relationnel », comme dans la toute première requête.
Azure CosmosDB
Ce qui a été dit ci-dessus sur ArangoDB et OrientDB s'applique dans une moindre mesure à Azure CosmosDB. CosmosDB fournit les API d'accès aux données suivantes : SQL, MongoDB, Gremlin et Cassandra.
Les API SQL et MongoDB sont utilisées pour accéder aux données dans un modèle de document. Les API Gremlin et Cassandra — pour accéder aux données dans les modèles graphique et en colonnes respectivement. Les données dans tous les modèles sont stockées au format du modèle interne de CosmosDB : (« atom-record-sequence »), qui est également proche du document.
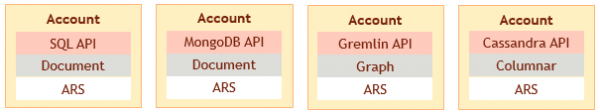
Cependant, le modèle de données choisi par l'utilisateur et l'API utilisée sont fixés au moment de la création du compte dans le service. Il n'est pas possible d'accéder aux données chargées dans un modèle, au format d'un autre modèle, ce qui serait illustré par un schéma semblable à celui-ci :
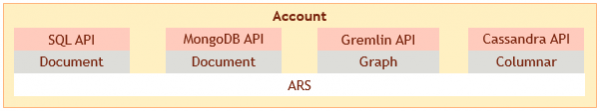
Ainsi, la multimodélité dans Azure CosmosDB représente uniquement la possibilité d'utiliser plusieurs bases de données supportant différents modèles, d'un seul fournisseur, ce qui ne résout pas tous les problèmes de stockage multivariant.
SGBD multimodèles basés sur un modèle graphique ?
Il est à noter qu'il n'existe actuellement sur le marché aucune SGBD multimodèle reposant sur un modèle graphique (si l'on ne considère pas la multimodalité comme la prise en charge simultanée de deux modèles graphiques : RDF et LPG ; voir à ce sujet dans ). Les principales difficultés résident dans la mise en œuvre d'un modèle de document sur un modèle graphique, et non relationnel.
La question de la manière de mettre en œuvre un modèle relationnel sur un modèle graphique a été examinée dès les débuts de ce dernier. Comment , par exemple, :
Il n’y a rien d’inherently dans l’approche graphique qui empêche de créer une couche (par exemple, par un index approprié) sur une base de données graphique qui permet une vue relationnelle avec (1) la récupération de tuples à partir des paires de valeurs clés usuelles et (2) le regroupement de tuples par type de relation.
Lors de la mise en œuvre d'un modèle de document sur un modèle graphique, il faut garder à l'esprit, par exemple, les éléments suivants :
- Les éléments d'un tableau JSON sont considérés comme ordonnés, mais ceux sortant du sommet d'une arête graphique ne le sont pas ;
- Les données dans un modèle de document sont généralement dénormalisées, et il n'est pas souhaitable de stocker plusieurs copies d'un même document imbriqué, tandis que les sous-documents n'ont généralement pas d'identifiants ;
- D'un autre côté, l'idéologie des SGBD documentaires repose sur le fait que les documents sont des « agrégats » prêts à l'emploi, qui n'ont pas besoin d'être reconstruits à chaque fois. Il est nécessaire d'assurer dans le modèle graphique la possibilité d'obtenir rapidement le sous-graphe correspondant à un document prêt.
Un peu de publicité
L'auteur de l'article est impliqué dans le développement du SGBD NitrosBase, dont le modèle interne est graphique, tandis que les modèles externes – relationnel et documentaire – en sont des représentations. Tous les modèles sont égaux : pratiquement toutes les données sont accessibles dans chacun d'eux en utilisant le langage de requête natif. De plus, dans n'importe quelle représentation, les données peuvent être modifiées. Les modifications se refléteront dans le modèle interne et, par conséquent, dans d'autres représentations.
Je décrirai comment se présente la correspondance des modèles dans NitrosBase, j'espère, dans un des prochains articles.
Conclusion
J'espère que les grandes lignes de ce que l'on appelle la multimodalité sont devenues, pour le lecteur, plus ou moins claires. Les SGBD multimodaux sont assez différents, et le "support de plusieurs modèles" peut se présenter de différentes manières. Pour comprendre ce que l'on appelle "multimodalité" dans chaque cas particulier, il est utile de répondre aux questions suivantes :
- S'agit-il d'un support de modèles traditionnels ou d'un modèle « hybride » ?
- Les modèles sont-ils « égaux », ou l'un d'eux est-il subordonné aux autres ?
- Les modèles sont-ils «indifférents» les uns aux autres ? Les données enregistrées dans un modèle peuvent-elles être lues dans un autre ou même réécrites ?
Je pense que nous pouvons désormais répondre positivement à la question de la pertinence des bases de données multimodèles, mais la question reste de savoir quelles variétés seront les plus demandées dans un avenir proche. Il semble que les bases de données multimodèles, soutenant des modèles traditionnels, notamment relationnels, seront les plus recherchées ; tandis que la popularité des bases de données multimodèles offrant de nouveaux modèles alliant les avantages de divers modèles traditionnels est un sujet de futur plus éloigné.
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Utilisez-vous des bases de données multimodèles ?
Nous n'en utilisons pas, nous stockons tout dans une seule base de données et un seul modèle.
Nous utilisons les capacités multimodèles des bases de données traditionnelles.
Nous pratiquons le stockage polyglotte (polyglot persistence).
Nous utilisons de nouvelles bases de données multimodèles (Arango, Orient, CosmosDB).
19 utilisateurs ont voté. 4 utilisateurs se sont abstenus.
Source : habr.com
