

Imaginons. Cinq chats sont enfermés dans une pièce, et pour aller réveiller leur maître, ils doivent tous s'accorder ensemble pour cela, car ils ne peuvent ouvrir la porte qu'en se poussant mutuellement. Si l'un des chats est le chat de Schrödinger, et que les autres ne connaissent pas sa décision, la question se pose : « Comment peuvent-ils faire cela ? »
Dans cet article, je vais vous expliquer en termes simples la composante théorique du monde des systèmes distribués et les principes de leur fonctionnement. Je vais également aborder brièvement l'idée principale qui sous-tend Paxos.
Lorsque les développeurs utilisent des infrastructures cloud, divers systèmes de gestion de bases de données, et qu'ils travaillent dans des clusters avec un grand nombre de nœuds, ils sont convaincus que les données seront intégrales, sécurisées et toujours accessibles. Mais d'où viennent ces garanties ?
En fait, les garanties que nous avons viennent du fournisseur. Elles sont décrites dans la documentation à peu près comme suit : « Ce service est suffisamment fiable, il a un SLA défini, ne vous inquiétez pas, tout fonctionnera de manière distribuée comme vous l'attendez. »
Nous avons tendance à croire au meilleur, car des personnes intelligentes de grandes entreprises nous ont assuré que tout ira bien. Nous ne nous posons pas la question : pourquoi cela peut-il fonctionner ? Existe-t-il une justification formelle pour la validité de ces systèmes ?
Récemment, je suis allé à et j'ai été très inspiré par ce sujet. Les cours dans l'école ressemblaient plus à des séminaires d'analyse mathématique qu'à autre chose lié aux systèmes informatiques. Mais c'est ainsi que, par le passé, les algorithmes les plus importants que nous utilisons chaque jour ont été prouvés, sans même que nous en ayons conscience.
La plupart des systèmes distribués modernes utilisent l'algorithme de consensus Paxos et ses diverses modifications. Le plus étonnant, c'est que la justification et, en principe, la possibilité même d'existence de cet algorithme peuvent être prouvées simplement avec un stylo et du papier. En pratique, cet algorithme est appliqué dans de grands systèmes fonctionnant sur un nombre énorme de nœuds dans le cloud.
Une illustration légère de ce dont nous allons parler ensuite : le problème des deux générauxPour commencer, examinons .
Nous avons deux armées – l'armée rousse et l'armée blanche. Les troupes blanches sont basées dans la ville assiégée. Les troupes rousses, dirigées par les généraux A1 et A2, se situent de chaque côté de la ville. La tâche des rousses est d'attaquer la ville blanche et de vaincre. Cependant, l'armée de chaque général rousse est plus petite que celle des blancs.
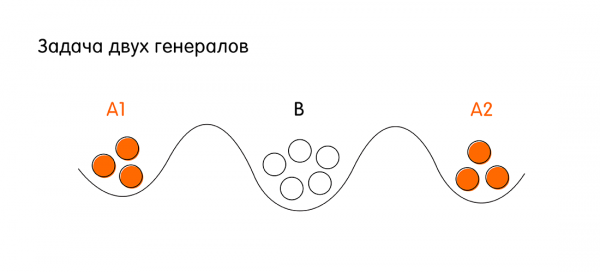
Les conditions de victoire pour les rousses : les deux généraux doivent attaquer en même temps pour avoir un avantage numérique sur les blancs. Pour cela, les généraux A1 et A2 doivent s'accorder entre eux. S'ils attaquent séparément, les rousses perdront.
Pour s'accorder, les généraux A1 et A2 peuvent s'envoyer des messagers à travers le territoire de la ville blanche. Un messager peut atteindre le général allié avec succès ou être intercepté par l'ennemi. La question est : existe-t-il une séquence de communications entre les généraux rousses (séquence d'envoi de messagers d'A1 à A2 et inversement d'A2 à A1), où ils vont s'accorder de manière certaine pour attaquer à l'heure X. Ici, par garanties, on entend que les deux généraux auront une confirmation claire que leur allié (l'autre général) attaquera à l'heure prévue X.
Supposons qu'A1 envoie un messager à A2 avec le message : « Attaquons aujourd'hui à minuit ! ». Le général A1 ne peut pas attaquer sans confirmation du général A2. Si le messager d'A1 est arrivé, alors le général A2 envoie une confirmation avec le message : « Oui, attaquons aujourd'hui les blancs ». Mais maintenant, le général A2 ne sait pas si son messager est arrivé ou non, il n'a pas de garanties que l'attaque sera synchronisée. Maintenant, le général A2 a de nouveau besoin de confirmation.
Si l'on prolonge leur communication, on découvrira que peu importe le nombre de cycles d'échange de messages, il n'est pas possible de garantir que les deux généraux soient informés que leurs messages ont été reçus (à condition que l'un des messagers puisse être intercepté).
La tâche des deux généraux est une excellente illustration d'un système distribué très simple, où il y a deux nœuds avec une communication peu fiable. Cela signifie que nous n'avons aucune garantie à 100 % qu'ils vont se synchroniser. Des problèmes similaires à une échelle plus grande seront abordés plus loin dans l'article.
Introduisons le concept de systèmes distribués.
Un système distribué est un ensemble d'ordinateurs (que nous appellerons nœuds) capables d'échanger des messages. Chaque nœud est une entité autonome. Un nœud peut traiter des tâches de manière indépendante, mais pour interagir avec d'autres nœuds, il doit envoyer et recevoir des messages.
La façon dont les messages sont précisément mis en œuvre, quels protocoles sont utilisés, ne nous intéresse pas dans ce contexte. Ce qui importe, c'est que les nœuds d'un système distribué peuvent échanger des données entre eux par l'envoi de messages.
La définition elle-même semble assez simple, mais il est important de noter qu'un système distribué possède plusieurs attributs qui seront cruciaux pour nous.
Attributs des systèmes distribués
- Concurrence – la possibilité d'événements simultanés ou concurrents dans le système. De plus, nous considérerons que les événements qui se produisent sur deux nœuds différents sont potentiellement concurrents tant que nous n'avons pas d'ordre clair d'apparition de ces événements. Et, en règle générale, nous n'en avons pas.
- Absence d'horloges globales. Nous n'avons pas d'ordre clair d'événements en raison de l'absence d'horloges globales. Dans le monde ordinaire des humains, nous sommes habitués à avoir des horloges et un temps absolu. Tout change quand il s'agit de systèmes distribués. Même les horloges atomiques ultraprecises ont un dérive, et il est possible que nous ne puissions pas dire quel événement parmi deux s'est produit en premier. Donc, nous ne pouvons pas non plus compter sur le temps.
- Défaillance indépendante des nœuds du système. Il y a aussi un autre problème : quelque chose peut mal tourner simplement parce que nos nœuds ne sont pas éternels. Un disque dur peut tomber en panne, une machine virtuelle dans le cloud peut redémarrer, le réseau peut vaciller et des messages peuvent être perdus. De plus, il est possible que les nœuds fonctionnent mais agissent contre le système. Cette dernière classe de problèmes a même reçu un nom distinct : le problème . L'exemple le plus populaire de système distribué avec ce type de problème est la Blockchain. Mais aujourd'hui, nous n'allons pas examiner cette classe particulière de problèmes. Nous nous intéresserons aux situations où un ou plusieurs nœuds peuvent simplement tomber en panne.
- Modèles de communication (modèles d'échange de messages) entre les nœuds. Nous avons déjà déterminé que les nœuds communiquent par échange de messages. Il existe deux modèles de communication par messages : synchrone et asynchrone.
Modèles de communication entre nœuds dans les systèmes distribués
Modèle synchrone – nous savons exactement qu'il existe un delta de temps connu au-delà duquel un message est garanti de parvenir d'un nœud à un autre. Si ce temps est écoulé et que le message n'est pas arrivé, nous pouvons affirmer avec certitude que le nœud est en panne. Dans ce modèle, nous avons un temps d'attente prédictible.
Modèle asynchrone – dans les modèles asynchrones, nous considérons que le temps d'attente est fini, mais il n'existe pas de delta de temps après lequel nous pouvons garantir qu'un nœud est en panne. C'est-à-dire que le temps d'attente d'un message d'un nœud peut être indéfini. C'est une définition importante, et nous en discuterons plus tard.
La notion de consensus dans les systèmes distribués
Avant de définir formellement la notion de consensus, considérons un exemple de situation où il est nécessaire, à savoir – Réplication de machine d'état.
Nous avons un certain journal distribué. Nous souhaitons qu'il soit cohérent et contienne des données identiques sur tous les nœuds du système distribué. Lorsqu'un des nœuds apprend une nouvelle valeur qu'il s'apprête à enregistrer dans le journal, sa tâche est de proposer cette valeur à tous les autres nœuds afin que le journal soit mis à jour sur tous les nœuds et que le système passe à un nouvel état cohérent. Dans ce cas, il est important que les nœuds s'accordent entre eux : tous les nœuds conviennent que la nouvelle valeur proposée est correcte, tous les nœuds acceptent cette valeur, et seulement dans ce cas, tous peuvent enregistrer la nouvelle valeur dans le journal.
En d'autres termes : aucun des nœuds n'a contesté le fait qu'il dispose d'informations plus récentes, et que la valeur proposée est incorrecte. L'accord entre les nœuds et le consensus sur une valeur acceptée et correcte constitue le consensus dans un système distribué. Nous allons ensuite parler des algorithmes qui permettent à un système distribué d'atteindre le consensus de manière garantie.
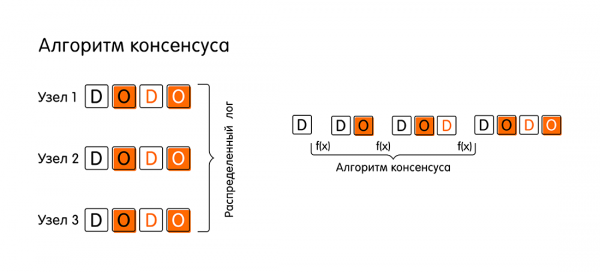
Plus formellement, nous pouvons définir l'algorithme d'atteinte du consensus (ou tout simplement l'algorithme de consensus) comme une fonction qui transforme un système distribué d'un état A à un état B. Cet état doit être accepté par tous les nœuds, et tous les nœuds doivent pouvoir le confirmer. Il s'avère que cette tâche n'est pas aussi triviale qu'elle en a l'air au premier abord.
Propriétés de l'algorithme de consensus
L'algorithme de consensus doit posséder trois propriétés pour que le système continue d'exister et progresse dans la transition d'un état à un autre :
- Accord – tous les nœuds fonctionnels doivent accepter la même valeur (dans les articles, cette propriété est également connue sous le nom de propriété de sécurité). Tous les nœuds qui fonctionnent actuellement (qui ne sont pas en panne et qui n'ont pas perdu le contact avec les autres) doivent parvenir à un accord et accepter une certaine valeur finale commune.
Il est important de comprendre que les nœuds dans le système distribué que nous examinons souhaitent parvenir à un accord. C'est-à-dire que nous parlons ici de systèmes où quelque chose peut simplement échouer (par exemple, un nœud peut échouer), mais dans ce système, il n'y a certainement pas de nœuds qui travaillent intentionnellement contre les autres (la tâche des généraux byzantins). Grâce à cette propriété, le système reste cohérent.
- Intégrité – si tous les nœuds fonctionnels proposent la même valeur, valors chaque nœud fonctionnel doit accepter cette valeur. v.
- Résolution – tous les nœuds fonctionnels doivent finalement accepter une certaine valeur (propriété de vivacité), ce qui permet à l’algorithme d'avoir un progrès dans le système. Chaque nœud fonctionnel individuel doit tôt ou tard accepter la valeur finale et le confirmer : « Pour moi, cette valeur est vraie, j'accorde avec l'ensemble du système ».
Exemple de fonctionnement de l'algorithme de consensus
Bien que les propriétés de l'algorithme puissent ne pas être complètement claires, illustrons par un exemple les étapes par lesquelles passe le plus simple algorithme de consensus dans un système avec un modèle de communication synchrone, où tous les nœuds fonctionnent comme prévu, les messages ne sont pas perdus et rien ne se casse (est-ce vraiment possible ?).
- Tout commence par une demande de main et de cœur (Propose). Supposons qu'un client se connecte au nœud appelé « Nœud 1 » et commence une transaction en transmettant une nouvelle valeur au nœud – O. À partir de ce moment, nous appellerons « Nœud 1 » proposer. En tant que proposer, « Nœud 1 » doit maintenant informer tout le système qu'il a de nouvelles données et il envoie à tous les autres nœuds des messages : « Regardez ! J'ai reçu la valeur « O », et je veux l'écrire ! Je demande à ce que vous confirmiez que vous écrirez aussi « O » dans votre journal ».

- La prochaine étape est le vote pour la valeur proposée (Voting). À quoi cela sert-il ? Il se peut que d'autres nœuds aient reçu des informations plus récentes et qu'ils disposent de données concernant cette même transaction.
Lorsque le nœud « Nœud 1 » envoie sa proposition, les autres nœuds vérifient dans leurs journaux les données concernant cet événement. S'il n'y a pas de contradictions, les nœuds déclarent : « Oui, je n'ai pas d'autres données concernant cet événement. La valeur « O » est l'information la plus récente que nous avons ».Dans tous les autres cas, les nœuds peuvent répondre à « Nœud 1 » : « Écoute ! J'ai des informations plus récentes sur cette transaction. Ce n'est pas « O », mais quelque chose de mieux ».
À l'étape de vote, les nœuds arrivent à une décision : soit tous acceptent une seule valeur, soit l'un d'entre eux vote contre, indiquant qu'il a des données plus récentes.
- Si le tour de vote se passe bien et que tout le monde est « pour », alors le système passe à une nouvelle étape – l'acceptation de la valeur (Accept). « Nœud 1 » collecte toutes les réponses des autres nœuds et annonce : « Tout le monde a accepté la valeur « O » ! Maintenant, je déclare officiellement que « O » est notre nouvelle valeur, unique pour tous ! Écrivez-la dans votre petit livre, n'oubliez pas. Notez-la dans votre journal ! »
- Les autres nœuds envoient leur confirmation (Accepted), affirmant qu'ils ont noté la valeur « O », rien de nouveau n'étant arrivé entre-temps (une sorte de commit en deux phases). Après cet événement significatif, nous considérons que la transaction distribuée a été complétée.
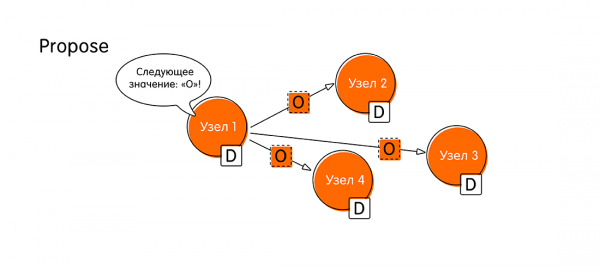
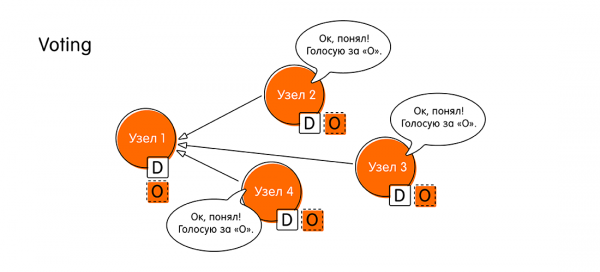
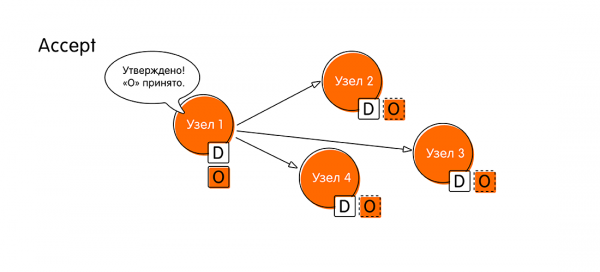
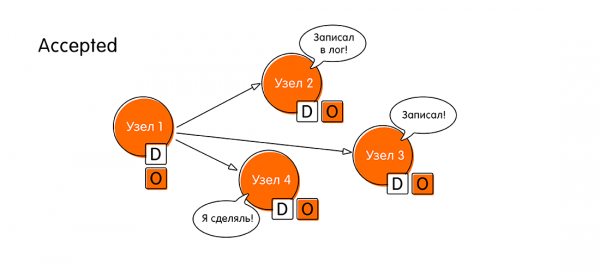
Ainsi, l'algorithme de consensus dans le cas simple se compose de quatre étapes : proposer, voter (voting), accepter (accept), confirmation d'acceptation (accepted).
Si à une étape nous n'avons pas pu parvenir à un consensus, l'algorithme redémarre, en tenant compte des informations fournies par les nœuds ayant refusé de confirmer la valeur proposée.
L'algorithme de consensus dans un système asynchrone
Tout allait bien jusqu'à présent, car nous parlions d'un modèle de communication synchrone. Mais nous savons tous que dans le monde moderne, nous avons pris l'habitude de fonctionner de manière asynchrone. Comment un algorithme similaire fonctionne-t-il dans un système avec un modèle de communication asynchrone, où l'on considère que le temps d'attente pour une réponse d'un nœud peut être indéfini (d'ailleurs, une défaillance d'un nœud peut aussi être considérée comme un exemple où un nœud peut répondre indéfiniment).
Maintenant que nous savons comment l'algorithme de consensus fonctionne en principe, une question pour les lecteurs curieux qui sont arrivés à ce point : combien de nœuds dans un système de N nœuds avec un modèle de messages asynchrone peuvent tomber en panne pour que le système puisse toujours atteindre un consensus ?
La bonne réponse et l'explication se trouvent sous le spoiler.Bonne réponse : 0. Si au moins un nœud dans un système asynchrone tombe en panne, le système ne pourra pas atteindre le consensus. Cette affirmation est prouvée dans le célèbre théorème FLP (1985, Fischer, Lynch, Paterson, lien vers l'original à la fin de l'article) : « L'impossibilité d'atteindre un consensus distribué en cas de panne d'au moins un nœud ».
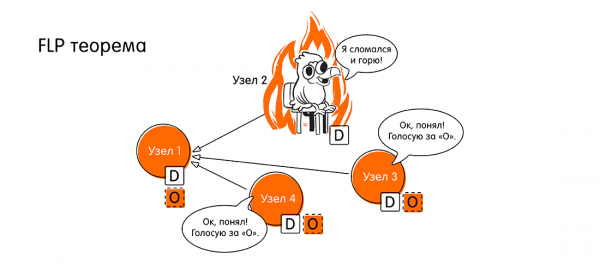
Les amis, alors nous avons un problème, nous avons l'habitude que tout soit asynchrone. Et là, c'est compliqué. Comment avancer ?
Nous venons de parler de théorie, de mathématiques. Que signifie « le consensus ne peut pas être atteint », en traduisant du langage mathématique au nôtre – technique ? Cela signifie que « le consensus ne peut pas toujours être atteint », c'est-à-dire qu'il existe un cas où le consensus est inatteignable. Quel est donc ce cas ?
C'est justement la violation de la propriété de vivacité, décrite ci-dessus. Nous n'avons pas de consensus commun, et le système ne peut pas progresser (ne peut pas se terminer dans un temps fini) s'il n'y a pas de réponse de tous les nœuds. Car dans un système asynchrone, nous n'avons pas de temps de réponse prévisible, et nous ne pouvons pas savoir si un nœud est tombé en panne ou simplement répond lentement.
Mais en pratique, nous pouvons trouver une solution. Supposons que notre algorithme puisse fonctionner longtemps en cas de pannes (peut potentiellement fonctionner indéfiniment). Mais dans la plupart des situations, lorsque la plupart des nœuds fonctionnent correctement, nous aurons du progrès dans le système.
Dans la pratique, nous traitons des modèles de communication partiellement synchrones. La partialité de la synchronisation est comprise ainsi : en général, nous avons un modèle asynchrone, mais un concept formel de « temps de stabilisation global » est introduit à un certain moment.
Ce moment peut ne pas arriver pendant une période indéfinie, mais un jour, il doit se réaliser. Une alarme virtuelle sonnera, et à partir de ce moment, nous pouvons prédire le délai pendant lequel les messages arriveront. À partir de ce point, le système passe d'asynchrone à synchrone. Dans la pratique, nous avons affaire à de tels systèmes.
L'algorithme Paxos résout les problèmes de consensus
– c'est une famille d'algorithmes qui résout le problème de consensus pour des systèmes partiellement synchrones, à condition que certains nœuds puissent échouer. L'auteur de Paxos est . Il a proposé une preuve formelle de l'existence et de la validité de l'algorithme en 1989.
Mais la preuve s'est avérée tout sauf triviale. La première publication a été publiée seulement en 1998 (33 pages) avec une description de l'algorithme. Comme il s'est avéré, elle était extrêmement difficile à comprendre, et en 2001, un document explicatif a été publié, qui a occupé 14 pages. Les volumes des publications sont mentionnés pour montrer que le problème du consensus n'est pas simple, et qu'un travail énorme de certaines des plus brillantes personnes est nécessaire pour de tels algorithmes.
Il est intéressant de noter que Leslie Lamport lui-même a remarqué dans sa conférence que dans le second article explicatif, il y a une affirmation, une ligne (sans préciser laquelle), qui peut être interprétée de différentes manières. En raison de cela, de nombreuses mises en œuvre modernes de Paxos ne fonctionnent pas tout à fait correctement.
Une analyse détaillée du fonctionnement de Paxos nécessiterait plusieurs articles, donc je vais essayer de transmettre très brièvement l'idée principale de l'algorithme. Dans les liens à la fin de mon article, vous trouverez des matériaux pour approfondir ce sujet.
Rôles dans Paxos
Dans l'algorithme Paxos, il existe un concept de rôles. Considérons trois principaux (il existe des modifications avec des rôles supplémentaires) :
- Proposers (d'autres termes peuvent également être rencontrés : leaders ou coordinateurs). Ce sont des gars qui apprennent une nouvelle valeur d'un utilisateur et prennent le rôle de leader. Leur tâche est de lancer un round de proposition d'une nouvelle valeur et de coordonner les actions ultérieures des nœuds. De plus, Paxos permet la présence de plusieurs leaders dans certaines situations.
- Accepteurs (Voteurs). Ce sont des nœuds qui votent pour l'acceptation ou le rejet d'une certaine valeur. Leur rôle est très important, car c'est d'eux que dépend la décision : dans quel état le système va basculer (ou ne pas basculer) après chaque étape de l'algorithme de consensus.
- Apprenants. Ce sont des nœuds qui acceptent simplement et enregistrent la nouvelle valeur acceptée lorsque l'état du système change. Ils ne prennent pas de décisions, ils reçoivent simplement des données et peuvent les transmettre à l'utilisateur final.
Un nœud peut combiner plusieurs rôles dans différentes situations.
La notion de quorum
Nous supposons que nous avons un système de N nœuds. Et parmi eux, au maximum F nœuds peuvent tomber en panne. Si F nœuds tombent en panne, alors nous devons avoir dans le cluster, au minimum, 2F + 1 nœuds accepteurs.
C'est nécessaire pour que, même dans la pire situation, les nœuds «bons», fonctionnant correctement, aient la majorité. Autrement dit, F + 1 nœuds «bons» qui se sont accordés, et la valeur finale sera acceptée. Sinon, il pourrait y avoir une situation où différents groupes locaux acceptent des valeurs différentes et ne peuvent pas se mettre d'accord. C'est pourquoi nous avons besoin d'une majorité absolue pour gagner le vote.
L'idée générale du fonctionnement de l'algorithme de consensus Paxos
L'algorithme Paxos se compose de deux grandes phases, qui sont à leur tour divisées en deux étapes chacune :
- Phase 1a : Préparer. Au stade de préparation, le leader (proposeur) informe tous les nœuds : « Nous commençons une nouvelle phase de vote. Nous avons un nouveau tour. Le numéro de ce tour est n. Nous allons maintenant commencer à voter ». Pour l'instant, il se contentera d'annoncer le début d'un nouveau cycle sans communiquer de nouvelle valeur. L'objectif de cette phase est d'initier un nouveau tour et de communiquer à tous son numéro unique. Le numéro du tour est important, il doit être supérieur à tous les numéros de votes précédents de tous les anciens leaders. C'est grâce à ce numéro que les autres nœuds du système comprendront combien de données récentes le leader possède. Il est probable que d'autres nœuds ont déjà des résultats de votes de tours beaucoup plus récents et ils informeront simplement le leader qu'il est à la traîne.
- Phase 1b : Promesse. Lorsque les nœuds-acceptants reçoivent le numéro de la nouvelle phase du vote, deux résultats sont possibles :
- Le numéro n du nouveau vote est supérieur à celui de n'importe quel des votes précédents auxquels l'acceptant a participé. Dans ce cas, l'acceptant envoie au leader une promesse de ne participer à aucun vote avec un numéro inférieur à n. Si l'acceptant a déjà voté pour quelque chose (c'est-à-dire qu'il a déjà accepté une valeur dans la deuxième phase), il joint à sa promesse la valeur acceptée et le numéro du vote auquel il a participé.
- En revanche, si l'acceptant connaît déjà un vote avec un numéro supérieur, il peut simplement ignorer la phase de préparation et ne pas répondre au leader.
- Phase 2a : Acceptation. Le leader doit attendre une réponse d'un quorum (la majorité des nœuds dans le système) et, si le nombre requis de réponses est obtenu, il a deux options :
- Certains des acceptants ont envoyé des valeurs pour lesquelles ils ont déjà voté. Dans ce cas, le leader choisit la valeur du vote avec le numéro le plus élevé. Appelons cette valeur x, et il envoie à tous les nœuds un message du type : « Accept (n, x) », où la première valeur est le numéro du vote de sa propre étape Propose, et la seconde valeur est celle pour laquelle tout le monde s'était réuni, c'est-à-dire la valeur pour laquelle nous votons en réalité.
- Si aucun des acceptateurs n'a envoyé de valeurs, mais simplement promis de voter lors de ce tour, le leader peut leur proposer de voter pour sa propre valeur, celle pour laquelle il est devenu leader. Appelons cette valeur y. Il envoie à tous les nœuds un message du type : « Accept (n, y) », par analogie avec le résultat précédent.
- Phase 2b : Accepté. Ensuite, les nœuds-accepteurs, lorsqu'ils reçoivent le message « Accept(...) » du leader, s'accordent avec lui (en envoyant à tous les nœuds une confirmation qu'ils acceptent la nouvelle valeur) uniquement s'ils n'ont pas promis à un autre leader de participer à des votes du tour numéro n’ > n, sinon ils ignorent la demande de confirmation.
Si la majorité des nœuds a répondu au leader et que tous ont confirmé la nouvelle valeur, alors la nouvelle valeur est considérée comme acceptée. Hourra ! En revanche, si la majorité n'est pas atteinte ou s'il y a des nœuds qui ont refusé d'accepter la nouvelle valeur, tout recommence.
C'est ainsi que fonctionne l'algorithme Paxos. Chacune de ces étapes a de nombreuses subtilités, nous n'avons pratiquement pas abordé les différents types de défaillances, les problèmes de multiples leaders et bien d'autres, mais l'objectif de cet article est simplement d'introduire le lecteur au monde de l'informatique distribuée à un niveau élevé.
Il convient également de noter que Paxos n'est pas le seul de son genre, il existe d'autres algorithmes, par exemple, , mais c'est un sujet pour un autre article.
Liens vers des documents pour un approfondissement ultérieur
Niveau « débutant » :
- , Preethi Kasireddy, article de blog sur Medium
- , Adi Kancherla, article de blog sur Medium
- , Ittai Abraham, blog
- , Ittai Abraham, article de blog
Niveau « Leslie Lamport » :
- , Fischer, Lynch et Paterson, article de recherche, 1985
- , Leslie Lamport, article de recherche, 1998
- , Leslie Lamport, article de recherche, 2001
Source : habr.com
