

Note de traduction.: L'auteur de cet article est Cindy Sridharan, ingénieur chez imgix, spécialisée dans le développement d'API et, en particulier, dans le test de microservices. Dans cet article, elle partage sa vision approfondie des défis actuels dans le domaine de la traçabilité distribuée, où elle estime qu'il y a un manque d'outils vraiment efficaces pour résoudre les problèmes urgents.
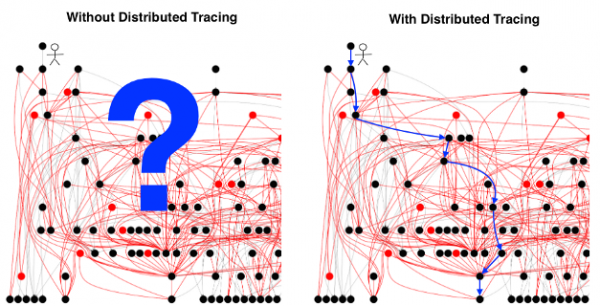
[L'illustration est empruntée à sur la traçabilité distribuée.]
On considère que est difficile à mettre en œuvre et que son retour sur investissement . La problématique de la traçabilité est expliquée par de nombreuses raisons, souvent en se référant à la complexité de la configuration de chaque composant du système pour transmettre les en-têtes appropriés avec chaque requête. Bien que ce problème soit réel, il ne peut en aucun cas être considéré comme insurmontable. D'ailleurs, cela n'explique pas pourquoi les développeurs n'apprécient pas vraiment la traçabilité (même lorsqu'elle est déjà fonctionnelle).
La principale difficulté de la traçabilité distribuée n'est pas la collecte de données, ni la standardisation des formats de distribution et de présentation des résultats, ni le fait de déterminer quand, où et comment effectuer des échantillonnages. Je ne suis en aucun cas en train de présenter comme triviales ces « problèmes d'appropriation » - en réalité, il existe des défis techniques significatifs et (si nous considérons vraiment les normes et protocoles open source) Cependant, en supposant que tous ces problèmes soient résolus, il y a de fortes chances que rien ne change vraiment du point de vue
de l'expérience utilisateur . La traçabilité peut encore ne pas apporter d'avantages pratiques dans les scénarios de débogage les plus courants - même après qu'elle ait été déployée.Cette traçabilité peu courante
La traçabilité distribuée comprend plusieurs composants disparates :
l'équipement des applications et du middleware avec des moyens de contrôle;
- la transmission de contexte distribué;
- la collecte des traces;
- le stockage des traces;
- leur extraction et visualisation.
- leur extraction et leur visualisation.
De nombreuses discussions sur la traçabilité distribuée se résument à la voir comme une opération unitaire dont le seul but est d'aider à un diagnostic complet du système. Cela est en grande partie lié à la façon dont les idées sur la traçabilité distribuée se sont historiquement formées. Dans , lors de l'ouverture du code source de Zipkin, il a été mentionné que il [Zipkin] rend Twitter plus rapide. Les premières offres commerciales pour la traçabilité étaient également promues comme .
Note de traduction.: Pour que le texte suivant soit mieux compris, définissons deux termes de base selon :
- Span — l'élément de base de la traçabilité distribuée. Il représente la description d'un certain flux de travail (par exemple, une requête à la base de données) avec un nom, un temps de début et de fin, des étiquettes, des logs et un contexte.
- Les spans contiennent généralement des références à d'autres spans, ce qui permet de regrouper de nombreux spans dans Trace — une visualisation de la vie d'une requête au fur et à mesure de son déplacement dans un système distribué.
Les traces contiennent des données incroyablement précieuses qui peuvent aider dans des tâches telles que : tester en production, effectuer des tests de reprise après sinistre, tester avec des erreurs introduites, etc. En fait, certaines entreprises utilisent déjà la traçabilité à de telles fins. Commençons par le fait que a d'autres applications en plus du simple transfert des spans vers un système de stockage :
- Par exemple, Uber les résultats de traçabilité pour distinguer le trafic de test et le trafic de production.
- Facebook les données des traces pour analyser le chemin critique et pour commuter le trafic lors des tests réguliers de reprise après sinistre.
- Aussi, le réseau social les notebooks Jupyter, permettant aux développeurs d'effectuer des requêtes arbitraires sur les résultats de traçabilité.
- Les partisans de ( Lineage Driven Failure Injection ) des traces distribuées pour le test avec injection d'erreurs.
Aucune des options mentionnées ci-dessus ne relève entièrement du scénario de débogage, au cours duquel un ingénieur essaie de résoudre un problème en regardant la trace.
Quand il s'agit de scénario de débogage, l'interface principale reste le diagramme traceview (bien que certains l'appellent aussi « diagramme de Gantt » ou « diagramme en cascade »). Par traceview je tous les spans et les métadonnées associées qui composent ensemble une trace. Chaque système de traçage open source, ainsi que chaque solution commerciale de traçage, offre une approche basée sur traceview une interface utilisateur pour la visualisation, la détaillation et le filtrage des traces.
Le problème avec tous les systèmes de traçage auxquels j'ai eu accès jusqu'à présent est que la visualisation finale traceview reflète pratiquement entièrement les caractéristiques du processus de génération de la trace. Même lorsque des visualisations alternatives sont proposées : cartes d'intensité (heatmap), topologies de services, histogrammes de latence, — in fine, elles se réduisent toutes à traceview.
Dans le passé, j'ai que la plupart des « innovations » dans le domaine du traçage en ce qui concerne l'UI/UX semblent se limiter à de métadonnées supplémentaires dans la trace, en y intégrant des informations à haute cardinalité (high-cardinality) ou en fournissant la possibilité de détailler des spans spécifiques ou d'effectuer des requêtes entre et intra-traces. Par ailleurs traceview reste le principal moyen de visualisation. Tant que cette situation persistera, le traçage distribué sera (au mieux) au quatrième rang en tant qu'outil de débogage, derrière les métriques, les logs et les stack traces, et au pire, il se révélera être une perte de temps et d'argent.
Le problème avec traceview
L'objectif traceview est de fournir une image complète du parcours d'une requête individuelle à travers tous les composants du système distribué auxquels elle est liée. Certains systèmes de traçage plus avancés permettent de détailler des spans individuels et de visualiser la répartition temporelle à l'intérieur d'un processus (lorsque les spans ont des limites fonctionnelles).
La base de l'architecture des microservices repose sur l'idée que la structure organisationnelle évolue avec les besoins de l'entreprise. Les partisans des microservices soutiennent que la répartition des différentes tâches commerciales entre des services distincts permet à de petites équipes de développeurs autonomes de contrôler l'ensemble du cycle de vie de ces services, leur donnant la possibilité de créer, tester et déployer ces services de manière indépendante. Cependant, un inconvénient de cette répartition est la perte d'informations sur la manière dont chaque service interagit avec les autres. Dans ce contexte, le suivi distribué se positionne comme un outil indispensable pour de débogage les interactions complexes entre les services.
Si vous avez vraiment , alors aucune personne ne peut garder à l'esprit son image complète. En réalité, développer un outil en partant du principe que cela est même possible est quelque peu un anti-modèle (une approche inefficace et peu productive). Idéalement, pour le débogage, un outil est nécessaire pour rétrécir la zone de recherche , afin que les ingénieurs puissent se concentrer sur un sous-ensemble de mesures (services/utilisateurs/hôtes, etc.) pertinentes pour le scénario de problème examiné. Lors de l'analyse de la cause d'un échec, les ingénieurs ne sont pas tenus de comprendre ce qui se passait danstous les services en même temps , puisque cette exigence contredirait même l'idée de l'architecture microservices.Cependant, traceview représente
justement cela. Oui, certains systèmes de suivi proposent des traceviews compressées lorsque le nombre de spans dans le trace est si élevé qu'il est impossible de les afficher dans une seule visualisation. Cependant, en raison de la grande quantité d'informations contenues même dans une telle visualisation réduite, les ingénieurs sont pourtant contraints de 'filtrer' manuellement afin de restreindre l'échantillon à un ensemble de services sources des problèmes. Hélas, sur ce terrain, les machines sont nettement plus rapides que les humains, moins sujettes aux erreurs, et leurs résultats sont plus répétables. Une autre raison pour laquelle je considère que la méthode traceview est incorrecte est qu'elle est mal adaptée au débogage basé sur des hypothèses. Fondamentalement, le débogage est
Une autre raison pour laquelle je considère que la méthode traceview est incorrecte est qu'elle est mal adaptée au débogage basé sur des hypothèses. Au fond, le débogage est itératif un processus qui commence par une hypothèse, suivi de la vérification de diverses observations et faits obtenus du système selon différents vecteurs, des conclusions/synthèses et une évaluation ultérieure de la véracité de l'hypothèse.
Possibilité rapidement et à faible coût tester des hypothèses et améliorer en conséquence le modèle mental est la pierre angulaire du débogage. Tout outil de débogage doit être interactif et réduire l'espace de recherche ou, en cas de fausse piste, permettre à l'utilisateur de revenir en arrière et de se concentrer sur une autre zone du système. L'outil idéal ferait cela de manière proactive, attirant immédiatement l'attention de l'utilisateur sur des zones potentiellement problématiques.
Hélas, traceview on ne peut pas parler d'un outil avec une interface interactive. Le mieux qu'on puisse espérer en l'utilisant est de détecter une certaine source de latences accrues et d'examiner toutes sortes de balises et de logs associés. Cela n'aide pas l'ingénieur à identifier des tendances dans le trafic, comme la spécificité de la distribution des latences, ou à identifier des corrélations entre différentes mesures. peut aider à contourner certains de ces problèmes. En effet, d'analyses réussies utilisant l'apprentissage automatique pour détecter des intervalles anormaux et identifier un sous-ensemble de balises qui pourraient être liées à un comportement anormal. Cependant, je n'ai pas encore rencontré de visualisations convaincantes des résultats obtenus grâce à l'apprentissage automatique ou à l'analyse des données appliquées aux intervalles, qui se distingueraient significativement de traceview ou DAG (graphe acyclique orienté).
Les intervalles sont trop basiques
Le problème fondamental avec traceview est que les intervalles sont des primitives trop basiques tant pour l'analyse des latences que pour l'analyse des causes profondes. C'est comme analyser des instructions individuelles du processeur dans une tentative de résoudre une exception, sachant qu'il existe des outils de niveau supérieur comme backtrace, avec lesquels il est bien plus facile de travailler.
De plus, je me permets d'affirmer ceci : en idéalisant, nous n'avons pas besoin d'avoir une vue d'ensemble complète survenu au cours du cycle de vie de la requête, que représentent les outils modernes pour le traçage. Au lieu de cela, une forme d'abstraction de niveau supérieur est requise, contenant des informations sur ce que s'est mal passé (par analogie avec le backtrace), avec un certain contexte. Au lieu d'observer tout le trace, je préfère voir sa partie, où quelque chose d'intéressant ou d'inhabituel se produit. Actuellement, la recherche s'effectue manuellement : l'ingénieur reçoit le trace et analyse lui-même les spans à la recherche de quelque chose d'intéressant. L'approche consistant à ce que les gens scrutent les spans dans des traces individuelles dans l'espoir de détecter une activité suspecte n'est absolument pas évolutive (surtout lorsqu'ils doivent réfléchir à toutes les métadonnées codées dans divers spans, telles que l'ID du span, le nom de la méthode RPC, la durée du span, les logs, les tags, etc.).
Alternatives à traceview
Les résultats de traçage sont les plus utiles lorsqu'ils peuvent être visualisés de manière à fournir une représentation non triviale de ce qui se passe dans les parties interconnectées du système. Tant que cela n'existe pas, le processus de débogage reste en grande partie inerte et dépend de la capacité de l'utilisateur à noter les bonnes corrélations, à vérifier les bonnes parties du système ou à assembler les morceaux du puzzle ensemble — contrairement à l'outil, aidant l'utilisateur à formuler ces hypothèses.
Je ne suis pas designer visuel et je ne suis pas expert en UX, mais dans la section suivante, je souhaite partager quelques idées sur à quoi pourraient ressembler de telles visualisations.
Focus sur des services spécifiques
Dans un contexte où l'industrie se consolide autour des idées , il semble raisonnable que des équipes distinctes doivent avant tout veiller à ce que leurs services respectent ces objectifs. Il en découle que une visualisation axée sur le service convient le mieux à ces équipes.
Les traces, surtout sans échantillonnage, sont une mine d'informations sur chaque composant d'un système distribué. Ces informations peuvent être nourries à un traitement astucieux, qui fournira aux utilisateurs des découvertes orientées sur le service. Elles peuvent être détectées à l'avance — avant même que l'utilisateur ne consulte les traces :
- Diagrammes de répartition des latences uniquement pour les requêtes aberrantes (requêtes aberrantes);
- Diagrammes de répartition des latences pour les cas où les objectifs SLO du service ne sont pas atteints ;
- Les étiquettes les plus « courantes », « intéressantes » et « étranges » dans les requêtes qui se répètent le plus souvent se répètent;
- Répartition des latences pour les cas où dépendances du service n'atteignent pas les objectifs SLO fixés ;
- Répartition des latences par rapport à différents services en aval.
À certaines de ces questions, les métriques intégrées ne peuvent tout simplement pas répondre, obligeant les utilisateurs à étudier attentivement les intervalles. En fin de compte, nous avons un mécanisme extrêmement hostile à l'utilisateur.
Cela soulève la question : qu'en est-il des interactions complexes entre les divers services, gérés par différentes équipes ? N'est-ce pas traceview la solution la plus adaptée pour éclairer une telle situation ?
Les développeurs mobiles, les propriétaires de services sans état, les propriétaires de services avec état (comme les bases de données) et les propriétaires de plateformes peuvent être intéressés par une autre représentation d'un système distribué ; traceview – c'est une solution trop générale pour ces besoins fondamentalement différents. Même dans une architecture de microservices très complexe, les propriétaires de services n'ont pas besoin de connaissances approfondies sur plus de deux ou trois services en amont et en aval. En substance, dans la plupart des scénarios, les utilisateurs se contentent de répondre aux questions concernant un ensemble limité de services.
Cela ressemble à examiner un petit sous-ensemble de services à travers une loupe pour une étude minutieuse. Cela permettra à l'utilisateur de poser des questions plus pertinentes concernant l'interaction complexe entre ces services et leurs dépendances immédiates. C'est analogue à un backtrace dans le monde des services, où un ingénieur sait ce que non seulement ce qui se passe, mais a également une certaine idée de ce qui se passe dans les services environnants, afin de comprendre, pourquoi.
Mon approche préconisée est complètement opposée à l'approche « de haut en bas » basée sur traceview, où l'analyse commence par l'ensemble du trace, puis descend progressivement jusqu'aux spans individuels. Au contraire, l'approche « de bas en haut » commence par l'analyse d'une petite section, proche de la cause potentielle de l'incident, puis étend l'espace de recherche si nécessaire (en impliquant éventuellement d'autres équipes pour analyser un éventail plus large de services). Cette seconde approche est mieux adaptée pour vérifier rapidement les hypothèses initiales. Une fois des résultats concrets obtenus, on peut passer à une analyse plus ciblée et détaillée.
Construction topologique
Les vues spécifiques à un service peuvent être incroyablement utiles si l'utilisateur sait quel service ou groupe de services est responsable des retards croissants ou est à l'origine des erreurs. Cependant, dans un système complexe, identifier le service fautif peut s'avérer une tâche non triviale lors d'une panne, surtout si les messages d'erreur des services n'ont pas été reçus.
La construction de la topologie des services peut grandement aider à comprendre quel service montre une augmentation de la fréquence des erreurs ou des retards, entraînant une dégradation notable du service. En parlant de construction de topologie, je ne fais pas référence à une carte des services, affichant chaque service existant dans le système et connue pour ses . Une telle représentation n'est pas meilleure qu'un traceview basé sur un graphe acyclique dirigé. Au lieu de cela, j'aimerais voir une topologie des services générée dynamiquement, basée sur des attributs spécifiques tels que la fréquence des erreurs, le temps de réponse ou tout paramètre défini par l'utilisateur qui aide à clarifier la situation concernant des services suspectés particuliers.
Prenons un exemple. Imaginons un site d'actualités hypothétique. Le service de la page d'accueil (front page) communique des données avec Redis, avec le service de recommandations, avec le service publicitaire et le service vidéo. Le service vidéo prend les vidéos depuis S3, et les métadonnées depuis DynamoDB. Le service de recommandations obtient les métadonnées depuis DynamoDB, charge des données depuis Redis et MySQL, et publie des messages dans Kafka. Le service publicitaire récupère des données depuis MySQL et publie des messages dans Kafka.
Voici une représentation schématique de cette topologie (de nombreuses programmes commerciaux construisent des topologies pour le traçage). Cela peut être utile si l'on doit comprendre les dépendances des services. Cependant, pendant de débogage, lorsqu'un certain service (par exemple, le service vidéo) montre un temps de réponse accru, une telle topologie n'est pas très utile.
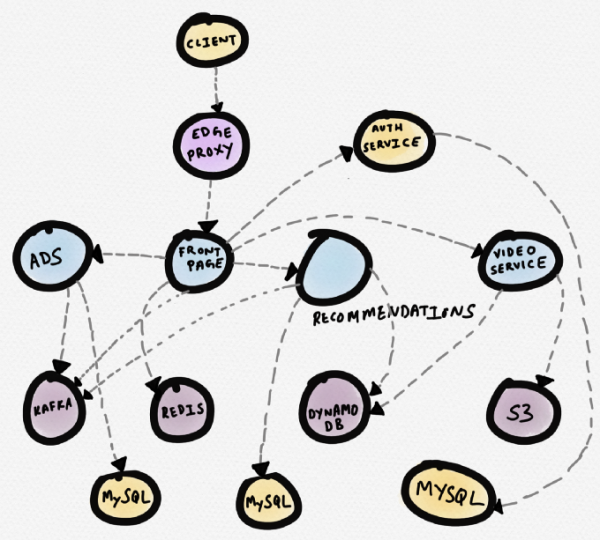
Schéma des services d'un site d'actualités hypothétique
Un diagramme comme celui présenté ci-dessous serait plus approprié. Il montre le service problématique (vidéo) directement au centre. L'utilisateur le remarque immédiatement. Cette visualisation montre clairement que le service vidéo fonctionne de manière anormale en raison de l'augmentation du temps de réponse de S3, ce qui impacte la vitesse de chargement d'une partie de la page d'accueil.
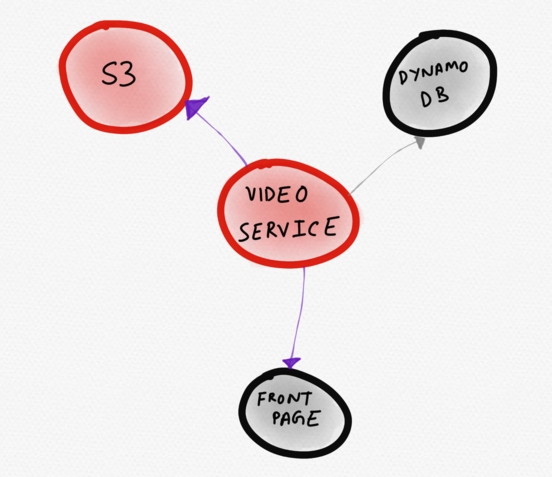
Topologie dynamique affichant uniquement les services « intéressants »
Les schémas topologiques générés dynamiquement peuvent s'avérer plus efficaces que les cartes statiques des services, surtout dans des infrastructures élastiques et auto-scalables. La possibilité de comparer et de juxtaposer les topologies des services permet à l'utilisateur de poser des questions plus pertinentes. Des questions plus précises sur le système sont plus susceptibles de mener à une meilleure compréhension de son fonctionnement.
Affichage comparatif
Une autre visualisation utile serait l'affichage comparatif. Actuellement, les traces ne sont pas très adaptées à la comparaison côte à côte, c'est pourquoi on compare généralement les intervalles. L'idée principale de cet article est justement que les spans sont trop bas niveaux pour extraire les informations les plus précieuses des résultats de traçage.
Comparer deux traces ne nécessite pas nécessairement de nouvelles visualisations. En fait, il suffit de quelque chose comme un histogramme représentant les mêmes informations que le traceview. Étonnamment, même cette méthode simple peut produire beaucoup plus de résultats que l'examen des deux traces séparément. Une fonctionnalité encore plus puissante serait la possibilité visualiser comparaison des traces dans l'ensemble. Il serait extrêmement utile de voir comment le changement de configuration de base de données récemment déployé, avec l'activation du GC (garbage collection), affecte le temps de réponse du service en aval sur plusieurs heures. Si ce que je décris ici ressemble à une analyse A/B de l'impact des changements d'infrastructure dans de nombreux services , à l'aide des résultats de traçage, vous n'êtes pas trop éloigné de la vérité.
Conclusion
Je ne doute pas de l'utilité même du traçage. Je crois sincèrement qu'il n'existe pas d'autre méthode pour collecter des données aussi riches, occasionnelles et contextuelles que celles contenues dans une trace. Cependant, je pense également que toutes les solutions de traçage utilisent ces données de manière extrêmement inefficace. Tant que les outils de traçage seront focalisés sur la représentation des vues de trace, ils seront limités dans leur capacité à maximiser l'utilisation des informations précieuses pouvant être extraites des données contenues dans les traces. De plus, il existe un risque de développement d'une interface visuelle non conviviale et non intuitive, qui restreindra considérablement la capacité de l'utilisateur à déboguer l'application.
Le débogage des systèmes complexes, même avec les outils les plus récents, est incroyablement difficile. Les outils doivent aider le développeur à formuler et à tester une hypothèse, en fournissant activement des informations pertinentes, en identifiant les anomalies et en notant les caractéristiques de la distribution des latences. Pour que le traçage devienne l'outil privilégié des développeurs pour résoudre les pannes en production ou pour traiter des problèmes couvrant divers services, des interfaces et des visualisations utilisateur originales sont nécessaires, davantage en phase avec le modèle mental des développeurs qui créent et exploitent ces services.
Il faudra des efforts mentaux considérables pour concevoir un système capable de représenter divers signaux disponibles dans les résultats de traçage d'une manière optimisée pour faciliter l'analyse et les déductions. Il est nécessaire de réfléchir à la manière d'abstraire la topologie du système lors du débogage afin d'aider l'utilisateur à surmonter les zones d'ombre, sans plonger dans des traces ou des segments individuels.
Nous avons besoin de bonnes capacités d'abstraction et de décomposition en niveaux (en particulier dans l'interface utilisateur). Celles-ci doivent bien s'insérer dans un processus de débogage basé sur des hypothèses, où il est possible de poser des questions itératives et de tester des hypothèses. Elles ne résoudront pas automatiquement tous les problèmes d'observabilité, mais elles aideront les utilisateurs à affiner leur intuition et à formuler des questions plus réfléchies. J'appelle à une approche plus réfléchie et innovante dans le domaine de la visualisation. Il y a une réelle opportunité d'élargir les horizons ici.
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
