

Introduction
Il se trouve qu'à mon poste actuel, j'ai dû me familiariser avec cette technologie. Je vais commencer par un bref historique. Lors d'une réunion, notre équipe a été informée qu'il fallait créer une intégration avec un système bien connu. Cette intégration signifiait que ce système bien connu nous enverrait des requêtes via HTTP à un certain endpoint, et nous, comme par hasard, devrions renvoyer des réponses sous forme de message SOAP. Tout semble simple et trivial. Il en découle qu'il faut…
La tâche
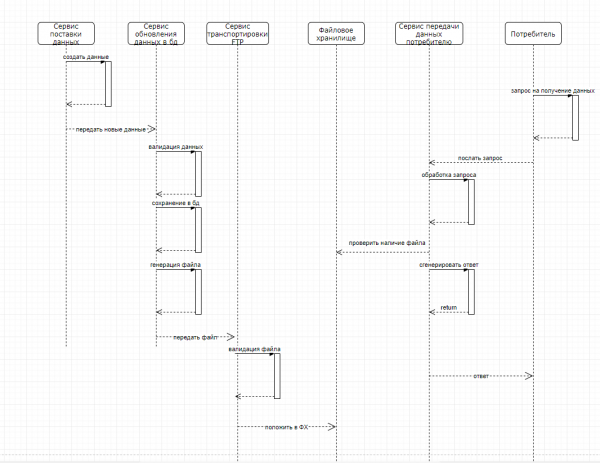
Créer 3 services. Le premier d'entre eux est le Service de mise à jour de la base de données. Ce service, lorsqu'il reçoit de nouvelles données d'un système externe, met à jour les données dans la base et génère un fichier au format CSV, pour le transmettre au système suivant. Il appelle l'endpoint du deuxième service — le Service de transport via FTP, qui reçoit le fichier transmis, le valide et le stocke dans un espace de stockage via FTP. Le troisième service — le Service de transmission de données à l'utilisateur, fonctionne de manière asynchrone avec les deux premiers. Il reçoit une demande d'un système externe pour le fichier dont il était question précédemment, prend le fichier prêt, le modifie (met à jour les champs id, description, linkToFile) et envoie la réponse sous forme de message SOAP. En gros, voici comment cela fonctionne : les deux premiers services commencent leur travail uniquement lorsque des données pour la mise à jour arrivent. Le troisième service fonctionne en permanence car il y a de nombreux consommateurs d'informations, environ 1000 demandes de données par minute. Les services sont toujours disponibles et leurs instances se trouvent dans différents environnements tels que test, démo, préproduction et production. Ci-dessous, un schéma de fonctionnement de ces services. Je précise que certains détails ont été simplifiés pour éviter des complications inutiles.
Approfondissement technique
Lors de la planification de la solution, nous avons d'abord décidé de créer des applications en Java en utilisant le framework Spring, avec Nginx comme équilibreur de charge, une base de données Postgres et d'autres éléments techniques et moins techniques. Comme le temps accordé à l'élaboration de la solution technique permettait d'envisager d'autres approches pour résoudre ce problème, notre attention s'est tournée vers la technologie à la mode dans certains cercles, Apache NIFI. Je dois dire tout de suite que cette technologie nous a permis de remarquer ces 3 services. Cet article décrira le développement du service de transport de fichiers et du service de transmission de données au consommateur, mais si l'article est bien reçu, j'écrirai sur le service de mise à jour des données dans la base de données.
Qu'est-ce que c'est
NIFI est une architecture distribuée pour le chargement et le traitement des données de manière rapide et parallèle, offrant un grand nombre de plugins pour les sources et les transformations, le versionnage des configurations et bien plus encore. Un avantage agréable est qu'il est très simple à utiliser. Les processus triviaux, tels que getFile, sendHttpRequest et d'autres, peuvent être représentés sous forme de carrés. Chaque carré représente un certain processus, dont l'interaction peut être visualisée sur l'image ci-dessous. Une documentation plus détaillée sur l'interaction et la configuration des processus est écrite , pour ceux qui parlent russe — . La documentation décrit très bien comment décompresser et démarrer NIFI, ainsi que comment créer des processus, qui sont aussi des carrés.
L'idée d'écrire cet article est née après de longues recherches et la structuration des informations reçues en quelque chose de cohérent, ainsi que le désir de rendre un peu la vie plus facile pour les futurs développeurs.
Exemple
Nous avons examiné un exemple de l'interaction entre les carrés. Le schéma général est assez simple : nous recevons une requête HTTP (en théorie avec un fichier dans le corps de la requête. Pour démontrer les capacités de NIFI, dans cet exemple, la requête lance le processus d'obtention d'un fichier depuis le FX local), puis nous envoyons une réponse indiquant que la requête a été reçue, tout en lançant en parallèle le processus d'obtention du fichier depuis le FX, puis le processus de transfert via FTP vers le FX. Il convient de préciser que les processus interagissent entre eux grâce à ce qu'on appelle un flowFile. C'est une entité de base dans NIFI, qui stocke des attributs et du contenu. Le contenu représente les données sous forme de fichier de flux. En gros, si vous obtenez un fichier d'un carré et le transférez à un autre, le contenu sera votre fichier.
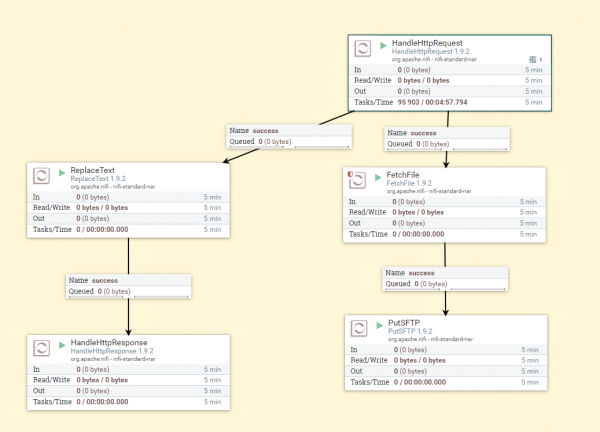
Comme vous pouvez le constater, ce diagramme montre le processus global. HandleHttpRequest reçoit les requêtes, ReplaceText génère le corps de la réponse, HandleHttpResponse renvoie la réponse. FetchFile obtient un fichier de l'entrepôt de fichiers et le transmet au carré PutSftp, qui dépose ce fichier sur FTP à l'adresse spécifiée. Prenons maintenant un peu plus de détails sur ce processus.
Dans ce cas, la request est le début de tout. Examinons ses paramètres de configuration.
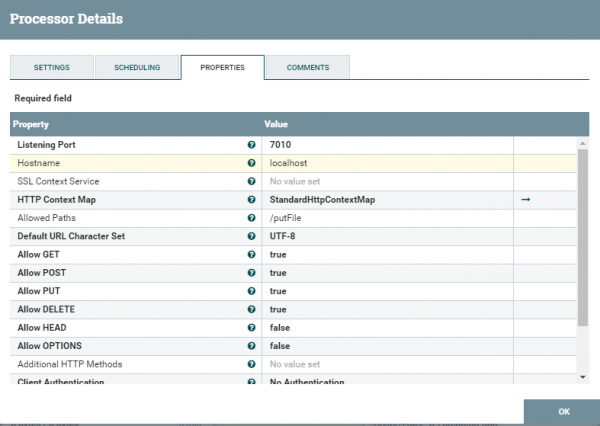
Ici, tout est assez trivial, à l'exception de StandartHttpContextMap, qui est un service permettant d'envoyer et de recevoir des requêtes. Pour plus de détails et même des exemples, vous pouvez consulter —
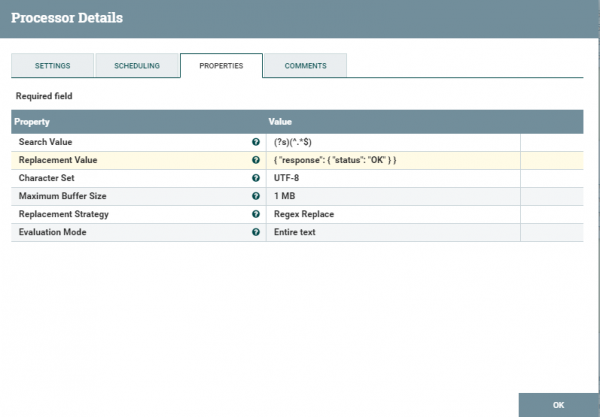
Passons maintenant aux paramètres de configuration du carré ReplaceText. Il faut faire attention à ReplacementValue — c'est ce qui sera renvoyé à l'utilisateur sous forme de réponse. Dans settings, vous pouvez régler le niveau de journalisation, les journaux peuvent être consultés {où nous avons décompressé nifi} /nifi-1.9.2/logs, où il y a aussi des paramètres failure/success — sur la base de ces paramètres, vous pouvez réguler le processus dans son ensemble. Autrement dit, en cas de traitement réussi du texte, le processus d'envoi de la réponse à l'utilisateur sera déclenché, sinon, nous journaliserons simplement le processus échoué.
Dans les propriétés de HandleHttpResponse, il n'y a rien d'intéressant à part le statut en cas de création réussie de la réponse.
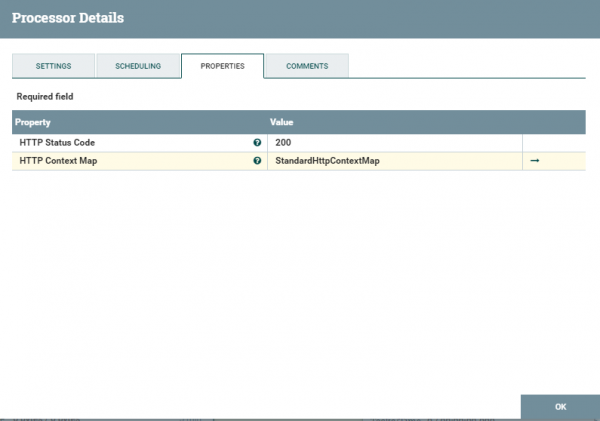
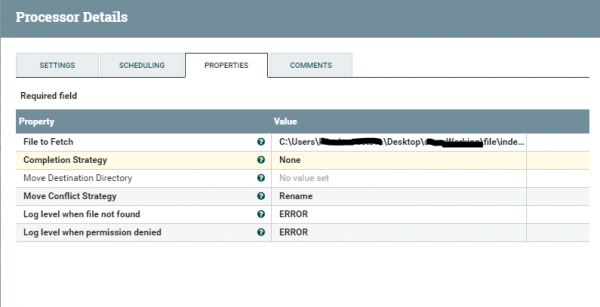
Nous avons compris la demande et la réponse — passons maintenant à l'obtention du fichier et à son placement sur le serveur FTP. FetchFile obtient le fichier selon le chemin spécifié dans les paramètres et le transmet au processus suivant.
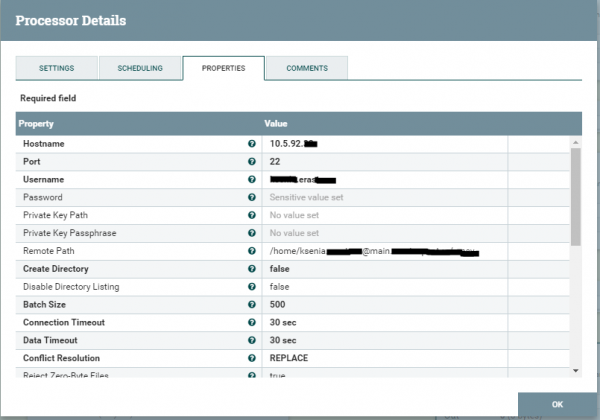
Le carré PutSftp place le fichier dans le stockage. Nous pouvons voir les paramètres de configuration ci-dessous.
Il convient de noter que chaque carré représente un processus distinct qui doit être exécuté. Nous avons examiné l'exemple le plus simple qui ne nécessite aucune personnalisation complexe. Passons maintenant à un processus un peu plus compliqué, où nous écrirons légèrement en Groovy.
Un exemple plus complexe
Le service de transfert de données au consommateur s'est avéré légèrement plus complexe en raison du processus de modification du message SOAP. Le processus général est illustré ci-dessous.
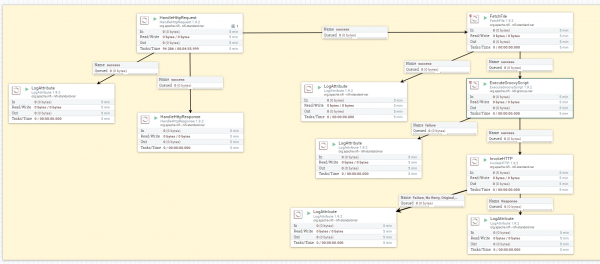
L'idée ici n'est pas particulièrement compliquée : nous avons reçu une demande du consommateur concernant des données, nous avons envoyé une réponse indiquant que nous avons reçu le message, lancé le processus d'obtention du fichier de réponse, puis l'avons modifié avec une certaine logique, avant de transmettre le fichier au consommateur sous forme de message SOAP sur le serveur.
Je pense qu'il n'est pas nécessaire de décrire à nouveau les carrés que nous avons vus ci-dessus — passons directement à de nouveaux. Si vous devez modifier un fichier et que les carrés standard comme ReplaceText ne conviennent pas, vous devrez écrire votre propre script. Cela peut être fait à l'aide du carré ExecuteGroovyScript. Ses paramètres sont présentés ci-dessous.
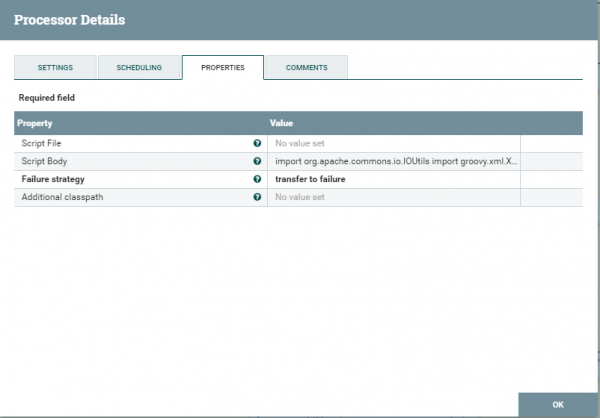
Il existe deux options pour charger le script dans ce carré. La première consiste à télécharger un fichier contenant le script. La deuxième consiste à insérer le script dans scriptBody. À ma connaissance, le carré executeScript prend en charge plusieurs langages de programmation, dont groovy. Je vais décevoir les développeurs Java : il n'est pas possible d'écrire des scripts en Java dans de tels carrés. Pour ceux qui le souhaitent vraiment, il faut créer son propre carré personnalisé et l'introduire dans le système NIFI. Toute cette opération est accompagnée de nombreuses danses rituelles, que nous n'aborderons pas dans cet article. J'ai choisi le langage groovy. Voici un script test qui met simplement à jour de manière incrémentielle l'id dans le message SOAP. Il est important de noter que vous prenez le fichier du flowFile, le mettez à jour, et n'oubliez pas de le remettre à sa place après modification. Il convient également de mentionner que toutes les bibliothèques ne sont pas connectées. Il se peut que vous deviez importer l'une des bibliothèques. Un autre inconvénient est que le script dans ce carré est assez difficile à déboguer. Il existe une méthode pour se connecter à la JVM NIFI et commencer le processus de débogage. Personnellement, j'ai lancé l'application localement et j'ai simulé la réception du fichier de la session. Le débogage a également été effectué localement. Les erreurs qui apparaissent lors du chargement du script sont assez faciles à rechercher sur Google et NIFI les consigne dans le log.
import org.apache.commons.io.IOUtils
import groovy.xml.XmlUtil
import java.nio.charset.*
import groovy.xml.StreamingMarkupBuilder

def flowFile = session.get()
if (!flowFile) return
try {
    flowFile = session.write(flowFile, { inputStream, outputStream ->
        String result = IOUtils.toString(inputStream, "UTF-8");
        def recordIn = new XmlSlurper().parseText(result)
        def element = recordIn.depthFirst().find {
            it.name() == 'id'
        }

        def newId = Integer.parseInt(element.toString()) + 1
        def recordOut = new XmlSlurper().parseText(result)
        recordOut.Body.ClientMessage.RequestMessage.RequestContent.content.MessagePrimaryContent.ResponseBody.id = newId

        def res = new StreamingMarkupBuilder().bind { mkp.yield recordOut }.toString()
        outputStream.write(res.getBytes(StandardCharsets.UTF_8))
} as StreamCallback)
     session.transfer(flowFile, REL_SUCCESS)
}
catch(Exception e) {
    log.error("Erreur lors du traitement de validate.groovy", e)
    session.transfer(flowFile, REL_FAILURE)
}
Cela marque la fin de la personnalisation du carré. Ensuite, le fichier mis à jour est transféré dans le carré responsable de l'envoi du fichier au serveur. Voici les paramètres de ce carré.
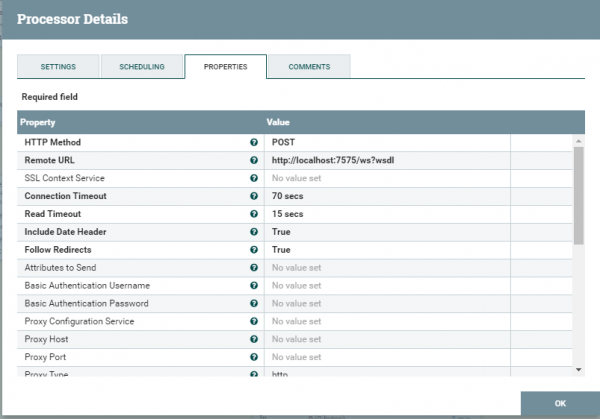
Nous décrivons la méthode par laquelle le message SOAP sera transmis. Nous indiquons où. Ensuite, il faut préciser qu'il s'agit bien d'un message SOAP.
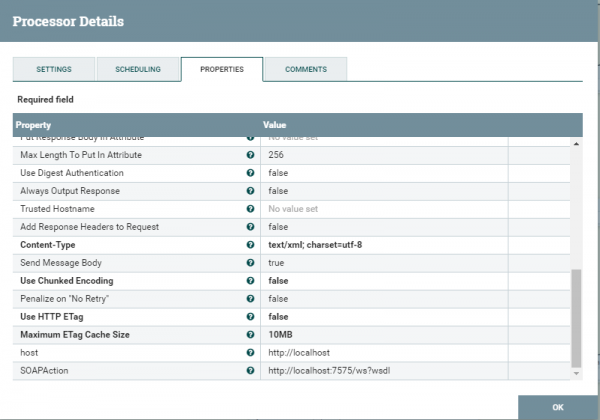
Nous ajoutons plusieurs propriétés telles que l'hôte et l'action (soapAction). Nous enregistrons et vérifions. Pour plus de détails sur l'envoi de requêtes SOAP, vous pouvez consulter
Nous avons exploré plusieurs options d'utilisation des processus NIFI. Comment ils interagissent et quel en est le véritable bénéfice. Les exemples examinés sont des tests et diffèrent un peu de ce qui se passe réellement en production. J'espère que cet article sera un peu utile aux développeurs. Merci pour votre attention. Si vous avez des questions, n'hésitez pas à écrire. Je ferai de mon mieux pour répondre.
Source : habr.com
