

On dit qu'il faut tout essayer au moins une fois dans la vie. Et si vous avez l'habitude de travailler avec des bases de données relationnelles, il est d'abord intéressant de faire connaissance avec NoSQL, ne serait-ce que pour élargir ses horizons. Actuellement, en raison de l'évolution rapide de cette technologie, de nombreuses opinions contradictoires et débats passionnés émergent sur le sujet, ce qui alimente particulièrement l'intérêt.
Si l'on plonge dans le cœur de tous ces débats, on peut voir qu'ils proviennent d'une approche incorrecte. Ceux qui utilisent des bases de données NoSQL là où elles sont nécessaires sont satisfaits et tirent tous les avantages de cette solution. Ceux qui expérimentent en comptant sur cette technologie comme une panacée là où elle n'est pas du tout applicable éprouvent de la déception, perdant les atouts des bases relationnelles sans obtenir d'avantages significatifs.
Je vais parler de notre expérience de mise en œuvre d'une solution basée sur la base de données Cassandra : les défis que nous avons rencontrés, comment nous nous sommes sortis de situations difficiles, si nous avons réussi à tirer profit de l'utilisation de NoSQL et où nous avons dû investir des efforts ou des ressources supplémentaires.
La tâche initiale consiste à construire un système enregistrant les appels dans un certain stockage.
Le principe de fonctionnement du système est le suivant. Des fichiers avec une structure définie, décrivant la structure de l'appel, arrivent en entrée. L'application assure ensuite la sauvegarde de cette structure dans les colonnes correspondantes. Les appels sauvegardés sont ensuite utilisés pour afficher des informations sur la consommation de trafic pour les abonnés (facturations, appels, historique des soldes).
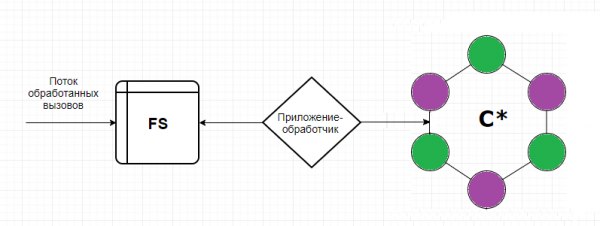
Pourquoi avoir choisi Cassandra est assez clair — elle écrit à la vitesse d'une mitrailleuse, est facilement évolutive et tolérante aux pannes.
Ainsi, voici ce que l'expérience nous a offert
Oui, une nœud tombée n'est pas une tragédie. C'est justement le principe de tolérance aux pannes de Cassandra. Mais une nœud peut être opérationnelle tout en commençant à ralentir en performance.. Il s'est avéré que cela se répercute immédiatement sur la performance de l'ensemble du cluster.
Cassandra ne vous protègera pas là où Oracle a sauvé grâce à ses contraintes.. Et si l'auteur de l'application n'a pas compris cela à l'avance, un doublon pour Cassandra n'est pas moins bon que l'original. Une fois qu'il est arrivé, mettons-le tout de même.
La version gratuite de Cassandra « prête à l'emploi » a très vite déplu à la sécurité informatique : Il n'y a pas de journalisation des actions des utilisateurs ni de séparation des droits.L'information sur les appels est considérée comme des données personnelles, ce qui signifie que toute tentative d'y accéder ou de les modifier doit être journalisée avec la possibilité d'un audit ultérieur. Il faut également comprendre la nécessité de séparer les droits à différents niveaux pour différents utilisateurs. Un simple ingénieur d'exploitation et un super administrateur, qui peut librement supprimer tout le keyspace - ce sont des rôles différents, avec des responsabilités et des compétences différentes. Sans cette séparation des droits d'accès, la valeur et l'intégrité des données seront mises en question plus rapidement qu'avec un niveau de cohérence ANY.
Nous n'avons pas pris en compte que les appels nécessitent à la fois une analyse sérieuse et des échantillons périodiques selon divers critères. Étant donné que les enregistrements sélectionnés sont supposés être supprimés et réécrits (dans le cadre de la tâche, nous devons maintenir le processus d'actualisation des données lorsque les données initialement reçues dans notre système sont incorrectes), Cassandra ici ne nous est d'aucune aide. Cassandra, comme une tirelire – il est pratique d'y stocker, mais vous ne pourrez pas effectuer de calculs.
Nous avons rencontré un problème de transfert de données vers les zones de test. (5 nœuds en test contre 20 en production). Dans ce cas, il ne sera pas possible d'utiliser un dump.
Problème de mise à jour du schéma de données de l'application qui écrit dans Cassandra. Un rollback va générer un grand nombre de tombstones, ce qui peut de manière imprévisible affecter nos performances.Cassandra est optimisée pour l'écriture, et avant d'écrire, elle ne réfléchit pas beaucoup. Toute opération sur des données existantes est également une écriture. C'est-à-dire qu'en supprimant des données superflues, nous allons simplement multiplier les enregistrements, et seule une partie d'entre eux sera marquée comme tombstones.
Timeouts lors des insertions. Cassandra est excellente pour l'écriture, mais parfois le flux entrant peut la rendre considérablement perplexe.Cela se produit lorsque l'application commence à faire circuler plusieurs enregistrements qu'il est impossible d'insérer pour une raison quelconque. Et nous aurons besoin d'un véritable DBA qui surveillera gc.log, les journaux système et de débogage à la recherche de requêtes lentes, ainsi que des métriques sur le compactage en attente.
Plusieurs centres de données dans le cluster. D'où lire et où écrire ?
Est-il possible de séparer en lecture et en écriture ? Et si oui, doit-il y avoir un DC pour l'écriture ou pour la lecture, près de l'application ? Ne risquons-nous pas de rencontrer un vrai split brain si nous choisissons incorrectement le niveau de cohérence ? Il y a tellement de questions, tant d'options non explorées, que j'ai vraiment envie d'expérimenter.
Comment nous avons résolu
Pour éviter que le nœud ne ralentisse, nous avons désactivé le SWAP.. Et maintenant, en cas de manque de mémoire, le nœud doit tomber au lieu de créer de longues pauses de GC.
Ainsi, nous ne comptons plus sur la logique dans la base de données. Les développeurs de l'application se rééduquent et commencent à se protéger activement dans leur propre code. Une séparation parfaite entre le stockage et le traitement des données.
Nous avons acheté du support de DataStax. La version boîte de Cassandra n'est plus développée (dernier commit en février 2018). En même temps, Datastax propose un excellent service et un grand nombre de solutions adaptées aux systèmes d'information existants.
Je tiens également à souligner que Cassandra n'est pas très pratique pour les requêtes de sélection. Bien sûr, CQL est un grand pas vers les utilisateurs (comparé à Thrift). Mais si vous avez des départements entiers habitués à des jointures pratiques, à une filtration libre par n'importe quel champ et à des possibilités d'optimisation des requêtes, et que ces départements travaillent pour résoudre des problèmes et des urgences, alors une solution basée sur Cassandra leur paraît hostile et insensée. Et nous avons commencé à chercher comment aider nos collègues à réaliser des sélection.
Nous avons envisagé deux options. Dans la première option, nous écrivons des appels non seulement dans C*, mais aussi dans la base de données Oracle archiviste. Cependant, contrairement à C*, cette base de données ne stocke que les appels du mois en cours (une profondeur de stockage adéquate pour les cas de re-tarification). Ici, un problème se posait immédiatement : si nous écrivons de manière synchrone, nous perdons tous les avantages de C* liés à une insertion rapide ; si nous écrivons de manière asynchrone, il n'y a aucune garantie que tous les appels nécessaires aient été enregistrés dans Oracle. Mais il y avait un seul, mais grand, avantage : pour l'exploitation, nous avons toujours le PL/SQL Developer familier, c'est-à-dire que nous pourrions pratiquement réaliser le pattern « Façade ». Option alternative. Nous mettons en œuvre un mécanisme qui extrait les appels de C*, tire certaines données pour enrichir à partir des tableaux correspondants dans Oracle, joint les résultats obtenus et nous donne le résultat final, que nous utiliserons ensuite d'une manière ou d'une autre (rollback, réexécution, analyse, admiration). Inconvénients : le processus s'avère assez complexe et, de plus, il n'y a pas d'interface pour les employés de l'exploitation.
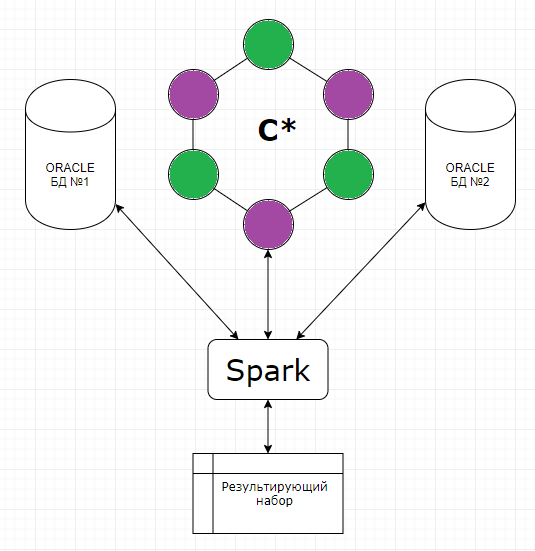
Au final, nous avons tout de même opté pour la deuxième option. Pour les sélections de différentes bases, nous avons utilisé Apache Spark. L'essence du mécanisme se résume à un code Java qui, en fonction des clés spécifiées (abonné, heure de l'appel – clés de la section), extrait des données de C* et également les données nécessaires pour enrichir à partir de toute autre base de données. Ensuite, il les joint dans sa mémoire et affiche le résultat dans la table de résultats. Nous avons dessiné une interface web sur Spark et cela s'est avéré tout à fait exploitable.
Lors de la résolution du problème de mise à jour des données, nous avons de nouveau examiné plusieurs façons de procéder. Tant le transfert via Sstloader que la solution consistant à diviser le cluster en zone de test en deux parties, chacune se connectant alternativement à un cluster de production, alimenté de cette manière. Lors de la mise à jour du test, il était prévu de les échanger : la partie qui a fonctionné dans le test serait nettoyée et introduite en production, tandis que l'autre commencerait à travailler avec les données séparément. Cependant, après y avoir réfléchi à nouveau, nous avons mieux évalué les données à transférer et compris que les appels eux-mêmes sont une entité non cohérente pour les tests, générée rapidement en cas de besoin, et que l'ensemble de données de production n'a pas de valeur à transférer dans le test. Il y a plusieurs objets accumulants qui méritent d'être transférés, mais ce ne sont littéralement que quelques tables, et pas très lourdes. Donc, nous comme solution, Spark a de nouveau été utile, grâce auquel nous avons écrit et commencé à utiliser activement un script de transfert des données entre les tables de production et de test.
Notre politique actuelle de déploiement nous permet de travailler sans rollback. Avant la production, un déploiement obligatoire a lieu sur le test, où l'erreur n'est pas si coûteuse. En cas d'échec, il est toujours possible de supprimer le keyspace et de redéployer toute la schéma depuis le début.
Pour assurer une disponibilité continue de Cassandra, il faut un DBA et bien plus encore. Tous ceux qui travaillent avec l'application doivent comprendre où et comment suivre l'état actuel et comment diagnostiquer les problèmes à temps. Pour cela, nous utilisons activement DataStax OpsCenter (Administration et surveillance des charges de travail), les métriques système du Cassandra Driver (nombre de timeouts d'écriture dans C*, nombre de timeouts de lecture dans C*, latence maximale, etc.), nous surveillons le fonctionnement de l'application elle-même, qui fonctionne avec Cassandra.
Lorsque nous avons réfléchi à la question précédente, nous avons compris où se cachait notre principal risque. Ce sont les formes d'affichage des données, qui tirent des informations de plusieurs requêtes indépendantes les unes des autres vers le stockage. Nous pouvons ainsi obtenir des informations plutôt incohérentes. Mais ce problème serait tout aussi pertinent même si nous ne travaillions qu'avec un seul centre de données. Donc, la meilleure chose à faire ici est, bien sûr, de créer une fonction batch de lecture des données dans une application externe, qui garantira l’obtention des données dans une période de temps unifiée. En ce qui concerne la séparation entre lecture et écriture en termes de performance, le risque qui nous a arrêté est que lors d'une perte de connexion entre les centres de données, nous pourrions obtenir deux clusters totalement incohérents entre eux.
Au final, à ce jour nous avons opté pour le niveau de cohérence d'écriture EACH_QUORUM et de lecture LOCAL_QUORUM
Impressions et conclusions en bref
Pour évaluer la solution obtenue du point de vue du support opérationnel et des perspectives de développement futur, nous avons décidé de réfléchir à d'autres domaines où ce développement pourrait être appliqué.
À brûle-pourpoint, le scoring des données pour des programmes comme « Payez quand cela vous arrange » (nous chargeons l'information dans S* et calculons avec des scripts Spark), la gestion des réclamations avec agrégation par départements, le stockage des rôles et le calcul selon la matrice des droits d'accès des utilisateurs.
Comme nous le voyons, le répertoire est large et varié. Et si nous devions choisir un camp entre les partisans et les opposants de NoSQL, nous rejoindrions les partisans, car nous avons obtenu des avantages, exactement là où nous le souhaitions.
Même la version standard de Cassandra permet un scaling horizontal en temps réel, résolvant de manière totalement indolore la question de l'augmentation des données dans le système. Nous avons réussi à isoler dans un contour distinct un mécanisme hautement chargé pour le calcul des agrégats d'appels, ainsi qu'à séparer le schéma et la logique de l'application, en nous débarrassant de la pratique néfaste d'écrire des jobs et objets personnalisés directement dans la base de données. Nous avons obtenu la possibilité de choisir et de configurer, pour améliorer la vitesse, dans quels centres de données nous effectuerons le calcul et dans lesquels nous enregistrerons les données, nous protégeant ainsi contre les pannes tant de nœuds individuels que des centres de données dans leur ensemble.
En appliquant notre architecture à de nouveaux projets, et déjà avec un certain niveau d'expérience, il serait souhaitable de prendre immédiatement en compte les nuances décrites ci-dessus et d'éviter certaines erreurs, ainsi que d'adoucir quelques angles qui n'ont pas pu être évités au départ.
Par exemple, surveiller en temps réel les mises à jour de Cassandra, car de nombreux problèmes que nous avons rencontrés étaient déjà connus et avaient été corrigés.
Ne pas installer la base de données et Spark sur les mêmes nœuds ou les séparer strictement en fonction de l'utilisation autorisée des ressources, car Spark peut consommer plus de mémoire vive que prévu, ce qui pourrait rapidement entraîner le problème numéro 1 de notre liste.
Améliorer le monitoring et la compétence opérationnelle dès la phase de test du projet. Prendre en compte au maximum tous les consommateurs potentiels de notre solution, car cela dépendra finalement de la structure de la base de données.
Passer plusieurs fois en revue le schéma obtenu pour identifier les possibilités d'optimisation. Déterminer quels champs peuvent être sérialisés. Comprendre quelles tables supplémentaires nous devons créer pour tenir compte de manière précise et optimale des données, et les restituer efficacement sur demande (par exemple, en considérant que les mêmes données peuvent être stockées dans différentes tables, selon divers critères de répartition, ce qui peut considérablement économiser le temps processeur lors des requêtes de lecture).
Pas mal prévoir immédiatement l'ajout de TTL et le nettoyage des données obsolètes.
Lors de l'extraction des données de Cassandra la logique de l'application doit fonctionner selon le principe de FETCH, pour que toutes les lignes ne soient pas chargées en mémoire d'un coup, mais soient sélectionnées par lots.
Il est préférable de vérifier la résilience du système avant de transférer le projet vers la solution décrite. en réalisant une série de tests de résistance, tels que la perte de données dans un centre de données, la restauration des données altérées sur une certaine période, et les baisses de réseau entre les centres de données. De tels tests permettront non seulement d'évaluer les avantages et les inconvénients de l'architecture proposée, mais fourniront également une bonne pratique aux ingénieurs qui les réalisent, et cette compétence ne sera pas de trop en cas de pannes système en production.
Lorsqu'il s'agit de traiter des informations critiques (telles que les données de facturation ou le calcul des dettes des abonnés), il convient également de prêter attention aux outils qui permettent de réduire les risques liés aux particularités des SGBD. Par exemple, utiliser l'outil nodesync (Datastax) en élaborant une stratégie optimale pour son utilisation afin de ne pas créer une surcharge excessive sur Cassandra pour des raisons de cohérence et de l'utiliser uniquement pour certaines tables pendant des périodes spécifiques.
Alors, après six mois de vie avec Cassandra ? Globalement, il n'y a pas de problèmes non résolus. Nous n'avons pas non plus subi de graves pannes ou de pertes de données. Oui, il a fallu réfléchir à la compensation de certains problèmes qui n'étaient pas apparus auparavant, mais au final, cela n'a pas terni notre solution architecturale. Si vous êtes prêt à essayer quelque chose de nouveau et que vous ne craignez pas d'être déçu, préparez-vous à ce que rien ne soit gratuit. Vous devrez vous plonger dans la documentation et rencontrer plus souvent vos propres obstacles que dans une solution legacy ancienne, et aucune théorie ne pourra vous indiquer à l'avance quels obstacles vous attendent.
Source : habr.com
