

À l'époque où Kubernetes était encore en version v1.0.0, il existait des plugins de volumes. Ces plugins étaient nécessaires pour connecter les systèmes de stockage aux données persistantes des conteneurs Kubernetes. Leur nombre était limité et parmi les premiers se trouvaient des fournisseurs de stockage tels que GCE PD, Ceph, AWS EBS et d'autres.
Les plugins étaient fournis avec Kubernetes, d'où le nom qu'ils ont reçu : in-tree. Cependant, de nombreux utilisateurs ont trouvé cet ensemble insuffisant. Les développeurs ajoutaient des plugins simples dans le noyau Kubernetes à l'aide de patches, puis rebuildaient leur propre Kubernetes pour l'installer sur leurs serveurs. Mais avec le temps, les développeurs de Kubernetes ont compris que la solution ne résidait pas dans cela. Les gens avaient besoin d'une canne à pêche. Et dans la version de Kubernetes v1.2.0, elle est apparue…
Plugin Flexvolume : une canne à pêche basique
Les développeurs de Kubernetes ont créé le plugin FlexVolume, qui était une couche logique composée de variables et de méthodes pour travailler avec les pilotes Flexvolume développés par des tiers.
Examinons plus en détail ce qu'est un pilote FlexVolume. Il s'agit d'un fichier exécutable (fichier binaire, script Python, script Bash, etc.), qui, lorsqu'il est exécuté, accepte des arguments de ligne de commande et retourne un message avec des champs prédéfinis au format JSON. Le premier argument de la ligne de commande est toujours la méthode, et les autres arguments sont ses paramètres.
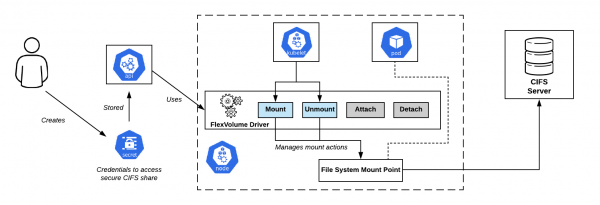
Schéma de connexion des partages CIFS dans OpenShift. Le pilote Flexvolume est au cœur du système.
Ensemble minimal de méthodes semble être le suivant :
flexvolume_driver mount # gère le montage du volume au pod
# Format du message retourné :
{
  "status": "Succès"/"Échec"/"Non supporté",
  "message": "Pour quelle raison ce statut a-t-il été retourné",
}

flexvolume_driver unmount # gère le démontage du volume du pod
# Format du message retourné :
{
  "status": "Succès"/"Échec"/"Non supporté",
  "message": "Pour quelle raison ce statut a-t-il été retourné",
}

flexvolume_driver init # gère l'initialisation du plugin
# Format du message retourné :
{
  "status": "Succès"/"Échec"/"Non supporté",
  "message": "Pour quelle raison ce statut a-t-il été retourné",
  // Indique si le pilote utilise les méthodes attach/detach
  "capabilities":{"attach": True/False}
}
Utilisation des méthodes attach et detach déterminera le scénario selon lequel kubelet agira à l'avenir lors de l'appel du pilote. Il existe également des méthodes spéciales expandvolume et expandfs, qui permettent un ajustement dynamique de la taille du volume.
À titre d'exemple des modifications apportées par la méthode expandvolume, ainsi que la possibilité d'effectuer des changements de taille de volumes en temps réel, vous pouvez consulter dans Rook Ceph Operator.
Voici un exemple d'implémentation d'un pilote Flexvolume pour travailler avec NFS :
usage() {
    err "Utilisation invalide. Usage : "
    err "t$0 init"
    err "t$0 mount <répertoire de montage> <params json>"
    err "t$0 unmount <répertoire de montage>"
    exit 1
}

err() {
    echo -ne $* 1>&2
}

log() {
    echo -ne $* >&1
}

ismounted() {
    MOUNT=`findmnt -n ${MNTPATH} 2>\/dev\/null | cut -d' ' -f1`
    if [ "${MOUNT}" == "${MNTPATH}" ]; then
        echo "1"
    else
        echo "0"
    fi
}

domount() {
    MNTPATH=$1

    NFS_SERVER=$(echo $2 | jq -r '.server')
    SHARE=$(echo $2 | jq -r '.share')

    if [ $(ismounted) -eq 1 ] ; then
        log '{"status": "Success"}'
        exit 0
    fi

    mkdir -p ${MNTPATH} &> \/dev\/null

    mount -t nfs ${NFS_SERVER}:\/{$SHARE} ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Échec", "message": "Échec du montage de ${NFS_SERVER}:${SHARE} sur ${MNTPATH}"}"
        exit 1
    fi
    log '{"status": "Success"}'
    exit 0
}

unmount() {
    MNTPATH=$1
    if [ $(ismounted) -eq 0 ] ; then
        log '{"status": "Success"}'
        exit 0
    fi

    umount ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Échec", "message": "Échec du démontage du volume à ${MNTPATH}"}"
        exit 1
    fi

    log '{"status": "Success"}'
    exit 0
}

op=$1

if [ "$op" = "init" ]; then
    log '{"status": "Success", "capabilities": {"attach": false}}'
    exit 0
fi

if [ $# -lt 2 ]; then
    usage
fi

shift

case "$op" in
    mount)
        domount $*
        ;;
    unmount)
        unmount $*
        ;;
    *)
        log '{"status": "Non pris en charge"}'
        exit 0
esac

exit 1
Ainsi, après la préparation de l'exécutable, il est nécessaire de déployer le pilote dans le cluster Kubernetes. Le pilote doit se trouver sur chaque nœud du cluster selon un chemin prédéfini. Par défaut, le chemin choisi était :
/usr/libexec/kubernetes/kubelet-plugins/volume/exec/имя_поставщика_хранилища~имя_драйвера/
… mais lors de l'utilisation de différentes distributions Kubernetes (OpenShift, Rancher…), le chemin peut être différent.
Problèmes de Flexvolume : comment bien lancer la ligne ?
Déployer le pilote Flexvolume sur les nœuds du cluster s'est avéré être une tâche délicate. Une fois l'opération effectuée manuellement, vous pouvez facilement vous retrouver dans une situation où de nouveaux nœuds apparaissent dans le cluster : en raison de l'ajout d'un nouveau nœud, d'un redimensionnement horizontal automatique ou, ce qui est plus inquiétant, d'un remplacement de nœud en raison d'une défaillance. Dans ce cas, l'interaction avec le stockage sur ces nœuds doit être est impossible, tant que vous n'avez pas ajouté le pilote Flexvolume manuellement sur eux.
La solution à ce problème a été l'un des primitives de Kubernetes — DaemonSetLorsqu'un nouveau nœud est ajouté au cluster, un pod de notre DaemonSet y est automatiquement déployé, avec un volume local monté pour la recherche des pilotes Flexvolume. Une fois le pod créé avec succès, il copie les fichiers nécessaires au fonctionnement du pilote sur le disque.
Voici un exemple de ce DaemonSet pour déployer le plugin Flexvolume :
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: flex-set
spec:
  template:
    metadata:
      name: flex-deploy
      labels:
        app: flex-deploy
    spec:
      containers:
        - image:
          name: flex-deploy
          securityContext:
              privileged: true
          volumeMounts:
            - mountPath: /flexmnt
              name: flexvolume-mount
      volumes:
        - name: flexvolume-mount
          hostPath:
            path:
… et voici un exemple de script Bash pour déployer le pilote Flexvolume :
#!/bin/sh

set -o errexit
set -o pipefail

VENDOR=k8s.io
DRIVER=nfs

driver_dir=$VENDOR${VENDOR:+"~"}${DRIVER}
if [ ! -d "/flexmnt/$driver_dir" ]; then
  mkdir "/flexmnt/$driver_dir"
fi

cp "/$DRIVER" "/flexmnt/$driver_dir/.$DRIVER"
mv -f "/flexmnt/$driver_dir/.$DRIVER" "/flexmnt/$driver_dir/$DRIVER"

while : ; do
  sleep 3600
done
Il est important de ne pas oublier que l'opération de copie n'est pas atomique. Il y a un grand risque que kubelet commence à utiliser le pilote avant que son processus de préparation ne soit terminé, ce qui provoquerait une erreur dans le fonctionnement du système. L'approche correcte consiste d'abord à copier les fichiers du pilote sous un autre nom, puis à utiliser une opération de renommage atomique.
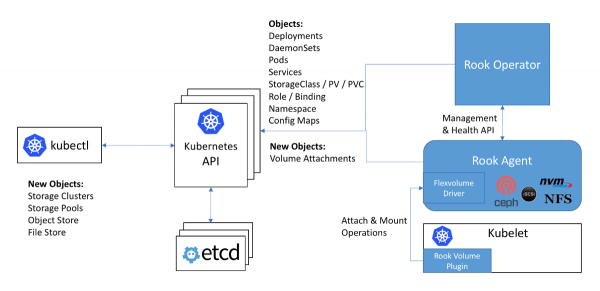
Schéma de fonctionnement avec Ceph dans l'opérateur Rook : le pilote Flexvolume dans le schéma se trouve à l'intérieur de l'agent Rook
Le problème suivant lors de l'utilisation des pilotes Flexvolume est que pour la plupart des stockages sur le nœud du cluster le logiciel nécessaire doit être installé (par exemple, le paquet ceph-common pour Ceph). À l'origine, le plugin Flexvolume n'était pas conçu pour des systèmes aussi complexes.
Une solution originale à ce problème peut être observée dans l'implémentation du pilote Flexvolume de l'opérateur Rook :
Le pilote lui-même est réalisé sous la forme d'un client RPC. Le socket IPC pour la communication se trouve dans le même répertoire que le pilote lui-même. Nous nous souvenons qu'il serait bon d'utiliser un DaemonSet pour copier les fichiers du pilote, qui connecte un répertoire où se trouve le pilote. Après la copie des fichiers nécessaires, le pod rook ne meurt pas, mais se connecte au socket IPC via le volume monté en tant que véritable serveur RPC. Le paquet ceph-common est déjà installé à l'intérieur du conteneur du pod. Le socket IPC garantit que kubelet communique bien avec le pod qui se trouve dans le même nœud. Tout ce qui est génial est simple !...
Au revoir, nos doux… plugins in-tree !
Les développeurs de Kubernetes ont découvert que le nombre de plugins de stockage dans le noyau s'élève à vingt. Et chaque changement dans l'un d'eux passe, d'une manière ou d'une autre, par le cycle de publication complet de Kubernetes.
Il s'avère que pour utiliser la nouvelle version du plugin de stockage, il faut mettre à jour l'ensemble du cluster. De plus, vous pourriez être surpris que la nouvelle version de Kubernetes devienne soudainement incompatible avec le noyau Linux utilisé... Et donc, vous essuyez vos larmes et, grincant des dents, vous convenez avec votre direction et les utilisateurs du moment pour mettre à jour le noyau Linux et le cluster Kubernetes, avec un éventuel temps d'arrêt dans la fourniture des services.
La situation est plus qu'ironique, n'est-ce pas ? Toute la communauté a compris que cette approche ne fonctionne pas. Par une décision ferme, les développeurs de Kubernetes annoncent que les nouveaux plugins pour le stockage ne seront plus acceptés dans le noyau. De plus, comme nous le savons déjà, un certain nombre de défauts ont été identifiés dans la mise en œuvre du plugin Flexvolume...
Pour clore une fois pour toutes la question des stockages de données persistants, le dernier plugin ajouté pour les volumes dans Kubernetes devait être le CSI. Sa version alpha, plus largement appelée Out-of-Tree CSI Volume Plugins, a été annoncée dans la version .
Container Storage Interface, ou le fameux CSI 3000 !
Tout d'abord, il convient de noter que le CSI n'est pas simplement un plugin de volume, mais un véritable pour la création de composants personnalisés pour le stockage de données.Il était prévu que les systèmes de gestion des conteneurs, tels que Kubernetes et Mesos, devaient 'apprendre' à travailler avec les composants réalisés selon cette norme. Et voilà, Kubernetes a déjà appris.
Quel est donc le fonctionnement du plugin CSI dans Kubernetes ? Le plugin CSI fonctionne avec des pilotes spéciaux (drivers CSI), écrits par des développeurs tiers. Le driver CSI dans Kubernetes doit au minimum se composer de deux composants (pods) :
- Contrôleur — gère les stockages persistants externes. Il est libéré sous la forme d'un serveur gRPC, pour lequel est utilisé le primitive
StatefulSet. - Nœud — répond aux montages de stockages persistants aux nœuds du cluster. Il est également réalisé sous la forme d'un serveur gRPC, mais pour lui est utilisé le primitive
DaemonSet.
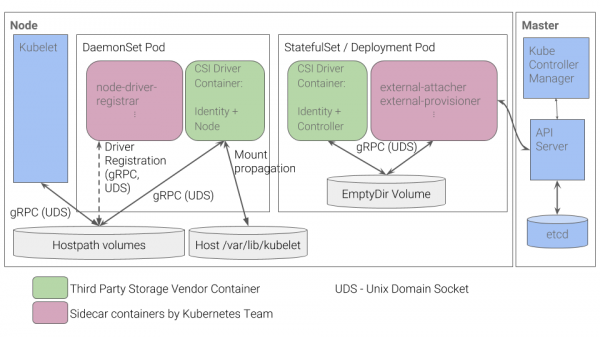
Schéma de fonctionnement du plugin CSI dans Kubernetes
Vous pouvez connaître certains autres détails sur le fonctionnement du CSI, par exemple, dans l'article «», a été publiée l'année dernière.
Les avantages de cette mise en œuvre
- Pour les choses basiques – par exemple, pour l'enregistrement d'un pilote pour un nœud – les développeurs de Kubernetes ont mis en œuvre un ensemble de conteneurs. Il n'est plus nécessaire de former soi-même la réponse JSON avec les capacités, comme cela se faisait pour le plugin Flexvolume.
- Au lieu de «sous-délivrer» des fichiers exécutables sur les nœuds, nous déployons maintenant des pods dans le cluster. C'est ce que nous attendons de Kubernetes : tous les processus se déroulent à l'intérieur des conteneurs, déployés à l'aide des primitives de Kubernetes.
- Pour la réalisation de pilotes complexes, il n'est plus nécessaire de développer un serveur RPC et un client RPC. Les développeurs de Kubernetes l'ont fait pour nous.
- Le passage d'arguments pour le travail avec le protocole gRPC est beaucoup plus pratique, flexible et fiable que leur passage via des arguments de ligne de commande. Pour comprendre comment ajouter le support des métriques d'utilisation des volumes dans CSI en ajoutant une méthode gRPC standardisée, vous pouvez consulter pour le pilote vsphere-csi.
- La communication se fait par des sockets IPC, afin de ne pas se perdre dans le pod auquel kubelet a envoyé la requête.
Cette liste ne vous rappelle-t-elle rien ? Les avantages de CSI sont la solution de ces problèmes, qui n'ont pas été pris en compte lors du développement du plugin Flexvolume.
Conclusions
CSI, en tant que norme pour la mise en œuvre de plugins personnalisés pour interagir avec les systèmes de stockage, a été accueillie très chaleureusement par la communauté. De plus, grâce à ses avantages et sa polyvalence, des pilotes CSI sont créés même pour des systèmes de stockage comme Ceph ou AWS EBS, dont les plugins ont été ajoutés dès la première version de Kubernetes.
Au début de 2019, les plugins in-tree Il est prévu de continuer à supporter le plugin Flexvolume, mais aucun nouveau développement de fonctionnalités pour celui-ci ne sera entrepris.
Nous avons déjà de l'expérience avec ceph-csi, vsphere-csi et nous sommes prêts à compléter cette liste ! Pour l'instant, CSI s'acquitte de ses tâches avec brio, et nous verrons par la suite.
N'oubliez pas que tout nouveau est un ancien bien repensé !
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
