

Le sujet du monorepo a déjà été discuté à plusieurs reprises et, en général, suscite des débats assez animés. En créant un outil Open Source destiné à améliorer lesprocessus de construction de code d'applications à partir de Git en images Docker (et leur livraison subséquente dans Kubernetes), nous réfléchissons peu à la question de savoir quel choix est le meilleur. Pour nous, il est prioritaire de fournir tout ce qu'il faut pour les partisans de différents avis (si cela ne contredit pas le bon sens, bien sûr).
La récente prise en charge du mono-repo dans werf en est un bon exemple. Mais d'abord, clarifions comment cette prise en charge est liée à l'utilisation de werf et quel est le rapport avec Docker Registry...
Problématique
Imaginons une telle situation. Dans une entreprise, plusieurs équipes de développeurs travaillent sur des projets indépendants. La majorité des applications fonctionnent dans Kubernetes, et donc — sont conteneurisées. Pour stocker les conteneurs et les images, il faut un registre (registry). Dans cette entreprise, Docker Hub est utilisé avec un seul compte COMPANY. Par analogie avec la plupart des systèmes de stockage de code source, Docker Hub ne permet pas de créer une hiérarchie imbriquée de dépôts, comme COMPANY/PROJECT/IMAGE. Dans ce cas... comment gérer cette limitation pour stocker des applications non monolithiques dans le registre sans créer un compte séparé pour chaque projet ?
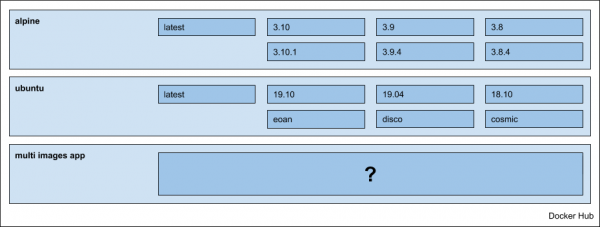
Peut-être que la situation décrite est familière à certains, mais examinons la question de l'organisation du stockage des applications en général, c'est-à-dire sans se limiter à l'exemple mentionné ci-dessus et à Docker Hub.
Voies de solution
Si l'application est monolithique, livrée dans une seule image, il n'y a pas de questions et nous sauvegardons simplement les images dans le registre des conteneurs du projet.
Quand l'application est présentée sous la forme de plusieurs composants, microservices, il faut choisir une approche définie. Prenons l'exemple d'une application web typique, composée de deux images : frontend et backend — les options possibles sont :
- Stocker les images dans des dépôts imbriqués séparés :

- Tout conserver dans un seul dépôt, en considérant le nom de l'image dans le tag, par exemple, comme suit :

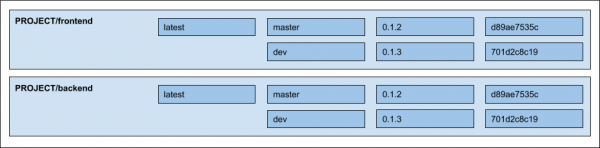
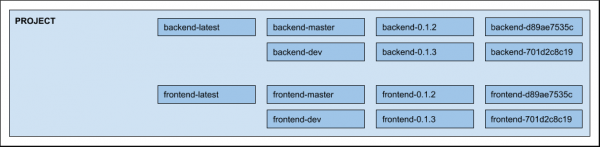
NB: En fait, il existe encore une option avec le stockage dans différents dépôts, PROJECT-frontend et PROJECT-backend, mais nous ne la considérerons pas en raison de la complexité de la prise en charge, de l'organisation et de la distribution des droits entre les utilisateurs.
Prise en charge dans werf
À l'origine, werf se limitait aux dépôts imbriqués, ce qui est pratique étant donné que la plupart des registres supportent cette fonctionnalité. À partir de la version , le support des registres où l'imbrication n'est pas prise en charge, y compris Docker Hub, a été ajouté. Dès lors, l'utilisateur a eu le choix de la manière de stocker les images de l'application.
L'implémentation est disponible via l'option --images-repo-mode=multirepo|monorepo (par défaut, multirepo, c'est-à-dire le stockage dans des dépôts imbriqués). Elle définit les modèles selon lesquels les images sont stockées dans le registre. Il suffit de choisir le mode approprié lors de l'utilisation des commandes principales, tout le reste restant inchangé.
Étant donné que la plupart des options de werf peuvent être définies par des variables d'environnement, dans les systèmes CI/CD, le mode de stockage est généralement facilement configuré de manière globale pour l'ensemble du projet. Par exemple, dans le cas de GitLab, il suffit d'ajouter une variable d'environnement dans les paramètres du projet : Réglages -> CI / CD -> Variables : WERF_IMAGES_REPO_MODE: multirepo|monorepo.
Concernant la publication des images et le déploiement des applications (ces processus sont expliqués en détail dans les articles correspondants de la documentation : et ), le mode détermine exclusivement le modèle utilisé pour travailler avec l'image.
Le diable est dans les détails
La différence et la principale difficulté lors de l'ajout d'un nouveau mode de stockage se trouvent dans le processus de nettoyage du registre (pour plus d'informations sur les capacités de nettoyage prises en charge par werf, voir ).
Lors du nettoyage, werf prend en compte les images utilisées dans les clusters Kubernetes, ainsi que les politiques définies par l'utilisateur. La base des politiques repose sur la division des balises en stratégies. Les stratégies actuellement prises en charge sont :
- 3 stratégies liées aux primitives Git, telles que la balise, la branche et le commit ;
- 1 stratégie pour les balises utilisateur arbitraires.
Les informations concernant la stratégie de balise sont conservées lors de la publication de l'image dans les labels de l'image finale. La valeur elle-même — le soi-disant métatag — est nécessaire pour l'application de certaines politiques. Par exemple, il est logique de supprimer les images non utilisées du registre lors de la suppression d'une branche ou d'une balise dans le dépôt Git, ce que couvre une partie de nos politiques.
Lors de la sauvegarde dans un même dépôt (monorepo), outre le métatag, le nom de l'image peut également être stocké dans la balise de l'image : PROJET :frontend-META-TAG. Pour les séparer, nous n'avons pas introduit de séparateur spécifique, mais avons simplement ajouté la valeur nécessaire dans l'étiquette de l'image finale lors de la publication.
NBSi vous souhaitez voir tout ce qui est décrit dans le code source de werf, le point de départ peut être .
Dans cet article, nous ne nous attarderons pas davantage sur la problématique et la justification de notre approche : des stratégies d'étiquetage, du stockage des données dans les étiquettes et du processus de publication en général — tout cela a été décrit en détail dans le récent rapport de Dmitri Stolyarov : «».
En résumé
L'absence de prise en charge des registres non imbriqués n'était pas un facteur bloquant pour nous ou pour les utilisateurs de werf que nous connaissons — il est toujours possible de créer un registre d'images séparé (ou de passer à un registre de conteneurs dans Google Cloud)... Cependant, lever une telle limitation semblait logique pour rendre l'outil plus pratique pour une communauté DevOps plus large. En réalisant cela, nous avons été confrontés à la principale difficulté de la refonte du mécanisme de nettoyage du registre de conteneurs. Maintenant que tout est prêt, c'est agréable de savoir que cela a facilité les choses pour quelqu'un, et nous (en tant que principaux développeurs du projet) ne prévoyons pas de difficultés majeures dans le support futur de cette fonctionnalité.
Restez avec nous et très bientôt nous parlerons des autres nouveautés dans !
P.S.
Lisez aussi dans notre blog :
- «»;
- «».
Source : habr.com
