

Beaucoup utilisent des outils spécialisés pour créer des procédures d'extraction, de transformation et de chargement de données dans des bases de données relationnelles. Le processus de travail des outils est enregistré, et les erreurs sont documentées.
En cas d'erreur, le journal contient des informations sur les raisons pour lesquelles l'outil n'a pas réussi à exécuter la tâche et quels modules (souvent en java) se sont arrêtés. Dans les dernières lignes, on peut trouver l'erreur de la base de données, par exemple, une violation de clé unique dans la table.
Pour répondre à la question du rôle des informations d'erreurs ETL, j'ai classé tous les problèmes survenus au cours des deux dernières années dans un grand entrepôt.
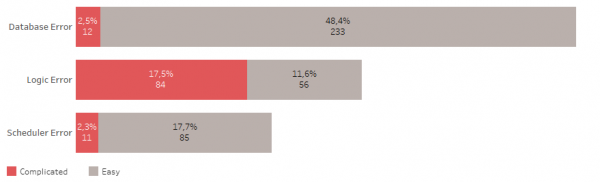
Les erreurs de base de données comprennent des problèmes tels que le manque d'espace, la rupture de connexion, une session suspendue, etc.
Les erreurs logiques comprennent des problèmes tels que les violations de clés de table, des objets non valides, l'absence d'accès aux objets, etc.
Le planificateur peut ne pas être lancé à temps, peut se bloquer, etc.
Les erreurs simples ne nécessitent pas beaucoup de temps pour être corrigées. La plupart d'entre elles peuvent être gérées automatiquement par un bon ETL.
Les erreurs complexes nécessitent d'ouvrir et de vérifier les procédures de traitement des données, d'explorer les sources de données. Elles entraînent souvent des tests des modifications et des déploiements.
Ainsi, la moitié de tous les problèmes est liée à la base de données. 48 % de toutes les erreurs sont des erreurs simples.
Un tiers de tous les problèmes est lié à des modifications de la logique ou du modèle de l'entrepôt, et plus de la moitié de ces erreurs sont complexes.
Moins d'un quart de tous les problèmes sont liés au planificateur de tâches, dont 18 % sont des erreurs simples.
En général, 22 % des erreurs survenues sont complexes, leur correction nécessite le plus d'attention et de temps. Elles se produisent environ une fois par semaine. Pendant ce temps, les erreurs simples se produisent presque tous les jours.
Il est évident que le suivi des processus ETL sera efficace lorsque le journal indique de manière aussi précise que possible l'emplacement de l'erreur et nécessite un minimum de temps pour localiser la source du problème.
Suivi efficace
Qu'aimerais-je voir dans le processus de suivi ETL ?
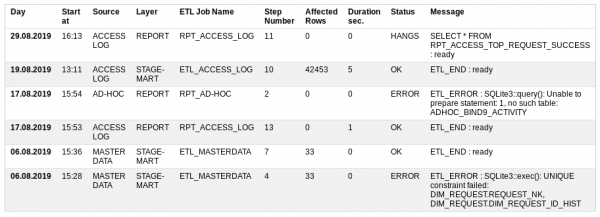
Start at — quand le travail a commencé,
Source — source de données,
Layer — quel niveau d'entrepôt est chargé,
ETL Job Name — procédure de chargement, composée de nombreuses petites étapes,
Step Number — numéro de l'étape actuellement exécutée,
Lignes affectées — combien de données ont déjà été traitées,
Durée sec — combien de temps cela prend,
Statut — tout va bien ou non : OK, ERREUR, EN COURS, BLOQUÉ
Message — dernier message réussi ou description de l'erreur.
Sur la base du statut des enregistrements, il est possible d'envoyer un e-mail aux autres participants. S'il n'y a pas d'erreurs, l'e-mail n'est pas nécessaire.
Ainsi, en cas d'erreur, l'endroit exact où cela s'est produit est clairement indiqué.
Il arrive parfois que l'outil de surveillance lui-même ne fonctionne pas. Dans ce cas, il est possible d'appeler directement dans la base de données la vue sur laquelle le rapport est basé.
Table de surveillance ETL
Pour mettre en place la surveillance des processus ETL, une seule table et une seule vue sont suffisantes.
Pour cela, on peut revenir dans et créer un prototype dans une base de données SQLite.
DDL de la table
CREATE TABLE UTL_JOB_STATUS (

/* Table pour l'enregistrement du journal d'exécution des tâches. Important que la tâche ait les étapes ETL_START et ETL_END ou ETL_ERROR */
  UTL_JOB_STATUS_ID INTEGER NOT NULL PRIMARY KEY AUTOINCREMENT,
  SID               INTEGER NOT NULL DEFAULT -1, /* Identificateur de session. Unique pour chaque Exécution de tâche */
  LOG_DT            INTEGER NOT NULL DEFAULT 0,  /* Date et heure */
  LOG_D             INTEGER NOT NULL DEFAULT 0,  /* Date */
  JOB_NAME          TEXT NOT NULL DEFAULT 'N/A', /* Nom de la tâche comme JOB_STG2DM_GEO */
  STEP_NAME         TEXT NOT NULL DEFAULT 'N/A', /* ETL_START, ..., ETL_END/ETL_ERROR */
  STEP_DESCR        TEXT,                        /* Description de la tâche ou message d'erreur */
  UNIQUE (SID, JOB_NAME, STEP_NAME)
);
INSERT INTO UTL_JOB_STATUS (UTL_JOB_STATUS_ID) VALUES (-1);
DDL de la vue/rapport
CRÉER UNE VUE SI NON EXISTE UTL_JOB_STATUS_V
EN TANT QUE
/* Contenu : Journal d'exécution du package pour les 3 derniers mois. */
AVEC SRC COMME (
  SÉLECTIONNER LOG_D,
    LOG_DT,
    UTL_JOB_STATUS_ID,
    SID,
	CASE WHEN INSTR(JOB_NAME, 'FTP') THEN 'TRANSFERT' /* transfert de fichier */
	     WHEN INSTR(JOB_NAME, 'STG') THEN 'STAGE' /* étape */
	     WHEN INSTR(JOB_NAME, 'CLS') THEN 'NETTOYAGE' /* nettoyage */
	     WHEN INSTR(JOB_NAME, 'DIM') THEN 'DIMENSION' /* dimension */
	     WHEN INSTR(JOB_NAME, 'FCT') THEN 'FAIT' /* fait */
		 WHEN INSTR(JOB_NAME, 'ETL') THEN 'STAGE-MART' /* mart de données */
	     WHEN INSTR(JOB_NAME, 'RPT') THEN 'RAPPORT' /* rapport */
	     ELSE 'N/A' END AS COUCHE,
	CASE WHEN INSTR(JOB_NAME, 'ACCESS') THEN 'LOG D’ACCÈS' /* source */
	     WHEN INSTR(JOB_NAME, 'MASTER') THEN 'DONNÉES MAÎTRES' /* source */
	     WHEN INSTR(JOB_NAME, 'AD-HOC') THEN 'AD-HOC' /* source */
	     ELSE 'N/A' END AS SOURCE,
    JOB_NAME,
    STEP_NAME,
    CASE WHEN STEP_NAME='ETL_START' THEN 1 ELSE 0 END AS START_FLAG,
    CASE WHEN STEP_NAME='ETL_END' THEN 1 ELSE 0 END AS END_FLAG,
    CASE WHEN STEP_NAME='ETL_ERROR' THEN 1 ELSE 0 END AS ERROR_FLAG,
    STEP_NAME || ' : ' || STEP_DESCR AS STEP_LOG,
	SUBSTR( SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), 1, INSTR(SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), '***')-2 ) AS AFFECTED_ROWS
  DE UTL_JOB_STATUS
  OÙ datetime(LOG_D, 'unixepoch') >= date('now', 'start of month', '-3 month')
)
SÉLECTIONNER JB.SID,
  JB.MIN_LOG_DT COMME START_DT,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) AS LOG_DT,
  JB.SOURCE,
  JB.COUCHE,
  JB.JOB_NAME,
  CASE
  QUAND JB.ERROR_FLAG = 1 ALORS 'ERREUR'
  QUAND JB.ERROR_FLAG = 0 ET JB.END_FLAG = 0 ET strftime('%s','now') - JB.MIN_LOG_DT > 0.5*60*60 ALORS 'EN ATTENTE' /* une demi-heure */
  QUAND JB.ERROR_FLAG = 0 ET JB.END_FLAG = 0 ALORS 'EN COURS'
  SINON 'OK'
  FIN AS STATUT,
  ERR.STEP_LOG     AS STEP_LOG,
  JB.CNT           AS STEP_CNT,
  JB.AFFECTED_ROWS AS AFFECTED_ROWS,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) AS JOB_START_DT,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MAX_LOG_DT, 'unixepoch')) AS JOB_END_DT,
  JB.MAX_LOG_DT - JB.MIN_LOG_DT AS JOB_DURATION_SEC
DE
  ( SÉLECTIONNER SID, SOURCE, COUCHE, JOB_NAME,
           MAX(UTL_JOB_STATUS_ID) COMME UTL_JOB_STATUS_ID,
           MAX(START_FLAG)       COMME START_FLAG,
           MAX(END_FLAG)         COMME END_FLAG,
           MAX(ERROR_FLAG)       COMME ERROR_FLAG,
           MIN(LOG_DT)           COMME MIN_LOG_DT,
           MAX(LOG_DT)           COMME MAX_LOG_DT,
           SOMME(1)                COMME CNT,
           SOMME(IFNULL(AFFECTED_ROWS, 0)) COMME AFFECTED_ROWS
    DE SRC
    GROUPE PAR SID, SOURCE, COUCHE, JOB_NAME
  ) JB,
  ( SÉLECTIONNER UTL_JOB_STATUS_ID, SID, JOB_NAME, STEP_LOG
    DE SRC
    OÙ 1 = 1
  ) ERR
OÙ 1 = 1
  ET JB.SID = ERR.SID
  ET JB.JOB_NAME = ERR.JOB_NAME
  ET JB.UTL_JOB_STATUS_ID = ERR.UTL_JOB_STATUS_ID
ORDER BY JB.MIN_LOG_DT DESC, JB.SID DESC, JB.SOURCE;
Vérification SQL de la possibilité d'obtenir un nouveau numéro de session
SÉLECTIONNER SOMME (
  CASE QUAND start_job.JOB_NAME EST NON NULL ET end_job.JOB_NAME EST NULL /* emploi existant terminé */
	    ET NON ( 'y' = 'n' ) /* redémarrer de force PARAMÈTRE */
       ALORS 1 SINON 0
  FIN ) COMME IS_RUNNING
  DE
    ( SÉLECTIONNER 1 COMME dummy DE UTL_JOB_STATUS OÙ sid = -1) d_job
  JOINDRE EXTÉRIEUR GAUCHE
    ( SÉLECTIONNER JOB_NAME, SID, 1 COMME dummy
      DE UTL_JOB_STATUS
      OÙ JOB_NAME = 'RPT_ACCESS_LOG' /* nom de job PARAMÈTRE */
	    ET STEP_NAME = 'ETL_START'
      GROUPE PAR JOB_NAME, SID
    ) start_job /* démarre */
  SUR d_job.dummy = start_job.dummy
  JOINDRE EXTÉRIEUR GAUCHE
    ( SÉLECTIONNER JOB_NAME, SID
      DE UTL_JOB_STATUS
      OÙ JOB_NAME = 'RPT_ACCESS_LOG' /* nom de job PARAMÈTRE */
	    ET STEP_NAME IN ('ETL_END', 'ETL_ERROR') /* statut d'arrêt */
      GROUPE PAR JOB_NAME, SID
    ) end_job /* termine */
  SUR start_job.JOB_NAME = end_job.JOB_NAME
     ET start_job.SID = end_job.SID
Caractéristiques de la table :
- Le début et la fin de la procédure de traitement des données doivent être accompagnés des étapes ETL_START et ETL_END
- En cas d'erreur, une étape ETL_ERROR doit être créée avec sa description
- Le nombre de données traitées doit être mis en évidence, par exemple, par des astérisques
- La même procédure peut être lancée simultanément avec le paramètre force_restart=y, sans cela, le numéro de session n'est fourni qu'à la procédure terminée
- En mode normal, il n'est pas possible de lancer simultanément la même procédure de traitement des données
Les opérations nécessaires pour travailler avec la table sont les suivantes :
- Obtenir le numéro de session de la procédure ETL en cours d'exécution
- Insérer un enregistrement de log dans la table
- Obtenir le dernier enregistrement réussi de la procédure ETL
Dans des bases de données comme Oracle ou Postgres, ces opérations peuvent être réalisées à l'aide de fonctions intégrées. Pour SQLite, un mécanisme externe est nécessaire et dans ce cas, il .
Sortie
Ainsi, les messages d'erreur dans les outils de traitement des données jouent un rôle méga-important. Mais il est difficile de les qualifier d'optimaux pour une recherche rapide de la cause du problème. Lorsque le nombre de procédures approche la centaine, la surveillance des processus devient un projet complexe.
L'article présente un exemple d'une possible solution au problème sous la forme d'un prototype. L'ensemble du prototype d'un petit entrepôt est disponible sur GitLab .
Source : habr.com
