

En mai de cette année, j'ai participé en tant que joueur à . J'ai remarqué que lorsque le nombre de joueurs atteignait un certain seuil, une partie d'entre eux se "déconnectait" toutes les quelques minutes. Hélas pour vous (mais pas pour moi), j'étais l'un de ces joueurs qui se déconnectaient à chaque fois, même avec une bonne connexion. J'ai considéré cela comme un défi personnel et j'ai commencé à chercher les raisons du problème. Après trois semaines de débogage, de tests et de corrections, l'erreur a enfin été résolue, mais ce voyage n'a pas été si simple.
Les problèmes des jeux multijoueurs sont très difficiles à suivre. Ils surviennent généralement dans des conditions très spécifiques de réseau et dans des états de jeu très particuliers (dans ce cas, la présence de plus de 200 joueurs). Et même lorsque l'on parvient à reproduire le problème, il est impossible de le déboguer correctement, car l'insertion de points de contrôle interrompt le jeu, perturbe les minuteries et entraîne généralement la perte de connexion à cause d'un dépassement de délai. Mais grâce à la persévérance et à un outil remarquable appelé , j'ai réussi à comprendre ce qui se passe.
En résumé : en raison d'une erreur et d'une mise en œuvre incomplète de la simulation de l'état de latence, le client se retrouvait parfois dans une situation où il devait envoyer, en un seul tour, un paquet réseau contenant des actions de choix d'environ 400 entités de jeu (que nous appelons "méga-paquet"). Ensuite, le serveur ne devait pas seulement recevoir correctement toutes ces actions d'entrée, mais aussi les transmettre à tous les autres clients. Si vous avez 200 clients, cela devient rapidement problématique. Le canal vers le serveur se bloque rapidement, entraînant une perte de paquets et un cascade de paquets redemandés. Le retard des actions d'entrée conduit alors encore plus de clients à envoyer des méga-paquets, et leur avalanche devient encore plus forte. Les clients chanceux parviennent à se rétablir, mais tous les autres "se déconnectent".
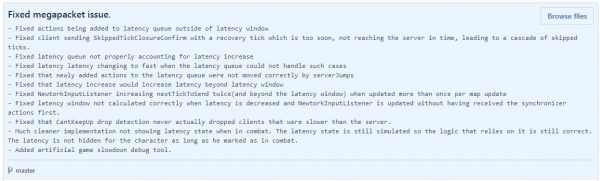
Le problème était assez fondamental, et il m'a fallu deux semaines pour le résoudre. C'est plutôt technique, donc je vais expliquer les détails techniques succulents ci-dessous. Mais d'abord, vous devez savoir qu'à partir de la version 0.17.54, publiée le 4 juin, le multijoueur est devenu plus stable en cas de problèmes de connexion temporaires, et la dissimulation des délais est bien moins buggée (moins de ralentissements et de téléportations). De plus, j'ai modifié la manière de masquer les délais pendant le combat et j'espère qu'ils seront un peu plus fluides grâce à cela.
Méga pack multijoueur — détails techniques
Pour expliquer de manière simplifiée, le multijoueur dans le jeu fonctionne comme suit : tous les clients simulent l'état du jeu, recevant et envoyant uniquement les entrées des joueurs (appelées « actions d'entrée », Input Actions). La tâche principale du serveur est de transmettre Input Actions et de contrôler que tous les clients effectuent les mêmes actions au même tour. Vous pouvez en lire plus dans le post .
Comme le serveur doit prendre des décisions sur les actions à effectuer, l'action du joueur suit à peu près ce chemin : action du joueur -> client de jeu -> réseau -> serveur -> réseau -> client de jeu. Cela signifie que chaque action du joueur n'est effectuée qu'après avoir effectué un aller-retour par le réseau. À cause de cela, le jeu semblerait horriblement lent, donc presque immédiatement après l'introduction du multijoueur, un mécanisme de dissimulation des délais a été mis en place. La dissimulation des délais imite l'entrée du joueur indépendamment des actions des autres joueurs et des décisions du serveur.
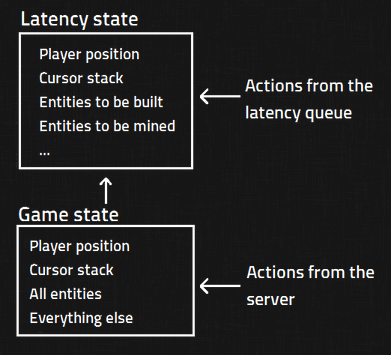
Dans Factorio, il existe un état de jeu Game State — c'est l'état complet de la carte, du joueur, des entités et de tout le reste. Il est déterminé et simulé dans tous les clients sur la base des actions reçues du serveur. L'état du jeu est sacré, et s'il commence un jour à différer de celui du serveur ou de tout autre client, une désynchronisation se produit.
En outre Game State nous avons un état de latence Latency State. Il contient un petit sous-ensemble de l'état principal. Latency State il n'est pas sacré et représente simplement une image de ce à quoi ressemblera l'état du jeu à l'avenir sur la base des entrées du joueur Input Actions.
Pour cela, nous conservons une copie des Input Actions dans la file d'attente des délais.
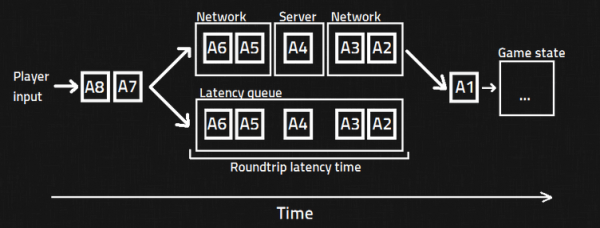
À la fin du processus, du côté du client, l'image ressemble à peu près à cela :
- Appliquons Input Actions à tous les joueurs Game State de la manière dont ces actions d'entrée ont été reçues du serveur.
- Nous supprimons de la file d'attente des délais tous les Input Actions, qui, selon les données du serveur, ont déjà été appliqués à Game State.
- Nous supprimons Latency State et le réinitialisons pour qu'il ressemble exactement à Game State.
- Nous appliquons toutes les actions de la file d'attente des délais à Latency State.
- Sur la base des données Game State et Latency State nous rendons le jeu au joueur.
Tout cela se répète à chaque tick.
Trop compliqué ? Ne vous détendez pas, ce n'est pas tout. Pour compenser l'instabilité des connexions Internet, nous avons créé deux mécanismes :
- Ticks manqués : lorsque le serveur décide que Input Actions seront exécutés dans le tick du jeu, si jamais il n'a pas reçu Input Actions d'un joueur (par exemple, en raison d'une augmentation de la latence), il ne va pas attendre, mais informera ce client « je n'ai pas pris en compte tes Input Actions, j'essaierai de les ajouter au prochain tick ». Cela est fait pour que la mise à jour de la carte ne soit pas retardée pour tous les autres à cause des problèmes de connexion (ou d'ordinateur) d'un seul joueur. Il convient de noter que Input Actions ne sont pas ignorés, mais simplement reportés.
- La latence du trajet aller-retour complet : le serveur essaie de deviner quelle est la latence de transfert des données aller-retour entre le client et le serveur pour chaque client. Toutes les 5 secondes, il discute avec le client d'une nouvelle latence si nécessaire (en fonction de la façon dont la connexion a fonctionné dans le passé), et ajuste en conséquence la latence de transfert de données aller-retour.
Ces mécanismes en eux-mêmes sont assez simples, mais lorsqu'ils sont utilisés ensemble (ce qui se produit souvent en cas de problèmes de connexion), la logique du code devient difficile à gérer avec de nombreux cas particuliers. De plus, lorsque ces mécanismes entrent en jeu, le serveur et la file d'attente des délais doivent correctement implanter une Input Action appelé StopMovementInTheNextTick. Grâce à cela, en cas de problème de connexion, le personnage ne se mettra pas à courir tout seul (par exemple, sous un train).
Maintenant, il faut vous expliquer comment fonctionne la sélection des entités. Un des types transmis Input Action — il s'agit d'un changement d'état du choix d'une entité. Cela informe tout le monde sur l'entité sur laquelle le joueur a placé le curseur de la souris. Comme on peut le comprendre, il s'agit de l'une des actions d'entrée les plus fréquentes envoyées par les clients, c'est pourquoi, pour économiser la bande passante, nous l'avons optimisée afin qu'elle occupe le moins de place possible. Cela est réalisé de la manière suivante : lors de la sélection de chaque entité, au lieu de sauvegarder des coordonnées absolues et très précises sur la carte, le jeu conserve un décalage relatif imprécis par rapport à la sélection précédente. Cela fonctionne bien, car la sélection avec la souris se produit généralement très près de la sélection précédente. Cela entraîne deux exigences importantes : Input Actions il ne faut jamais les ignorer et il est nécessaire de les exécuter dans le bon ordre. Ces exigences sont satisfaites pour Game State. Mais puisque la tâche État de latence visant à « avoir l'air suffisamment bon » pour le joueur, dans un état de latence, elles ne sont pas satisfaites. Latency State ne prend pas en compte , liés à l'ignorance des cycles et aux variations de latence de transmission aller-retour.
Vous pouvez déjà deviner où cela mène. Enfin, nous commençons à voir les raisons du problème du mégapacket. La racine du problème réside dans le fait que, dans la prise de décision quant à la nécessité de transmettre l'action de changement de sélection, la logique de sélection d'entités repose sur Latency State, et cet état ne contient pas toujours les bonnes informations. C'est pourquoi le mégapacket est généré environ de cette manière :
- Le joueur a des problèmes de connexion.
- Des mécanismes d'ignorance des cycles et de régulation de la latence de transmission aller-retour entrent en jeu.
- La file d'état de latence ne prend pas en compte ces mécanismes. Cela entraîne la suppression prématurée de certaines actions ou leur exécution dans le mauvais ordre, ce qui entraîne une incorrecte Latency State.
- Le joueur n'a plus de problème de connexion et, pour rattraper le serveur, il simule jusqu'à 400 cycles.
- À chaque cycle, une nouvelle action de changement de sélection d'entité est générée et préparée pour être envoyée au serveur.
- Le client envoie au serveur un mégapacket de plus de 400 changements de sélection d'entités (et d'autres actions : l'état de tir, de marche, etc. ont également souffert de ce problème).
- Le serveur reçoit 400 actions d'entrée. Comme il n'est pas autorisé à ignorer aucune action d'entrée, il ordonne à tous les clients d'exécuter ces actions et les envoie sur le réseau.
L'ironie est que le mécanisme, censé économiser la bande passante, finissait par créer d'énormes paquets sur le réseau.
Nous avons résolu ce problème en corrigeant tous les cas limites de mise à jour et de gestion de la file d'attente des retards. Bien que cela ait pris beaucoup de temps, cela valait finalement la peine d'être mis en œuvre correctement plutôt que de se fier à des hacks rapides.
Source : habr.com
