

Bonjour à tous. Dans cet article, je vais vous expliquer pourquoi nous avons choisi Kafka chez Avito il y a neuf mois, et ce qu'elle représente. Je partagerai l'un des cas d'utilisation - le broker de messages. Enfin, nous aborderons les avantages que nous avons tirés de l'approche Kafka as a Service.
Le problème
Pour commencer, un peu de contexte. Il y a quelque temps, nous avons commencé à nous éloigner de l'architecture monolithique, et maintenant, chez Avito, il y a plusieurs centaines de services différents. Chacun d'eux a ses propres bases de données, sa propre pile technologique et est responsable de sa partie de la logique métier.
L'un des problèmes liés à un grand nombre de services est la communication. Le service A souhaite souvent connaître des informations détenues par le service B. Dans ce cas, le service A se tourne vers le service B via une API synchronisée. Le service C veut savoir ce qui se passe avec les services G et D, tandis que ceux-ci, à leur tour, s'intéressent aux services A et B. Lorsque ce genre de services 'curieux' devient nombreux, les connexions entre eux se transforment en un enchevêtrement complexe.
À tout moment, le service A peut devenir indisponible. Que doit alors faire le service B et tous les autres services qui en dépendent ? Et si, pour exécuter une opération commerciale, il faut effectuer une chaîne d'appels synchrones successifs, la probabilité que l'ensemble de l'opération échoue devient encore plus grande (et elle augmente avec la longueur de cette chaîne).
Choix de la technologie
Ok, les problèmes sont clairs. Nous pouvons les résoudre en créant un système centralisé d'échange de messages entre les services. Maintenant, chaque service n'a besoin de connaître que ce système d'échange de messages. De plus, le système doit être résistant aux pannes et pouvoir évoluer horizontalement, tout en accumulant un tampon des appels en cas de défaillance pour un traitement ultérieur.
Choisissons maintenant la technologie sur laquelle la livraison des messages sera réalisée. Pour cela, comprenons d'abord ce que nous en attendons :
- les messages entre les services ne doivent pas être perdus ;
- les messages peuvent être dupliqués ;
- les messages peuvent être stockés et lus sur plusieurs jours (tampon persistant) ;
- les services peuvent s'abonner aux données qui les intéressent ;
- plusieurs services peuvent lire les mêmes données ;
- les messages peuvent contenir une charge utile détaillée et volumineuse (event-carried state transfer) ;
- parfois, une garantie de l'ordre des messages est nécessaire.
Il était également crucial pour nous de choisir un système hautement évolutif et fiable avec une grande capacité de traitement (au moins 100k messages de plusieurs kilobytes par seconde).
À ce stade, nous avons dit adieu à RabbitMQ (difficile à maintenir stable à des RPS élevés), PGQ de SkyTools (pas assez rapide et mal évolutif) et NSQ (non persistant). Toutes ces technologies sont utilisées dans notre entreprise, mais elles n'étaient pas adaptées à la tâche à accomplir.
Nous avons ensuite commencé à explorer de nouvelles technologies pour nous : Apache Kafka, Apache Pulsar et NATS Streaming.
Nous avons d'abord écarté Pulsar. Nous avons décidé que Kafka et Pulsar sont des solutions assez semblables. Et même si Pulsar est éprouvé par de grandes entreprises, plus récent et offre une latence plus faible (en théorie), nous avons décidé de conserver Kafka parmi ces deux options, comme la norme de facto pour de telles tâches. Nous reviendrons probablement à Apache Pulsar à l'avenir.
Il nous restait donc deux candidats : NATS Streaming et Apache Kafka. Nous avons étudié les deux solutions en détail, et toutes deux répondaient à nos besoins. Mais au final, nous avons craint la relative jeunesse de NATS Streaming (et le fait que l'un des principaux développeurs, Tyler Treat, a décidé de quitter le projet pour commencer le sien — Liftbridge). De plus, le mode de clustering de NATS Streaming ne permettait pas un fort évolutivité horizontale (ce n'est probablement plus un problème depuis l'ajout du mode de partitionnement en 2017).
Cela dit, NATS Streaming est une technologie impressionnante, écrite en Go et soutenue par la Cloud Native Computing Foundation. Contrairement à Apache Kafka, elle n'a pas besoin de Zookeeper pour fonctionner (peut-être que ), car elle implémente le RAFT en interne. De plus, NATS Streaming est plus simple à administrer. Nous ne rejetons pas la possibilité de revenir à cette technologie à l'avenir.
Et pourtant, aujourd'hui, notre gagnant est Apache Kafka. Dans nos tests, elle s'est montrée suffisamment rapide (plus d'un million de messages par seconde pour la lecture et l'écriture avec un volume de messages de 1 kilobyte), assez fiable, bien évolutive et éprouvée en production par de grandes entreprises. De plus, Kafka est soutenue par au moins plusieurs grandes entreprises commerciales (nous utilisons par exemple la version de Confluent), et possède un écosystème bien développé.
Aperçu de Kafka
Avant de commencer, je recommande immédiatement un excellent livre — « Kafka: The Definitive Guide » (il existe aussi une traduction en russe, mais les termes peuvent être un peu déroutants). On y trouve des informations nécessaires pour une compréhension de base de Kafka et même un peu plus. La documentation d'Apache et le blog de Confluent sont également bien rédigés et faciles à lire.
Alors, examinons comment Kafka est structuré dans les grandes lignes. La topologie de base de Kafka se compose de producteurs, consommateurs, courtiers et zookeeper.
Courtier
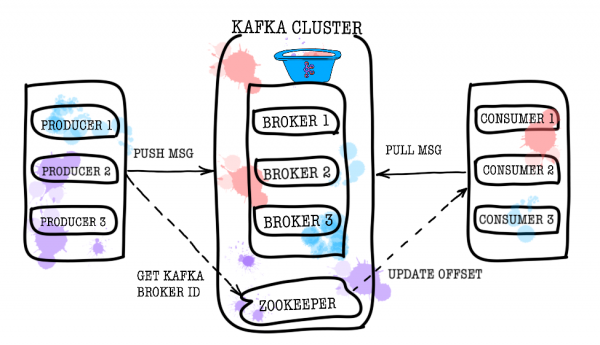
Le courtier (broker) est responsable de la conservation de vos données. Toutes les données sont stockées sous forme binaire, et le courtier sait peu de choses sur leur contenu et leur structure.
Chaque type logique d'événement se trouve généralement dans son propre topic. Par exemple, un événement de création d'annonce peut être envoyé au topic item.created, tandis qu'un événement de modification ira dans item.changed. Les topics peuvent être considérés comme des classificateurs d'événements. Au niveau du topic, vous pouvez définir des paramètres de configuration tels que :
- la taille des données stockées et/ou leur ancienneté (retention.bytes, retention.ms);
- le facteur de redondance des données (replication factor);
- la taille maximale d'un message (max.message.bytes);
- le nombre minimum de répliques synchronisées nécessaires pour écrire des données dans le topic (min.insync.replicas);
- la possibilité d'effectuer un basculement vers une réplique en retard non synchronisée avec une possible perte de données (unclean.leader.election.enable);
- et bien d'autres ().
Chaque topic est à son tour divisé en une ou plusieurs partitions. Ce sont dans ces partitions que les événements finissent par être stockés. S'il y a plus d'un courtier dans le cluster, les partitions seront réparties équitablement entre tous les courtiers (autant que possible), permettant ainsi de répartir la charge d'écriture et de lecture d'un topic sur plusieurs courtiers à la fois.
Sur le disque, les données de chaque partition sont stockées sous forme de fichiers segments, par défaut d'un gigaoctet chacun (contrôlé via log.segment.bytes). Une caractéristique importante est que la suppression de données des partitions (lorsque la rétention s'active) se fait par segments (un événement ne peut pas être supprimé d'une partition, seul un segment entier peut l'être, et uniquement s'il est inactif).
Zookeeper
Zookeeper joue le rôle de stockage des métadonnées et de coordinateur. C'est lui qui peut dire si les courtiers sont vivants (vous pouvez le voir avec zookeeper via la commande zookeeper-shell ls /brokers/ids), lequel des courtiers est le contrôleur (get /controller), les partitions sont-elles en état de synchronisation avec leurs répliques (get /brokers/topics/topic_name/partitions/partition_number/state). De plus, c'est d'abord vers zookeeper que le producer et le consumer se dirigeront pour savoir sur quel broker quels topics et partitions sont stockés. Dans les cas où un facteur de réplication supérieur à 1 est défini pour le topic, zookeeper indiquera quelles partitions sont les leaders (où l'écriture aura lieu et d'où la lecture sera également effectuée). En cas de défaillance d'un broker, c'est bien dans zookeeper que l'information sur les nouvelles partitions leaders sera enregistrée (depuis la version 1.1.0 de manière asynchrone, ).
Dans les versions plus anciennes de Kafka, zookeeper était également responsable du stockage des offsets, mais maintenant ils sont conservés dans un topic spécial __consumer_offsets sur le broker (bien que vous puissiez toujours utiliser zookeeper à ces fins).
Le moyen le plus simple de transformer vos données en citrouille est justement de perdre des informations avec zookeeper. Dans ce scénario, il sera très difficile de comprendre ce qu'il faut lire et d'où.
Producteur
Un Producteur est souvent un service qui enregistre directement des données dans Apache Kafka. Le Producteur choisit le topic dans lequel ses messages thématiques seront stockés et commence à y écrire des informations. Par exemple, un service de petites annonces pourrait être un producteur. Dans ce cas, il enverrait dans des topics thématiques des événements tels que "annonce créée", "annonce mise à jour", "annonce supprimée", etc. Chaque événement représente alors une paire clé-valeur.
Par défaut, tous les événements sont répartis dans les partitions du topic par round-robin si aucune clé n'est spécifiée (perdant l'ordre), et via MurmurHash (clé), si une clé est présente (maintenant l'ordre au sein d'une seule partition).
Il convient de noter ici que Kafka garantit l'ordre des événements uniquement au sein d'une seule partition. Mais en réalité, cela n'est souvent pas un problème. Par exemple, il est possible d'ajouter de manière garantie tous les changements d'une même annonce dans une seule partition (maintenant ainsi l'ordre de ces changements au sein de l'annonce). Il est également possible de transmettre un numéro de séquence dans l'un des champs de l'événement.
Consumer
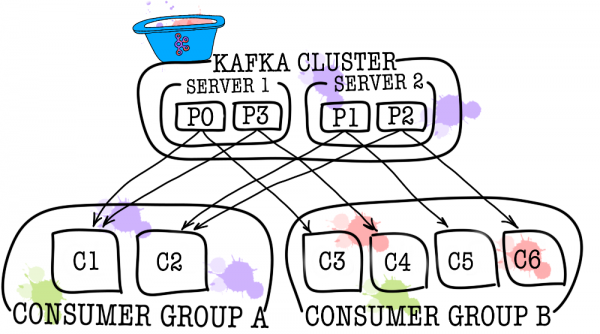
Le consumer est responsable de l'obtention des données depuis Apache Kafka. Pour revenir à l'exemple précédent, le consumer pourrait être un service de modération. Ce service sera abonné au topic du service d'annonces, et lorsqu'une nouvelle annonce apparaîtra, il la recevra et l'analysera en fonction de certaines politiques définies.
Apache Kafka mémorise quels sont les derniers événements reçus par le consumer (pour cela, un topic de service est utilisé __consumer__offsets), garantissant ainsi que lors d'une lecture réussie, le consumer ne recevra pas le même message deux fois. Cependant, si l'option enable.auto.commit = true est utilisée et que l'on confie entièrement le suivi de la position du consumer dans le topic à Kafka, il est possible de . Dans le code de production, la position du consumer est le plus souvent contrôlée manuellement (le développeur gère le moment où le commit de l'événement lu doit obligatoirement se produire).
Dans les cas où un seul consumer n'est pas suffisant (par exemple, si le flux de nouveaux événements est très important), il est possible d'ajouter plusieurs consumers, en les liant ensemble dans un groupe de consumers. Le groupe de consumers représente logiquement un consumer exactement de la même manière, mais avec la répartition des données entre les membres du groupe. Cela permet à chacun des participants de prendre sa part de messages, augmentant ainsi la vitesse de lecture.
Résultats des tests
Je ne vais pas écrire beaucoup de texte explicatif ici, je vais simplement partager les résultats obtenus. Les tests ont été réalisés sur 3 machines physiques (12 CPU, 384 Go de RAM, DISK SAS 15k, 10Gbit/s Net), les brokers et zookeeper ont été déployés dans lxc.
Tests de performance
Au cours des tests, les résultats suivants ont été obtenus.
- La vitesse d'écriture des messages de 1 Ko avec 9 producers simultanés — 1 300 000 événements par seconde.
- La vitesse de lecture des messages de 1 Ko avec 9 consumers simultanés — 1 500 000 événements par seconde.
Tests de résilience
Au cours des tests, les résultats suivants ont été obtenus (3 brokers, 3 zookeepers).
- L'arrêt inattendu de l'un des brokers n'entraîne pas l'arrêt ou l'indisponibilité du cluster. Le fonctionnement se poursuit normalement, mais la charge sur les brokers restants augmente.
- La terminaison anormale de deux courtiers dans un cluster de trois courtiers avec min.isr = 2 rend le cluster inaccessible pour l'écriture, mais accessible pour la lecture. Si min.isr = 1, le cluster reste accessible aussi bien pour la lecture que pour l'écriture. Cependant, ce mode contredit l'exigence de haute durabilité des données.
- La terminaison anormale d'un des serveurs Zookeeper ne conduit pas à l'arrêt ou à l'inaccessibilité du cluster. Le fonctionnement continue normalement.
- La terminaison anormale de deux serveurs Zookeeper rend le cluster inaccessible jusqu'à ce qu'au moins un des serveurs Zookeeper soit restauré. Cette affirmation est valable pour un cluster Zookeeper composé de 3 serveurs. En conséquence, après des recherches, il a été décidé d'augmenter le cluster Zookeeper à 5 serveurs pour améliorer la tolérance aux pannes.
Kafka en tant que service
Nous avons constaté que Kafka est une excellente technologie qui permet de résoudre le problème qui nous était posé (la mise en œuvre d'un courtier de messages). Néanmoins, nous avons décidé d'interdire aux services d'accéder directement à Kafka et l'avons fermé par-dessus avec le service data-bus. Pourquoi avons-nous fait cela ? En fait, il y a plusieurs raisons.
Le data-bus a pris en charge toutes les tâches liées à l'intégration avec Kafka (mise en œuvre et configuration des consommateurs et producteurs, surveillance, alertes, journalisation, scalabilité, etc.). Ainsi, l'intégration avec le courtier de messages se fait de manière extrêmement simple.
Le data-bus a permis de s'abstraire de la langue ou de la bibliothèque spécifique pour travailler avec Kafka.
Le data-bus a permis aux autres services de s'abstraire de la couche de stockage. Peut-être qu'à un moment donné, nous remplacerons Kafka par Pulsar, et à ce moment-là, personne ne s'en rendra compte (tous les services connaissent uniquement l'API du data-bus).
Le data-bus a pris en charge la validation des schémas d'événements.
Avec le data-bus, l'authentification a été mise en œuvre.
Sous la couverture du data-bus, nous pouvons mettre à jour les versions de Kafka sans temps d'arrêt, discrètement, gérer la configuration des producteurs, consommateurs, courtiers, etc.
Le data-bus a permis d'ajouter les fonctionnalités nécessaires qui ne sont pas présentes dans Kafka (telles que l'audit des sujets, le contrôle des anomalies dans le cluster, la création de DLQ, etc.).
Le data-bus permet de réaliser un basculement de manière centralisée pour tous les services.
Actuellement, pour commencer à envoyer des événements à un courtier de messages, il vous suffit de connecter une petite bibliothèque dans le code de votre service. C'est tout. Vous avez désormais la possibilité d'écrire, de lire et de vous développer avec une seule ligne de code. Toute l'implémentation est cachée de vous, seules quelques poignées, comme la taille du lot, sont visibles. Sous le capot, le service data-bus déploie dans Kubernetes le nombre nécessaire d'instances de producteurs et de consommateurs et leur fournit la configuration requise, mais tout cela reste transparent pour votre service.
Bien sûr, il n'existe pas de solution miracle, et cette approche présente ses propres limitations.
- Le data-bus doit être maintenu par vos propres moyens, contrairement aux bibliothèques tierces.
- Le data-bus augmente le nombre d'interactions entre les services et le courtier de messages, ce qui entraîne une diminution des performances par rapport à une utilisation directe de Kafka.
- Tout ne peut pas être caché si facilement aux services, nous ne souhaitons pas dupliquer les fonctionnalités de KSQL ou de Kafka Streams dans le data-bus, donc parfois, il est nécessaire de permettre aux services d'accéder directement.
Dans notre cas, les avantages ont prévalu sur les inconvénients, et la décision de masquer le courtier de messages derrière un service distinct s'est avérée judicieuse. En un an d'exploitation, nous n'avons rencontré aucun incident grave ni problème.
P.S. Merci à ma copine, Ekaterina Obalayeva, pour les superbes illustrations de cet article. Si elles vous ont plu, vous trouverez encore plus d'illustrations.
Source : habr.com
