

Source :
La régression linéaire est l'un des algorithmes de base pour de nombreux domaines liés à l'analyse des données. La raison en est évidente. C'est un algorithme très simple et compréhensible, ce qui favorise son large éventail d'applications depuis plusieurs décennies, voire des centaines d'années. L'idée est que nous supposons une dépendance linéaire d'une variable à un ensemble d'autres variables, puis nous tentons de reconstruire cette dépendance.
Cependant, cet article ne portera pas sur l'application de la régression linéaire pour résoudre des problèmes pratiques. Nous allons aborder les caractéristiques intéressantes de la mise en œuvre d'algorithmes distribués pour sa reconstruction, auxquelles nous avons été confrontés lors de l'écriture du module d'apprentissage automatique dans . Un peu de mathématiques de base, fondamentaux de l'apprentissage automatique et de l'informatique distribuée aideront à comprendre comment reconstruire la régression linéaire, même lorsque les données sont réparties entre des milliers de nœuds.
De quoi s'agit-il ?
Nous sommes confrontés à la tâche de restaurer une dépendance linéaire. Comme données d'entrée, nous avons un ensemble de vecteurs supposément indépendants, à chacun desquels est associé une certaine valeur d'une variable dépendante. Ces données peuvent être représentées sous forme de deux matrices :

Maintenant, puisque nous supposons une dépendance, et encore plus qu'elle est linéaire, exprimons notre hypothèse sous la forme d'un produit de matrices (pour simplifier l'écriture, ici et plus loin, il est supposé que le terme libre de l'équation est caché derrière  , et la dernière colonne de la matrice
 contient des uns) :

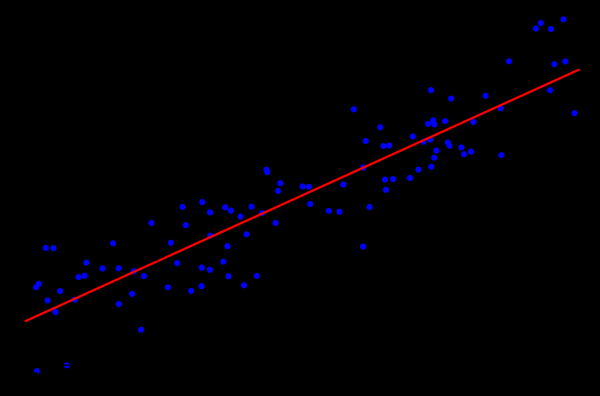
Cela ressemble beaucoup à un système d'équations linéaires, n'est-ce pas ? Cela y ressemble, mais cette système d'équations n'a probablement pas de solution. La raison en est le bruit, qui est présent dans presque toutes les données réelles. Une autre raison peut être l'absence même de dépendance linéaire, contre laquelle on pourrait essayer de lutter en introduisant des variables supplémentaires, dépendant de manière non linéaire des originales. Considérons l'exemple suivant :
Source :
C'est un exemple simple de régression linéaire qui démontre la dépendance d'une variable (sur l'axe  ) par rapport à une autre variable (sur l'axe
 ). Pour qu'un système d'équations linéaires tel que celui-ci ait une solution, tous les points doivent se situer exactement sur une même droite. Mais ce n'est pas le cas. Ils ne sont pas sur une même droite précisément à cause du bruit (ou parce que l'hypothèse d'une dépendance linéaire était erronée). Ainsi, pour restaurer la dépendance linéaire à partir de données réelles, il est généralement nécessaire d'introduire une autre hypothèse: les données d'entrée contiennent du bruit et ce bruit a . On peut faire des hypothèses sur d'autres types de distributions du bruit, mais dans la grande majorité des cas, on considère principalement la distribution normale, dont nous allons parler ci-dessous.
La méthode du maximum de vraisemblance
. Ainsi, nous avons supposé qu'il existe un bruit aléatoire distribué normalement. Que faire dans une telle situation ? En mathématiques, il existe et est largement utilisé . En bref, son essence réside dans le choix et sa maximisation ultérieure.
Revenons à la restauration de la dépendance linéaire à partir de données avec du bruit normal. Notons que la dépendance linéaire supposée est l'espérance mathématique  de la distribution normale existante. Parallèlement, la probabilité que
 prenne une certaine valeur, étant donné l'existence d'observations
 , est la suivante :

Remplaçons maintenant  et
 par les variables dont nous avons besoin :

Il ne reste plus qu'à trouver le vecteur  , pour lequel cette probabilité est maximale. Pour maximiser une telle fonction, il est pratique de la logarifmer d'abord (le logarithme de la fonction atteindra un maximum au même point que la fonction elle-même) :

Ce qui, à son tour, revient à minimiser la fonction suivante :

Au fait, cela s'appelle la méthode . Souvent, tous les raisonnements précédents sont omis et cette méthode est simplement utilisée.
Décomposition QR
Le minimum de la fonction mentionnée ci-dessus peut être trouvé en trouvant le point où le gradient de cette fonction est nul. Le gradient sera écrit comme suit :

est une méthode matricielle de résolution du problème de minimisation utilisée dans la méthode des moindres carrés. À cet égard, réécrivons l'équation sous forme matricielle :

Ainsi, nous décomposons la matrice  en matrices
 et
 et nous effectuons une série de transformations (l'algorithme QR ne sera pas abordé ici, seulement son utilisation dans le cadre du problème proposé) :

La matrice  est orthogonale. Cela nous permet d'éliminer le produit
 :

Et si nous remplaçons  sur
 , cela donnera
 . Étant donné que
 est une matrice triangulaire supérieure, cela se présente comme suit :

Cela peut être résolu par la méthode de substitution. L'élément  se trouve comme
 , l'élément précédent
 se trouve comme
 et ainsi de suite.
Il convient de noter que la complexité de l'algorithme obtenu grâce à l'utilisation de la décomposition QR est de  . Bien que l'opération de multiplication de matrices se parallélise bien, il n'est pas possible d'écrire une version distribuée efficace de cet algorithme.
Descente de gradient
En parlant de la minimisation d'une certaine fonction, il est toujours utile de se rappeler de la méthode (stochastique) de descente de gradient. C'est une méthode simple et efficace de minimisation, basée sur le calcul itératif du gradient de la fonction à un point puis de son décalage dans la direction opposée au gradient. Chaque pas rapproche la solution du minimum. Le gradient reste le même :

De plus, cette méthode se parallélise et se distribue bien en raison des propriétés linéaires de l'opérateur gradient. Notons que dans la formule ci-dessus, les termes sous le signe de somme sont indépendants. Autrement dit, nous pouvons calculer le gradient indépendamment pour tous les indices  de un à
 , parallèlement à cela, calculer le gradient pour les indices de
 à
 . Ensuite, nous additionnons les gradients obtenus. Le résultat de l'addition sera le même que si nous avions calculé directement le gradient pour les indices de un à
 . Ainsi, si les données sont réparties entre plusieurs parties, le gradient peut être calculé indépendamment sur chaque partie, puis les résultats de ces calculs peuvent être additionnés pour obtenir le résultat final :

Du point de vue de l'implémentation, cela s'inscrit dans la catégorie . À chaque étape de la descente de gradient, une tâche de calcul du gradient est envoyée à chaque nœud de données, puis les gradients calculés sont rassemblés et le résultat de leur addition est utilisé pour améliorer le résultat.
Malgré la simplicité de mise en œuvre et la possibilité d'exécution dans la paradigme MapReduce, la descente de gradient présente également des inconvénients. En particulier, le nombre d'étapes nécessaires pour atteindre la convergence est considérablement plus élevé par rapport à d'autres méthodes plus spécialisées.
LSQR
— une autre méthode pour résoudre le problème, qui convient tant à la restauration de la régression linéaire qu'à la résolution de systèmes d'équations linéaires. Sa principale caractéristique est qu'elle combine les avantages des méthodes matricielles et de l'approche itérative. Des implémentations de cette méthode peuvent être trouvées dans des bibliothèques , ainsi que dans . La description de cette méthode ne sera pas présentée ici (elle peut être trouvée dans l'article ). À la place, une approche sera démontrée pour adapter LSQR à l'exécution dans un environnement distribué.
La méthode LSQR repose sur . C'est une procédure itérative, chaque itération consistant en les étapes suivantes :
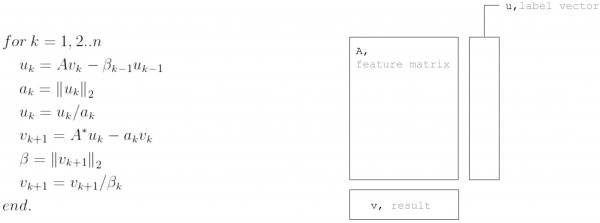
Mais si l'on considère que la matrice est  partitionnée horizontalement, alors chaque itération peut être représentée sous la forme de deux étapes MapReduce. Cela permet de minimiser les transferts de données à chaque itération (seuls les vecteurs de longueur égale au nombre d'inconnues) :
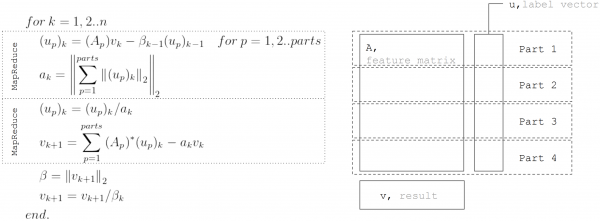
C'est cette approche qui est utilisée lors de la mise en œuvre de la régression linéaire dans .
Conclusion
Il existe de nombreux algorithmes pour restaurer la régression linéaire, mais tous ne peuvent pas être appliqués dans toutes les conditions. Ainsi, la décomposition QR convient parfaitement pour une résolution précise sur de petits ensembles de données. La descente de gradient est simple à mettre en œuvre et permet de trouver rapidement une solution approximative. Et LSQR combine les meilleures propriétés des deux algorithmes précédents, car il peut être distribué, converge plus rapidement par rapport à la descente de gradient, et permet également un arrêt précoce de l'algorithme, contrairement à la décomposition QR pour la recherche d'une solution approximative.
Source : habr.com
