

TL;DR
- Pour atteindre une haute observabilité des conteneurs et des microservices, les journaux et les métriques primaires ne suffisent pas.
- Pour une récupération plus rapide et une meilleure résilience, les applications doivent appliquer le Principe de Haute Observabilité (HOP, High Observability Principle).
- Au niveau de l'application, le HOP nécessite : une journalisation appropriée, une surveillance rigoureuse, des vérifications de disponibilité et des traces de performance/transitions.
- En tant qu'élément du HOP, utilisez les vérifications readinessProbe et livenessProbe Kubernetes.
Qu'est-ce qu'un Modèle de vérification de disponibilité ?
Lors de la conception d'une application critique et hautement disponible, il est très important de penser à un aspect tel que la résilience. Une application est considérée comme résiliente si elle se remet rapidement après une défaillance. Une application cloud typique utilise une architecture de microservices - chaque composant étant placé dans un conteneur séparé. Pour s'assurer que l'application sur k8s est hautement disponible, il est nécessaire de suivre certains modèles lors de la conception d'un cluster. Parmi eux se trouve le Modèle de vérification de disponibilité. Il définit comment l'application informe k8s de sa disponibilité. Il ne s'agit pas seulement d'une information sur le fait que le pod fonctionne, mais aussi sur la façon dont il traite et répond aux requêtes. Plus Kubernetes en sait sur la disponibilité d'un pod, plus il prend des décisions intelligentes quant à l'acheminement du trafic et à l'équilibrage de la charge. Ainsi, le Principe de Haute Observabilité permet à l'application de répondre en temps voulu aux requêtes.
Principe de Haute Observabilité (HOP)
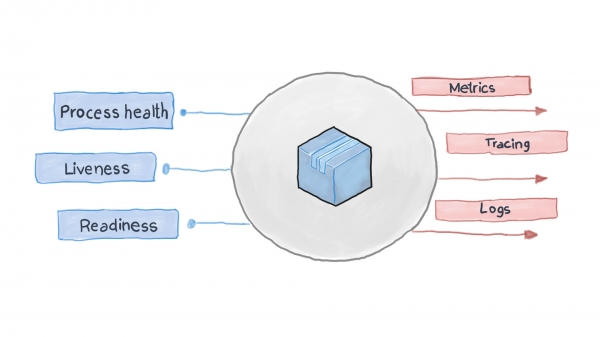
Le Principe de Haute Observabilité est l'un des Dans une architecture microservices, les services ne se soucient pas de la manière dont leur requête est traitée (et c'est la bonne approche), mais il est important de savoir comment obtenir des réponses des services récepteurs. Par exemple, pour l'authentification d'un utilisateur, un conteneur envoie une requête HTTP à un autre, en attendant une réponse dans un certain format : c'est tout. Une requête peut être traitée en PythonJS et la réponse peut être fournie en Python Flask. Les conteneurs sont comme des boîtes noires avec un contenu caché. Cependant, le principe de la santé opérationnelle exige que chaque service révèle plusieurs points de terminaison API, montrant son niveau de fonctionnement ainsi que son état de préparation et de tolérance aux pannes. Ces indicateurs sont demandés par Kubernetes afin de planifier les prochaines étapes en matière de routage et de répartition des charges.
Une application cloud bien conçue journalise ses événements principaux en utilisant les flux d'entrée-sortie standard STDERR et STDOUT. Ensuite, un service auxiliaire, comme filebeat, logstash ou fluentd, transmet les journaux à un système de surveillance centralisé (comme Prometheus) et à un système de collecte de journaux (ensemble de logiciels ELK). Le schéma ci-dessous illustre comment l'application cloud fonctionne selon le Modèle de vérification de la disponibilité et le Principe de haute observabilité.
Comment appliquer le Modèle de vérification de la disponibilité dans Kubernetes ?
Par défaut, k8s surveille l'état des pods à l'aide de l'un des contrôleurs (, , , et autres, etc.). Lorsqu'un pod est constaté comme étant hors service pour une raison quelconque, le contrôleur tente de le redémarrer ou de le reprogrammer sur un autre nœud. Cependant, un pod peut signaler qu'il est en cours d'exécution et fonctionnel alors qu'en réalité il ne fonctionne pas. Prenons un exemple : votre application utilise Apache comme serveur web, et vous avez déployé le composant sur plusieurs pods du cluster. Étant donné que la bibliothèque a été mal configurée, toutes les requêtes à l'application renvoient le code 500 (erreur interne du serveur). Lors de la vérification de la livraison, l'état des pods affiche un résultat satisfaisant, alors que les clients ne sont pas de cet avis. Nous décrirons cette situation indésirable comme suit :
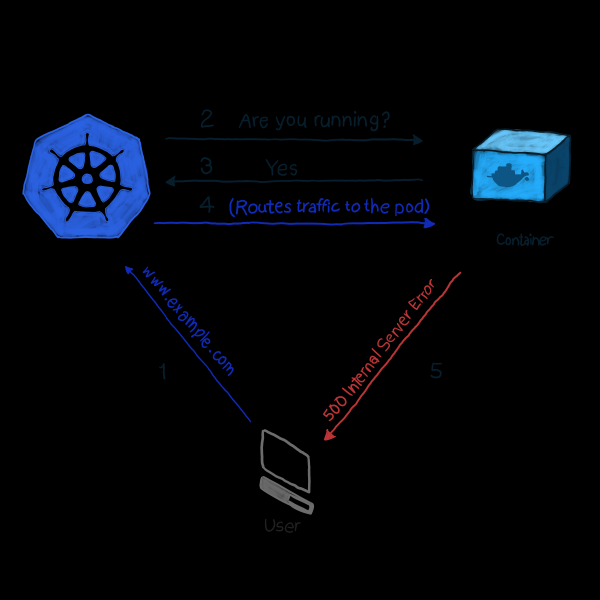
Dans notre exemple, k8s effectue une vérification de la disponibilité. Dans ce type de vérification, kubelet surveille constamment l'état du processus dans le conteneur. Dès qu'il détecte que le processus est bloqué, il le redémarre. Si une erreur peut être corrigée par un simple redémarrage de l'application, et que le programme est conçu pour se fermer en cas de toute erreur, alors pour respecter les NORMES et le Modèle de vérification de la fonctionnalité, il suffit de contrôler la fonctionnalité du processus. Malheureusement, toutes les erreurs ne peuvent pas être résolues par un redémarrage. Dans ce cas, k8s propose deux méthodes plus approfondies pour diagnostiquer les problèmes d'un pod : et .
LivenessProbe
Pendant ce temps, livenessProbe kubelet effectue trois types de vérifications : il détermine non seulement si le pod fonctionne, mais aussi s'il est prêt à recevoir et à répondre correctement aux requêtes :
- Établir une requête HTTP au pod. La réponse doit contenir un code de réponse HTTP compris entre 200 et 399. Ainsi, les codes 5xx et 4xx signalent que le pod a des problèmes, même si le processus fonctionne.
- Pour vérifier les pods avec des services non-HTTP (comme le serveur de messagerie Postfix), il est nécessaire d'établir une connexion TCP.
- Exécuter une commande arbitraire pour le pod (en interne). La vérification est considérée comme réussie si le code de sortie de la commande est 0.
Voici un exemple de son fonctionnement. La définition du pod suivant contient une application NodeJS qui renvoie une erreur 500 aux requêtes HTTP. Pour s'assurer que le conteneur redémarre après avoir reçu cette erreur, nous utilisons le paramètre livenessProbe :
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Cela ne diffère en rien de toute autre définition de pod, mais nous ajoutons l'objet .spec.containers.livenessProbe. Le paramètre httpGet prend le chemin sur lequel il envoie la requête HTTP GET (dans notre exemple, c'est /, mais dans des scénarios de production, cela pourrait être quelque chose comme /api/v1/status). De plus, livenessProbe accepte un paramètre initialDelaySeconds, qui indique aux opérations de vérification d'attendre un certain nombre de secondes. Ce délai est nécessaire car le conteneur a besoin de temps pour se lancer, et lors d'un redémarrage, il sera indisponible pendant un certain temps.
Pour appliquer cette configuration au cluster, utilisez :
kubectl apply -f pod.yamlAprès quelques secondes, vous pouvez vérifier le contenu du pod à l'aide de la commande suivante :
kubectl describe pods node500À la fin de la sortie, recherchez .
Comme vous pouvez le voir, l'livenessProbe a initié une requête HTTP GET, le conteneur a retourné une erreur 500 (comme prévu), kubelet l'a redémarré.
Si vous êtes curieux de savoir comment l'application NideJS a été programmée, voici le fichier app.js et le Dockerfile qui ont été utilisés :
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Nous avons rencontré une erreurn");
});

server.listen(3000, function() {
    console.log('Le serveur fonctionne sur le port 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Il est important de noter que : l'livenessProbe redémarrera le conteneur uniquement en cas de défaillance. Si le redémarrage ne corrige pas l'erreur empêchant le fonctionnement du conteneur, kubelet ne pourra pas prendre de mesures pour résoudre la panne.
readinessProbe
readinessProbe fonctionne de manière similaire aux livenessProbes (requêtes GET, communications TCP et exécution de commandes), à l'exception des actions de dépannage. Un conteneur dans lequel une défaillance est signalée n'est pas redémarré, mais isolé du trafic entrant. Imaginez qu'un des conteneurs effectue de nombreux calculs ou subit une charge importante, provoquant une augmentation du temps de réponse aux requêtes. Dans le cas de l'livenessProbe, un contrôle de la disponibilité de la réponse se déclenche (via le paramètre de vérification timeoutSeconds), après quoi kubelet redémarre le conteneur. Lors du démarrage, le conteneur commence à effectuer des tâches gourmandes en ressources, et il est redémarré à nouveau. Cela peut être critique pour les applications où la réactivité est importante. Par exemple, une machine en route attend une réponse du serveur, le délai de réponse s'allonge – et la machine se retrouve en panne.
Écrivons une définition de readinessProbe, qui établira le temps de réponse à la requête GET à un maximum de deux secondes, alors que l'application répondra à la requête GET après 5 secondes. Le fichier pod.yaml devrait ressembler à ceci :
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Déployons le pod avec kubectl :
kubectl apply -f pod.yamlAttendons quelques secondes, puis voyons comment l'livenessProbe a réagi :
kubectl describe pods nodedelayedÀ la fin de la sortie, vous pouvez voir que certains événements ressemblent à .
Comme vous pouvez le voir, kubectl n'a pas redémarré le pod lorsque le temps de vérification a dépassé 2 secondes. Au lieu de cela, il a annulé la requête. Les connexions entrantes sont redirigées vers d'autres pods opérationnels.
Notez que maintenant qu'il n'y a plus de charge superflue sur le pod, kubectl dirige de nouveau les demandes vers celui-ci : les réponses aux requêtes GET ne sont plus retardées.
Pour comparaison : voici le fichier app.js modifié ci-dessous :
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Le serveur fonctionne sur le port 3000')
})
TL;DR
Avant l'émergence des applications cloud, le principal moyen de surveillance et de vérification de l'état des applications était les journaux. Pourtant, il n'y avait pas d'outils pour entreprendre des mesures de dépannage. Les journaux sont toujours utiles aujourd'hui, ils doivent être collectés et envoyés à un système de collecte de journaux pour l'analyse des situations d'urgence et la prise de décisions. [cela pouvait également être fait sans applications cloud en utilisant monit, par exemple, mais avec k8s, c'est devenu beaucoup plus facile 🙂 – note de l'éditeur. ]
Aujourd'hui, les corrections doivent être apportées presque en temps réel, donc les applications ne doivent plus être des boîtes noires. Non, elles doivent afficher des points de terminaison qui permettent aux systèmes de surveillance de demander et de collecter des données précieuses sur l'état des processus, afin de réagir immédiatement si nécessaire. Cela s'appelle le Modèle de conception de vérification de la disponibilité, qui suit le Principe de haute observabilité (HLO).
Kubernetes propose par défaut 2 types de vérification de la disponibilité : readinessProbe et livenessProbe. Les deux utilisent les mêmes types de vérifications (requêtes HTTP GET, connexions TCP et exécution de commandes). Ils diffèrent par les décisions prises en réponse à des problèmes dans les pods. L'livenessProbe redémarre le conteneur dans l'espoir que l'erreur ne se reproduise plus, tandis que readinessProbe isole le pod du trafic entrant – jusqu'à ce que la cause du problème soit résolue.
La conception correcte d'une application doit inclure les deux types de vérification, et elles doivent collecter suffisamment de données, notamment lorsqu'une situation exceptionnelle est créée. Elle doit également afficher les points de terminaison API nécessaires qui transmettent au système de surveillance (comme Prometheus) des métriques importantes sur la disponibilité.
Source : habr.com
