

Dans le cadre d'un projet de recherche le travail a commencé pour ajouter à GCC la capacité de diviser le processus de compilation en plusieurs threads exécutés en parallèle. Actuellement, pour améliorer la vitesse de compilation sur des systèmes multicœurs, il est utilisé un lancement de processus de compilateur distincts au niveau de l'outil make, chacun d'eux effectuant la compilation d'un fichier de code distinct. Le nouveau projet expérimente la parallélisation au niveau du compilateur, ce qui pourrait potentiellement améliorer l'efficacité de fonctionnement sur des systèmes multicœurs.
Pour les tests une branche de parallélisation distincte de GCC, pour laquelle un nouveau paramètre «—param=num-threads=N» a été proposé pour définir le nombre de threads. À ce stade initial, les optimisations interprocédurales, qui sont appelées de manière cyclique pour chaque fonction et se prêtent bien à la parallélisation, ont été exécutées dans des threads distincts. Les opérations GIMPLE responsables des optimisations indépendantes du matériel, évaluant l'interaction entre les fonctions, ont été déplacées dans des threads séparés.
Au stade suivant, il est également prévu de déplacer dans des threads distincts les optimisations RTL interprocédurales, prenant en compte les spécificités de la plateforme matérielle. Ensuite, il est prévu de réaliser la parallélisation des optimisations intraprocedurales (IPA) appliquées au code à l'intérieur de la fonction, indépendamment des caractéristiques de l'appel. La limitation actuelle est le ramasse-miettes, auquel une verrouillage global a été ajouté, désactivant les opérations de ramassage pendant l'exécution en mode multithread (à l'avenir, le ramasse-miettes sera adapté à l'exécution multithread de GCC).
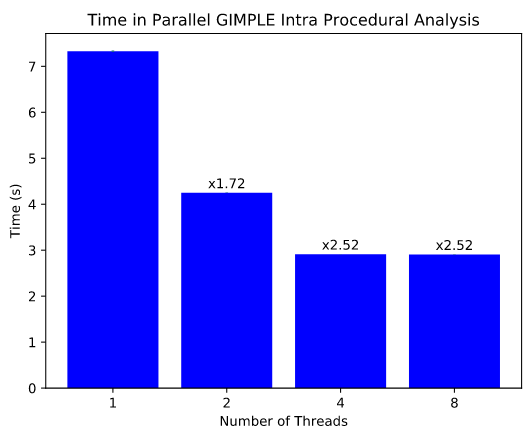
Pour évaluer le changement de performance, un ensemble de tests a été préparé, qui compile le fichier gimple-match.c, contenant plus de 100 000 lignes de code et 1700 fonctions. Les tests sur un système avec un CPU Intel Core i5-8250U avec 4 cœurs physiques et 8 virtuels (Hyperthreading) ont montré une réduction du temps d'exécution des optimisations intra procédurales GIMPLE de 7 à 4 secondes lors de l'exécution de 2 threads et à 3 secondes lors de l'exécution de 4 threads, soit une augmentation de la vitesse de la phase considérée de compilation de 1,72 et 2,52 fois, respectivement. Les tests ont également montré que l'utilisation de cœurs virtuels lors de l'Hyperthreading n'entraîne pas d'augmentation de performance.
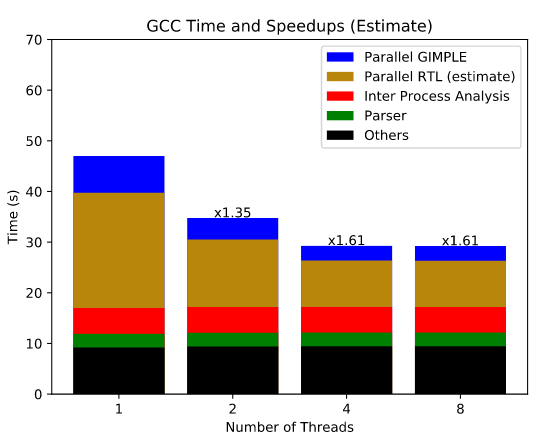
Le temps de compilation a été réduit d'environ 10 %, mais selon les prévisions, le parallélisme des optimisations RTL permettra d'obtenir des résultats plus significatifs, car cette étape prend beaucoup plus de temps lors de la compilation. Approximativement, après le parallélisme RTL, le temps de compilation devrait être réduit d'un facteur de 1,61. Par la suite, il sera encore possible de réduire le temps de compilation de 5 à 10 % grâce au parallélisme des optimisations IPA.
Source : opennet.ru
