

Bonjour, lecteurs de Habr. Cet article marque le début d'une série qui présentera notre système hyperconvergé AERODISK vAIR. Dans un premier temps, nous avions prévu de tout expliquer dans cet article d'introduction, mais le système étant assez complexe, nous allons y aller progressivement.
Nous commencerons par l'histoire de la création du système, en nous plongeant dans le système de fichiers ARDFS, qui constitue la base de vAIR, et en réfléchissant un peu à la position de cette solution sur le marché russe.
Dans les articles suivants, nous expliquerons en détail les différents composants architecturaux (cluster, hyperviseur, répartiteur de charge, système de surveillance, etc.), le processus de configuration, nous aborderons les questions de licence, nous démontrerons des tests de résistance et, bien entendu, nous traiterons des tests de charge et du sizing. De plus, un article sera dédié à la version communautaire de vAIR.
AERODISK, est-ce vraiment une histoire de stockage? Ou pourquoi avons-nous même commencé à travailler sur l'hyperconvergence?
L'idée de créer notre propre solution hyperconvergée nous est venue aux alentours de 2010. À l'époque, il n'existait ni AERODISK ni de systèmes hyperconvergés commerciaux sur le marché. Notre objectif était le suivant : à partir d'un ensemble de serveurs avec des disques locaux, interconnectés via un protocole Ethernet, créer un stockage distribué et y faire fonctionner des machines virtuelles et un réseau logiciel. Le tout devait être réalisé sans système de stockage (car nous n'avions pas les moyens d'acheter un système de stockage ni d'en concevoir un à l'époque).
Nous avons testé de nombreuses solutions open source et avons finalement réussi, mais la solution était très complexe et difficile à reproduire. De plus, cette solution relevait de la catégorie "Ça fonctionne? Ne touche pas!". Donc, ayant résolu ce problème, nous n'avons pas continué à développer l'idée de transformer le résultat de notre travail en un produit complet.
Après cette expérience, nous avons laissé cette idée de côté, mais nous n'avons pas cessé de sentir que cette problématique était tout à fait soluble et que les avantages d'une telle solution étaient plus que évidents. Par la suite, les produits HCI lancés par des entreprises étrangères n'ont fait que confirmer ce sentiment.
C'est pourquoi, au milieu de l'année 2016, nous sommes revenus à cette tâche dans le cadre de la création d'un produit complet. À l'époque, nous n'avions pas encore de relations avec des investisseurs, c'est pourquoi nous avons dû acheter notre stand de développement avec nos modestes fonds. En cherchant sur Avito des serveurs et des commutateurs d'occasion, nous nous sommes mis au travail.
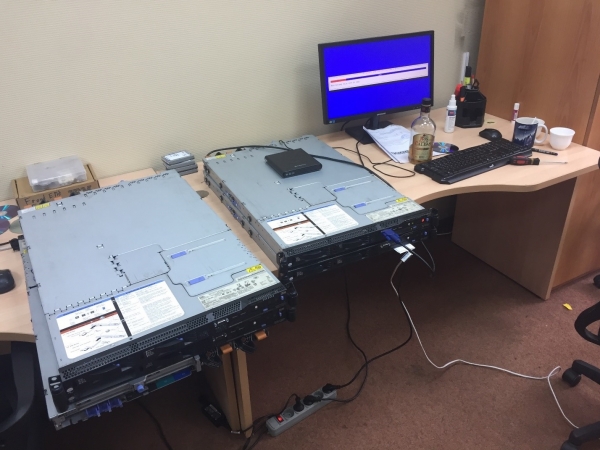
La principale tâche initiale était de créer notre propre système de fichiers, bien que simple, mais qui pourrait automatiquement et uniformément répartir les données sous forme de blocs virtuels sur un nombre n de nœuds de cluster, interconnectés par Ethernet. Ce système de fichiers devait être facilement évolutif et indépendant des systèmes adjacents, c'est-à-dire pouvoir être détaché de vAIR en tant que « simple stockage ».
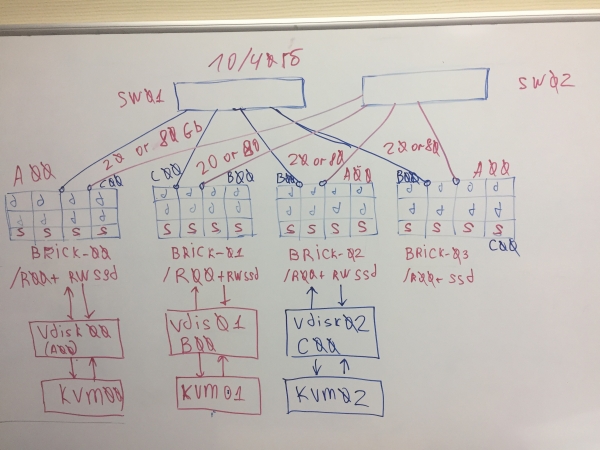
Le premier concept de vAIR
Nous avons délibérément évité d'utiliser des solutions open source prêtes à l'emploi pour organiser un stockage distribué (ceph, gluster, lustre et similaires) en faveur de notre propre développement, car nous avions déjà une expérience de projet significative avec eux. Sans aucun doute, ces solutions sont excellentes en soi, et avant de travailler sur Aerodisk, nous avons réalisé plusieurs projets d'intégration avec elles. Mais il y a une différence entre réaliser une tâche spécifique pour un client, former le personnel et, éventuellement, acheter le support d'un grand fournisseur, et créer un produit facilement reproductible qui sera utilisé pour différentes tâches, dont nous, en tant que fournisseur, ne serons peut-être même pas conscients. Pour cet objectif, les produits open source existants ne nous convenaient pas, c'est pourquoi nous avons décidé de développer notre propre système de fichiers distribué.
Après deux ans de travail de plusieurs développeurs (qui combinaient leur travail sur vAIR avec celui d'un stockage classique Engine), nous avons obtenu un certain résultat.
D'ici 2018, nous avions écrit un système de fichiers très simple et l'avions complété par l'encadrement nécessaire. Le système combinait via un interconnect interne des disques physiques (locaux) de différents serveurs en un seul pool plat et les « découpait » en blocs virtuels ; ensuite, des dispositifs de bloc étaient créés à partir de ces blocs virtuels avec un certain niveau de tolérance aux pannes, sur lesquels des machines virtuelles étaient créées et exécutées à l'aide de l'hyperviseur KVM.
Nous n'avons pas vraiment cherché à compliquer le nom de notre système de fichiers et l'avons sobrement appelé ARDFS (devinez ce que cela signifie))
Ce prototype avait fière allure (pas visuellement, bien sûr, il n'y avait pas encore de design à l'époque) et montrait de bonnes performances et une bonne évolutivité. Après le premier résultat concret, nous avons donné le feu vert à ce projet, en organisant un environnement de développement complet et une équipe distincte qui s'occupait uniquement de vAIR.
À ce moment-là, l'architecture générale de la solution s'était justement formée et n'a pas subi de changements majeurs depuis.
Plongée dans le système de fichiers ARDFS
ARDFS est la base de vAIR, qui fournit un stockage de données distribué et tolérant aux pannes pour l'ensemble du cluster. L'une des (mais pas la seule) caractéristiques distinctives d'ARDFS est qu'il n'utilise aucun supplément de serveurs dédiés pour la gestion et le contrôle. Cela a été conçu dès le départ pour simplifier la configuration de la solution et pour sa fiabilité.
Structure de stockage
À travers toutes les nœuds du cluster, ARDFS organise un pool logique de tout l'espace disque disponible. Il est important de comprendre que le pool n'est pas encore des données ni un espace formaté, mais simplement un balisage, c'est-à-dire que tous les nœuds avec vAIR installés, lorsqu'ils sont ajoutés au cluster, sont automatiquement intégrés au pool ARDFS et les ressources de disque deviennent automatiquement partagées sur tout le cluster (et disponibles pour un stockage futur des données). Cette approche permet d'ajouter et de supprimer des nœuds à la volée sans impact sérieux sur le système déjà en fonctionnement. Cela signifie que le système est très facile à évoluer « brique par brique », en ajoutant ou en retirant des nœuds au cluster si nécessaire.
Au-dessus du pool ARDFS, des disques virtuels (objets de stockage pour les machines virtuelles) sont ajoutés, qui sont construits à partir de blocs virtuels de 4 mégaoctets. Les données sont directement stockées sur ces disques virtuels. Au niveau des disques virtuels, un schéma de tolérance aux pannes est également défini.
Comme vous pouvez déjà le deviner, pour la résilience du système de stockage, nous n'utilisons pas le concept de RAID (Redundant array of independent Disks), mais nous utilisons RAIN (Redundant array of independent Nodes). C'est-à-dire que la résilience est mesurée, automatisée et gérée en fonction des nœuds, et non des disques. Les disques, bien sûr, sont également un objet de stockage, ils, comme tout le reste, sont surveillés, et toutes les opérations standard peuvent être effectuées avec eux, y compris la création de RAID matériel local, mais le cluster opère uniquement sur des nœuds.
Dans une situation où l'on désire vraiment RAID (par exemple, un scénario supportant de multiples pannes sur de petits clusters), rien n'empêche d'utiliser des contrôleurs RAID locaux et de créer au-dessus un stockage étendu et une architecture RAIN. Ce scénario est tout à fait viable et nous le supportons, c'est pourquoi nous en parlerons dans l'article sur les scénarios typiques d'application de vAIR.
Schémas de résilience du stockage
Il peut y avoir deux schémas de résilience des disques virtuels dans vAIR :
1) Facteur de réplication ou simplement réplication – cette méthode de résilience est aussi simple que « une bâton et une corde ». Elle consiste en une réplication synchrone entre les nœuds avec un facteur de 2 (2 copies par cluster) ou 3 (3 copies, respectivement). RF-2 permet au disque virtuel de supporter la panne d'un nœud dans le cluster, mais « consomme » la moitié de l'espace utile, tandis que RF-3 supportera la panne de 2 nœuds dans le cluster, mais réservera déjà 2/3 de l'espace utile à ses propres besoins. Ce schéma ressemble beaucoup à RAID-1, c'est-à-dire qu'un disque virtuel configuré en RF-2 est résistant à la panne de n'importe quel nœud du cluster. Dans ce cas, les données seront en sécurité et même l'entrée-sortie ne s'arrêtera pas. Lorsque le nœud défaillant sera de retour, la récupération automatique/synchronisation des données commencera.
Ci-dessous des exemples de distribution des données RF-2 et RF-3 en mode normal et en cas de pannes.
Nous avons une machine virtuelle de 8 Mo de données uniques (utiles) fonctionnant sur 4 nœuds vAIR. Il est évident qu'en réalité, un tel petit volume sera peu probable, mais cet exemple est le plus clair pour illustrer la logique de fonctionnement de l'ARDFS. AB représente des blocs virtuels de 4 Mo contenant des données uniques de la machine virtuelle. Avec RF-2, deux copies de ces blocs A1+A2 et B1+B2 sont créées. Ces blocs sont "répartis" sur les nœuds, évitant la duplication des mêmes données sur un seul nœud, c'est-à-dire que la copie A1 ne sera pas sur le même nœud que la copie A2. Il en va de même pour B1 et B2.
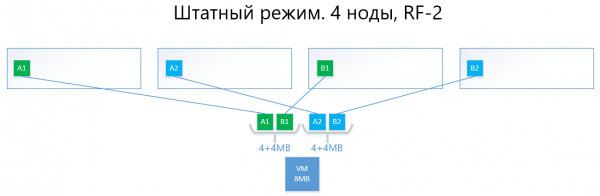
En cas de défaillance d'un des nœuds (par exemple, le nœud n°3, où se trouve la copie B1), cette copie est automatiquement activée sur un nœud où sa copie (c'est-à-dire la copie B2) n'est pas présente.
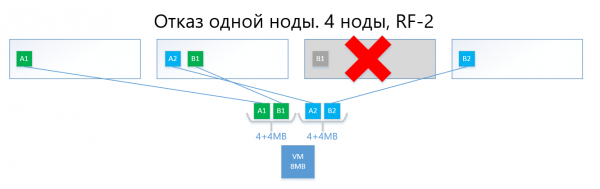
Ainsi, le disque virtuel (et la VM, par conséquent) peuvent facilement survivre à la défaillance d'un nœud dans le schéma RF-2.
Le schéma de réplication, malgré sa simplicité et sa fiabilité, souffre du même problème que le RAID1 : peu d'espace utile.
2) Le codage par effacement ou erasure coding (également connu sous les noms de « codage redondant », « codage d'effacement » ou « code de redondance ») existe précisément pour résoudre le problème ci-dessus. EC est un schéma de redondance qui assure une haute disponibilité des données avec des frais généraux d'espace disque moindres que ceux de la réplication. Le principe de fonctionnement de ce mécanisme est similaire à celui du RAID 5, 6, 6P.
Lors du codage, le processus EC divise le bloc virtuel (par défaut 4 Mo) en plusieurs « morceaux de données » plus petits en fonction du schéma EC (par exemple, le schéma 2+1 divise chaque bloc de 4 Mo en 2 morceaux de 2 Mo). Ensuite, ce processus génère pour les « morceaux de données » des « morceaux de parité » d'une taille ne dépassant pas celle des parties précédemment divisées. Lors du décodage, EC génère les morceaux manquants en lisant les données « survivantes » à travers le cluster.
Par exemple, un disque virtuel avec un schéma EC 2 + 1, déployé sur 4 nœuds d'un cluster, peut résister à la défaillance d'un nœud dans le cluster tout aussi bien que le RF-2. Dans ce cas, les frais généraux seront moindres, en particulier le facteur d'utilité dans RF-2 est de 2, tandis que pour EC 2+1, il sera de 1,5.
Pour résumer simplement, le principe consiste à diviser un bloc virtuel en 2 à 8 (pourquoi de 2 à 8, voir ci-dessous) « morceaux », et pour ces morceaux, des « morceaux » de parité de volume similaire sont calculés.
Les données et leur parité sont donc uniformément réparties sur tous les nœuds du cluster. Comme pour la réplication, ARDFS répartit automatiquement les données sur les nœuds afin d'éviter que des données identiques (copies des données et de leur parité) ne soient stockées sur un même nœud, afin d'exclure la possibilité de perdre des données si les données et leur parité se retrouvaient soudainement sur un nœud de stockage qui tomberait en panne.
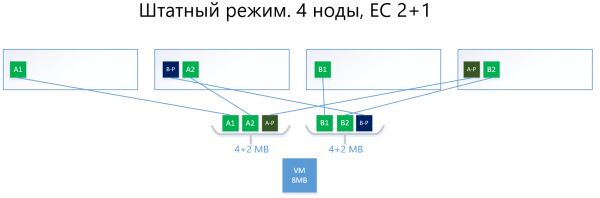
Voici un exemple, avec la même machine virtuelle de 8 Mo et 4 nœuds, mais avec un schéma EC 2+1.
Les blocs A et B sont chacun divisés en deux morceaux de 2 Mo (en deux car 2+1), c'est-à-dire A1+A2 et B1+B2. Contrairement à une réplique, A1 n'est pas une copie de A2, c'est un bloc virtuel A, divisé en deux parties, de la même manière pour le bloc B. Nous obtenons donc deux ensembles de 4 Mo, chacun contenant deux morceaux de deux mégabits. Ensuite, pour chacun de ces ensembles, une parité d'une taille ne dépassant pas un morceau (c'est-à-dire 2 Mo) est calculée, nous obtenons donc en plus + 2 morceaux de parité (A-P et B-P). Au total, nous avons 4×2 données + 2×2 parité.
Ensuite, les morceaux sont 'répartis' sur les nœuds de manière à ce que les données ne croisent pas leur parité. C'est-à-dire que A1 et A2 ne seront pas sur le même nœud que A-P.
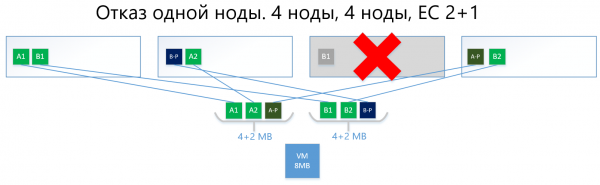
En cas de défaillance d'un nœud (disons, le troisième), le bloc B1 tombé sera automatiquement restauré à partir de la parité B-P, qui est stockée sur le nœud n°2, et sera activé sur le nœud où il n'y a pas de parité B, c'est-à-dire le morceau B-P. Dans cet exemple, c'est le nœud n°1.
Je suis sûr que le lecteur se pose la question :
« Tout ce que vous avez décrit a déjà été réalisé par des concurrents et dans des solutions open source, quelle est la différence avec votre implémentation EC dans ARDFS ? »
Et ensuite, nous parlerons des caractéristiques intéressantes du fonctionnement d'ARDFS.
Codage de rupture axé sur la flexibilité
Initialement, nous avons prévu un schéma EC X+Y assez flexible, où X est un nombre de 2 à 8, et Y est un nombre de 1 à 8, mais toujours inférieur ou égal à X. Ce schéma est conçu pour la flexibilité. Augmenter le nombre de morceaux de données (X) sur lesquels un bloc virtuel est divisé permet de réduire les coûts généraux, c'est-à-dire d'augmenter l'espace utile.
L'augmentation du nombre de morceaux de parité (Y) accroît la fiabilité du disque virtuel. Plus la valeur de Y est élevée, plus le nombre de nœuds dans le cluster peut tomber en panne. Bien sûr, augmenter le volume de parité réduit la capacité utile, mais c'est le prix à payer pour la fiabilité.
La dépendance des performances par rapport aux schémas EC est presque directe : plus il y a de « morceaux », plus la performance est faible. Il est donc clair qu'une vue équilibrée est nécessaire.
Cette approche permet aux administrateurs de configurer de manière maximale et flexible le stockage étendu. Dans le cadre de la pool ARDFS, il est possible d'utiliser n'importe quels schémas de tolérance de panne et leurs combinaisons, ce qui est également très utile à notre avis.
Ci-dessous se trouve un tableau comparatif de plusieurs (mais non tous les) schémas RF et EC.
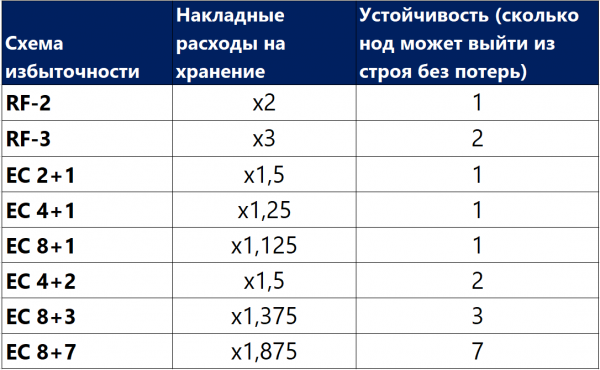
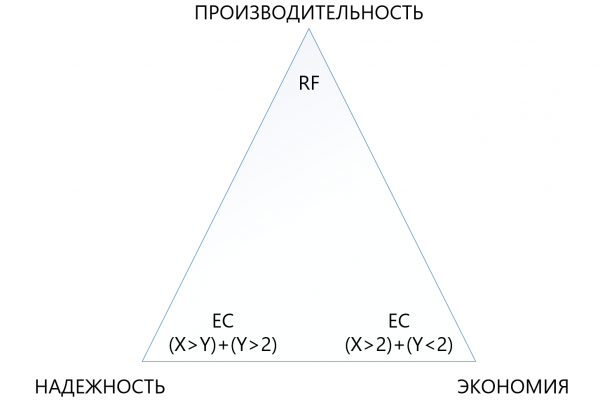
Il ressort du tableau que même la combinaison EC 8+7 la plus 'extrême', permettant la perte simultanée de jusqu'à 7 nœuds dans le cluster, consomme moins d'espace utile (1,875 contre 2) que la réplication standard, tout en protégeant 7 fois mieux, ce qui rend ce mécanisme de protection, bien que plus complexe, significativement plus attrayant dans les situations où il est nécessaire d'assurer une fiabilité maximale en raison d'un manque d'espace disque. Il est à comprendre que chaque 'plus' à X ou Y sera une surcharge supplémentaire sur les performances, il est donc crucial de faire un choix très attentif dans le triangle entre fiabilité, économies et performances. Pour cette raison, nous consacrerons un article séparé au sizing de l'encodage à distance.
Fiabilité et autonomie du système de fichiers
ARDFS est exécuté localement sur tous les nœuds du cluster et synchronise ses propres moyens via des interfaces Ethernet dédiées. Un point important est que ARDFS synchronise non seulement les données, mais aussi les métadonnées relatives au stockage. Pendant le développement d'ARDFS, nous avons également étudié un certain nombre de solutions existantes et découvert que beaucoup synchronisent les métadonnées du système de fichiers à l'aide d'une base de données distribuée externe, que nous utilisons également pour la synchronisation, mais uniquement des configurations et non des métadonnées FS (nous aborderons ce sujet et d'autres systèmes connexes dans le prochain article).
La synchronisation des métadonnées du FS à l'aide d'une SGBD externe est une solution fonctionnelle, mais la cohérence des données stockées sur ARDFS dépendrait alors de cette SGBD externe et de son comportement (qui est, il faut le dire, une dame capricieuse), ce qui, à notre avis, est problématique. Pourquoi ? Si les métadonnées du FS se détériorent, on pourrait aussi dire « au revoir » aux données du FS, c'est pourquoi nous avons décidé de prendre une voie plus complexe mais fiable.
Nous avons développé nous-mêmes le sous-système de synchronisation des métadonnées pour ARDFS, et il fonctionne complètement indépendamment des sous-systèmes adjacents. Autrement dit, aucun autre sous-système ne peut endommager les données d'ARDFS. À notre avis, c'est la voie la plus fiable et correcte, mais le temps nous montrera si cela est réellement le cas. De plus, cette approche présente un avantage supplémentaire. ARDFS peut être utilisé indépendamment de vAIR, simplement comme un stockage étendu, ce dont nous tirerons nécessairement parti dans nos futurs produits.
En fin de compte, en développant ARDFS, nous avons obtenu un système de fichiers flexible et fiable qui permet de choisir où économiser sur la capacité ou allouer toute la performance, ou faire du stockage un super fiable à un coût modéré tout en réduisant les exigences de performance.
Avec une politique de licences simple et un modèle de fourniture flexible (pour faire simple, vAIR est licencié par nœuds et est fourni soit en logiciel, soit sous forme de PAK), cela permet de bien adapter la solution aux diverses exigences des clients et de maintenir facilement cet équilibre par la suite.
Qui a besoin de cette merveille ?
D'une part, on peut dire qu'il y a déjà des acteurs sur le marché avec des solutions sérieuses dans le domaine de l’hyperconvergence, et où nous, en fait, tentons de nous imposer. Il semble que cette affirmation soit vraie, MAIS…
D'autre part, en allant « sur le terrain » et en discutant avec les clients, nous et nos partenaires constatons que ce n'est pas du tout le cas. Il y a de nombreuses tâches pour l'hyperconvergence ; certaines personnes ne savaient tout simplement pas que de telles solutions existent, d'autres trouvaient cela coûteux, d'autres encore avaient des tests infructueux d'alternatives, et dans certains cas, il est même interdit d'acheter en raison de sanctions. En gros, le champ s'est avéré inexploré, c'est pourquoi nous avons décidé de défricher cette terre))).
Quand un SCD est-il meilleur qu'un GKS ?
Au fur et à mesure de notre travail sur le marché, on nous demande souvent quand il est préférable d'appliquer le schéma classique avec un stockage en réseau (SAN) et quand – une solution hyperconvergente ? De nombreuses entreprises – fabricants de GKS (surtout celles qui n'ont pas de SAN dans leur portefeuille) disent : « Le SAN est obsolète, l'hyperconvergence est la seule voie ! ». C'est une déclaration audacieuse, mais elle ne reflète pas entièrement la réalité.
À vrai dire, le marché du SAN se tourne effectivement vers les solutions hyperconvergentes et similaires, mais il y a toujours un « mais ».
Tout d'abord, les centres de données et les infrastructures informatiques construits selon le schéma classique avec un SAN ne peuvent pas simplement être reconvertis, donc la modernisation et l'extension de ces infrastructures — c'est un héritage qui va durer encore 5 à 7 ans.
Deuxièmement, les infrastructures qui sont actuellement construites en masse (en Russie, par exemple) sont réalisées selon le schéma classique en utilisant un SAN, non pas parce que les gens ne connaissent pas l'hyperconvergence, mais parce que le marché de l'hyperconvergence est nouveau, les solutions et normes ne sont pas encore établies, les informaticiens ne sont pas encore formés, l'expérience est limitée, et il faut construire des centres de données ici et maintenant. Cette tendance va encore durer de 3 à 5 ans (et puis un autre héritage, voir le point 1).
Troisièmement, une limitation purement technique concernant des délais supplémentaires de 2 millisecondes pour l'écriture (sans tenir compte du cache local, bien sûr), qui sont le prix à payer pour un stockage distribué.
Et n'oublions pas l'utilisation de grands serveurs physiques, qui apprécient l'évolutivité verticale des systèmes de stockage.
Il existe de nombreuses tâches nécessaires et populaires où le SAN fonctionne mieux que l'hyperconvergence. Certes, les fabricants qui n'ont pas de SAN dans leur portefeuille ne seront pas d'accord avec nous, mais nous sommes prêts à débattre de manière argumentée. Bien entendu, en tant que développeurs des deux produits, nous réaliserons dans une de nos futures publications une comparaison entre le SAN et l'hyperconvergence, où nous démontrerons clairement dans quelles conditions chacun est le meilleur.
Et où les solutions hyperconvergentes fonctionneront-elles mieux que le SAN ?
Sur la base des thèses ci-dessus, on peut tirer trois conclusions évidentes :
- Là où les 2 millisecondes supplémentaires de latence à l'écriture, qui se manifestent de manière uniforme dans n'importe quel environnement de production (ici, nous ne parlons pas de tests synthétiques, car dans les tests synthétiques, on peut montrer des nanosecondes), ne sont pas critiques, l'hyperconvergence conviendra.
- Là où la charge des grands serveurs physiques peut être transformée en de nombreuses petites machines virtuelles et répartie sur des nœuds, l'hyper-convergence s'y intégrera également très bien.
- Là où l'évolutivité horizontale est plus prioritaire que l'évolutivité verticale, l'hyper-convergence s'y intégrera également parfaitement.
Quelles sont ces solutions ?
- Tous les services d'infrastructure standard (service d'annuaire, courrier, GED, serveurs de fichiers, systèmes ERP et BI petits ou moyens, etc.). Nous les appelons « calculs généraux ».
- L'infrastructure des fournisseurs de cloud, où il est nécessaire de s'étendre horizontalement rapidement et de manière standardisée et de « découper » facilement un grand nombre de machines virtuelles pour les clients.
- Infrastructure des bureaux virtuels (VDI), où de nombreuses petites machines virtuelles d'utilisateurs sont lancées et évoluent tranquillement à l'intérieur d'un cluster homogène.
- Les réseaux d'agences, où chaque agence doit obtenir une infrastructure standard, tolérante aux pannes, mais en même temps peu coûteuse, composée de 15 à 20 machines virtuelles.
- Tous les calculs distribués (services big data, par exemple). Là où la charge va « latéralement », plutôt qu'« en profondeur ».
- Environnements de test, où de légers retards supplémentaires sont acceptables, mais il y a des restrictions budgétaires car il s'agit de tests.
Pour le moment, c'est précisément pour ces tâches que nous avons créé AERODISK vAIR et c'est sur cela que nous nous concentrons (avec succès jusqu'à présent). Cela pourrait bientôt changer, car le monde ne reste pas immobile.
Alors…
Ceci conclut la première partie d'un grand cycle d'articles, dans le prochain article nous parlerons de l'architecture de la solution et des composants utilisés.
Nous serons ravis de recevoir vos questions, suggestions et débats constructifs.
Source : habr.com
