

Nous vous présentons la troisième partie de la traduction du matériel sur le chemin parcouru par l'entreprise Dropbox lors de la mise en œuvre d'un système de vérification des types du code Python.
→ Parties précédentes : et
Atteindre 4 millions de lignes de code typées
Une autre tâche importante (c'était le deuxième problème le plus populaire, préoccupant ceux qui participaient aux enquêtes internes) était d'augmenter le volume de code dans Dropbox couvert par des vérifications de types. Nous avons essayé plusieurs approches pour relever ce défi - allant de la croissance naturelle du volume de la base de code typée à la concentration des efforts des membres de l'équipe mypy sur l'inférence de type statique et dynamique automatisée. Au final, il semblait qu'il n'y avait pas de stratégie gagnante simple, mais nous avons réussi à atteindre une croissance rapide du volume de code annoté en combinant plusieurs approches.
En conséquence, dans notre plus grand dépôt Python (avec le code back-end), le nombre de lignes de code annoté a atteint presque 4 millions. Le travail de typage statique du code a été réalisé en environ trois ans. Mypy prend désormais en charge divers types de rapports sur la couverture du code par des types, qui facilitent le suivi de l'avancement de la typisation. En particulier, nous pouvons générer des rapports sur le code comportant des incertitudes de type, telles que l'utilisation explicite de type Any dans les annotations, qui ne peuvent pas être vérifiées, ou telles que l'importation de bibliothèques tierces, pour lesquelles il n'y a pas d'annotations de types. Dans le cadre de notre projet visant à améliorer la précision des vérifications de types dans Dropbox, nous avons contribué à l'amélioration des définitions de types (les soi-disant fichiers stub) pour certaines bibliothèques open source populaires dans le dépôt Python centralisé .
Nous avons mis en œuvre (et normalisé dans les PEP suivants) de nouvelles fonctionnalités du système de types, permettant d'utiliser des types plus précis pour certains modèles Python spécifiques. Un exemple notable de cela est TypeDict, qui fournit des types pour les dictionnaires similaires à JSON ayant un ensemble fixe de clés de chaîne, chacune ayant une valeur de son propre type. Nous continuerons à développer le système de types. Il est probable que notre prochaine étape sera d'améliorer le support des fonctionnalités Python en matière de traitement des nombres.
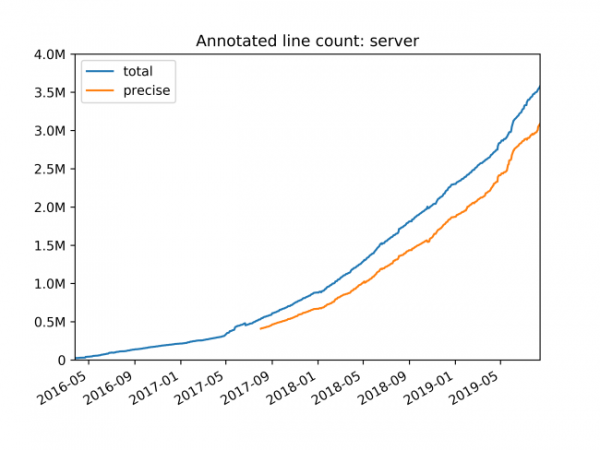
Nombre de lignes de code annotées : serveur
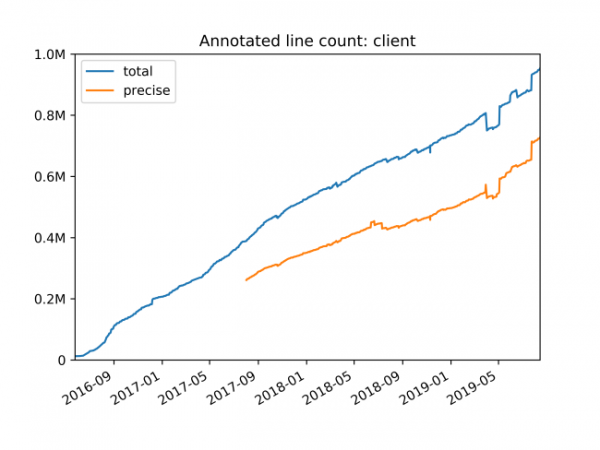
Nombre de lignes de code annotées : client
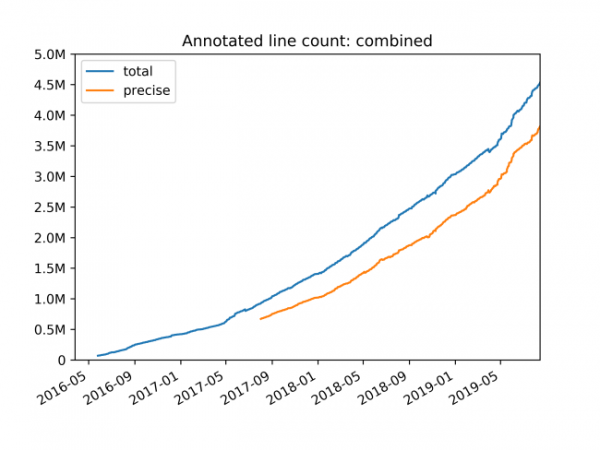
Nombre total de lignes de code annotées
Voici un aperçu des principales caractéristiques des actions que nous avons menées pour augmenter le volume de code annoté dans Dropbox :
Rigueur de l'annotation. Nous avons progressivement augmenté les exigences de rigueur pour l'annotation du nouveau code. Nous avons commencé par des conseils de linter qui suggéraient d'ajouter des annotations dans les fichiers déjà annotés. Maintenant, nous exigeons la présence d'annotations de type dans les nouveaux fichiers Python et dans la plupart des fichiers existants.
Rapports de typage. Nous envoyons chaque semaine des rapports aux équipes sur le niveau de typage de leur code et fournissons des conseils sur ce qu'il convient d'annoter en priorité.
Promotion de mypy. Nous parlons de mypy lors de divers événements et échangeons avec les équipes pour les aider à commencer à utiliser des annotations de type.
Sondages. Nous menons des sondages périodiques auprès des utilisateurs pour identifier les problèmes majeurs. Nous sommes prêts à aller assez loin pour résoudre ces problèmes (jusqu'à créer un nouveau langage pour accélérer mypy !).
Performance. Nous avons considérablement amélioré les performances de mypy grâce à l'utilisation d'un daemon et de mypyc. Cela a été fait pour réduire les désagréments rencontrés lors de l'annotation et pour pouvoir travailler avec de grands volumes de code.
Intégration avec les éditeurs. Nous avons créé des outils pour prendre en charge l'exécution de mypy dans les éditeurs populaires chez Dropbox. Cela inclut PyCharm, Vim et VS Code. Cela a considérablement simplifié le processus d'annotation du code et de vérification de sa fonctionnalité. De telles actions sont généralement caractéristiques de l'annotation de code existant.
Analyse statique. Nous avons créé un outil pour générer des signatures de fonction en utilisant des méthodes d'analyse statique. Cet outil ne fonctionne que dans des situations relativement simples, mais il nous a aidés à augmenter sans effort la couverture du code par des types.
Support pour les bibliothèques tierces. Dans de nombreux projets, nous utilisons l'ensemble d'outils SQLAlchemy. Il exploite les capacités dynamiques de Python, que les types PEP 484 ne peuvent pas modéliser directement. Conformément à PEP 561, nous avons créé un fichier stub correspondant et écrit un plugin pour mypy (), améliorant le support de SQLAlchemy.
Les difficultés rencontrées
Le chemin vers 4 millions de lignes de code typé n'a pas toujours été facile. Sur cette route, nous avons rencontré de nombreux obstacles et commis quelques erreurs. Voici quelques-uns des problèmes que nous avons rencontrés. Nous espérons que notre récit aidera d'autres à éviter des problèmes similaires.
Fichiers manquants. Nous avons commencé à travailler en vérifiant un petit volume de fichiers. Tout ce qui ne faisait pas partie de ces fichiers n'était pas vérifié. Les fichiers étaient ajoutés à la liste de vérification lorsqu'ils recevaient leurs premières annotations. Si quelque chose était importé d'un module situé en dehors de la zone de vérification, il s'agissait de travailler avec des valeurs de type Any, qui n'étaient pas du tout vérifiées. Cela a conduit à une perte significative de précision de typage, surtout au début de la migration. Cette approche a néanmoins fonctionné de manière étonnamment efficace, bien qu'il soit courant que l'ajout de fichiers à la zone de vérification révèle des problèmes dans d'autres parties de la base de code. Dans le pire des cas, lorsque deux zones de code isolées, dans lesquelles les types avaient déjà été vérifiés de manière indépendante, étaient fusionnées, il s'est avéré que les types de ces zones étaient incompatibles. Cela a nécessité de nombreuses modifications dans les annotations. En regardant en arrière, nous comprenons maintenant que nous aurions dû ajouter le module de bibliothèque de base à la zone de vérification des types mypy le plus tôt possible. Cela aurait rendu notre travail beaucoup plus prévisible.
Annotation du code ancien. Lorsque nous avons commencé, nous avions environ 4 millions de lignes de code Python existant. Il était clair que l'annotation de tout ce code était une tâche complexe. Nous avons créé un outil appelé PyAnnotate, qui peut collecter des informations sur les types pendant l'exécution des tests et ajouter des annotations de types au code, basées sur les informations recueillies. Cependant, nous n'avons pas constaté une adoption particulièrement large de cet outil. La collecte d'informations sur les types était lente, et les annotations générées automatiquement nécessitaient souvent de nombreux ajustements manuels. Nous avons envisagé d'exécuter cet outil automatiquement à chaque vérification de code, ou de collecter des informations sur les types en nous basant sur l'analyse d'un petit volume de requêtes réseau réelles, mais avons finalement décidé de ne pas le faire, car chacun de ces approches était trop risqué.
En fin de compte, on peut noter que la majorité du code a été annotée manuellement par ses propriétaires. Pour orienter ce processus dans la bonne direction, nous préparons des rapports sur des modules et fonctions particulièrement importants à annoter. Par exemple, il est essentiel d'annoter le module de bibliothèque utilisé dans des centaines d'endroits. En revanche, annoter un ancien service qui est remplacé par un nouveau est moins crucial. De plus, nous expérimentons l'utilisation de l'analyse statique pour générer des annotations de types pour le code ancien.
Importations circulaires. J'ai mentionné plus haut les importations circulaires (les « nœuds de dépendances »), dont l'existence a compliqué l'accélération de mypy. De plus, nous avons dû travailler sérieusement pour fournir à mypy une prise en charge de tous les types d'idiomes, dont l'origine est due à ces importations circulaires. Récemment, nous avons terminé un grand projet de refonte du système qui a résolu la plupart des problèmes de mypy liés aux importations circulaires. Ces problèmes provenaient en réalité des premiers jours du projet, depuis Alore, le langage d'apprentissage sur lequel mypy était initialement basé. La syntaxe d'Alore permettait de résoudre facilement les problèmes des cycles d'importation. Le mypy moderne a hérité de certaines limitations de sa première implémentation rudimentaire (qui convenait parfaitement à Alore). Python complique la gestion des importations circulaires principalement en raison de l'ambiguïté des expressions. Par exemple, lors d'une opération d'assignation, un alias de type peut en réalité être défini. Mypy ne parvient pas toujours à détecter ce genre de choses tant que la majeure partie du cycle d'importation n'est pas traitée. Dans Alore, ces ambiguïtés n'existaient pas. Les solutions inappropriées prises aux premiers stades de développement du système peuvent réserver des surprises désagréables au programmeur des années plus tard.
Bilan : le chemin vers 5 millions de lignes de code et de nouveaux horizons
Le projet mypy a parcouru un long chemin — des premiers prototypes à un système qui contrôle les types d'un code de production de 4 millions de lignes. Au fur et à mesure de l'évolution de mypy, une normalisation des annotations de types en Python a été réalisée. Aujourd'hui, une puissante écosystème s'est développée autour de la typage du code Python. Elle inclut le soutien de bibliothèques, des outils auxiliaires pour les IDE et les éditeurs, et plusieurs systèmes de vérification des types, chacun ayant ses avantages et ses inconvénients.
Bien que la vérification des types soit déjà perçue chez Dropbox comme un acquis, je suis convaincu que nous vivons encore à l'aube de la typage du code Python. Je pense que les technologies de vérification des types continueront à évoluer et à s'améliorer.
Si vous n'avez pas encore utilisé les vérifications de types dans votre projet Python à grande échelle, sachez que c'est le moment idéal pour commencer la transition vers la typage statique. J'ai discuté avec ceux qui ont fait ce changement. Aucun d'entre eux ne le regrette. Le contrôle des types transforme Python en un langage beaucoup plus adapté à la développement de grands projets que le « Python classique ».
Chers lecteurs ! Utilisez-vous le contrôle des types dans vos projets Python ?
Source : habr.com
