

Zabbix est un système de surveillance. Comme tout autre système, il est confronté à trois problèmes principaux de tous les systèmes de surveillance : la collecte et le traitement des données, le stockage de l'historique, et son nettoyage.
Les étapes de collecte, de traitement et d'enregistrement des données prennent du temps. Un peu, mais pour un grand système, cela peut se traduire par de grands délais. Le problème du stockage est une question d'accès aux données. Elles sont utilisées pour les rapports, les vérifications et les déclencheurs. Les retards d'accès aux données affectent également les performances. Lorsque la base de données se développe, il faut supprimer les données obsolètes. La suppression est une opération lourde qui consomme également une partie des ressources.
Les problèmes de délais lors de la collecte et du stockage dans Zabbix sont résolus par le cache : plusieurs types de caches, le cache dans la base de données. Pour résoudre le troisième problème, le cache ne convient pas, c'est pourquoi Zabbix utilise TimescaleDB. Cela sera expliqué par Andrey Guschin — ingénieur de support technique . Andrey travaille chez Zabbix depuis plus de 6 ans et fait face directement à la performance.
Comment fonctionne TimescaleDB, quelles performances peut-elle offrir par rapport à un PostgreSQL classique ? Quel est le rôle de Zabbix pour une base de données TimescaleDB ? Comment démarrer à partir de zéro et comment migrer depuis PostgreSQL, et quelle configuration offre les meilleures performances ? Tout cela est abordé ci-dessous.

Défis de performance
Chaque système de surveillance est confronté à des défis de performance spécifiques. Je vais parler de trois d'entre eux : la collecte et le traitement des données, le stockage, et le nettoyage de l'historique.
Collecte et traitement des données rapides. Un bon système de surveillance doit pouvoir obtenir rapidement toutes les données et les traiter en fonction des expressions déclencheurs — selon ses propres critères. Après traitement, le système doit également sauvegarder ces données rapidement dans la base de données pour un usage futur.
Stockage de l'historique. Un bon système de surveillance doit stocker l'historique dans la base de données et fournir un accès facile aux métriques. L'historique est nécessaire pour l'utiliser dans les rapports, les graphiques, les déclencheurs, les seuils et les éléments de données calculés pour les alertes.
Nettoyage de l'historique. Parfois, il arrive un jour où vous n'avez plus besoin de conserver les métriques. Pourquoi conserver des données collectées il y a 5 ans, un mois ou deux : certains nœuds ont été supprimés, certains hôtes ou métriques ne sont plus nécessaires car obsolètes et ne sont plus collectés. Un bon système de surveillance doit conserver des données historiques et les supprimer de temps en temps pour éviter que la base de données ne devienne trop volumineuse.
La suppression des données obsolètes est un sujet sensible qui a un impact fort sur les performances de la base de données.
Mise en cache dans Zabbix
Dans Zabbix, le premier et le deuxième appels sont résolus grâce à la mise en cache. Pour la collecte et le traitement des données, la mémoire vive est utilisée. Pour le stockage — l'historique dans les déclencheurs, les graphiques et les éléments de données calculés. Du côté de la base de données, il existe un certain cache pour les requêtes principales, par exemple, pour les graphiques.
La mise en cache du côté du serveur Zabbix lui-même est :
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Examinons-les plus en détail.
ConfigurationCache
C'est le cache principal où nous stockons les métriques, les hôtes, les éléments de données, les déclencheurs — tout ce qui est nécessaire pour le prétraitement et la collecte de données.
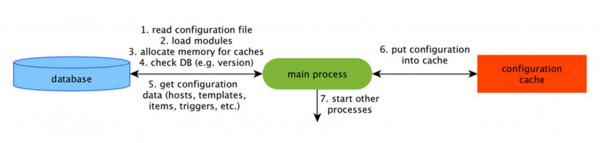
Tout cela est stocké dans le ConfigurationCache pour éviter de créer des requêtes excessives dans la base de données. Après le démarrage du serveur, nous mettons à jour ce cache, créons et mettons périodiquement à jour les configurations.
Collecte des données
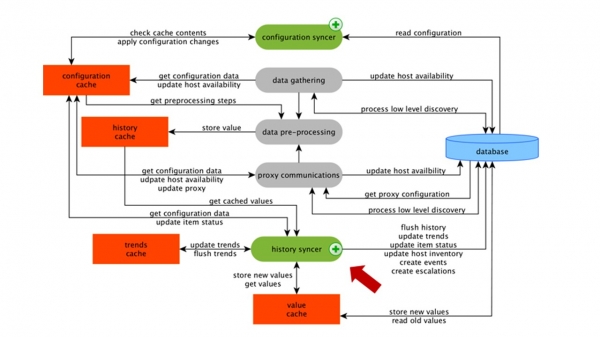
Le schéma est assez vaste, mais l'essentiel est les collecteurs. Ce sont différents « pollers » — processus de collecte. Ils sont responsables de différents types de collecte : ils collectent des données via SNMP, IPMI, et transmettent tout cela au prétraitement.
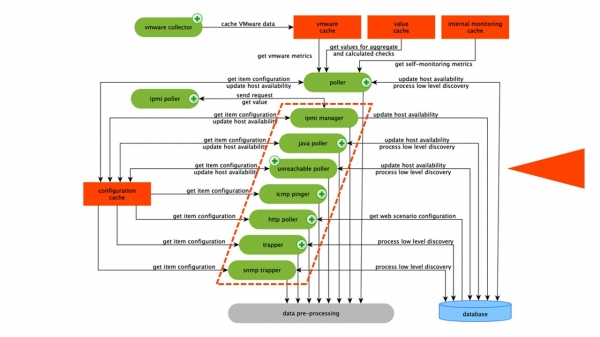 Les collecteurs sont encerclés par une ligne orange.
Dans Zabbix, il existe des éléments de données agrégés calculés qui sont nécessaires pour agréger les vérifications. Si nous les avons, nous récupérons les données pour eux directement depuis le ValueCache.
Prétraitement HistoryCache
Tous les collecteurs utilisent le ConfigurationCache pour obtenir des tâches. Ensuite, ils les transmettent au prétraitement.
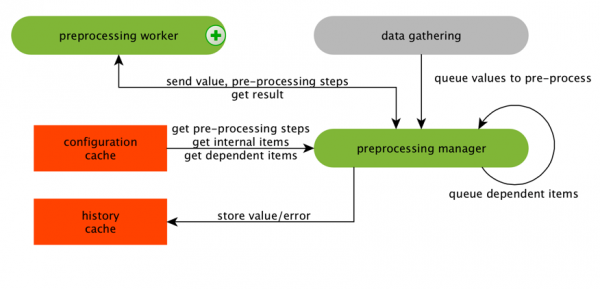
Le prétraitement utilise le ConfigurationCache pour obtenir les étapes de prétraitement. Il traite ces données de différentes manières.
Après le traitement des données avec le prétraitement, nous les sauvegardons dans le HistoryCache pour traitement. C'est la fin de la collecte de données et nous passons au principal processus dans Zabbix — history syncer, car c'est une architecture monolithique.
Remarque : le prétraitement est une opération assez lourde. À partir de la version 4.2, il a été déplacé sur le proxy. Si vous avez un Zabbix très volumineux avec un grand nombre d'éléments de données et une fréquence de collecte élevée, cela facilite considérablement le travail.
ValueCache, historique et cache des tendances
Le synchroniseur d'historique est le processus principal qui traite de manière atomique chaque élément de données, c'est-à-dire chaque valeur.
Le synchroniseur d'historique prend les valeurs du Cache d'historique et vérifie s'il existe des déclencheurs pour les calculs dans la Configuration. S'il y en a, il calcule.
Le synchroniseur d'historique crée un événement, une escalade, pour générer des alertes si nécessaire selon la configuration, et les enregistre. S'il y a des déclencheurs pour un traitement ultérieur, alors il mémorise cette valeur dans le ValueCache, afin de ne pas se référer à la table d’historique. Ainsi, le ValueCache se remplit des données nécessaires pour le calcul des déclencheurs et des éléments calculés.
Le synchroniseur d'historique enregistre toutes les données dans la base de données, et celle-ci les envoie sur le disque. Le processus de traitement se termine ici.
Mise en cache dans la base de données
Du côté de la base de données, il existe différents caches lorsque vous souhaitez voir des graphiques ou des rapports sur les événements :
Innodb_buffer_pooldu côté de MySQL ;shared_buffersdu côté de PostgreSQL ;effective_cache_sizedu côté d'Oracle ;shared_pooldu côté de DB2.
Il existe encore beaucoup d'autres caches, mais ce sont les principaux pour toutes les bases de données. Ils permettent de garder en mémoire vive les données souvent nécessaires pour les requêtes. Ils ont leurs propres technologies pour cela.
La performance de la base de données est critique
Le serveur Zabbix collecte constamment des données et les enregistre. Lors du redémarrage, il lit également l'historique pour remplir le ValueCache. Il utilise des scripts et des rapports Zabbix API, qui est construit sur la base de l'interface Web. L'API Zabbix interroge la base de données et obtient les données nécessaires pour les graphiques, les rapports, les listes d'événements et les problèmes récents.
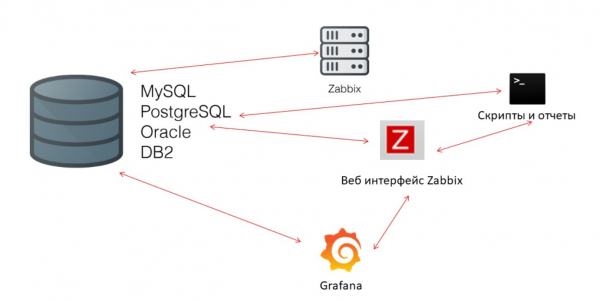
Pour la visualisation — Grafana. C'est une solution populaire parmi nos utilisateurs. Elle peut envoyer directement des requêtes via l'API Zabbix à la base de données et crée une certaine concurrence pour l'obtention des données. Par conséquent, une configuration plus fine et de meilleure qualité de la base de données est nécessaire pour répondre à la rapide délivrance de résultats et au test.
Housekeeper
Le troisième appel de performance dans Zabbix est le nettoyage de l'historique par Housekeeper. Il respecte tous les paramètres — dans les éléments de données, il est indiqué combien de temps conserver la dynamique des changements (tendances) en jours.
Nous calculons TrendsCache à la volée. Lorsque les données arrivent, nous les agrégeons sur une heure et les enregistrons dans les tables pour la dynamique des changements de tendances.
Le Housekeeper s'exécute et supprime des informations de la base de données via des « selects » ordinaires. Ce n'est pas toujours efficace, comme le montrent les graphiques de performance des processus internes.
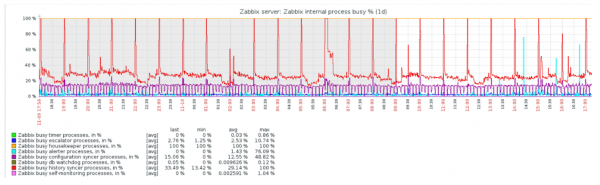
Le graphique rouge montre que le synchroniseur d'historique est constamment occupé. Le graphique orange en haut représente le Housekeeper, qui s'exécute en continu. Il attend que la base de données supprime toutes les lignes qu'il a spécifiées.
Quand faut-il désactiver le Housekeeper ? Par exemple, s'il y a un « Item ID » et qu'il faut supprimer les 5 000 dernières lignes sur une certaine période. Bien sûr, cela se fait par index. Mais en général, le dataset est très volumineux, et la base de données lit toujours depuis le disque et le charge en cache. Cela représente toujours une opération très coûteuse pour la base de données et, selon la taille de la base, cela peut entraîner des problèmes de performance.
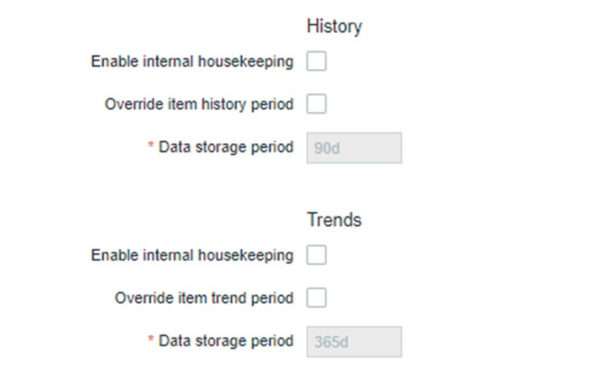
Le Housekeeper peut être simplement désactivé. Dans l'interface Web, il existe un paramètre dans « Administration générale » pour le Housekeeper. Nous désactivons le Housekeeping interne pour l'historique interne des tendances et il ne gère plus cela.
Le Housekeeper a été désactivé, les graphiques se sont stabilisés - quels problèmes pourraient survenir dans ce cas et que pourrait-il faire pour résoudre le troisième appel de performance ?
Partitionnement - ou sectionnement
En général, le partitionnement est configuré de différentes manières sur chaque base de données relationnelle que j'ai mentionnée. Chacune a sa propre technologie, mais elles se ressemblent dans l'ensemble. La création d'une nouvelle partition entraîne souvent certains problèmes.
En général, les partitions sont configurées en fonction de la « setup » - la quantité de données générées par jour. En règle générale, le partitionnement est établi sur une journée, c'est le minimum. Pour les tendances, une nouvelle partition est établie sur un mois.
Les valeurs peuvent changer en cas de très grande « setup ». Si la petite « setup » est de moins de 5 000 nvps (nouvelles valeurs par seconde), la moyenne est entre 5 000 et 25 000, tandis que la grande est au-dessus de 25 000 nvps. Ce sont de grandes et très grandes installations qui nécessitent un réglage minutieux de la base de données.
Sur de très grandes installations, un segment d'une journée peut ne pas être optimal. J'ai vu des partitions sur MySQL dépassant 40 Go ou plus par jour. C'est un volume de données très élevé qui peut poser des problèmes, et il doit être réduit.
Quels sont les avantages du partitionnement ?
Partitionnement des tables. Cela consiste souvent en des fichiers séparés sur le disque. Le plan de requêtes choisit de manière plus optimale une partition. En général, la partition est utilisée par plage — c'est également vrai pour Zabbix. Nous utilisons ici un «timestamp» — le temps depuis le début de l'époque. Ce sont des nombres ordinaires. Vous définissez le début et la fin de la journée — c'est la partition.
Suppression rapide — SUPPRIMER. Un fichier/sous-table est sélectionné, plutôt qu'un échantillon de lignes à supprimer.
Accélère considérablement la récupération des données SELECT — utilise une ou plusieurs partitions, plutôt que toute la table. Si vous demandez des données datant de deux jours, elles sont récupérées depuis la base de données plus rapidement, car il suffit de charger en cache et de fournir un seul fichier, au lieu d'une grande table.
Souvent, cela accélère également de nombreuses bases de données INSERT — les insertions dans la sous-table.
TimescaleDB
Pour la version 4.2, nous avons examiné TimescaleDB. C'est une extension pour PostgreSQL avec une interface native. L'extension fonctionne efficacement avec des données de séries temporelles, tout en conservant les avantages des bases de données relationnelles. TimescaleDB partitionne également automatiquement.
Dans TimescaleDB, il existe le concept de hypertable (hypertable), que vous créez. Elle contient des chunks — partitions. Les chunks sont des fragments de l'hypertable gérés automatiquement, qui n'affectent pas les autres fragments. Chaque chunk a sa propre plage temporelle.
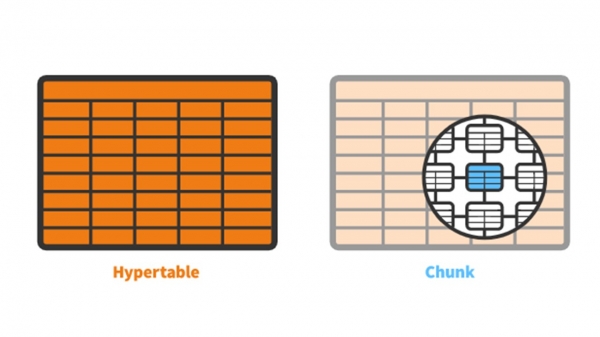
TimescaleDB vs PostgreSQL
TimescaleDB fonctionne vraiment efficacement. Les développeurs de l'extension affirment qu'ils utilisent un algorithme de traitement des requêtes plus approprié, notamment pour les inserts. Lorsque les tailles des inserts de dataset augmentent, l'algorithme maintient des performances constantes.
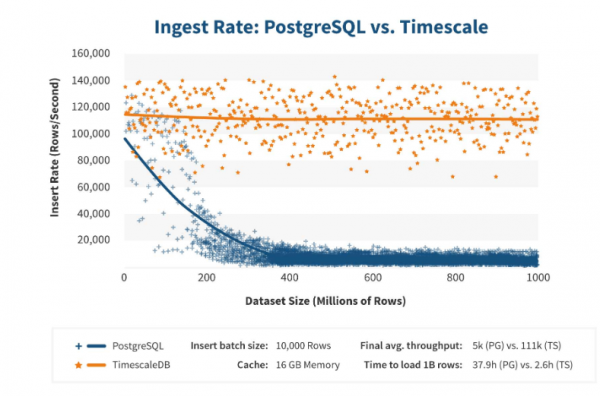
Après 200 millions de lignes, PostgreSQL commence généralement à fortement ralentir et perd en performance jusqu'à 0. TimescaleDB permet d'insérer des «inserts» efficacement, quel que soit le volume de données.
Installation
Installer TimescaleDB est assez simple pour tous les paquets. Dans tout est décrit en détail — cela dépend des paquets officiels de PostgreSQL. TimescaleDB peut également être construit et compilé manuellement.
Pour la base de données Zabbix, il suffit d'activer l'extension :
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Vous activez l' extension et la créez pour la base de données Zabbix. La dernière étape consiste à créer l'hypertable.
Migrez les tables d'historique vers TimescaleDB
Il existe une fonction spéciale pour cela create_hypertable:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
La fonction a trois paramètres. Le premier — la table dans la base de données, pour laquelle il faut créer une hypertable. Le deuxième — le champ, selon lequel il faut créer chunk_time_interval — l'intervalle des partitions de chunks à utiliser. Dans mon cas, l'intervalle est d'un jour — 86 400.
Le troisième paramètre — migrer_données. Si vous mettez true, toutes les données actuelles sont transférées dans les chunks déjà créés. J'ai utilisé migrer_données. J'avais environ 1 To, ce qui a pris plus d'une heure. Même dans certains cas lors des tests, j'ai supprimé les anciennes données d'historique inutiles pour ne pas les transférer.
La dernière étape — UPDATE: dans db_extension nous fixons timescaledb, afin que la base de données comprenne qu'il existe cette extension. Zabbix l'active et utilise correctement la syntaxe et les requêtes à la base de données — ces fonctionnalités nécessaires pour TimescaleDB.
Configuration matérielle
J'ai utilisé deux serveurs. Le premier — machine VMware. Elle est assez petite : 20 processeurs Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 Go de RAM et un disque SSD de 200 Go.
J'ai installé PostgreSQL 10.8 dessus avec l'OS Debian 10.8-1.pgdg90+1 et un système de fichiers xfs. J'ai fait les réglages minimaux pour utiliser cette base de données, excepté ce que Zabbix va utiliser lui-même.
Sur cette même machine se trouvaient le serveur Zabbix, PostgreSQL et les agents de charge. J'avais 50 agents actifs qui utilisaient LoadableModule, afin de générer très rapidement différents résultats : chiffres, chaînes. Je remplissais la base avec une grande quantité de données.
Initialement, la configuration contenait 5 000 éléments de données par hôte. Presque chaque élément contenait un déclencheur, afin que cela ressemble à de vraies installations. Dans certains cas, il y avait plus d'un déclencheur. Pour un nœud du réseau, il y avait 3 000 à 7 000 déclencheurs.
L'intervalle de mise à jour des éléments de données — 4 à 7 secondesJ'ai régulé la charge en utilisant non seulement 50 agents, mais j'en ai ajouté d'autres. De plus, grâce aux éléments de données dynamiques, j'ai ajusté la charge et réduit l'intervalle de mise à jour à 4 secondes.
PostgreSQL. 35 000 nvps
Mon premier lancement sur ce matériel s'est fait avec PostgreSQL pur — 35 000 valeurs par seconde. Comme on peut le voir, l'insertion des données prend des fractions de seconde — tout fonctionne bien et rapidement. La seule chose est que le disque SSD de 200 Go se remplit rapidement.
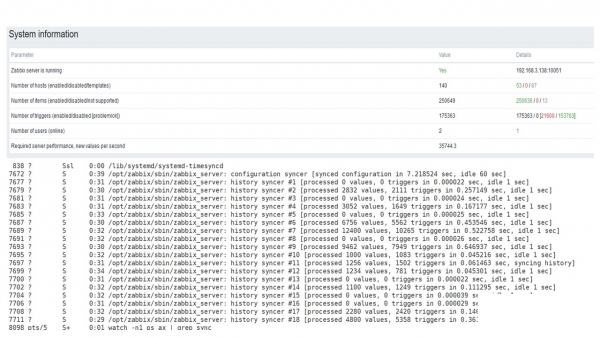
Voici le tableau de bord standard de performance de Zabbix — serveurs.
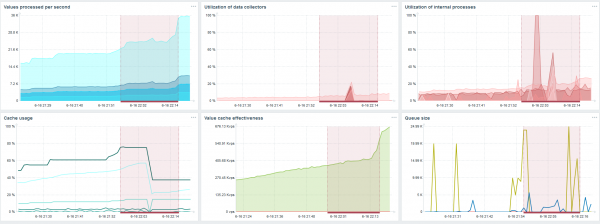
Le premier graphique bleu montre le nombre de valeurs par seconde. Le second graphique à droite montre la charge des processus de collecte. Le troisième indique la charge des processus internes de collecte : history syncers et Housekeeper, qui a fonctionné ici pendant une durée suffisante.
Le quatrième graphique montre l'utilisation de HistoryCache. C'est une sorte de tampon avant l'insertion dans la base de données. Le cinquième graphique vert indique l'utilisation de ValueCache, c'est-à-dire combien de hits de ValueCache pour les déclencheurs — ce sont plusieurs milliers de valeurs par seconde.
PostgreSQL. 50 000 nvps
Ensuite, j'ai augmenté la charge à 50 000 valeurs par seconde sur ce même matériel.
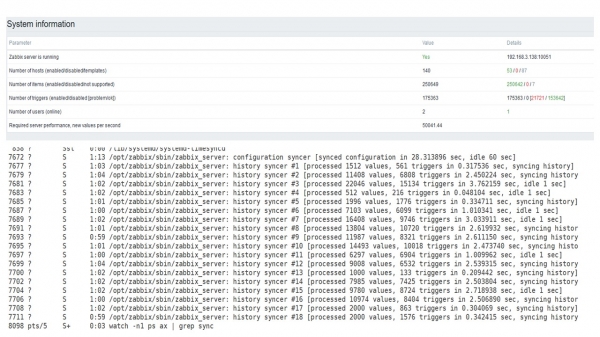
Lors du chargement avec Housekeeper, l'insertion de 10 000 valeurs s'écrivait en 2 à 3 secondes.
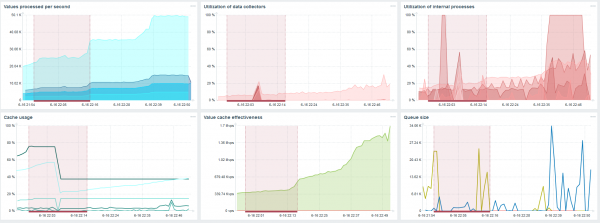
Housekeeper commence déjà à interférer avec le fonctionnement.
D'après le troisième graphique, on peut voir que, dans l'ensemble, la charge des trappeurs et des history syncers est encore à 60 %. Sur le quatrième graphique, HistoryCache commence à se remplir assez activement pendant le fonctionnement de Housekeeper. Il est rempli à 20 % — soit environ 0,5 Go.
PostgreSQL. 80 000 nvps
Ensuite, j'ai augmenté la charge à 80 000 valeurs par seconde. Cela représente environ 400 000 éléments de données et 280 000 déclencheurs.
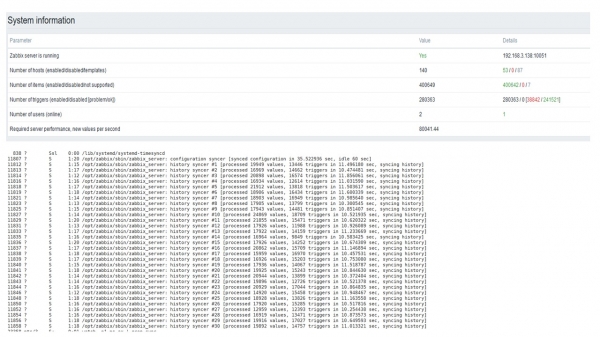
L'insertion avec la charge de trente history syncers est déjà suffisamment élevée.
J'ai également augmenté divers paramètres : history syncers, caches.
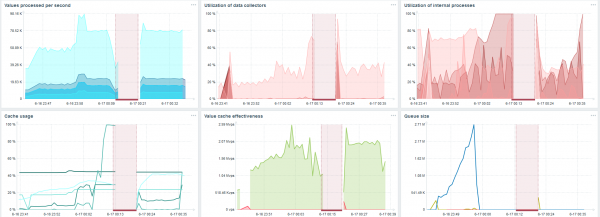
Sur mon matériel, la charge des history syncers atteignait son maximum. HistoryCache s'est rapidement rempli de données — des données ont été accumulées dans le tampon pour traitement.
Tout ce temps, j'ai surveillé l'utilisation du processeur, de la mémoire vive et d'autres paramètres système, et j'ai découvert que l'utilisation des disques était maximale.
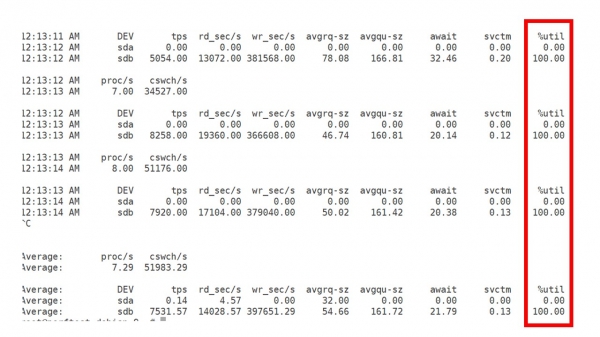
J'ai atteint l'utilisation des capacités maximales du disque sur ce matériel et cette machine virtuelle. Avec une telle intensité, PostgreSQL a commencé à vider les données assez activement, et le disque n'était plus capable de fonctionner correctement pour les écritures et les lectures.
Deuxième serveur
J'ai pris un autre serveur qui avait déjà 48 processeurs et 128 Go de RAM. Je l'ai optimisé en installant 60 history syncer, et j'ai obtenu des performances acceptables.
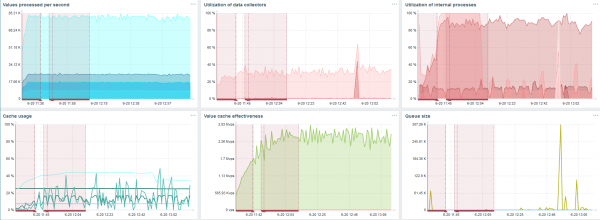
En fait, c'est déjà la limite de performance où il faut prendre des mesures.
TimescaleDB. 80 000 nvps
Mon principal objectif est d'évaluer les capacités de TimescaleDB sous la charge de Zabbix. 80 000 valeurs par seconde, c'est beaucoup, surtout avec une fréquence de collecte des métriques (à part Yandex, bien sûr) et un « setup » assez important.
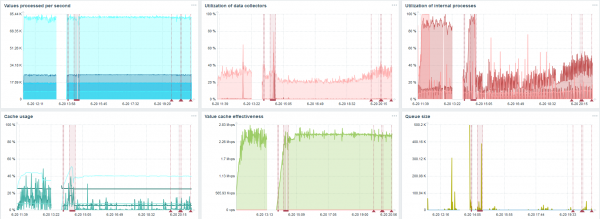
Sur chaque graphique, il y a un creux — c'est lors de la migration des données. Après ces creux, le profil de charge de history syncer sur le serveur Zabbix a énormément changé — il a chuté de trois fois.
TimescaleDB permet d'insérer des données presque trois fois plus vite et d'utiliser moins d'HistoryCache.
En conséquence, les données vous parviendront en temps opportun.
TimescaleDB. 120 000 nvps
Ensuite, j'ai augmenté le nombre d'éléments de données à 500 000. Mon principal objectif était d'évaluer les capacités de TimescaleDB — j'ai obtenu une valeur estimée de 125 000 valeurs par seconde.
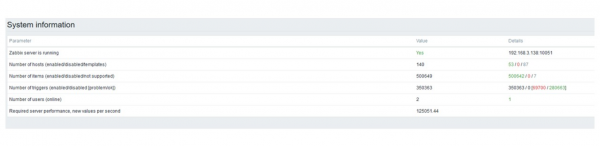
C'est un « setup » fonctionnel qui peut fonctionner longtemps. Mais comme mon disque n'était que de 1,5 To, je l'ai rempli en quelques jours.
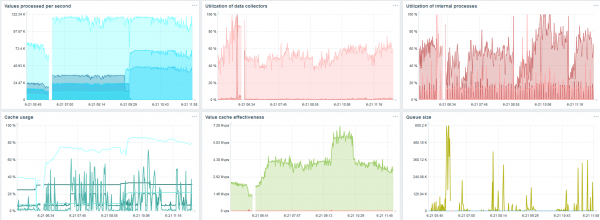
Le plus important, c'est qu'en même temps, de nouvelles partitions de TimescaleDB étaient créées.
Pour les performances, cela est complètement imperceptible. Lorsque des partitions sont créées dans MySQL, par exemple, c'est tout autre chose. Cela se produit généralement la nuit, car cela bloque les insertions globales, les opérations sur les tables et peut causer une dégradation du service. Ce n'est pas le cas avec TimescaleDB.
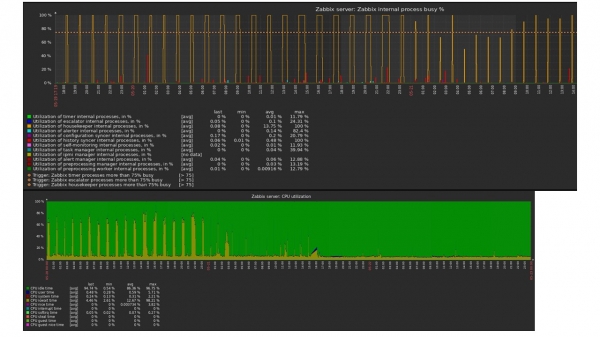
À titre d'exemple, je vais montrer un graphique parmi de nombreux autres dans la communauté. Sur l'image, TimescaleDB est activé, ce qui a permis de réduire la charge d'utilisation de io.weight sur le processeur. L'utilisation des éléments des processus internes a également diminué. D'ailleurs, c'est une machine virtuelle classique sur des disques classiques, et non sur SSD.
Conclusions
TimescaleDB est une bonne solution pour de petits « setup », qui sont limités par les performances du disque. Cela permettra de continuer à bien fonctionner jusqu'à ce que la base de données soit migrée sur un matériel plus rapide.
TimescaleDB est facile à configurer, offre un gain de performance, fonctionne bien avec Zabbix et présente des avantages par rapport à PostgreSQL..
Si vous utilisez PostgreSQL et que vous ne prévoyez pas de le changer, je recommande d'utiliser PostgreSQL avec l'extension TimescaleDB en tandem avec Zabbix.Cette solution fonctionne efficacement jusqu'à des « setup » moyens.
Quand nous parlons de « haute performance », nous faisons référence à . Il ne reste plus longtemps à attendre pour découvrir les technologies et pratiques permettant aux services de gérer des millions d'utilisateurs. La liste pour les 7 et 8 novembre est déjà établie, mais peuvent encore être proposés.
Abonnez-vous à notre et , où nous dévoilons des astuces pour la prochaine conférence, et découvrez comment en tirer le meilleur parti.
Source : habr.com
