

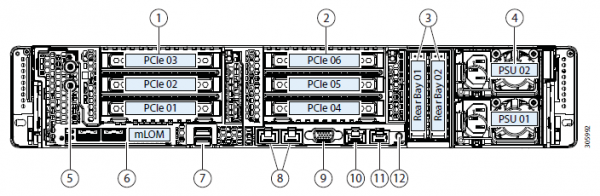
C'est un mythe assez répandu dans le domaine du matériel serveur. En pratique, les solutions hyperconvergées (tout-en-un) sont nécessaires pour de nombreuses raisons. Historiquement, les premières architectures ont été développées par Amazon et Google pour leurs services. L'idée était de créer un parc informatique composé de nœuds identiques, chacun ayant ses propres disques. Le tout était relié par un logiciel de système (hyperviseur) et divisé en machines virtuelles. L'objectif principal était de minimiser les efforts de maintenance d'un nœud et le minimum de problèmes lors de l'évolutivité : il suffisait d'ajouter quelques milliers de serveurs de ce type et de les connecter côte à côte. En pratique, ce sont des cas isolés, et la plupart du temps, il s'agit de moins de nœuds et d'une architecture légèrement différente.
Mais l'avantage reste le même : une simplicité extraordinaire à l'échelle et à la gestion. Le inconvénient est que différentes tâches consomment les ressources de manière variée, donc il y aura beaucoup de disques locaux par endroits, et ailleurs peu de RAM, etc. Cela signifie qu'avec différents types de tâches, l'utilisation des ressources sera diminuée.
Il en résulte que vous payez 10 à 15 % de plus pour la facilité de configuration. Ceci a donné naissance au mythe mentionné dans le titre. Nous avons longtemps cherché où la technologie pouvait être utilisée de manière optimale et nous avons trouvé. En effet, Cisco n'avait pas ses propres systèmes de stockage, mais ils voulaient conquérir le marché des serveurs. Ils ont donc créé Cisco Hyperflex — une solution avec des stockages locaux sur les nœuds.
Et cela a soudainement donné un très bon résultat pour les centres de données de secours (Disaster Recovery). Pourquoi et comment — je vais vous expliquer maintenant. Et je montrerai des tests de cluster.
Là où c'est nécessaire
L'hyperconvergence, c'est :
- Le transfert de disques dans les nœuds de calcul.
- Une intégration complète du sous-système de stockage avec le sous-système de virtualisation.
- Le transfert/intégration avec le sous-système réseau.
Cette combinaison permet de réaliser de nombreuses fonctionnalités du stockage au niveau de la virtualisation, le tout depuis une seule interface de gestion.
Notre entreprise a une forte demande pour des projets de conception de centres de données de secours, et il est souvent choisi précisément des solutions hyperconvergées en raison de nombreux choix de réplication (jusqu'au métro-cluster) disponibles dès la sortie de la boîte.
Dans le cas des centres de données secondaires, il s'agit généralement d'un site éloigné situé à l'autre bout de la ville ou même dans une autre ville. Cela permet de restaurer les systèmes critiques en cas de défaillance partielle ou totale du centre de données principal. Les données du serveur sont constamment répliquées, et cette réplication peut se faire au niveau de l'application ou au niveau de l'appareil de stockage (SAN).
Je vais donc vous parler de la structure du système et des tests, puis de quelques scénarios d'application réelle avec des données sur les économies réalisées.
Tests
Notre configuration est composée de quatre serveurs, chacun équipé de 10 disques SSD de 960 Go. Il y a un disque dédié pour la mise en cache des opérations d'écriture et pour le stockage d'une machine virtuelle de service. La solution elle-même est la quatrième version. La première était franchement instable (d'après les retours), la deuxième avait encore des défauts, la troisième était déjà assez stable, et celle-ci peut être considérée comme une version finale après avoir terminé les tests bêta auprès du grand public. Pendant la phase de test, je n'ai rencontré aucun problème, tout fonctionne parfaitement.
Modifications dans v4Un grand nombre de bogues ont été corrigés.
Au départ, la plateforme ne pouvait fonctionner qu'avec l'hyperviseur VMware ESXi et ne supportait qu'un nombre limité de nœuds. De plus, le processus de déploiement ne se terminait pas toujours avec succès, nécessitant le redémarrage de certaines étapes, il y avait des problèmes de mise à jour depuis d'anciennes versions, et les données dans l'interface graphique n'étaient pas toujours affichées correctement (bien que je ne sois pas encore ravi de l'affichage des graphiques de performance), et parfois des problèmes survenaient au niveau de la virtualisation.
Maintenant, tous les problèmes initiaux ont été corrigés, HyperFlex prend en charge à la fois ESXi et Hyper-V, et en plus de cela, il est possible de :
- Créer un cluster étendu.
- Créer un cluster pour des bureaux sans utiliser de Fabric Interconnect, de deux à quatre nœuds (nous achetons uniquement les serveurs).
- Possibilité de travailler avec des SAN externes.
- Support des conteneurs et de Kubernetes.
- Créer des zones de disponibilité.
- Intégration avec VMware SRM, si la fonctionnalité intégrée ne convient pas.
L'architecture ne diffère pas beaucoup de celle des principaux concurrents, pas besoin de réinventer la roue. Tout cela fonctionne sur une plateforme de virtualisation VMware ou Hyper-V. Au niveau matériel, cela s'implante sur des serveurs développés en interne par Cisco UCS. Certaines personnes détestent la plateforme en raison de la relative complexité de sa configuration initiale, de ses nombreux boutons, de son système de modèles et de dépendances non trivial, mais d'autres ont compris l'essence de l'idée et ne souhaitent plus travailler avec d'autres serveurs.
Nous allons examiner la solution pour VMware, car elle a été initialement conçue pour cela et offre plus de fonctionnalités, tandis que Hyper-V a été amélioré au fil du temps pour ne pas échapper à la concurrence et répondre aux attentes du marché.
Il y a un cluster de serveurs équipés de disques. Il y a des disques pour le stockage des données (SSD ou HDD selon vos besoins), ainsi qu'un SSD pour le caching. Lors de l'écriture des données sur le datastore, celles-ci sont d'abord sauvegardées sur la couche de cache (disque SSD dédié et RAM de la VM de service). Parallèlement, le bloc de données est envoyé sur les nœuds du cluster (le nombre de nœuds dépend du facteur de réplication du cluster). Après confirmation de l'écriture réussie par tous les nœuds, la confirmation est envoyée à l'hyperviseur, puis à la VM. Les données écrites sont ensuite dédupliquées, compressées et sauvegardées sur les disques de stockage en arrière-plan. De plus, des blocs importants sont toujours écrits séquentiellement sur les disques de stockage, ce qui réduit la charge sur ceux-ci.
La déduplication et la compression sont activées en permanence et ne peuvent pas être désactivées. La lecture des données se fait directement à partir des disques de stockage ou du cache RAM. Si une configuration hybride est utilisée, la lecture est également mise en cache sur le disque SSD.
Les données ne sont pas liées à l'emplacement actuel de la machine virtuelle et sont réparties uniformément entre les nœuds. Cette approche permet de charger de manière égale tous les disques et interfaces réseau. Il y a un inconvénient évident : nous ne pouvons pas minimiser au maximum la latence de lecture, car il n'y a aucune garantie que les données sont localement disponibles. Mais je pense que c'est un sacrifice insignifiant comparé aux avantages obtenus. De plus, les latences réseau ont atteint de tels niveaux qu'elles n'affectent pratiquement plus le résultat global.
La logique de fonctionnement de la sous-système de stockage est gérée par une machine virtuelle de service spéciale, le contrôleur Cisco HyperFlex Data Platform, qui est créée sur chaque nœud de stockage. Dans notre configuration, cette VM de service dispose de huit vCPU et de 72 Go de RAM, ce qui n'est pas négligeable. Je rappelle que l'hôte possède 28 cœurs physiques et 512 Go de RAM.
La VM de service a accès aux disques physiques directement via le passage du contrôleur SAS dans la VM. Les communications avec l'hyperviseur se font par le biais d'un module spécial IOVisor qui intercepte les opérations d'entrée/sortie, ainsi qu'à l'aide d'un agent qui permet de transmettre des commandes à l'API de l'hyperviseur. L'agent s'occupe de la gestion des snapshots et des clones HyperFlex.
Dans l'hyperviseur, les ressources de stockage sont montées en tant que partages NFS ou SMB (selon le type d'hyperviseur, devinez où se trouve quoi). En coulisses, il s'agit d'un système de fichiers distribué capable d'ajouter des fonctionnalités typiques des systèmes de stockage avancés : allocation fine des volumes, compression et dé-duplication, snapshots par technologie Redirect-on-Write, réplication synchrone/asynchrone.
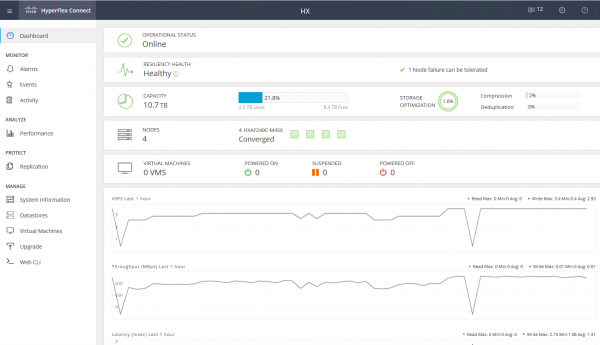
La VM de service fournit un accès à l'interface web de gestion du sous-système HyperFlex. Il existe une intégration avec vCenter, et la plupart des tâches quotidiennes peuvent être effectuées depuis celui-ci, mais il est plus pratique de découper les datastores à partir d'une interface web séparée, si vous êtes déjà passé à l'interface HTML5 rapide, ou d'utiliser un client Flash complet avec intégration totale. Dans l'interface web de service, vous pouvez consulter les performances et le statut détaillé du système.
Il existe un autre type de nœud dans le cluster — les nœuds de calcul. Ce peuvent être des serveurs en rack ou des serveurs blade sans disques intégrés. Sur ces serveurs, vous pouvez faire fonctionner des VM dont les données sont stockées sur des serveurs avec disques. Du point de vue de l'accès aux données, il n'y a pas de différence entre les types de nœuds, car l'architecture suppose une abstraction de la localisation physique des données. Le ratio maximum de nœuds de calcul à nœuds de stockage est de 2:1.
L'utilisation de nœuds de calcul augmente la flexibilité lors de l'évolutivité des ressources du cluster : nous n'avons pas besoin d'acheter des nœuds avec disques si nous avons uniquement besoin de CPU/RAM. De plus, nous pouvons ajouter un châssis blade et réaliser des économies sur la mise en rack des serveurs.
En résumé, nous avons une plateforme hyper-convergente avec les fonctionnalités suivantes :
- Jusqu'à 64 nœuds dans le cluster (jusqu'à 32 nœuds de stockage).
- Le nombre minimum de nœuds dans le cluster est de trois (deux pour le cluster Edge).
- Mécanisme de redondance des données : miroir avec un facteur de réplication de 2 et 3.
- Metro-cluster.
- Réplique asynchrone des VM sur un autre cluster HyperFlex.
- Orchestration du basculement des VM vers un centre de données distant.
- Snapshots natifs utilisant la technologie Redirect-on-Write.
- Jusqu'à 1 Po d'espace utile avec un facteur de réplication de 3 et sans tenir compte de la déduplication. Le facteur de réplication de 2 n'est pas pris en compte, car il ne constitue pas une option sérieuse.
Un autre gros avantage est la simplicité de gestion et de déploiement. Toutes les complexités de la configuration des serveurs UCS sont prises en charge par une VM spécialisée, préparée par les ingénieurs de Cisco.
Configuration du banc d'essai :
- 2 x Cisco UCS Fabric Interconnect 6248UP en tant que cluster de gestion et composants réseau (48 ports fonctionnant en mode Ethernet 10G/FC 16G).
- Quatre serveurs Cisco UCS HXAF240 M4.
Caractéristiques des serveurs :
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32 Go DDR4-2400-MHz RDIMM/PC4-19200/rangée double/x4/1,2 V
Réseau
UCSC-MLOM-CSC-02 (VIC 1227). 2 ports Ethernet 10G
HBA de stockage
Contrôleur SAS pass-through modulaire Cisco 12G
Disques de stockage
1 x SSD Intel S3520 120 Go, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 Go
Plus d'options de configurationEn plus du matériel choisi, les options suivantes sont actuellement disponibles :
- HXAF240c M5.
- Un ou deux CPU allant d'Intel Silver 4110 à Intel Platinum I8260Y. La deuxième génération est disponible.
- 24 emplacements mémoire, modules de 16 Go RDIMM 2600 à 128 Go LRDIMM 2933.
- De 6 à 23 disques pour les données, un disque de cache, un disque système et un disque de démarrage.
Disques de capacité
- HX-SD960G61X-EV 960 Go SSD SATA 2,5 pouces sur le marché entreprise 6G (1X endurance) SAS 960 Go.
- HX-SD38T61X-EV 3,8 To SSD SATA 2,5 pouces sur le marché entreprise 6G (1X endurance) SAS 3,8 To.
- Disques de mise en cache
- HX-NVMEXPB-I375 375 Go SSD 2,5 pouces Intel Optane, performance et endurance extrêmes.
- HX-NVMEHW-H1600* 1,6 To SSD 2,5 pouces Ent. Perf. NVMe (3X endurance) NVMe 1,6 To.
- HX-SD400G12TX-EP 400 Go SSD 2,5 pouces Ent. Perf. 12G SAS (10X endurance) SAS 400 Go.
- HX-SD800GBENK9** 800 Go SSD 2,5 pouces Ent. Perf. 12G SAS SED (10X endurance) SAS 800 Go.
- HX-SD16T123X-EP 1,6 To SSD 2,5 pouces de performance entreprise 12G SAS (3X endurance).
Disques système / journal
- HX-SD240GM1X-EV 240 Go SSD SATA 2,5 pouces sur le marché entreprise 6G SATA (nécessite une mise à niveau).
Disques de démarrage
- HX-M2-240GB 240 Go SSD SATA M.2 SATA 240 Go.
Connexion réseau via des ports Ethernet 40G, 25G ou 10G.
Les FI peuvent être HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Le test lui-même
Pour tester le système de disques, j'ai utilisé HCIBench 2.2.1. Il s'agit d'un utilitaire gratuit qui permet d'automatiser la création de charge à partir de plusieurs machines virtuelles. La charge elle-même est générée par le fio classique.
Notre cluster est composé de quatre nœuds, avec un facteur de réplication de 3, tous les disques sont Flash.
Pour les tests, j'ai créé quatre datastores et huit machines virtuelles. Pour les tests d'écriture, il est supposé que le disque de cache ne sera pas saturé.
Les résultats des tests sont les suivants :
100 % Lecture 100 % Aléatoire
0 % Lecture 100 % Aléatoire
Blaque/profondeur de la file d'attente
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376,484 IOPS
5,47 ms 373,176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Les valeurs en gras indiquent les seuils au-delà desquels il n'y a plus d'augmentation de performance, parfois une dégradation est même observée. Cela est dû à la saturation de la performance du réseau/contrôleurs/disques.
- Lecture séquentielle 4432 Mo/s.
- Écriture séquentielle 804 Mo/s.
- En cas de défaillance d'un contrôleur (défaillance d'une machine virtuelle ou d'un hôte), la performance est réduite de moitié.
- En cas de défaillance d'un disque de stockage, la diminution de performance est d'un tiers. La reconstruction d'un disque utilise 5 % des ressources de chaque contrôleur.
Avec un petit bloc, nous atteignons la limite de performance du contrôleur (machine virtuelle), son CPU est chargé à 100 %, en augmentant le bloc, nous atteignons la bande passante des ports. 10 Gbit/s n'est pas suffisant pour libérer le potentiel des systèmes AllFlash. Malheureusement, les paramètres de la démonstration fournie ne permettent pas de tester à 40 Gbit/s.
D'après mes impressions des tests et de l'étude de l'architecture, grâce à l'algorithme qui répartit les données entre tous les hôtes, nous obtenons une performance prévisible et évolutive, mais cela est aussi une limitation lors de la lecture, car nous pourrions tirer parti de disques locaux plus rapides ; une meilleure performance réseau pourrait aider, par exemple avec des FI à 40 Gbit/s.
Un seul disque pour la mise en cache et la déduplication peut également poser une contrainte, car dans cette configuration, nous ne pouvons écrire que sur quatre SSD. Il serait idéal de pouvoir augmenter le nombre de disques de cache et de constater la différence.
Utilisation réelle
Pour organiser un site secondaire de sauvegarde, deux approches peuvent être utilisées (nous ne considérons pas le stockage de sauvegardes sur un site distant) :
- Actif-Passif. Toutes les applications sont hébergées dans le centre de données principal. La réplication peut être synchrone ou asynchrone. En cas de panne du centre de données principal, nous devons activer le secours. Cela peut être fait manuellement, par scripts ou par des applications d'orchestration. Ici, nous obtiendrons un RPO équivalent à la fréquence de réplication, et le RTO dépend de la réaction et des compétences de l'administrateur ainsi que de la qualité de la préparation et du débogage du plan de basculement.
- Actif-Actif. Dans ce cas, seule la réplication synchrone est présente, la disponibilité des centres de données est déterminée par un quorum/arbitre, situé strictement sur un troisième site. RPO = 0, et le RTO peut atteindre 0 (si l'application le permet) ou être égal au temps nécessaire pour traiter la défaillance d'un nœud dans le cluster de virtualisation. Un cluster étendu (Metro) est créé au niveau de la virtualisation, nécessitant un stockage actif-actif.
Nous voyons généralement chez nos clients une architecture déjà mise en œuvre avec un stockage classique dans le centre de données principal, c'est pourquoi nous concevons un autre pour la réplication. Comme je l'ai mentionné, Cisco HyperFlex propose une réplication asynchrone et la création d'un cluster de virtualisation étendu. Cela signifie que nous n'avons pas besoin de stockage Niveau Midrange et supérieur avec des fonctions de réplication et d'accès actif-actif aux données sur deux systèmes de stockage coûteux.
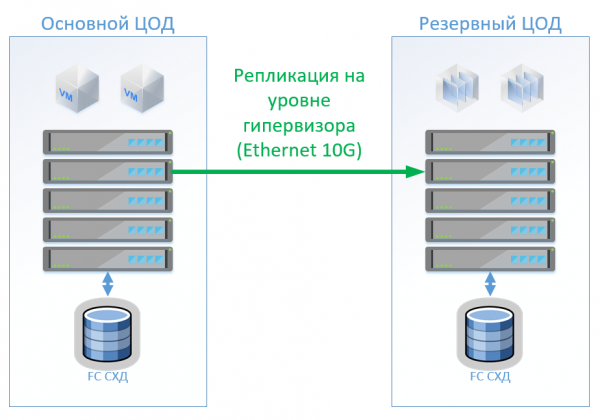
Scénario 1: Nous avons un centre de données principal et un centre de données de secours, avec une plateforme de virtualisation sur VMware vSphere. Tous les systèmes de production sont situés dans le centre de données principal, tandis que la réplication des machines virtuelles s'effectue au niveau de l'hyperviseur, ce qui permet de ne pas garder les VM allumées dans le centre de données de secours. Les bases de données et les applications spécifiques sont répliquées avec des outils intégrés et nous gardons les VM allumées. En cas de défaillance du centre de données principal, nous lançons les systèmes dans le centre de données de secours. Nous estimons qu'il y a environ 100 machines virtuelles. Tant que le centre de données principal est opérationnel, des environnements de test et d'autres systèmes peuvent être lancés dans le centre de données de secours, qui peuvent être désactivés en cas de basculement du centre de données principal. Une option est également possible où nous utilisons une réplication bidirectionnelle. Du point de vue matériel, rien ne changera.
Dans le cadre de l'architecture classique, nous installerons dans chaque centre de données un système de stockage hybride avec accès par FibreChannel, tiering, déduplication et compression (mais pas en ligne), 8 serveurs par site, avec 2 commutateurs FibreChannel et Ethernet 10G. Pour la réplication et la gestion du basculement dans une architecture classique, nous pouvons utiliser les outils VMware (Replication + SRM) ou des outils tiers, qui seront un peu moins chers et parfois plus pratiques.
Le schéma est présenté dans l'illustration.
En utilisant Cisco HyperFlex, on obtient l'architecture suivante :
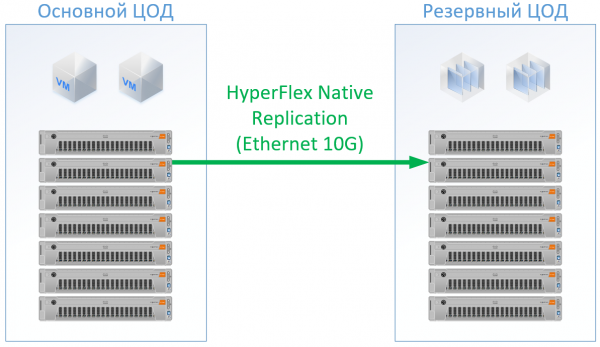
Pour HyperFlex, j'ai utilisé des serveurs dotés de grandes ressources en CPU/RAM, car une partie des ressources sera dédiée à la VM du contrôleur HyperFlex, et j'ai même légèrement surdimensionné la configuration d'HyperFlex en CPU et en mémoire, afin de ne pas privilégier Cisco et de garantir des ressources pour les autres VMs. En revanche, nous pouvons nous passer des commutateurs FibreChannel, et nous n'aurons pas besoin de ports Ethernet pour chaque serveur, le trafic local étant commuté à l'intérieur de l'infrastructure intégrée (FI).
Au final, la configuration suivante a été obtenue pour chaque centre de données :
Serveurs
8 x serveur 1U (384 Go RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 Go RAM, 2 x Intel Gold 6150, 3,2 Go SSD, 10 x 6 To NL-SAS)
SAN
Système de stockage hybride avec interface FC Front-End (20 To SSD, 130 To NL-SAS)
—
LAN
2 x commutateur Ethernet 10G 12 ports
—
SAN
2 x commutateur FC 32/16 Gb 24 ports
2 x Cisco UCS FI 6332
Licences
VMware Ent Plus
Réplication et/ou orchestration du basculement des VMs
VMware Ent Plus
Pour Hyperflex, je n'ai pas prévu de licences pour le logiciel de réplication, car cela est disponible en standard.
Pour l'architecture classique, j'ai choisi un fournisseur qui s'est imposé comme un fabricant de qualité et à prix raisonnable. Pour les deux options, j'ai appliqué une réduction standard pour la solution, ce qui m'a permis d'obtenir des prix réels.
La solution sur Cisco HyperFlex s'est avérée être 13 % moins chère.
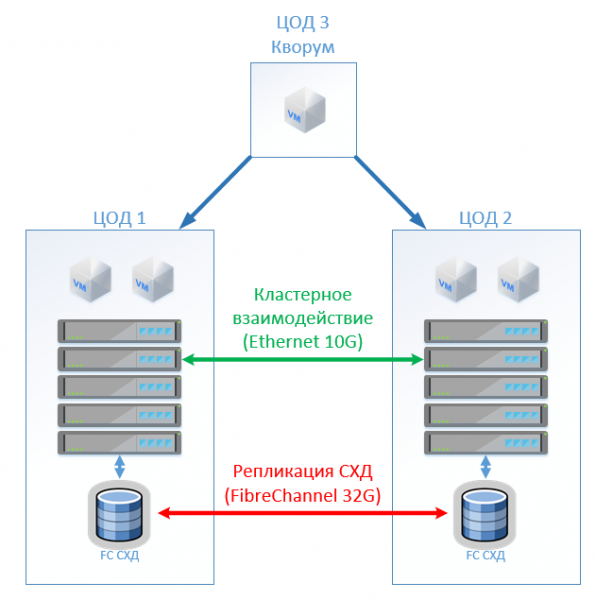
Scénario 2 : création de deux centres de données actifs. Dans ce scénario, nous concevons un cluster étendu sur VMware.
L'architecture classique se compose de serveurs de virtualisation, SAN (protocole FC) et deux systèmes de stockage capables de lire et d'écrire sur le stockage, réparti entre eux. Pour chaque système de stockage, nous prévoyons une capacité utile pour le local.
Avec HyperFlex, nous créons simplement un Stretch Cluster avec le même nombre de nœuds sur les deux sites. Dans ce cas, un facteur de réplication 2+2 est utilisé.
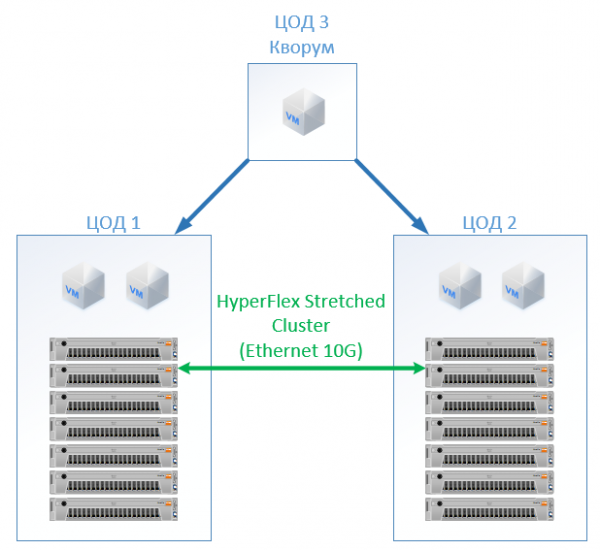
La configuration suivante a été obtenue :
Architecture classique
HyperFlex
Serveurs
16 x serveur 1U (384 Go RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 Go RAM, 2 x Intel Gold 6132, 1,6 To NVMe, 12 x 3,8 To SSD, VIC 1387)
SAN
2 x systèmes de stockage AllFlash (150 To SSD)
—
LAN
4 x commutateur Ethernet 10G 24 ports
—
SAN
4 x commutateur FC 32/16 Gb 24 ports
4 x Cisco UCS FI 6332
Licences
VMware Ent Plus
VMware Ent Plus
Dans tous mes calculs, je n'ai pas pris en compte l'infrastructure réseau, les coûts du centre de données, etc. : ceux-ci seront les mêmes pour l'architecture classique et pour la solution HyperFlex.
En termes de coût, HyperFlex s'est avéré 5 % plus cher. Il convient de noter qu'en ce qui concerne les ressources CPU/RAM, j'ai rencontré un déséquilibre pour Cisco, car j'ai réparti uniformément les canaux des contrôleurs de mémoire dans la configuration. Le coût est un peu plus élevé, mais pas de manière significative, ce qui indique clairement que l'hyperconvergence n'est pas nécessairement un "jouet pour les riches" et peut rivaliser avec l'approche standard de construction de centres de données. Cela peut également intéresser ceux qui possèdent déjà des serveurs Cisco UCS et l'infrastructure correspondante.
Parmi les avantages, nous obtenons l'absence de coûts d'administration pour le SAN et le stockage, la compression et la déduplication en ligne, un point d'entrée unique pour le support (virtualisation, serveurs, également — stockage), des économies d'espace (mais pas dans tous les scénarios), et une simplification de l'exploitation.
En ce qui concerne le support, vous le recevrez d'un seul fournisseur — Cisco. Si je me base sur mon expérience avec les serveurs Cisco UCS, je l'apprécie, car je n'ai jamais eu besoin d'ouvrir HyperFlex, tout fonctionnait déjà. Les ingénieurs répondent rapidement et peuvent résoudre non seulement des problèmes typiques mais aussi des cas limites complexes. Il m'arrive de les contacter avec des questions telles que : « Est-ce qu'il est possible de faire cela, d'ajouter ceci ? » ou « J'ai configuré quelque chose, et ça ne veut pas fonctionner. Aidez-moi ! » — ils prendront patiemment le temps de trouver le bon guide et d'indiquer les bonnes actions, sans répondre : « Nous ne gérons que les problèmes matériels. »
Liens
- Mon email est StGeneralov@croc.ru
Source : habr.com
