

Le système de recommandation de contenu vidéo en ligne sur lequel nous travaillons est un développement commercial fermé et se compose techniquement d'un cluster multi-composants constitué d'éléments propriétaires et open source. L'objectif de cet article est de décrire l'implémentation du système de clustering Docker Swarm pour une plateforme staging, sans perturber notre workflow établi dans un délai limité. Le récit que nous vous présentons est divisé en deux parties. La première partie décrit le CI/CD avant l'utilisation de Docker Swarm, et la seconde aborde le processus de son implémentation. Ceux qui ne souhaitent pas lire la première partie peuvent passer directement à la seconde.
Partie I
Il y a longtemps, il était nécessaire de configurer le processus CI/CD le plus rapidement possible. L'une des conditions était de ne pas utiliser Docker pour le déploiement des composants développés pour plusieurs raisons :
- pour un fonctionnement plus fiable et stable des composants en production (c'est-à-dire en réalité, il était impératif de ne pas utiliser la virtualisation)
- les principaux développeurs ne souhaitaient pas travailler avec Docker (c'est étrange, mais c'était le cas)
- pour des raisons idéologiques de la direction de la R&D
L'infrastructure, la pile technologique et les exigences initiales approximatives pour le MVP étaient les suivantes :
- 4 serveurs Intel® X5650 avec Debian (une machine plus puissante entièrement dédiée au développement)
- Le développement de composants personnalisés se fait en C++, Python3
- Les principaux outils tiers utilisés : Kafka, Clickhouse, Airflow, Redis, Grafana, Postgresql, Mysql, …
- Les pipelines de construction et de test des composants sont séparés pour debug et release
L'une des premières questions à résoudre au stade initial est la manière dont les composants personnalisés seront déployés dans un environnement (CI/CD).
Les composants tiers ont été décidés d'être installés et mis à jour systématiquement. Les applications personnalisées, développées en C++ ou Python, peuvent être déployées de plusieurs manières. Parmi elles, par exemple : la création de paquets système, leur envoi dans le dépôt des images compilées et leur installation ultérieure sur les serveurs. Pour des raisons inconnues, une autre méthode a été choisie, à savoir : à l'aide de CI, les fichiers exécutables des applications sont compilés, un environnement virtuel du projet est créé, les modules py sont installés à partir de requirements.txt et tous ces artefacts sont envoyés avec les configurations, scripts et l'environnement d'accompagnement des applications sur les serveurs. Ensuite, les applications sont lancées par un utilisateur virtuel sans droits d'administrateur.
Le système CI/CD choisi était Gitlab-CI. Le pipeline résultant ressemblait à peu près à ceci :
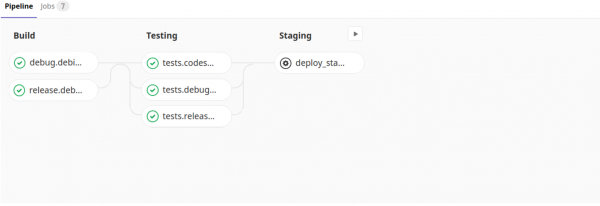
Structuellement, gitlab-ci.yml se présentait comme suit
---
variables:
  # version minimale du CPU sur les serveurs où le cluster est déployé
  CMAKE_CPUTYPE: "westmere"

  DEBIAN: "MYREGISTRY:5000/debian:latest"

before_script:
  - eval $(ssh-agent -s)
  - ssh-add  ~/.ssh/config

stages:
  - build
  - testing
  - deploy

debug.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always
release.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always

## stage de test
tests.codestyle:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -t codestyle -b "${CI_COMMIT_REF_NAME}_codestyle"
tests.debug.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - debug.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_debug"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week
tests.release.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_release"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week

## stage de mise en scène
deploy_staging:
  stage: deploy
  environment: staging
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - cd scripts/deploy/ &&
        python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
        /bin/bash install_venv.sh -d -r ../../requirements.txt &&
        python3 prepare_init.d.py &&
        python3 deploy.py -s $CI_ENVIRONMENT_NAME
  when: manual
Il convient de noter que la compilation et les tests sont effectués sur une image propriétaire où tous les paquets système nécessaires sont déjà installés et d'autres configurations sont effectuées.
Bien que chacun de ces scripts dans les jobs soit intéressant à sa manière, je ne vais bien sûr pas les décrire car cela prendrait beaucoup de temps et ce n'est pas l'objectif de cet article. Je vais juste souligner que la phase de déploiement consiste en une séquence d'appels de scripts :
- createconfig.py — crée le fichier settings.ini avec les paramètres des composants dans différents environnements pour un déploiement ultérieur (Préproduction, Production, Test, …)
- install_venv.sh — crée un environnement virtuel pour les composants py dans un répertoire spécifique et le copie sur les serveurs distants
- prepare_init.d.py — prépare les scripts de démarrage/arrêt des composants sur la base d'un modèle
- deploy.py — déploie et redémarre les nouveaux composants
Le temps a passé. La phase de staging a été remplacée par la préproduction et la production. Le support du produit a été ajouté sur une autre distribution (CentOS). Cinq serveurs physiques puissants et une dizaine de serveurs virtuels supplémentaires ont été ajoutés. Les développeurs et les testeurs trouvaient de plus en plus difficile d'exécuter leurs tâches dans un environnement qui se rapprochait d'un état de travail. À ce moment-là, il est devenu clair qu'on ne pouvait pas s'en passer…
Partie II
Ainsi, notre cluster est un spectacle à part, un système composé de quelques dizaines de composants distincts, non décrits par des Dockerfiles. Le configurer pour un déploiement dans un environnement spécifique ne peut se faire que globalement. Notre tâche consiste à déployer le cluster dans un environnement de staging pour le tester avant les tests de pré-lancement.
Théoriquement, il peut y avoir plusieurs clusters fonctionnant en même temps : autant qu'il y a de tâches dans un état terminé ou proche de l'achèvement. Les capacités des serveurs à notre disposition permettent de lancer plusieurs clusters sur chaque serveur. Chaque cluster de staging doit être isolé (il ne doit pas y avoir de chevauchement sur les ports, les répertoires, etc.).
La ressource la plus précieuse est notre temps, et nous en avions peu.
Pour un démarrage plus rapide, nous avons choisi Docker Swarm en raison de sa simplicité et de la flexibilité de son architecture. La première chose que nous avons faite a été de créer un gestionnaire sur les serveurs distants et plusieurs nœuds :
$ docker node ls
ID                            HOSTNAME            STATUS              AVAILABILITY        MANAGER STATUS      ENGINE VERSION
kilqc94pi2upzvabttikrfr5d     nop-test-1     Prêt                Actif                                   19.03.2
jilwe56pl2zvabupryuosdj78     nop-test-2     Prêt                Actif                                   19.03.2
j5a4yz1kr2xke6b1ohoqlnbq5 *   nop-test-3     Prêt                Actif              Leader              19.03.2
Ensuite, nous avons créé un réseau :
$ docker network create --driver overlay --subnet 10.10.10.0/24 nw_swarm
Ensuite, nous avons lié Gitlab-CI et les nœuds Swarm pour la gestion distante des nœuds depuis CI : installation des certificats, configuration des variables secrètes, ainsi que la configuration du service Docker sur le serveur de gestion. Voici cela nous a fait économiser beaucoup de temps.
Ensuite, nous avons ajouté des jobs de création et de destruction de pile dans .gitlab-ci .yml.
Le fichier .gitlab-ci .yml a reçu plusieurs nouveaux jobs
## staging stage
deploy_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
    CI_BIN_DEPENDENCIES_JOB: "release.centos.7"
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack deploy -c docker-compose.yml ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME} --with-registry-auth
    - rm -rf $DOCKER_CERT_PATH
  when: manual

## stop staging stage
stop_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack rm ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME}
    # TODO: need check that stopped
  when: manual
Dans l'extrait de code ci-dessus, on voit que deux boutons (deploy_staging, stop_staging) ont été ajoutés dans Pipelines, nécessitant une intervention manuelle.
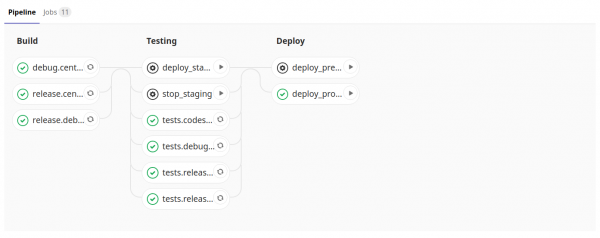
Le nom de la pile correspond au nom de la branche et cette unicité devrait suffire. Les services de la pile reçoivent des adresses IP uniques, tandis que les ports, répertoires, etc. seront isolés mais identiques d'une pile à l'autre (car le fichier de configuration est identique pour toutes les piles) — c'est ce que nous voulions atteindre. Nous déployons la pile (cluster) à l'aide de docker-compose.yml, dans lequel notre cluster est décrit.
docker-compose.yml
---
version: '3'

services:
  userprop:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:
  celery_bcd:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  schedulerdb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: schedulerdb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    command: ['--character-set-server=utf8mb4', '--collation-server=utf8mb4_unicode_ci', '--explicit_defaults_for_timestamp=1']
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  celerydb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: celerydb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  cluster:
    image: $CENTOS7
    environment:
      - CENTOS
      - CI_ENVIRONMENT_NAME
      - CI_API_V4_URL
      - CI_REPOSITORY_URL
      - CI_PROJECT_ID
      - CI_PROJECT_URL
      - CI_PROJECT_PATH
      - CI_PROJECT_NAME
      - CI_COMMIT_REF_NAME
      - CI_BIN_DEPENDENCIES_JOB
    command: >
      sudo -u myusername -H /bin/bash -c ". /etc/profile &&
        mkdir -p /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
            git clone -b $CI_COMMIT_REF_NAME $CI_REPOSITORY_URL . &&
            curl $CI_API_V4_URL/projects/$CI_PROJECT_ID/jobs/artifacts/$CI_COMMIT_REF_NAME/download?job=$CI_BIN_DEPENDENCIES_JOB -o artifacts.zip &&
            unzip artifacts.zip ;
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME/scripts/deploy/ &&
            python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
            /bin/bash install_venv.sh -d -r ../../requirements.txt &&
            python3 prepare_init.d.py &&
            python3 deploy.py -s $CI_ENVIRONMENT_NAME"
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    tty: true
    stdin_open: true
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Ici, on voit que les composants sont regroupés dans un seul réseau (nw_swarm) et sont accessibles les uns aux autres.
Les composants système (basés sur redis, mysql) sont séparés du pool général de composants personnalisés (prévoir aussi de séparer les personnalisés en tant que services). La phase de déploiement de notre cluster ressemble pratiquement à l'envoi d'un CMD à notre grande image configurée et ne diffère presque pas du déploiement décrit dans la Partie I. Je souligne les différences :
- git clone … — nous obtenons les fichiers nécessaires pour effectuer le déploiement (createconfig.py, install_venv.sh, etc.)
- curl… && unzip … — nous téléchargeons et décompressons les artefacts de construction (outils compilés)
Il reste seulement un problème non décrit pour le moment : les composants qui ont une interface web ne sont pas accessibles depuis les navigateurs des développeurs. Nous résolvons ce problème avec un reverse proxy, de la manière suivante :
Dans le fichier .gitlab-ci.yml, après le déploiement de la pile du cluster, nous ajoutons une ligne pour le déploiement du load balancer (qui, lors des commits, met seulement à jour sa configuration (crée de nouveaux fichiers de configuration nginx selon le modèle : /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf) — voir le code docker-compose-nginx.yml)
- docker stack deploy -c docker-compose-nginx.yml ${CI_ENVIRONMENT_NAME} --with-registry-auth
docker-compose-nginx.yml
---
version: '3'

services:
  nginx:
    image: nginx:latest
    environment:
      CI_COMMIT_REF_NAME: ${CI_COMMIT_REF_NAME}
      NGINX_CONFIG: |-
            server {
                listen 8080;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:8080;
                }
            }
            server {
                listen 5555;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:5555;
                }
            }
    volumes:
      - /tmp/staging/nginx:/etc/nginx/conf.d
    command:
      /bin/bash -c "echo -e "$$NGINX_CONFIG" > /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf;
        nginx -g "daemon off;";
        /etc/init.d/nginx reload"
    ports:
      - 8080:8080
      - 5555:5555
      - 3000:3000
      - 443:443
      - 80:80
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Sur les ordinateurs des développeurs, nous mettons à jour /etc/hosts ; nous ajoutons l'URL vers nginx :
10.50.173.106 staging_BRANCH-1831_cluster.dev
Ainsi, le déploiement de clusters staging isolés est réalisé et les développeurs peuvent désormais les lancer en nombre suffisant pour vérifier leurs tâches.
Plans futurs :
- Diviser nos composants en tant que services
- Créer un Dockerfile pour chaque composant
- Identifier automatiquement les nœuds moins chargés dans la pile
- Définir les nœuds selon le modèle de nom (au lieu d'utiliser l'ID comme dans l'article)
- Ajouter une vérification que la pile est détruite
- …
Remerciements particuliers à .
Source : habr.com
