

L'avenir est arrivé, les technologies de l'intelligence artificielle et de l'apprentissage automatique sont déjà utilisées avec succès par vos magasins préférés, les entreprises de transport et même les fermes d'élevage de dindes.
Et si quelque chose existe, il y a déjà des informations à ce sujet sur Internet... un projet ouvert ! Voyez comment Open Data Hub aide à intégrer de nouvelles technologies et à éviter les difficultés lors de leur mise en œuvre.
Malgré tous les avantages de l'intelligence artificielle (IA) et de l'apprentissage automatique (ML), les organisations rencontrent souvent des difficultés pour intégrer ces technologies. Les principaux problèmes rencontrés sont généralement les suivants :
- Échange d'informations et collaboration – il est pratiquement impossible d'échanger des informations sans effort supplémentaire et de collaborer en mode itératif rapide.
- Accès aux données – pour chaque tâche, il faut le reconstruire à partir de zéro et manuellement, ce qui prend beaucoup de temps.
- Accès à la demande – il n'est pas possible d'obtenir un accès à la demande aux outils et à la plateforme de machine learning, ainsi qu'à l'infrastructure de calcul.
- Production – les modèles restent au stade de prototype et ne sont pas mis en production.
- Suivi et explication des résultats de l'IA – la reproductibilité, le suivi et l'explication des résultats de l'IA/ML sont difficiles.
Si ces problèmes restent non résolus, ils ont un impact négatif sur la vitesse, l'efficacité et la productivité des précieux spécialistes en traitement et analyse des données. Cela conduit à leur frustration, à une déception au travail, et finalement, les attentes de l'entreprise concernant l'IA/ML s'évaporent.
La responsabilité de résoudre ces problèmes incombe aux spécialistes IT, qui doivent fournir aux analystes de données – oui, quelque chose comme le cloud. Plus précisément, une plateforme qui offre une liberté de choix et un accès facile et simple. En même temps, elle devrait être rapide, facilement reconfigurable, scalable à la demande et résiliente aux pannes. La construction d'une telle plateforme basée sur des technologies open-source aide à éviter la dépendance vis-à-vis du fournisseur et à préserver un avantage stratégique à long terme en matière de contrôle des coûts.
Il y a quelques années, une situation similaire s'est produite dans le développement d'applications, menant à l'émergence des microservices, des environnements cloud hybrides, de l'automatisation IT et des processus agiles. Pour gérer tout cela, les professionnels de l'IT ont commencé à utiliser des conteneurs, Kubernetes et des clouds hybrides ouverts.
Cette expérience est désormais appliquée pour répondre aux défis de l'IA. Ainsi, les professionnels de l'IT créent des plateformes basées sur des conteneurs, permettant de développer des services AI/ML dans le cadre de processus agiles, accélérant les innovations et conçues avec une vision pour le cloud hybride.
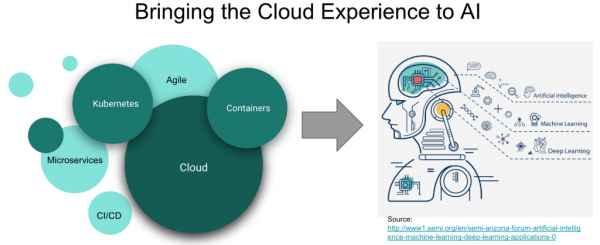
La construction de cette plateforme débutera avec Red Hat OpenShift, notre plateforme Kubernetes pour le cloud hybride, qui dispose d'un écosystème en pleine croissance de solutions logicielles et matérielles pour l'IA/ML (NVIDIA, H2O.ai, Starburst, PerceptiLabs, etc.). Certains clients de Red Hat, tels que BMW Group, ExxonMobil et d'autres, ont déjà déployé des chaînes d'outils ML conteneurisées et des processus DevOps basés sur cette plateforme et son écosystème, afin de mettre leurs architectures ML en mode production et d'accélérer le travail des analystes de données.
Une autre raison pour laquelle nous avons lancé le projet Open Data Hub est de montrer un exemple d'architecture basé sur plusieurs projets de logiciels libres et de démontrer comment réaliser l'ensemble du cycle de vie des solutions ML sur la plateforme OpenShift.
Projet Open Data Hub
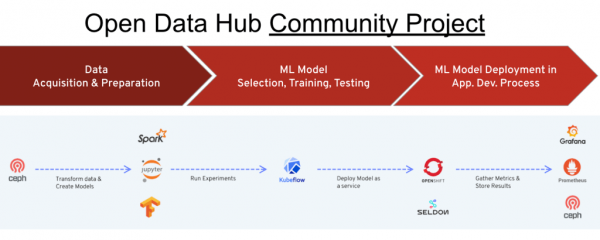
C'est un projet open source qui évolue au sein d'une communauté de développement appropriée et réalise l'ensemble du cycle opérationnel – de l'importation et la transformation des données initiales à la création, à l'entraînement et à la maintenance du modèle – pour résoudre des problèmes AI/ML à l'aide de conteneurs et de Kubernetes sur la plateforme OpenShift. Ce projet peut être considéré comme une mise en œuvre de référence, un exemple de la façon de construire une solution open source de type 'AI/ML en tant que service' basée sur OpenShift et les outils open source associés, tels que Tensorflow, JupyterHub, Spark, etc. Il est important de noter que Red Hat utilise également ce projet pour fournir ses services AI/ML. De plus, OpenShift s'intègre aux principales solutions logicielles et matérielles d'IA/ML de NVIDIA, Seldon, Starburst et d'autres fournisseurs, facilitant ainsi la création et le déploiement de ses propres systèmes d'apprentissage automatique.
Le projet Open Data Hub est destiné aux catégories d'utilisateurs et scénarios d'utilisation suivants :
- Un analyste de données qui a besoin d'une solution de type cloud pour la mise en œuvre de projets ML avec des fonctionnalités en libre-service.
- Un analyste de données qui a besoin du plus large choix parmi la variété des derniers outils et plateformes AI/ML open source.
- Un analyste de données qui a besoin d'accès aux sources de données lors de l'entraînement des modèles.
- Un analyste de données qui a besoin d'accès aux ressources de calcul (CPU, GPU, mémoire).
- Un analyste de données qui nécessite la possibilité de collaborer et de partager ses résultats avec ses collègues, de recevoir des retours et d'apporter des améliorations par des itérations rapides.
- Un analyste de données qui souhaite interagir avec les développeurs (et les équipes devops) pour que ses modèles ML et ses résultats passent en production.
- Un ingénieur des données qui doit offrir à l'analyste de données un accès à une variété de sources de données tout en respectant les normes et exigences de sécurité.
- Un administrateur/opérateur de systèmes informatiques qui nécessite la possibilité de contrôler sans effort le cycle de vie (installation, configuration, mise à jour) des composants et technologies open source. Des outils de gestion et de quota appropriés sont également nécessaires.
Le projet Open Data Hub regroupe toute une gamme d'outils open source pour réaliser un cycle complet d'opérations AI/ML. Comme principal outil de travail de l'analyste de données, Jupyter Notebook est utilisé. Cet outil est aujourd'hui très populaire parmi les spécialistes du traitement et de l'analyse des données, et Open Data Hub leur permet de créer et de gérer facilement des environnements de travail Jupyter Notebook, en utilisant le JupyterHub intégré. En plus de la création et de l'importation de notebooks Jupyter, le projet Open Data Hub contient également une bibliothèque de notebooks prêts à l'emploi sous forme de bibliothèque AI Library.
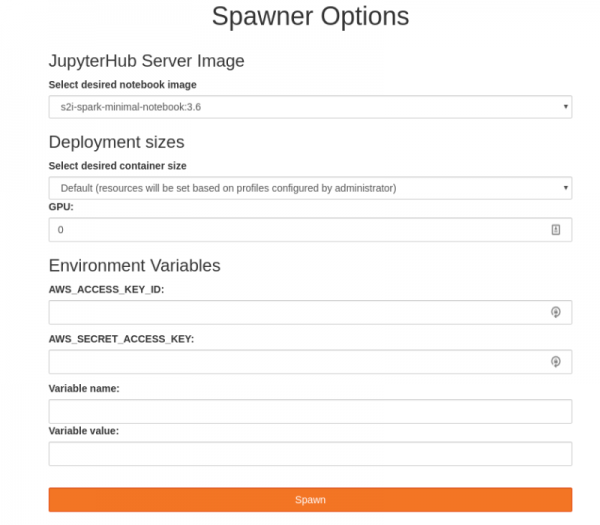
Cette bibliothèque est une collection de composants open-source en apprentissage automatique et de solutions pour des scénarios standards, facilitant le prototypage rapide. JupyterHub est intégré avec un modèle d'accès RBAC d'OpenShift, permettant d'utiliser des comptes OpenShift existants et de réaliser une authentification unique. De plus, JupyterHub propose une interface utilisateur conviviale appelée spawner, qui permet à l'utilisateur de configurer facilement la quantité de ressources de calcul (cœurs de processeur, mémoire, GPU) pour le Jupyter Notebook sélectionné.
Une fois qu'un analyste de données a créé et configuré un notebook, toutes les autres préoccupations sont prises en charge par le planificateur Kubernetes, qui fait partie d'OpenShift. Les utilisateurs n'ont plus qu'à réaliser leurs expériences, sauvegarder et partager les résultats de leur travail. De plus, les utilisateurs avancés peuvent accéder directement à la CLI OpenShift depuis les notebooks Jupyter pour exploiter les primitives Kubernetes, telles que Job, ou les fonctionnalités d'OpenShift, comme Tekton ou Knative. Alternativement, ils peuvent utiliser l'interface graphique conviviale d'OpenShift appelée « console web d'OpenShift ».
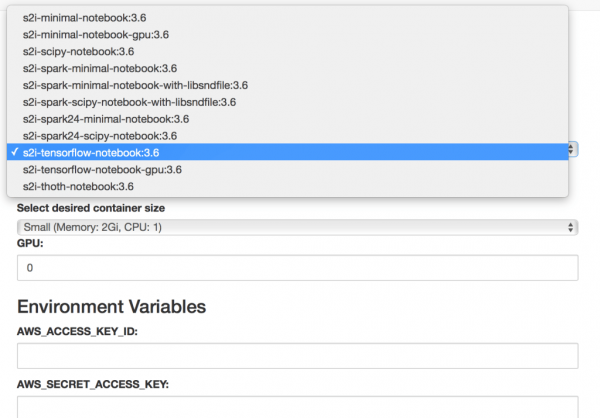
Passant à l'étape suivante, Open Data Hub permet de gérer des pipelines de données. Pour cela, un objet Ceph est utilisé, fourni sous la forme d'un stockage d'objets compatible S3. Apache Spark permet le streaming de données provenant de sources externes ou du stockage Ceph S3 intégré, ainsi que l'exécution de transformations de données préliminaires. Apache Kafka offre une gestion avancée des pipelines de données (où il est possible de charger plusieurs fois, ainsi que d'effectuer des opérations de transformation, d'analyse et de sauvegarde des données).
Ainsi, l'analyste de données a eu accès aux données et a construit son modèle. Il souhaite maintenant partager les résultats obtenus avec ses collègues ou les développeurs d'applications, en leur fournissant son modèle en tant que service. Pour cela, un serveur de déploiement est nécessaire, et Open Data Hub dispose d'un tel serveur, appelé Seldon, qui permet de publier le modèle sous la forme d'un service RESTful.
À un moment donné, plusieurs de ces modèles apparaissent sur le serveur Seldon, ce qui crée le besoin de surveiller leur utilisation. Pour cela, Open Data Hub propose une collection de métriques pertinentes et un moteur de rapports basé sur des outils de surveillance open source largement utilisés comme Prometheus et Grafana. Ainsi, nous obtenons des retours pour surveiller l'utilisation des modèles d'IA, en particulier dans un environnement de production.
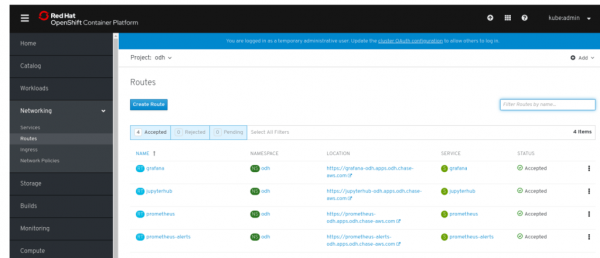
De cette manière, Open Data Hub adopte une approche cloud à travers le cycle complet des opérations AI/ML, depuis l'accès et la préparation des données jusqu'à l'entraînement et la mise en production du modèle.
Rassemblons tout
La question se pose alors de savoir comment tout cela est organisé pour l'administrateur OpenShift. C'est ici qu'entrent en jeu un opérateur Kubernetes spécialisé pour les projets Open Data Hub.
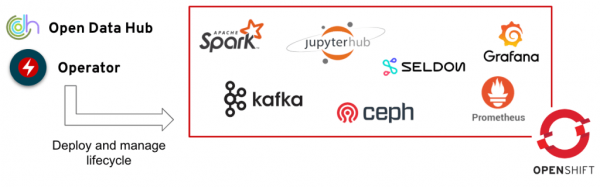
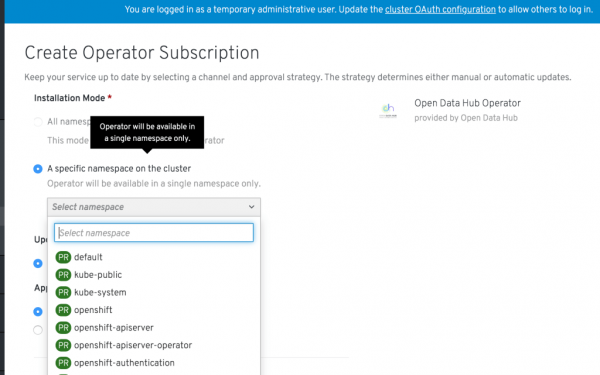
Cet opérateur gère l'installation, la configuration et le cycle de vie du projet Open Data Hub, y compris le déploiement d'outils tels que JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus et Grafana. Le projet Open Data Hub peut être trouvé dans la console web d'OpenShift, dans la section des opérateurs communautaires. Ainsi, l'administrateur OpenShift peut spécifier que les projets OpenShift concernés appartiennent à la catégorie « projet Open Data Hub ». Cela se fait une seule fois. Ensuite, l'analyste de données, via la console web d'OpenShift, accède à son espace projet et constate que l'opérateur Kubernetes concerné est installé et disponible pour ses projets. Il crée ensuite un exemplaire du projet Open Data Hub en un clic et a immédiatement accès aux outils décrits ci-dessus. Et tout cela peut être configuré en mode haute disponibilité et résilience.
Si vous souhaitez essayer le projet Open Data Hub par vous-même, commencez par . Les détails techniques de l'architecture d'Open Data Hub peuvent être trouvés , les plans de développement du projet – . À l'avenir, une intégration supplémentaire avec Kubeflow est prévue, ainsi que la résolution de certaines questions de réglementation des données et de sécurité, et l'organisation d'une intégration avec des systèmes basés sur les règles Drools et Optaplanner. Vous pouvez exprimer votre avis et devenir participant au projet sur la page .
En résumé : des problèmes majeurs d'évolutivité empêchent les organisations de tirer pleinement parti du potentiel de l'intelligence artificielle et de l'apprentissage automatique. Red Hat OpenShift est utilisé depuis longtemps et avec succès pour résoudre des problèmes similaires dans le secteur des logiciels. Le projet Open Data Hub, développé au sein de la communauté de développement open source, propose une architecture de référence pour organiser le cycle complet des opérations AI/ML sur la base du cloud hybride OpenShift. Nous avons un plan de développement clair et réfléchi pour ce projet, et nous sommes déterminés à créer autour de lui une communauté de développement active et productive d'AI solutions open sur la plateforme OpenShift.
Source : habr.com
