

Les clouds sont semblables à une boîte magique — vous demandez ce dont vous avez besoin, et les ressources apparaissent comme par magie. Les machines virtuelles, les bases de données, le réseau — tout cela vous appartient. Il existe d'autres locataires dans le cloud, mais dans votre univers, vous êtes le souverain unique. Vous êtes sûr d'obtenir toujours les ressources nécessaires, sans avoir à vous soucier des autres, et vous décidez vous-même comment sera le réseau. Comment cette magie fonctionne-t-elle, permettant au cloud d'allouer des ressources de manière élastique et d'isoler complètement les locataires les uns des autres ?
Le cloud AWS est un système méga-super-complexe qui évolue depuis 2006. Une partie de cette évolution a été vécue Vassili Pantioukhine — architecte des Amazon Web Services. En tant qu'architecte, il voit non seulement le résultat final, mais aussi les défis que surmonte AWS. Plus vous comprenez le fonctionnement du système, plus vous avez confiance. C'est pourquoi Vassili partagera les secrets des services cloud d'AWS. Sous ce lien, découvrez l'architecture des serveurs physiques d'AWS, l'élasticité des bases de données, la base de données personnalisée d'Amazon et les méthodes d'augmentation de la performance des machines virtuelles tout en réduisant leurs coûts. Connaître les approches architecturales d'Amazon vous aidera à mieux utiliser les services d'AWS et peut-être vous donnera de nouvelles idées pour construire vos propres solutions.
À propos du conférencier : Vassili Pantioukhine () a commencé comme admin Unix dans des entreprises .ru, a travaillé pendant 6 ans sur de gros matériels Sun Microsystem, et a prêché pendant 11 ans la centralité des données chez EMC. Il a naturellement évolué vers les clouds privés et, en 2017, il a fait le saut vers les clouds publics. Actuellement, il offre des conseils techniques pour vivre et prospérer dans le cloud AWS.
Avertissement : tout ce qui suit est l'opinion personnelle de Vassili et peut ne pas refléter la position d'Amazon Web Services. de la présentation sur laquelle cet article est basé est disponible sur notre chaîne YouTube.
Pourquoi je parle de l'architecture d'Amazon
Ma première voiture avait une 'manuelle' — avec une boîte de vitesses mécanique. C'était génial car cela me donnait un sentiment de pouvoir sur la voiture et de contrôle total. J'aimais aussi le fait que je comprenais au moins en gros son fonctionnement. Naturellement, je visualisais le fonctionnement de la boîte de vitesses de manière assez primitive — un peu comme une boîte de vitesses de bicyclette.
Tout était merveilleux, sauf un détail : le temps passé dans les embouteillages. On a beau être assis sans rien faire, on doit constamment changer de vitesses, actionner l'embrayage, accélérer, freiner — c'est vraiment fatigant. Le problème des bouchons a été en partie résolu lorsque nous avons acquis une voiture automatique. Au volant, j'ai eu le temps de réfléchir à certaines choses et d'écouter des livres audio.
Une énigme est également apparue dans ma vie, car je ne comprends plus du tout comment fonctionne ma voiture. Une voiture moderne est un dispositif complexe. Elle s'adapte simultanément à des dizaines de paramètres différents : pression sur l'accélérateur, freinage, style de conduite, qualité de la route. Je ne comprends plus comment tout cela fonctionne.
Lorsque j'ai commencé à travailler avec le cloud Amazon, cela était aussi un mystère pour moi. Mais cette énigme est d'un niveau supérieur, car dans une voiture, il n'y a qu'un seul conducteur, tandis que dans AWS, il y en a des millions. Tous les utilisateurs conduisent, accélèrent et freinent en même temps. C'est incroyable de constater qu'ils arrivent à se diriger là où ils veulent — pour moi, c'est un miracle ! Le système s'adapte automatiquement, se redimensionne et se configure de manière élastique pour chaque utilisateur, au point qu'il semble être le seul dans cet univers.
La magie s'est un peu dissipée lorsque je suis devenu architecte chez Amazon. J'ai vu les problèmes auxquels nous faisons face, comment nous les résolvons, comment nous développons les services. Avec une compréhension accrue du fonctionnement du système, la confiance dans le service grandit. C'est pourquoi je souhaite partager un aperçu de ce qui se trouve sous le capot du cloud AWS.
De quoi allons-nous parler
J'ai choisi une approche diversifiée — j'ai sélectionné 4 services intéressants dont il vaut la peine de parler.
Optimisation des serveurs. Des clouds éphémères avec une manifestation physique : des centres de données physiques, où se trouvent des serveurs physiques qui ronronnent, chauffent et clignotent.
Fonctions serverless (Lambda) — sans doute le service le plus scalable du cloud.
Mise à l'échelle de la base de données. Je vais parler de la manière dont nous construisons nos propres bases de données évolutives.
Mise à l'échelle du réseau. La dernière partie, où je dévoilerai l'architecture de notre réseau. C'est une chose merveilleuse — chaque utilisateur du cloud se sent comme s'il était le seul sur le cloud et ne voit absolument pas les autres locataires.
Remarque. Cet article traite de l'optimisation des serveurs et de l'évolutivité des bases de données. L'évolutivité du réseau sera abordée dans l'article suivant. Où sont donc les fonctions serverless ? Une explication séparée a été publiée à ce sujet.Elle décrit plusieurs méthodes différentes d'évolutivité et examine en détail la solution Firecracker — une combinaison des meilleures caractéristiques des machines virtuelles et des conteneurs.
Serveurs
Le cloud est éphémère. Mais cette éphémérité a tout de même une incarnation physique — des serveurs. Au départ, leur architecture était classique. Un jeu de puces x86 standard, des cartes réseau, Linux, un hyperviseur Xen qui faisait fonctionner les machines virtuelles.
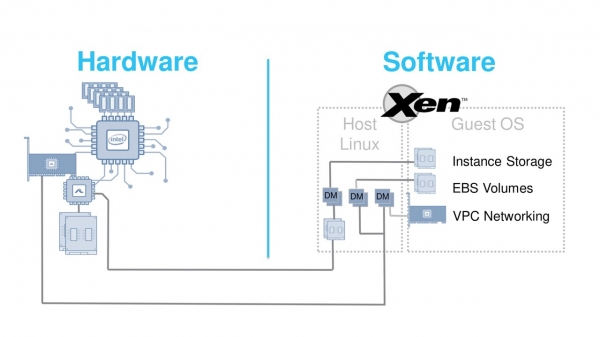
En 2012, cette architecture répondait parfaitement à ses tâches. Xen est un excellent hyperviseur, mais avec un sérieux inconvénient. Il a des frais généraux élevés pour l'émulation des appareils.Avec l'apparition de nouvelles cartes réseau plus rapides ou de disques SSD, ces frais deviennent trop élevés. Comment faire face à ce problème ? Nous avons décidé d'opérer sur deux fronts — optimiser à la fois le matériel et l'hyperviseur.La tâche est très sérieuse.
Optimisation du matériel et de l'hyperviseur.
Il n'est pas possible de tout faire bien en même temps. Qu'est-ce que "bien", cela a également été au départ peu clair.
Nous avons décidé d'adopter une approche évolutive — modifier un élément important de l'architecture et le déployer en production.
Nous trébuchons sur des obstacles, écoutons les plaintes et les suggestions. Puis nous modifions un autre composant. Ainsi, par petites étapes, nous changeons radicalement toute l'architecture sur la base des retours des utilisateurs et du support.
Les transformations ont commencé en 2013 avec le plus complexe — le réseau. Dans les instances C3, une carte Network Accelerator spéciale a été ajoutée à la carte réseau standard. Elle était connectée simplement par un court câble loopback à l'avant du châssis. Pas très esthétique, mais cela ne se voit pas dans le cloud. En revanche, l'interaction directe avec le matériel a considérablement amélioré le jitter et la bande passante du réseau. Ensuite, nous avons décidé d'améliorer l'accès au stockage de blocs EBS — Elastic Block Storage. C'est une combinaison de réseau et de stockage. La difficulté réside dans le fait que, alors que des cartes Network Accelerator existaient sur le marché, il n'était tout simplement pas possible d'acheter du matériel de Storage Accelerator. Nous avons donc contacté la startup
Annapurna Labs. Annapurna Labs, qui a développé pour nous des puces ASIC spéciales. Elles ont permis de connecter des volumes EBS distants comme des dispositifs NVMe.
Dans les instances C4 , nous avons résolu deux problèmes. Le premier - nous avons réalisé une avancée vers une technologie NVMe prometteuse mais nouvelle à l'époque. Le second - nous avons considérablement déchargé le processeur central en déplaçant le traitement des requêtes EBS vers une nouvelle carte. Cela a bien fonctionné, c'est pourquoi Annapurna Labs fait désormais partie d'Amazon.
D'ici novembre 2017, nous avons compris qu'il était temps de changer l'hyperviseur lui-même.
Le nouvel hyperviseur a été développé sur la base de modules du noyau KVM retravaillés.
Il a permis de réduire considérablement les frais généraux d'émulation des dispositifs et de travailler directement avec les nouvelles ASIC. Les instances C5 étaient les premières machines virtuelles sous le capot desquelles fonctionnait le nouvel hyperviseur. Nous l'avons nommé Nitro.
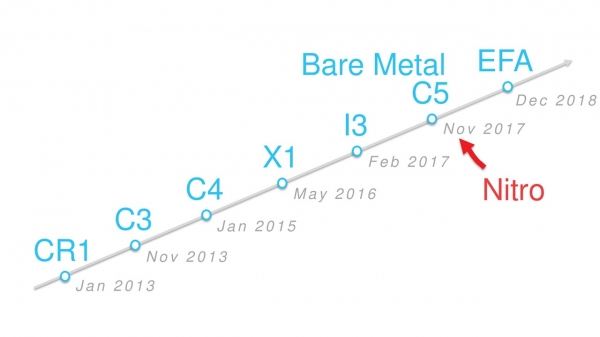 Évolution des instances sur la ligne du temps.
Tous les nouveaux types de machines virtuelles apparus depuis novembre 2017 fonctionnent sur cet hyperviseur. Les instances Bare Metal n'ont pas d'hyperviseur, mais elles sont également appelées Nitro, car elles utilisent des cartes Nitro spécialisées.
Au cours des deux années suivantes, le nombre de types d'instances Nitro a dépassé une paire de dizaines : A1, C5, M5, T3 et d'autres.
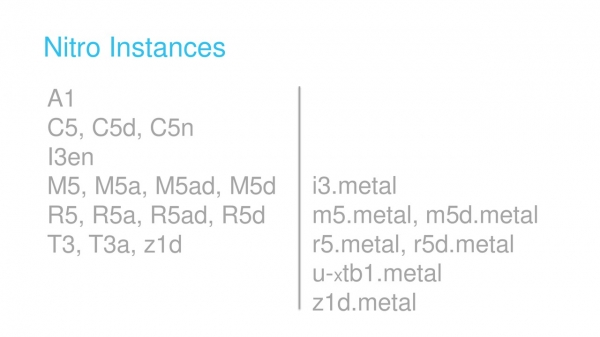
Types d'instances.
Comment fonctionnent les machines Nitro modernes
Elles ont trois composants principaux : l'hyperviseur Nitro (mentionné précédemment), une puce de sécurité et les cartes Nitro.
La puce de sécurité est intégrée directement sur la carte mère. Elle contrôle de nombreuses fonctions importantes, comme le contrôle du démarrage du système d'exploitation hôte.
Les cartes Nitro sont au nombre de quatre types. Elles ont toutes été développées par Annapurna Labs et sont basées sur des ASIC communs. Une partie de leur firmware est également commune.
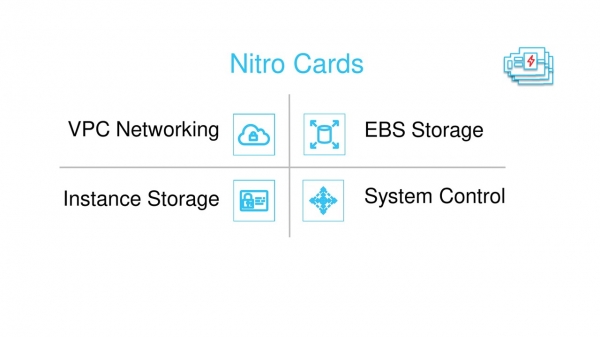
Quatre types de cartes Nitro.
Une des cartes est destinée à fonctionner avec le réseauVPC. C'est celle-ci qui est visible dans les machines virtuelles comme carte réseau ENA - Elastic Network Adaptor. Elle encapsule également le trafic lors de son transfert à travers le réseau physique (nous en parlerons dans la deuxième partie de l'article), contrôle le pare-feu des Groupes de sécurité, gère le routage et d'autres aspects réseau.
Certaines cartes fonctionnent avec le stockage par blocs EBS et les disques intégrés au serveur. Pour la machine virtuelle hôte, elles sont présentées comme des adaptateurs NVMe. Elles sont également responsables du chiffrement des données et du suivi des disques.
Le système de cartes Nitro, d'hyperviseur et de puce de sécurité est intégré dans un réseau SDN ou Software Defined Network. La gestion de ce réseau (Control Plane) est assurée par carte de contrôleur.
Bien sûr, nous continuons à développer de nouveaux ASIC. Par exemple, à la fin de 2018, nous avons lancé la puce Inferentia, qui permet de travailler plus efficacement avec des tâches d'apprentissage automatique.
Puce Inferentia pour le traitement des données d'apprentissage automatique.
Base de données évolutive
Une base de données traditionnelle a une structure en couches. Pour simplifier, on peut distinguer les niveaux suivants.
- SQL — c'est là où opèrent les gestionnaires de clients et de requêtes.
- Assurances des transactions — ici tout est clair, ACID et tout ça.
- Mise en cache, qui est assuré par des pools de tampons.
- Journalisation — gère le travail avec les journaux de redo. Dans MySQL, ils s'appellent Bin Logs, dans PostgreSQL — Write Ahead Logs (WAL).
- Stockage – l'écriture directe sur le disque.
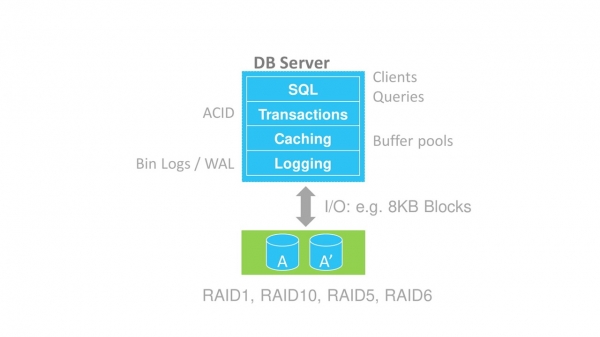
Structure en couches de la base de données.
Il existe différentes méthodes de mise à l'échelle des bases de données : sharding, architecture Shared Nothing, disques partagés.
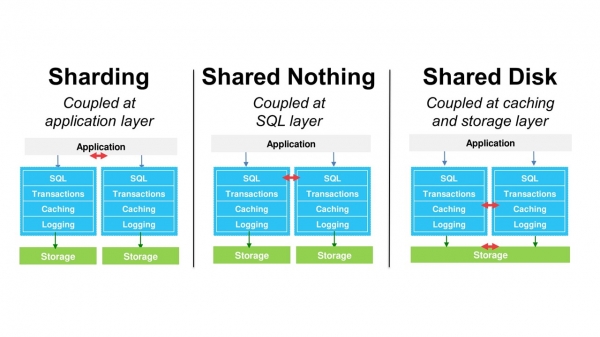
Cependant, toutes ces méthodes conservent la même structure monolithique de base de données. Cela limite considérablement la mise à l'échelle. Pour résoudre ce problème, nous avons développé notre propre base de données — Amazon Aurora. Elle est compatible avec MySQL et PostgreSQL.
Amazon Aurora
L'idée architecturale principale est de séparer les niveaux de stockage et de journalisation de la base de données principale.
Pour aller plus loin, je dirai que le niveau de mise en cache est également devenu indépendant. L'architecture cesse d'être un monolithe, et nous obtenons des degrés de liberté supplémentaires dans la mise à l'échelle de blocs individuels.
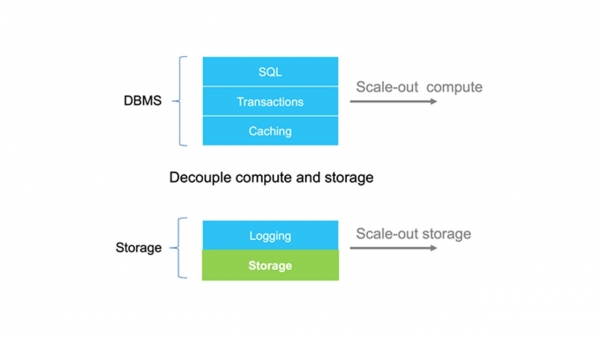
Les niveaux de journalisation et de stockage sont séparés de la base de données.
Une SGBD traditionnelle écrit des données sur le système de stockage sous forme de blocs. Dans Amazon Aurora, nous avons créé un stockage « intelligent » capable de converser dans le langage des journaux de redo. En interne, le stockage transforme les journaux en blocs de données, surveille leur intégrité et effectue automatiquement des sauvegardes.
Cette approche permet de réaliser des choses intéressantes comme le clonage. Cela fonctionne de manière fondamentalement plus rapide et plus rentable car il ne nécessite pas de créer une copie complète de toutes les données.
Le niveau de stockage est réalisé sous la forme d'un système distribué. Il est composé d'un très grand nombre de serveurs physiques. Chaque journal de redo est traité et sauvegardé simultanément par six nœuds. Cela garantit la protection des données et une répartition de la charge.
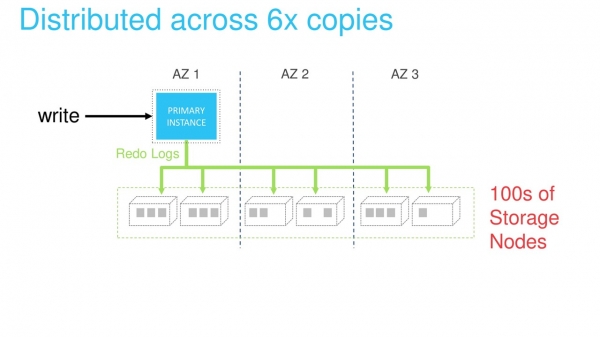
Le scalabilité en lecture peut être assurée par des répliques appropriées. Un stockage distribué élimine le besoin de synchronisation entre l'instance principale de la base de données, à travers laquelle nous écrivons des données, et les autres répliques. Les données actuelles sont garanties disponibles pour toutes les répliques.
Le seul problème est la mise en cache des anciennes données sur les répliques de lecture. Mais ce problème est résolu par la transmission de tous les journaux redo vers les répliques via le réseau interne. Si le journal est présent dans le cache, il est marqué comme invalide et réécrit. S'il n'est pas dans le cache, il est simplement rejeté.
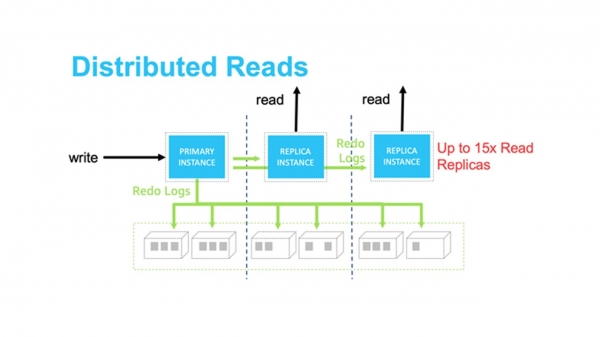
Nous avons réglé la question du stockage.
Comment mettre à l'échelle les niveaux de SGBD
Il est beaucoup plus difficile de réaliser une mise à l'échelle horizontale ici. Nous allons donc suivre la voie classique de la mise à l'échelle verticale classique..
Supposons que nous ayons une application qui communique avec le SGBD via un nœud principal.
Lors de la mise à l'échelle verticale, nous allouons un nouveau nœud qui aura plus de processeurs et de mémoire.
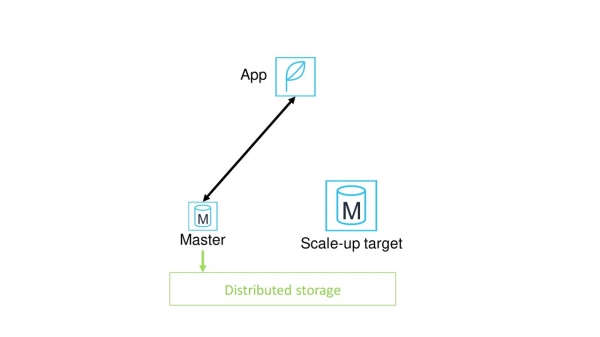
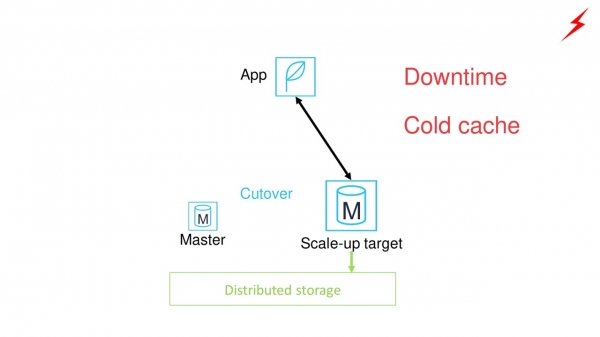
Ensuite, nous transférons l'application de l'ancien nœud principal au nouveau. Des problèmes se posent.
- Cela nécessitera un temps d'arrêt significatif de l'application.
- Le nouveau nœud principal aura un cache froid. La performance de la base de données sera maximale uniquement après le réchauffement du cache.
Comment améliorer la situation ? Installer un proxy entre l'application et le nœud principal.
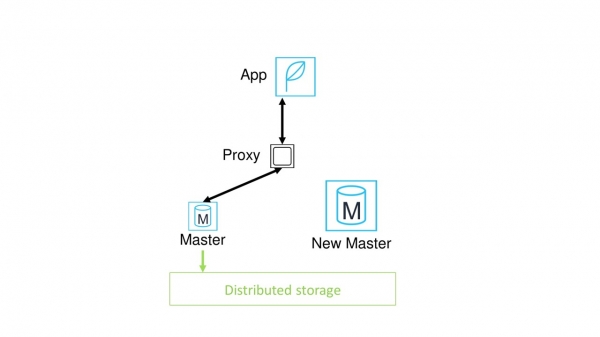
Qu'est-ce que cela nous apportera ? Maintenant, toutes les applications n'ont pas besoin d'être redirigées manuellement vers le nouveau nœud. La bascule peut se faire sous le proxy et être fondamentalement plus rapide.
On pourrait penser que le problème est résolu. Mais non, nous souffrons toujours de la nécessité de réchauffer le cache. De plus, un nouveau problème est apparu : le proxy est désormais un point potentiel de défaillance.
La solution finale avec Amazon Aurora serverless
Comment avons-nous résolu ces problèmes ?
Nous avons gardé le proxy. Il ne s'agit pas d'une instance séparée, mais d'une flotte distribuée de proxies, à travers laquelle les applications se connectent à la base de données. N'importe quel nœud, en cas de défaillance, peut être remplacé presque instantanément.
Nous avons ajouté un pool de nœuds chauds de différentes tailles. Par conséquent, lorsqu'il est nécessaire de dédier un nouveau nœud de plus grande ou plus petite taille, il est immédiatement disponible. Pas besoin d'attendre qu'il soit chargé.
Tout le processus de mise à l'échelle est contrôlé par un système de surveillance spécial. La surveillance suit constamment l'état du nœud maître actuel. S'il détecte, par exemple, que la charge processeur a atteint un niveau critique, il informe le pool d'instances chaudes de la nécessité de déployer un nouveau nœud.
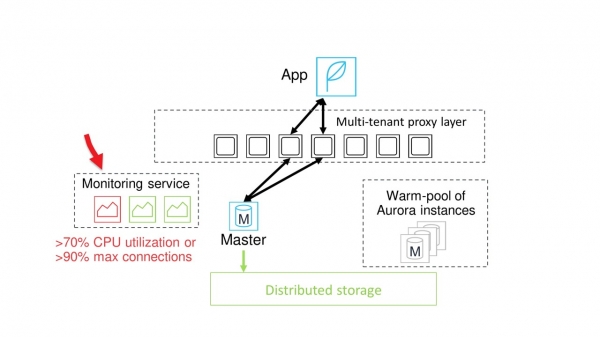
Proxy distribués, instances chaudes et surveillance.
Un nœud de puissance requise est disponible. Les pools de tampons y sont copiés et le système commence à attendre un moment sûr pour le basculement.
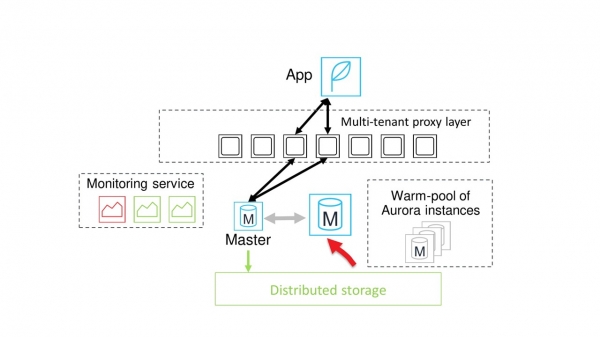
En général, le moment du basculement arrive assez rapidement. À ce moment-là, la communication entre le proxy et l'ancien nœud maître est suspendue, et toutes les sessions sont transférées vers le nouveau nœud.
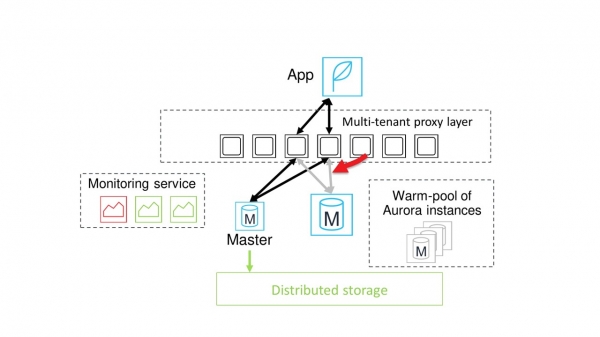
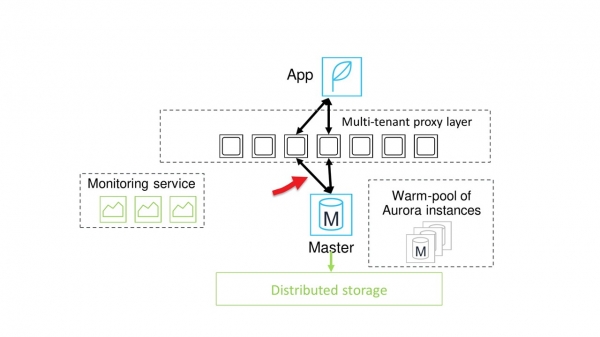
Le travail avec la base de données reprend.
Le graphique montre que la pause est en effet très courte. Sur le graphique bleu, vous voyez la charge, et sur les marches rouges — les moments de mise à l'échelle. Les courts temps d'arrêt sur le graphique bleu correspondent exactement à cette courte latence.
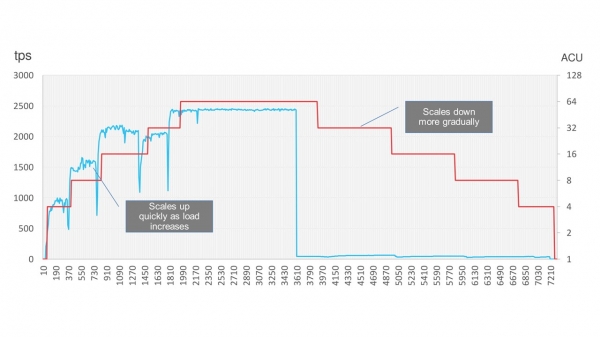
Au fait, Amazon Aurora permet d'économiser en éteignant la base de données lorsqu'elle n'est pas utilisée, par exemple pendant le week-end. Après l'arrêt, la charge de la base de données réduit progressivement sa puissance et se désactive pendant un certain temps. Quand la charge revient, elle augmente à nouveau en douceur.
Dans la prochaine partie de notre histoire sur Amazon, nous parlerons de la mise à l'échelle du réseau. Abonnez-vous et restez à l'affût des mises à jour pour ne pas manquer l'article.
Sur Vassili Pantoukhine présentera sa conférence «». Quels modèles de conception sont utilisés par les développeurs d'Amazon, quelles sont les causes possibles des pannes de service, qu'est-ce que l'architecture basée sur des cellules, le travail constant, le Shuffle Sharding — ce sera intéressant. Il reste moins d'un mois avant la conférence — . Le 24 octobre, les prix vont augmenter définitivement.
Source : habr.com
