

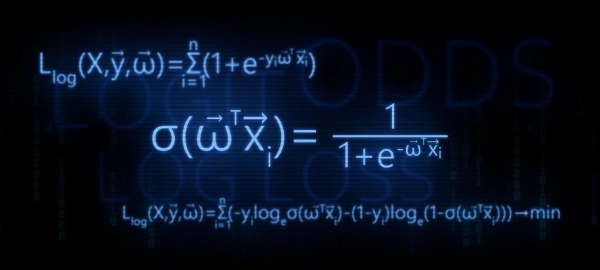
Dans cet article, nous allons examiner les concepts théoriques de la transformation de la fonction de régression linéaire dans la fonction de transformation logit inverse (ou fonction de réponse logistique). Ensuite, en utilisant l'arsenal de la méthode du maximum de vraisemblance, selon le modèle de régression logistique, nous allons dériver la fonction de perte Logistic Loss, ou en d'autres termes, nous allons définir la fonction par laquelle les paramètres du vecteur de poids sont ajustés dans le modèle de régression logistique  .
Plan de l'article :
- Réexaminons la relation linéaire entre deux variables
- Identifions la nécessité de la transformation de la fonction de régression linéaire
 dans la fonction de réponse logistique
- Nous réaliserons des transformations et dériverons la fonction de réponse logistique
- Essayons de comprendre pourquoi la méthode des moindres carrés est problématique pour l'ajustement des paramètres des fonctions Logistic Loss
- Utiliser la méthode du maximum de vraisemblance pour déterminer des fonctions d'ajustement des paramètres :
5.1. Cas 1 : fonction Logistic Loss pour les objets avec des classes désignées 0 et 1:
5.2. Cas 2 : fonction Logistic Loss pour les objets avec des classes désignées -1 et +1:
 dans la fonction de réponse logistique

 des fonctions Logistic Loss
 :


L'article regorge d'exemples simples où tous les calculs peuvent être facilement effectués oralement ou sur papier, dans certains cas, une calculatrice peut être nécessaire. Alors préparez-vous 🙂
Cet article est principalement destiné aux data scientists ayant des connaissances de base en machine learning.
L'article fournira également du code pour tracer des graphiques et faire des calculs. Tout le code est écrit en python 2.7. Je vais expliquer à l'avance la « nouveauté » de la version utilisée — c'est l'une des conditions à la réussite d'un cours bien connu de Yandex sur une plateforme d'éducation en ligne tout aussi connue Coursera, et comme on peut le supposer, le matériel a été préparé d'après ce cours.
01. Relation linéaire
Il est tout à fait raisonnable de se demander ce que la relation linéaire a à voir avec la régression logistique.
C'est simple ! La régression logistique est l'un des modèles qui appartiennent aux classificateurs linéaires. En termes simples, la tâche d'un classificateur linéaire est de prédire des valeurs cibles  à partir de variables (régressors)
 . Dans ce contexte, on suppose que la relation entre les caractéristiques
 et les valeurs cibles
 est linéaire. D'où le nom du classificateur — linéaire. Pour le résumer très grossièrement, le modèle de régression logistique repose sur l'hypothèse d'une relation linéaire entre les caractéristiques
 et les valeurs cibles
 . Voici donc le lien.
Dans le premier exemple du studio, il s'agit, en effet, d'une relation linéaire entre les quantités étudiées. En préparant l'article, je suis tombé sur un exemple qui a déjà laissé beaucoup de monde sur sa faim : la dépendance du courant électrique par rapport à la tension. («Analyse de régression appliquée», N. Draper, G. Smith). Ici, nous allons aussi l'examiner.
Conformément au la loi d'Ohm :
 , où
 — le courant,
 — la tension,
 — la résistance.
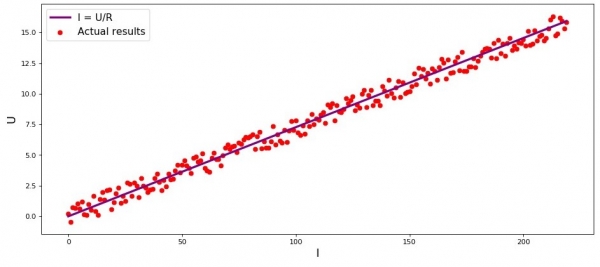
Si nous ne savions pas la loi d'Ohm, nous pourrions établir empiriquement la dépendance en variant  et en mesurant
 , tout en maintenant
 constant. Alors, nous verrions que le graphique de dépendance
 à partir de
 donne une ligne plus ou moins droite passant par l'origine. Nous avons dit «plus ou moins», car bien que la dépendance soit effectivement exacte, nos mesures peuvent contenir de petites erreurs, et donc les points sur le graphique ne tomberont peut-être pas strictement sur la ligne, mais seront dispersés autour d'elle de manière aléatoire.
Graphique 1 «Dépendance  à partir de
 »
Code pour tracer le graphique
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Résultats réels')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. La nécessité de transformations de l'équation de régression linéaire
Considérons un autre exemple. Imaginons que nous travaillons dans une banque et que notre tâche est de déterminer la probabilité de remboursement d'un prêt par un emprunteur en fonction de certains facteurs. Pour simplifier la tâche, considérons seulement deux facteurs : le salaire mensuel de l'emprunteur et le montant mensuel du paiement pour le remboursement du prêt.
La tâche est très conditionnelle, mais à travers cet exemple, nous pourrons comprendre pourquoi l'application de de la fonction de régression linéaire, ainsi que découvrir quelles transformations doivent être apportées à la fonction.
Revenons à l'exemple. Il est compris que plus le salaire est élevé, plus l'emprunteur pourra allouer de fonds mensuellement au remboursement du crédit. Dans une certaine mesure, cette dépendance sera linéaire pour une certaine plage de salaires. Par exemple, prenons une plage de salaires entre 60.000R et 200.000R et supposons que dans cette plage, la relation entre le montant de la mensualité et le salaire soit linéaire. Supposons qu'il a été déterminé que pour cette plage de salaires, le ratio salaire/versement ne peut descendre en dessous de 3 et que l'emprunteur doit également garder 5.000R de réserve. Ce n'est que dans ce cas que nous considérerons que l'emprunteur remboursera le crédit à la banque. Alors, l'équation de régression linéaire prendra la forme suivante :

où  ,
 ,
 ,
 — salaire
 de l'emprunteur,
 — paiement du crédit
 de l'emprunteur.
En substituant dans l'équation le salaire et le paiement du crédit avec des paramètres fixes,  on peut prendre une décision d'octroi ou de refus de crédit.
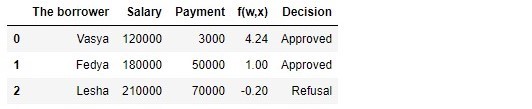
Pour anticiper, notons qu'avec les paramètres donnés,  la fonction de régression linéaire, appliquée dans la fonction de réponse logistique produira de grandes valeurs qui compliqueront les calculs pour déterminer les probabilités de remboursement du crédit. Par conséquent, nous proposons de réduire nos coefficients, disons, d'un facteur de 25.000. Cette transformation des coefficients ne changera pas la décision d'octroi du crédit. Gardons cela à l'esprit pour l'avenir, et maintenant pour rendre les choses encore plus claires, examinons la situation avec trois emprunteurs potentiels.
Tableau 1 «Emprunteurs potentiels»
Code pour générer le tableau
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'L'emprunteur':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salaire':np.array([120000,180000,210000]),
       'Paiement':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salaire']*w_1 + df['Paiement']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Approuvé'
        decision.append(dec)
    else:
        dec = 'Refus'
        decision.append(dec)

df['Décision'] = decision

df[['L'emprunteur', 'Salaire', 'Paiement', 'f(w,x)', 'Décision']]
Selon les données du tableau, Vasya avec un salaire de 120.000R veut obtenir un crédit pour rembourser 3.000R par mois. Il a été déterminé que pour l'approbation du crédit, le montant du salaire de Vasya doit être trois fois supérieur au montant du paiement, et qu'il doit également rester 5.000R. Cette exigence est remplie par Vasya :  Il reste même 106 000 R. Bien que lors du calcul
 nous ayons réduit les coefficients
 de 25 000 fois, le résultat est resté le même : le crédit peut être approuvé. Fedya obtiendra également un crédit, tandis que Lesha, malgré le fait qu'il gagne le plus, devra modérer ses appétits.
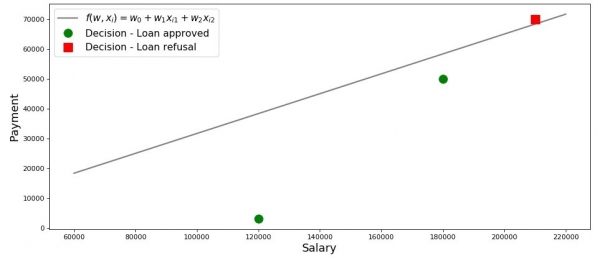
Traçons un graphique dans ce cas.
Graphique 2 « Classification des emprunteurs »
Code pour tracer le graphique
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Decision - Prêt approuvé')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Decision - Refus de prêt')
plt.xlabel('Salaire', size = 16)
plt.ylabel('Paiement', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Ainsi, notre droite, construite selon la fonction  , sépare les « mauvais » emprunteurs des « bons ». Ceux dont les désirs ne correspondent pas aux possibilités se situent au-dessus de la droite (Lesha), tandis que ceux qui peuvent, selon les paramètres de notre modèle, rembourser le crédit se trouvent en dessous de la droite (Vasya et Fedya). En d'autres termes, notre droite sépare les emprunteurs en deux classes. Nous les désignerons comme suit : à la classe
 nous inclurons ceux qui rembourseront probablement le crédit, à la classe
 ou
 nous inclurons ceux qui ne pourront probablement pas rembourser le crédit.
Généraliser les conclusions de cet exemple simple. Prenons un point  et, en substituant les coordonnées du point dans l'équation correspondante de la droite
 , examinons trois options :
- Si le point se situe en dessous de la droite, et que nous l'attribuons à la classe , alors la valeur de la fonction sera positive de à . Cela signifie que nous pouvons considérer que la probabilité de remboursement du crédit se situe dans la fourchette . Plus la valeur de la fonction est élevée, plus la probabilité est grande.
- Si le point se situe au-dessus de la droite et que nous l'attribuons à la classe ou , alors la valeur de la fonction sera négative de à . Dans ce cas, nous considérerons que la probabilité de remboursement de la dette se situe dans la fourchette et, plus la valeur de la fonction est élevée en valeur absolue, plus nous avons de confiance.
- Le point se situe sur la droite, à la frontière entre les deux classes. Dans ce cas, la valeur de la fonction sera égale à et la probabilité de remboursement du crédit est égale à .
 , alors la valeur de la fonction
 sera positive de
 à
 . Cela signifie que nous pouvons considérer que la probabilité de remboursement du crédit se situe dans la fourchette
 . Plus la valeur de la fonction est élevée, plus la probabilité est grande.
 ou
 , alors la valeur de la fonction sera négative de
 à
 . Dans ce cas, nous considérerons que la probabilité de remboursement de la dette se situe dans la fourchette
 et, plus la valeur de la fonction est élevée en valeur absolue, plus nous avons de confiance.
 sera égale à
 et la probabilité de remboursement du crédit est égale à
 .
Maintenant, imaginons que nous n'ayons pas deux facteurs, mais des dizaines, que les emprunteurs ne soient pas trois, mais des milliers. Alors, au lieu d'une droite, nous aurons m-métrique plan et coefficients  nous ne prendrons pas ces données au hasard, mais nous les établirons selon toutes les règles, en nous basant sur des données accumulées concernant les emprunteurs, qu'ils aient remboursé ou non leur prêt. Et en effet, notez bien, nous sélectionnons actuellement les emprunteurs selon des coefficients déjà connus
 . En réalité, la tâche du modèle de régression logistique est précisément de déterminer les paramètres
 , pour lesquels la valeur de la fonction de perte Logistic Loss tendra vers un minimum. Mais comment le vecteur
 est calculé, nous le découvrirons dans la 5ème section de l'article. Pour l'instant, revenons sur terre — à notre banquier et à ses trois clients.
Grâce à la fonction  nous savons à qui nous pouvons accorder un prêt et à qui nous devons refuser. Mais avec cette information, nous ne pouvons pas aller voir le directeur, car on voulait obtenir la probabilité de remboursement du prêt par chaque emprunteur. Que faire ? La réponse est simple — nous devons d'une manière ou d'une autre transformer la fonction
 , dont les valeurs se situent dans l'intervalle
 en une fonction, dont les valeurs se situeront dans l'intervalle
 . Et une telle fonction existe, elle s'appelle la fonction de réponse logistique ou la transformation logit inverse. Voici :

Voyons étape par étape comment obtenir la fonction de réponse logistique. Il est à noter que nous allons avancer en arrière, c'est-à-dire que nous supposerons que nous connaissons la valeur de probabilité, qui se situe entre  à
 et ensuite nous allons 'dérouler' cette valeur sur tout l'intervalle des nombres de
 à
 .
03. Nous développons la fonction de réponse logistique
Étape 1. Nous allons transférer les valeurs de probabilité dans l'intervalle

Pendant la transformation de la fonction  dans la fonction de réponse logistique
 nous laisserons notre analyste crédit de côté, et à la place, nous ferons un tour des bookmakers. Non, bien sûr, nous ne parions pas, tout ce qui nous intéresse là-bas, c'est le sens de l'expression, par exemple, la cote de 4 à 1. Les cotes, connues de tous les parieurs, sont le rapport des 'succès' aux 'échecs'. Du point de vue des probabilités, les cotes représentent la probabilité qu'un événement se produise, divisée par la probabilité que l'événement ne se produise pas. Écrivons la formule de la cote d'un événement
 :

, où  — probabilité de l'événement,
 — probabilité de NON survenance de l'événement
Par exemple, si la probabilité que le jeune, fort et vif cheval surnommé « Vortex » devance lors des courses la vieille et flasque dame appelée « Mathilde » est égale  , les chances de succès de « Vetterka » seront
 sur

 et inversement, en connaissant les chances, il ne nous sera pas difficile de calculer la probabilité
 :

Ainsi, nous avons appris à « traduire » la probabilité en chances, qui prennent des valeurs allant de  à
 . Faisons un autre pas et apprenons à « traduire » la probabilité sur toute la ligne numérique de
 à
 .
Étape 2. Traduisons les valeurs de probabilité en plage

Cette étape est très simple : nous prenons le logarithme des chances dans la base du nombre d'Euler  et nous obtenons :

Maintenant, nous savons que si  , alors il sera très simple de calculer la valeur
 et, de plus, elle doit être positive :
 . C'est en effet le cas.
Par curiosité, vérifions que si  , alors nous nous attendons à voir une valeur négative
 . Vérifions :
 . Tout est correct.
Maintenant, nous savons comment traduire la valeur de probabilité de  à
 sur toute la ligne numérique de
 à
 . À l'étape suivante, faisons le contraire.
Pour l'instant, notons qu'en accord avec les règles de logarithmisation, connaissant la valeur de la fonction  , on peut calculer les chances :

Cette méthode de détermination des chances nous sera utile à l'étape suivante.
Étape 3. Dérivons la formule pour déterminer

Donc, nous avons appris à connaître  , pour trouver les valeurs de la fonction
 . Cependant, en réalité, nous avons besoin de tout faire à l'envers — connaissant la valeur
 trouver
 . Pour cela, nous nous tournerons vers le concept de fonction inverse des chances, selon lequel :

Dans cet article, nous ne dériverons pas la formule mentionnée ci-dessus, mais vérifierons avec les chiffres de l'exemple ci-dessus. Nous savons que pour des chances égales à 4 contre 1 ( ), la probabilité de survenue de l'événement est de 0,8 (
 ). Faisons le remplacement :
 . Cela correspond à nos calculs précédents. Continuons.
À l'étape précédente, nous avons déduit que  , donc nous pouvons faire le remplacement dans la fonction inverse des chances. Nous obtiendrons :

Divisons à la fois le numérateur et le dénominateur par  , alors :

Au cas où, pour être sûr que nous ne nous sommes pas trompés, faisons encore une petite vérification. À l'étape 2, nous avons déterminé que  . Alors, en substituant la valeur
 dans la fonction de réponse logistique, nous nous attendons à obtenir
 . Nous substituons et obtenons :
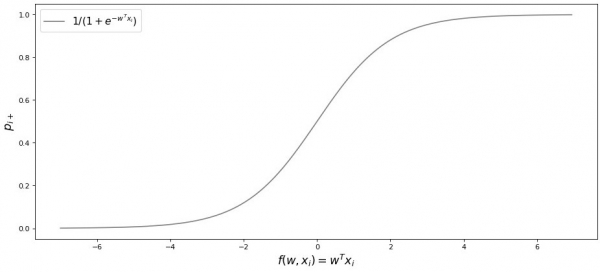
 Félicitations, cher lecteur, nous venons de dériver et de tester la fonction de réponse logistique. Regardons le graphique de la fonction.

Graphique 3 « Fonction de réponse logistique »
Graphique 3 «Fonction de réponse logistique»
Code pour tracer le graphique
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Dans la littérature, on peut également trouver le nom de cette fonction comme fonction sigmoïde. Le graphique montre clairement que le principal changement dans la probabilité d'appartenance d'un objet à une classe se produit sur une plage relativement étroite  , quelque part entre
 à
 .
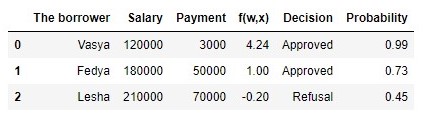
Je propose de revenir à notre analyste de crédit et de l'aider à calculer la probabilité de remboursement des crédits, sinon il risque de ne pas toucher sa prime 🙂
Tableau 2 «Emprunteurs potentiels»
Code pour générer le tableau
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probabilité'] = proba

df[['L'emprunteur', 'Salaire', 'Paiement', 'f(w,x)', 'Décision', 'Probabilité']]
Ainsi, nous avons déterminé la probabilité de remboursement du crédit. Dans l'ensemble, cela semble vrai.
En effet, la probabilité que Vasya, avec un salaire de 120 000 Р, puisse rembourser 3 000 Р au banque chaque mois est proche de 100 %. D'ailleurs, nous devons comprendre que la banque peut accorder un crédit à Liosha si sa politique le prévoit, par exemple, en accordant des crédits à des clients ayant une probabilité de remboursement supérieure à 0,3. Dans ce cas, la banque constituera simplement une réserve plus importante pour les pertes potentielles.
Il convient également de noter que le rapport entre le salaire et le paiement d'au moins 3 et avec une réserve de 5 000 Р a été pris un peu au hasard. Par conséquent, nous n'avons pas pu utiliser dans sa forme originale le vecteur des poids  . Nous devions réduire considérablement les coefficients et dans ce cas, nous avons divisé chaque coefficient par 25 000, c'est-à-dire que nous avons essentiellement ajusté le résultat. Mais cela a été fait intentionnellement pour simplifier la compréhension du matériel à ce stade initial. En réalité, nous devrons non pas inventer et adapter des coefficients, mais les trouver. C'est justement dans les sections suivantes de l'article que nous établirons les équations qui permettent de déterminer les paramètres
 .
04. Méthode des moindres carrés pour déterminer le vecteur de poids dans la fonction de réponse logistique
 dans la fonction de réponse logistique
Nous connaissons déjà une telle méthode pour ajuster le vecteur de poids  , comme méthode des moindres carrés (MNC) et en fait, pourquoi ne pas l'utiliser pour des tâches de classification binaire ? En effet, rien n'empêche de l'utiliser MCO, seulement cette méthode donne des résultats moins précis dans les tâches de classification. Logistic LossIl existe une justification théorique à cela. Commençons par examiner un exemple simple.
Supposons que nos modèles (utilisant MSE et Logistic Loss) aient déjà commencé à ajuster le vecteur de poids  et que nous avons arrêté le calcul à une certaine étape. Peu importe si c’est au milieu, à la fin ou au début, l'essentiel est que nous ayons déjà certaines valeurs du vecteur de poids et supposons qu'à cette étape, les vecteurs de poids
 pour les deux modèles ne présentent aucune différence. Prenons donc les poids obtenus et substituons-les dans la fonction de réponse logistique (
 ) pour un objet qui appartient à la classe
 . Nous allons explorer deux cas, lorsque selon le vecteur de poids ajusté notre modèle se trompe gravement et, au contraire, que le modèle est fortement convaincu que l'objet appartient à la classe
 . Voyons quelles pénalités seront 'imposées' lors de l'utilisation de MCO et Logistic Loss.
Code pour calculer les pénalités en fonction de la fonction de perte utilisée
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Cas d'erreur grossière — le modèle attribue l'objet à la classe  avec une probabilité de 0,01
La pénalité lors de l'utilisation de MCO sera :

La pénalité lors de l'utilisation de Logistic Loss sera :

Cas de forte conviction — le modèle attribue l'objet à la classe  avec une probabilité de 0,99
La pénalité lors de l'utilisation de MCO sera :

La pénalité lors de l'utilisation de Logistic Loss sera :

Cet exemple illustre bien que lors d'une erreur grossière, la fonction de perte Log Loss pénalise le modèle beaucoup plus sévèrement que MSE. Voyons maintenant quelles sont les prérequis théoriques pour l'utilisation de la fonction de perte Log Loss dans les tâches de classification.
05. Méthode du maximum de vraisemblance et régression logistique
Comme promis au début, l'article regorge d'exemples simples. Voici un nouvel exemple avec nos anciens invités — les emprunteurs de la banque : Vasya, Fedya et Lesha.
Au cas où, avant de développer l'exemple, je rappelle que dans la réalité, nous faisons face à un ensemble de données d'apprentissage contenant des milliers ou des millions d'objets avec des dizaines ou des centaines de caractéristiques. Cependant, ici, les chiffres ont été choisis pour être facilement mémorisables par un débutant en data science.
Revenons à notre exemple. Supposons que le directeur de la banque a décidé d'accorder un crédit à tous ceux qui en ont besoin, même si l'algorithme lui conseillait de ne pas l'accorder à Alexeï. Après un certain temps, nous avons découvert qui parmi les trois héros a remboursé le crédit et qui ne l'a pas fait. Comme prévu, Vasya et Fedya ont remboursé le crédit, tandis qu'Alexeï ne l'a pas fait. Imaginons maintenant que ce résultatconstitue un nouvel ensemble d'apprentissage et que nous avons mystérieusement perdu toutes les données concernant les facteurs influençant la probabilité de remboursement du crédit (salaire de l'emprunteur, montant de la mensualité). Intuitivement, nous pourrions supposer que chaque troisième emprunteur ne rembourse pas le crédit à la banque, autrement dit, la probabilité de remboursement du crédit par le prochain emprunteur.  . Cette hypothèse intuitive a une confirmation théorique et repose sur la méthode du maximum de vraisemblance, souvent appelée dans la littérature le principe du maximum de vraisemblance.
Commençons par nous familiariser avec le vocabulaire.
La vraisemblance de l'échantillon est la probabilité d'obtenir cet échantillon précis, ce type d'observations/résultats, c'est-à-dire le produit des probabilités d'obtenir chacun des résultats de l'échantillon (par exemple, que le crédit soit remboursé ou non par Vasya, Fedya et Alexeï en même temps).
La fonction de vraisemblance relie la vraisemblance de l'échantillon aux valeurs des paramètres de distribution.
Dans notre cas, l'échantillon d'apprentissage représente un schéma généralisé de Bernoulli, dans lequel la variable aléatoire n'admet que deux valeurs :  ou
 . Par conséquent, la vraisemblance de l'échantillon peut être écrite comme une fonction de vraisemblance par rapport au paramètre
 comme suit :


L'expression ci-dessus peut être interprétée ainsi. La probabilité conjointe que Vasya et Fedya remboursent le crédit est égale à  , la probabilité qu'Alexeï NE rembourse PAS le crédit est égale à
 (car il s'agit effectivement d'un NON-remboursement du crédit), par conséquent, la probabilité conjointe de tous les trois événements est égale à
 .
La méthode du maximum de vraisemblance — c'est une méthode d'estimation d'un paramètre inconnu par maximisation de la fonction de vraisemblance. Dans notre cas, il est nécessaire de trouver une valeur telle que  , à laquelle
 atteint un maximum.
D'où vient l'idée de chercher la valeur d'un paramètre inconnu pour lequel la fonction de vraisemblance atteint un maximum ? Les origines de cette idée découlent de la compréhension que l'échantillon est notre unique source de connaissance sur la population générale. Tout ce que nous savons sur la population générale est représenté dans l'échantillon. Par conséquent, tout ce que nous pouvons dire, c'est que l'échantillon est le reflet le plus précis de la population générale qui soit à notre disposition. Ainsi, nous devons trouver un paramètre tel que l'échantillon donné devienne le plus probable.
Il est évident que nous sommes confrontés à un problème d'optimisation, dans lequel il faut trouver un point d'extrême de la fonction. Pour découvrir ce point d'extrême, il est nécessaire d'examiner la condition du premier ordre, c'est-à-dire d'égaliser la dérivée de la fonction à zéro et de résoudre l'équation par rapport au paramètre recherché. Cependant, la recherche de la dérivée d'un produit d'un grand nombre de facteurs peut s'avérer être une tâche longue, pour éviter cela, il existe une technique spéciale : passer au logarithme. de la fonction de vraisemblance. Pourquoi un tel passage est-il possible ? Notons que nous ne cherchons pas l'extrême de la fonction , mais le point d'extrême, c'est-à-dire la valeur d'un paramètre inconnu
 , à laquelle
 qui atteint un maximum. Lors du passage au logarithme, le point d'extrême demeure inchangé (bien que l'extrême lui-même soit différent), car le logarithme est une fonction monotone.
Continuons à développer notre exemple avec les crédits de Vasya, Fedya et Lesha, conformément à ce qui précède. Commençons par passer au logarithme de la fonction de vraisemblance:

Nous pouvons maintenant facilement dériver l'expression par rapport à  :

Enfin, examinons la condition du premier ordre : égalisons la dérivée de la fonction à zéro :

Ainsi, notre estimation intuitive de la probabilité de remboursement du crédit  a été théoriquement fondée.
C'est bien, mais que devons-nous maintenant faire avec cette information ? Si nous supposons que chaque troisième emprunteur ne remboursera pas l'argent à la banque, alors cette dernière finira inévitablement par faire faillite. C'est vrai, mais en évaluant la probabilité de remboursement du crédit comme étant égale à  Nous n'avons pas pris en compte les facteurs affectant le remboursement d'un prêt : le salaire de l'emprunteur et le montant de la mensualité. Rappelons que nous avons précédemment calculé la probabilité de remboursement d'un prêt par chaque client en tenant compte de ces mêmes facteurs. Il est logique que les probabilités aient été différentes de la constante équivalente.
 .
Définissons la vraisemblance des échantillons :
Code pour le calcul de la vraisemblance des échantillons
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Vraisemblance de l'échantillon pour une valeur constante p=2/3 :', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Vraisemblance de l'échantillon pour la valeur calculée p :', round(likelihood(y,p_log_response),3)
Vraisemblance de l'échantillon pour une valeur constante  :

Vraisemblance de l'échantillon lors du calcul de la probabilité de remboursement d'un prêt en tenant compte des facteurs  :


La vraisemblance de l'échantillon avec une probabilité calculée en fonction des facteurs était supérieure à la vraisemblance avec une valeur constante de probabilité. Qu'est-ce que cela signifie ? Cela signifie que la connaissance des facteurs a permis de mieux ajuster la probabilité de remboursement d'un prêt pour chaque client. Par conséquent, lors de l'octroi d'un nouveau prêt, il serait plus approprié d'utiliser le modèle d'évaluation de la probabilité de remboursement de la dette proposé à la fin de la 3ème section de l'article.
Mais alors, si nous devons maximiser la fonction de vraisemblance de l'échantillon, pourquoi ne pas utiliser un algorithme qui donnerait des probabilités pour Vassia, Fedia et Lesha, par exemple, égales à 0.99, 0.99 et 0.01 respectivement. Il est possible qu'un tel algorithme se révèle efficace sur l'échantillon d'apprentissage, car il rapprocherait la valeur de la vraisemblance de l'échantillon.  , mais d’une part, un tel algorithme aura probablement des difficultés avec sa capacité de généralisation, et d’autre part, il ne sera certainement pas linéaire. Et si les méthodes pour lutter contre le surapprentissage (ainsi que la faible capacité de généralisation) ne sont clairement pas dans le plan de cet article, alors abordons le deuxième point plus en détail. Pour cela, répondons à une simple question. La probabilité de remboursement du prêt pour Vasya et Fedya peut-elle être identique compte tenu des facteurs connus ? D'un point de vue logique, bien sûr que non, cela ne peut pas être le cas. Ainsi, pour rembourser le prêt, Vasya consacrera 2,5 % de son salaire par mois, tandis que Fedya en consacrera presque 27,8 %. De plus, sur le graphique 2 « Classification des clients », nous voyons que Vasya est nettement plus éloigné de la ligne séparant les classes que Fedya. Et enfin, nous savons que la fonction
 pour Vasya et Fedya prend des valeurs différentes : 4,24 pour Vasya et 1,0 pour Fedya. Eh bien, si Fedya, par exemple, gagnait beaucoup plus ou demandait un prêt plus petit, alors les probabilités de remboursement du prêt pour Vasya et Fedya seraient similaires. En d'autres termes, on ne peut pas tromper la dépendance linéaire. Et si nous avions réellement calculé les coefficients
 , et ne les avions pas pris à la va-vite, nous pourrions affirmer sans hésitation que nos valeurs
 permettent le mieux d'évaluer la probabilité de remboursement du prêt par chaque emprunteur, mais étant donné que nous avons convenu de considérer que la définition des coefficients
 a été réalisée selon toutes les règles, nous allons donc considérer que nos coefficients donnent la meilleure estimation de la probabilité 🙂
Cependant, nous nous sommes éloignés du sujet. Dans cette section, nous devons comprendre comment le vecteur des poids  , qui est nécessaire pour évaluer la probabilité de remboursement d'un prêt par chaque emprunteur, est déterminé.
En résumé, avec quel arsenal nous nous lançons à la recherche des coefficients  :
1. Nous supposons que la dépendance entre la variable cible (valeur prédictive) et le facteur influençant le résultat est linéaire. Pour cette raison, nous appliquons la fonction de régression linéaire de type  , dont la ligne divise les objets (clients) en classes
 et
 ou
 (clients capables de rembourser le prêt et incapables). Dans notre cas, l'équation prend la forme
 .
2. Nous utilisons la fonction de transformation logit inverse de type  pour déterminer la probabilité d’appartenance d’un objet à une classe
 .
3. Nous considérons notre échantillon d'apprentissage comme une réalisation généralisée Schémas de Bernoulli, c'est-à-dire qu'une variable aléatoire est générée pour chaque objet, qui avec une probabilité  (sa propre pour chaque objet) prend la valeur 1 avec une probabilité
 – 0.
4. Nous savons que nous devons maximiser la fonction de vraisemblance de l'échantillon en tenant compte des facteurs pris en compte afin que l'échantillon soit le plus vraisemblable possible. En d'autres termes, nous devons choisir des paramètres qui rendent l'échantillon le plus vraisemblable. Dans notre cas, le paramètre à ajuster est la probabilité de remboursement du prêt  , qui à son tour dépend de coefficients inconnus
 . Cela signifie que nous devons trouver un vecteur de poids
 , pour lequel la vraisemblance de l'échantillon sera maximale.
5. Nous savons donc qu'il faut maximiser la fonction de vraisemblance de l'échantillon vous pouvez utiliser la méthode du maximum de vraisemblance. Et nous connaissons toutes les astuces pour travailler avec cette méthode.
Voici un enchevêtrement comme ça 🙂
Et maintenant, rappelons-nous qu'au tout début de l'article, nous voulions dériver deux types de fonctions de perte Logistic Loss en fonction de la manière dont les classes d'objets sont désignées. Il est d'usage dans les problèmes de classification à deux classes que les classes soient désignées par  et
 ou
 . Selon la désignation, la fonction de perte correspondante sera à la sortie.
Cas 1. Classification d'objets selon et
 et

Auparavant, lors de la détermination de la vraisemblance de l'échantillon, dans lequel la probabilité de remboursement de la dette par l'emprunteur était calculée sur la base de facteurs et de coefficients donnés  , nous avons appliqué la formule :

En réalité  — c'est la valeur de la fonction de réponse logistique
 pour un vecteur de poids donné

Alors rien ne nous empêche d'écrire la fonction de vraisemblance de l'échantillon comme suit :

Il arrive que parfois, certains analystes débutants aient du mal à comprendre immédiatement comment cette fonction fonctionne. Examinons 4 exemples courts qui clarifieront tout :
1. Si  (c'est-à-dire que selon l'échantillon d'entraînement, un objet appartient à la classe +1), mais notre algorithme
 détermine la probabilité d'appartenance de l'objet à la classe
 égale à 0.9, alors ce morceau de vraisemblance de l'échantillon sera calculé ainsi :

2. Si  , et
 , alors le calcul sera le suivant :

3. Si  , et
 , alors le calcul sera le suivant :

4. Si  , et
 , alors le calcul sera le suivant :

Il est évident que la fonction de vraisemblance sera maximisée dans les cas 1 et 3, ou dans le cas général — lorsque les valeurs de probabilité d'appartenance de l'objet à la classe sont correctement devinées  .
En raison du fait que lors de la détermination de la probabilité d'appartenance de l'objet à la classe  nous ne connaissons que les coefficients
 , donc nous les chercherons. Comme mentionné précédemment, c'est une tâche d'optimisation, dans laquelle nous devons d'abord trouver la dérivée de la fonction de vraisemblance par rapport au vecteur de poids
 . Cependant, il est judicieux de simplifier la tâche : nous chercherons la dérivée du logarithme de la fonction de vraisemblance.

Pourquoi après la logarithmisation, dans la fonction d'erreur logistique, nous avons changé le signe avec  sur
 . C'est simple, car dans les tâches d'évaluation de la qualité du modèle, il est d'usage de minimiser la valeur de la fonction, nous avons donc multiplié le côté droit de l'expression par
 et par conséquent, au lieu de maximiser, maintenant nous minimisons la fonction.
En fait, en ce moment, sous vos yeux, la fonction de perte a été péniblement dérivée — Logistic Loss pour un ensemble d'apprentissage avec deux classes :  et
 .
Maintenant, pour trouver les coefficients, nous devons simplement trouver la dérivée la fonction d'erreur logistique et ensuite, en utilisant des méthodes numériques d'optimisation, comme la descente de gradient ou la descente de gradient stochastique, ajuster les coefficients les plus optimaux  . Mais, compte tenu déjà du volume de l'article, il est proposé de faire la différentiation soi-même ou, peut-être, ce sera le sujet d'un prochain article avec plus d'arithmétique sans exemples aussi détaillés.
Cas 2. Classification des objets sur et
 et

L'approche ici sera la même que pour les classes  et
 , mais le parcours vers la sortie de la fonction de perte Logistic Loss, sera plus sinueux. Commençons. Pour la fonction de vraisemblance, nous utiliserons l'opérateur «si…, alors…». C'est-à-dire que si
 -ième objet appartient à la classe
 , alors pour calculer la vraisemblance de l'échantillon, nous utilisons la probabilité
 , si l'objet appartient à la classe
 , alors nous substituons dans la vraisemblance
 . Voici à quoi ressemble la fonction de vraisemblance :

Expliquons cela de manière simple. Considérons 4 cas :
1. Si  et
 , alors dans la vraisemblance de l'échantillon «ira»

2. Si  et
 , alors dans la vraisemblance de l'échantillon «ira»

3. Si  et
 , alors dans la vraisemblance de l'échantillon «ira»

4. Si  et
 , alors dans la vraisemblance de l'échantillon «ira»

Il est évident que dans le cas 1 et 3, lorsque les probabilités ont été correctement déterminées par l'algorithme, la fonction de vraisemblance sera maximisée, c'est-à-dire que c'est précisément ce que nous voulions obtenir. Cependant, cette approche est assez encombrante et ensuite nous examinerons une écriture plus compacte. Mais d'abord, logarithmiser la fonction de vraisemblance en changeant de signe, car maintenant nous allons la minimiser.

Nous allons substituer à la place de  l'expression
 :

Simplifions le terme du logarithme à droite en utilisant de simples techniques arithmétiques et obtenons :

Il est maintenant temps de se débarrasser de l'opérateur «si…, alors…». Remarquez que lorsque l'objet  appartient à la classe
 , alors dans l'expression sous le logarithme, au dénominateur,
 élevé à la puissance
 , si l'objet appartient à la classe
 , alors $e$ est élevé à la puissance
 . Par conséquent, l'écriture de la puissance peut être simplifiée - regroupons les deux cas en un seul :
 . Alors la fonction de perte logistique sera de la forme :

Selon les règles de logarithmisation, nous allons inverser la fraction et sortir le signe " " (moins) du logarithme, nous obtenons :

Voici la fonction de perte logistic Loss, qui est appliquée dans l'échantillon d'apprentissage avec des objets appartenant aux classes :  et
 .
Eh bien, sur ce point, je vous dis au revoir et nous terminons l'article.
Le précédent travail de l'auteur - «Mettre l'équation de la régression linéaire dans une forme matricielle»
Matériaux d'aide
1. Littérature
1) Analyse de régression appliquée / N. Draper, G. Smith - 2e éd. - Moscou : Finances et statistiques, 1986 (traduction de l'anglais)
2) Théorie des probabilités et statistique mathématique / V.E. Gmourman - 9e éd. - Moscou : École supérieure, 2003
3) Théorie des probabilités / N.I. Tchernova - Novossibirsk : Université d'État de Novossibirsk, 2007
4) Analyse commerciale : des données aux connaissances / Paklin N.B., Oreshkov V.I. - 2e éd. - Saint-Pétersbourg : Piter, 2013
5) Data Science La science des données pour les débutants / Joel Grass - Saint-Pétersbourg : BHV Saint-Pétersbourg, 2017
6) Statistiques pratiques pour les spécialistes Data Science / P.Bruce, E.Bruce - Saint-Pétersbourg : BHV Saint-Pétersbourg, 2018
2. Cours, vidéos
1)
2)
3)
4)
5)
3. Sources Internet
1)
2)
3)
4)
5)
6)
7)
8)
Source : habr.com
