

Cet article a été rédigé pour aider à choisir la solution adéquate et à comprendre les différences entre des SDS tels que Gluster, Ceph et Vstorage (Virtuozzo).
Le texte contient des liens vers des articles offrant des explications plus détaillées sur certains problèmes, donc les descriptions seront aussi concises que possible en utilisant des points essentiels sans trop de détails et d'informations d'introduction, que vous pourrez rechercher par vous-même sur Internet si vous le souhaitez.
Les sujets abordés nécessitent en effet un certain ton, mais de nos jours, de plus en plus de personnes n'aiment pas lire longuement))), donc il est possible de lire rapidement et de faire un choix, et si quelque chose n'est pas clair, vous pouvez suivre les liens ou chercher des termes inconnus))), cet article étant une sorte d'emballage transparent pour ces thèmes profonds, présentant le contenu – les principaux points clés de chaque solution.
Gluster
Commençons par Gluster, qui est largement utilisé par les fabricants de plateformes hyperconvergentes utilisant des SDS basés sur des logiciels open source pour des environnements virtuels et qui peut être trouvé sur le site de RedHat dans la section stockage, où vous pouvez choisir entre deux options de SDS : Gluster ou Ceph.
Gluster se compose d'une pile de traducteurs – des services qui exécutent toutes les tâches de distribution de fichiers, etc. Brick – un service qui gère un disque unique, Volume – un volume (pool) – qui regroupe ces bricks. Ensuite, il y a un service de distribution de fichiers par groupes grâce à la fonction DHT (table de hachage distribuée). Nous n'inclurons pas dans la description le service de sharding, car des problèmes le concernant seront abordés dans les liens ci-dessous.
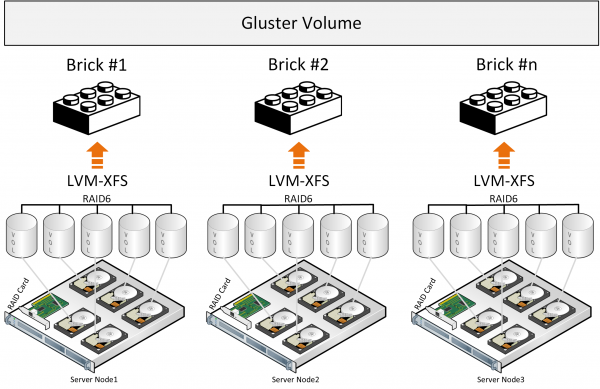
Lors de l'écriture, le fichier entier est enregistré dans un brick et une copie est écrite en parallèle dans un brick sur le deuxième serveur. Ensuite, le deuxième fichier sera enregistré dans le deuxième groupe de deux bricks (ou plus) sur des serveurs différents.
Si les fichiers ont une taille à peu près égale et que le volume ne se compose que d'un seul groupe, tout ira bien, mais dans d'autres conditions, les descriptions évoqueront les problèmes suivants :
- l'espace dans les groupes est utilisé de manière inégale, cela dépend des tailles des fichiers et si un groupe n'a pas assez d'espace pour enregistrer un fichier – vous obtiendrez une erreur, le fichier ne sera pas enregistré et ne sera pas redistribué dans un autre groupe;
- lors de l'enregistrement d'un fichier, l'I/O n'est effectué que sur un seul groupe, les autres étant inactifs;
- il est impossible d'obtenir l'I/O de l'ensemble du volume lors de l'enregistrement d'un seul fichier;
- et le concept général semble moins performant en raison de l'absence de distribution des données par blocs, où il est plus facile d'effectuer un équilibrage et de résoudre le problème de la répartition uniforme, plutôt que comme c'est le cas actuellement où le fichier se place dans un brique dans son intégralité.
D'après la description officielle , on en vient également à comprendre que Gluster fonctionne comme un stockage de fichiers au-dessus d'un RAID matériel classique. Des tentatives ont été faites pour découper (Sharding) les fichiers en blocs, mais tout cela est un ajout qui entraîne une perte de performance à l'approche architecturale déjà existante, en plus de l'utilisation de composants open source dont la performance est limitée comme Fuse. Il n'y a pas de services de métadonnées, ce qui limite les performances et la résilience du stockage lors de la répartition des fichiers par blocs. De meilleures performances peuvent être observées dans la configuration “Distributed Replicated” et le nombre de nœuds doit être d'au moins 6 pour organiser une réplique fiable de 3 avec une répartition de charge optimale.
Ces conclusions sont également liées à la description de l'expérience d'utilisation et lors de la comparaison avec , ainsi qu'une description de l'expérience d'appréhension de cette configuration plus performante et plus fiable
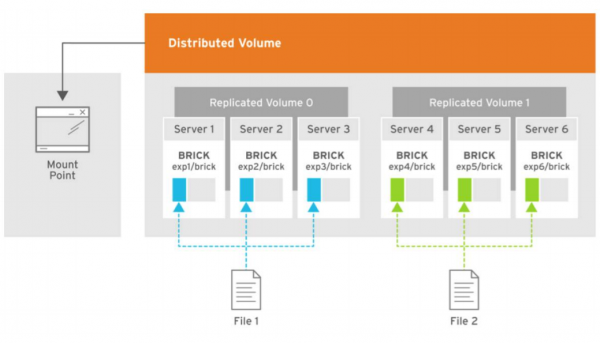
L'image montre la répartition de la charge lors de l'écriture de deux fichiers, où des copies du premier fichier sont distribuées sur les trois premiers serveurs, qui sont regroupés dans le volume 0, et trois copies du second fichier sont placées sur le deuxième groupe volume1 composé de trois serveurs. Chaque serveur a un disque.
La conclusion générale est que Gluster peut être utilisé, mais avec la compréhension qu'il y aura des limitations en termes de performance et de résilience qui posent des difficultés dans certaines conditions de solution hyper-convergente, où des ressources sont également nécessaires pour les charges de calcul des environnements virtuels.
Il existe également certaines performances de Gluster qui peuvent être atteintes sous certaines conditions, tout en se limitant à
Ceph
Examinons maintenant Ceph à partir des descriptions d'architecture que j'ai pu Il y a aussi une comparaison entre , où l'on peut immédiatement comprendre que Ceph doit être déployé sur des serveurs séparés, car ses services nécessitent toutes les ressources matérielles lors de charges.
Architecture plus complexe que Gluster et propose des services tels que des services de métadonnées, mais l'ensemble de la pile de composants est assez difficile et pas très flexible pour une utilisation dans une solution de virtualisation. Les données sont organisées par blocs, ce qui semble plus performant, mais dans la hiérarchie de tous les services (composants), il y a des pertes et de la latence sous certaines charges et conditions d'urgence, par exemple.
Dans la description de l'architecture, le cœur est représenté par CRUSH, qui choisit l'emplacement pour le stockage des données. Ensuite vient le PG — c'est l'abstraction la plus complexe (groupe logique) à comprendre. Les PG sont nécessaires pour que CRUSH soit plus efficace. La principale fonction du PG est de regrouper des objets pour réduire la consommation de ressources, améliorer les performances et la scalabilité. L'adressage des objets directement, individuellement, sans les regrouper dans un PG serait très coûteux. OSD est le service pour chaque disque individuel.
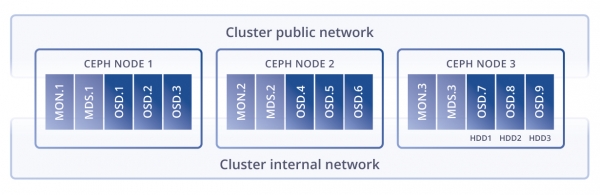
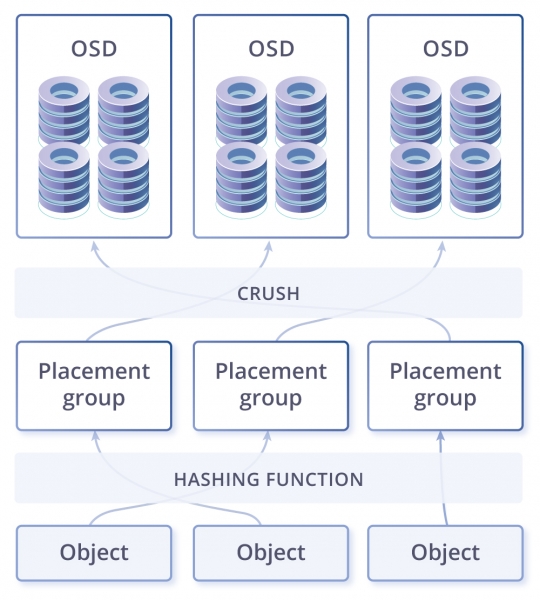
Un cluster peut avoir un ou plusieurs pools de données avec des objectifs différents et des configurations variées. Les pools sont divisés en groupes de placement. Les groupes de placement contiennent des objets auxquels les clients accèdent. À ce niveau logique, on termine et on commence au niveau physique, car chaque groupe de placement est associé à un disque principal et plusieurs disques répliques (le nombre dépend du facteur de réplication du pool). En d'autres termes, au niveau logique, un objet est stocké dans un groupe de placement spécifique, et au niveau physique — sur les disques qui lui sont associés. Ces disques peuvent physiquement se trouver sur différents nœuds ou même dans différents centres de données.
Dans ce schéma, les groupes de placement apparaissent comme un niveau nécessaire pour la flexibilité de l'ensemble de la solution, mais en même temps comme un maillon superflu dans cette chaîne, ce qui suscite inévitablement des pensées sur la perte de performance. Par exemple, lors de l'enregistrement des données, le système doit les diviser en ces groupes et ensuite les transférer physiquement sur le disque principal et sur les disques pour les répliques. Autrement dit, la fonction de hachage fonctionne lors de la recherche et de l'insertion d'un objet, mais il y a un effet secondaire - des coûts élevés et des limitations lors de la reconstruction du hachage (lors de l'ajout ou de la suppression d'un disque). Un autre problème du hachage est la localisation rigide des données, qui ne peut pas être modifiée. Ainsi, si un disque subit une charge accrue, le système n'a pas la possibilité d'écrire sur un autre disque, car la fonction de hachage oblige à placer les données selon une règle, indépendamment de l'état du disque. C'est pourquoi Ceph consomme beaucoup de mémoire lors de la reconstruction du PG en cas d'auto-réparation ou d'augmentation du stockage. En résumé, Ceph fonctionne bien (bien que lentement), mais seulement en l'absence de montée en charge, de situations d'urgence et de mises à jour.
Il existe bien sûr des options pour améliorer les performances par le biais du caching et du cache tiering, mais cela nécessite du bon matériel et il y aura tout de même des pertes. Dans l'ensemble, Ceph semble plus attrayant que Gluster pour la production. De plus, lors de l'utilisation de ces produits, il est crucial de prendre en compte un facteur important : un haut niveau de compétences, d'expérience et de professionnalisme, avec un accent mis sur Linux, car il est très important de tout déployer, configurer et maintenir correctement, ce qui impose encore plus de responsabilités et de charges à l'administrateur.
Vstorage
L'architecture de , qui peut être utilisée conjointement avec l'hyperviseur sur les mêmes nœuds, sur le même , mais il est crucial de tout configurer correctement pour atteindre de bonnes performances. Il est donc très facile de déployer un tel produit directement avec une configuration quelconque sans respecter les recommandations en fonction de l'architecture, mais cela ne sera pas performant.
Qu'est-ce qui peut coexister pour le stockage à proximité des services du conteneur KVM-QEMU, cela comprend seulement quelques services où l'on trouve une hiérarchie compacte et optimale des composants : le service client monté via FUSE (modifié, non open source), le service de métadonnées MDS (Metadata service), le service de blocs de données Chunk service, qui au niveau physique équivaut à un disque et c'est tout. En termes de vitesse, il est bien sûr optimal d'utiliser une configuration de redondance avec deux répliques, mais si l'on utilise un cache et des journaux sur des disques SSD, alors le codage de correction d'erreurs (erase coding ou raid6) peut être raisonnablement accéléré dans un schéma hybride ou même mieux sur un système entièrement flash. Avec EC (erase coding), il y a un petit inconvénient : lorsque l'on modifie un bloc de données, il est nécessaire de recalculer les sommes de parité. Pour contourner la latence de cette opération, Ceph écrit en EC de manière différée et des problèmes de performance peuvent se produire en réponse à une certaine requête, par exemple, lorsqu'il est nécessaire de lire tous les blocs. En revanche, avec Virtuozzo Storage, l'écriture des blocs modifiés est effectuée en utilisant une approche de « système de fichiers structuré par journaux », ce qui minimise les coûts de calcul de parité. Pour estimer approximativement les options d'accélération des opérations avec et sans EC, il y a Les chiffres obtenus peuvent être approximatifs et dépendent du coefficient de précision du fabricant du matériel, mais les résultats des calculs aident bien à planifier la configuration.
Une simple schéma de composants de stockage ne signifie pas que ces composants ne consomment pas mais si l'on compte toutes les dépenses à l'avance, on peut espérer travailler en parallèle avec le conteneur.
Il existe un schéma comparatif de la consommation des ressources matérielles par les services Ceph et Virtuozzo Storage.
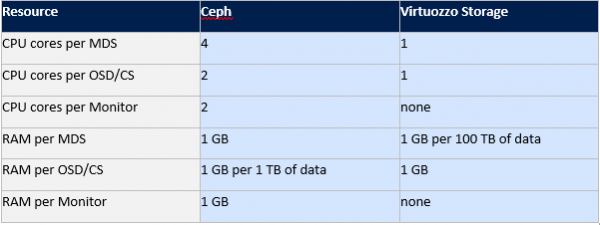
Si auparavant il était possible de comparer Gluster et Ceph à partir d'anciens articles en utilisant les lignes les plus importantes, avec Virtuozzo, c'est plus compliqué. Il n'y a pas beaucoup d'articles sur ce produit et l'on peut trouver des informations seulement dans la documentation sur ou en russe si l'on considère Vstorage comme le stockage utilisé dans certaines solutions hyper-convergentes dans des entreprises comme et Acronis.
Je vais essayer d'aider à décrire cette architecture, donc le texte sera un peu plus long, mais pour comprendre la documentation, il faut beaucoup de temps, et la documentation existante ne peut être utilisée que comme un manuel en consultant le sommaire ou en recherchant par mot-clé.
Considérons le processus d'écriture dans une configuration hybride de matériel avec les composants décrits ci-dessus : l'écriture commence sur le nœud à partir duquel elle a été initiée par le client (le service de point de montage FUSE), mais le composant du service maître des métadonnées (MDS) dirigera bien sûr le client directement vers le service de bloc requis (le service de stockage de blocs CS), donc le MDS ne participe pas au processus d'écriture, mais dirige simplement vers le service de bloc nécessaire. En gros, on peut faire une analogie de l'écriture avec le déversement d'eau dans des fûts. Chaque fût représente un bloc de données de 256 Mo.
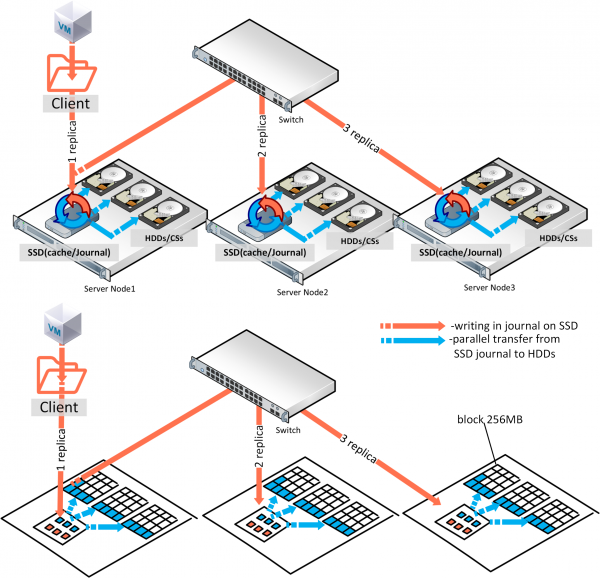
C'est-à-dire qu'un disque, c'est une certaine quantité de ces fûts, donc le volume du disque divisé par 256 Mo. Chaque copie est versée sur un nœud, la seconde presque parallèlement sur un autre nœud, etc. Si nous avons trois répliques et des disques SSD pour le cache (pour la lecture et les journaux d'écriture), la confirmation d'écriture se fera après l'écriture du journal sur le SSD, tandis que le déversement parallèle depuis le SSD se poursuivra sur le HDD, en quelque sorte en mode arrière-plan. Dans le cas de trois répliques, l'engagement d'écriture se fera après confirmation du SSD du troisième nœud. Il peut sembler que la somme des vitesses d'écriture des trois SSD peut être divisée par trois, ce qui donnerait la vitesse d'écriture d'une réplique, mais l'écriture des copies se fait en parallèle et la latence du réseau est généralement plus élevée que celle des SSD, et en réalité, la performance d'écriture dépendra du réseau. En raison de cela, pour voir de réels IOPS, il est nécessaire de bien charger tout le Vstorage selon , c'est-à-dire tester la charge réelle, et non la mémoire et le cache, où il est nécessaire de prendre en compte la taille correcte du bloc de données, le nombre de flux, etc.
Le journal des enregistrements mentionné ci-dessus sur SSD fonctionne de manière à ce que dès que des données y sont enregistrées, elles sont immédiatement lues par le service et écrites sur HDD. Il y a plusieurs services de métadonnées (MDS) par cluster, et leur nombre est déterminé par un quorum qui fonctionne selon l'algorithme Paxos. Du point de vue du client, le point de montage FUSE est un dossier de stockage cluster qui est simultanément visible par tous les nœuds du cluster, chaque nœud ayant un client monté de cette manière, ce qui rend ce stockage accessible à chaque nœud.
Pour la performance de n'importe lequel des approches décrites ci-dessus, il est très important, lors de la planification et du déploiement, de configurer correctement le réseau, où l'équilibrage se fait grâce à l'agrégation et à une bande passante réseau correctement sélectionnée. Dans l'agrégation, il est essentiel de choisir le mode de hachage et les tailles des trames de manière adéquate. Il y a également une distinction importante par rapport aux SDS décrits ci-dessus, c'est le fuse avec la technologie fast path dans Virtuozzo Storage. Ce dernier, en plus d'un fuse modernisé, contrairement aux autres solutions open source, augmente considérablement les IOPS et ne se limite pas à l'évolutivité horizontale ou verticale. En général, par rapport aux architectures décrites ci-dessus, celle-ci semble plus puissante, mais cet avantage nécessite l'achat de licences, contrairement à Ceph et Gluster.
En résumé, on peut souligner le classement des trois : la première place en termes de performance et de fiabilité est occupée par Virtuozzo Storage, suivie par Ceph et enfin Gluster.
Les critères pour lesquels Virtuozzo Storage a été choisi : c'est un ensemble optimal de composants d'architecture, un fuse modernisé avec fast path, une configuration matérielle flexible, une consommation de ressources réduite et la possibilité de co-utilisation avec des ressources de calcul (calculs/virtualisation), ce qui le rend entièrement adapté à une solution hyperconvergente, dont il fait partie. La deuxième place revient à Ceph, car c'est une architecture plus performante que Gluster, grâce à l'opération sur des blocs, ainsi qu'à des scénarios plus flexibles et la possibilité de travailler dans des clusters de plus grande taille.
Dans les projets, il y a le souhait d'écrire une comparaison entre vSAN, Space Direct Storage, Vstorage et Nutanix Storage, de tester Vstorage sur du matériel HPE, Huawei, ainsi que des scénarios d'intégration de Vstorage avec des systèmes de stockage externes, donc si vous avez aimé l'article, il serait bon de recevoir vos retours, qui pourraient renforcer la motivation pour de nouveaux articles en tenant compte de vos remarques et suggestions.
Source : habr.com
