

Bonjour Habr ! Je vous présente la traduction de l'article
.
Quand il s'agit de bases de données relationnelles, je ne peux pas m'empêcher de penser qu'il manque quelque chose. Elles sont utilisées partout. Il existe de nombreuses bases de données différentes : de SQLite, petite et utile, à Teradata, puissante. Mais il n'y a que quelques articles qui expliquent comment fonctionne une base de données. Vous pouvez chercher vous-même avec la requête "howdoesarelationaldatabasework" pour voir à quel point il y a peu de résultats. De plus, ces articles sont courts. Mais si vous cherchez les dernières technologies à la mode (Big Data, NoSQL ou JavaScript), vous trouverez plus d'articles approfondis expliquant comment elles fonctionnent.
Les bases de données relationnelles sont-elles trop anciennes et trop ennuyeuses pour être expliquées en dehors des cours universitaires, des travaux de recherche et des livres ?
En tant que développeur, je déteste utiliser ce que je ne comprends pas. Et si les bases de données existent depuis plus de 40 ans, il doit y avoir une raison. Au fil des ans, j'ai passé des centaines d'heures à vraiment comprendre ces étranges boîtes noires que j'utilise chaque jour. Bases de données relationnelles sont très intéressantes parce qu'elles sont basées sur des concepts utiles et réutilisables. Si vous êtes intéressé par la compréhension des bases de données, mais que vous n'avez jamais eu le temps ou l'envie de plonger dans ce vaste sujet, cet article devrait vous plaire.
Bien que le titre de cet article soit explicite, l'objectif de cet article n'est pas de comprendre comment utiliser une base de données. Par conséquent, vous devez déjà savoir comment écrire une simple requête de jointure et des requêtes de base CRUD; sinon, vous risquez de ne pas comprendre cet article. C'est la seule chose que vous devez savoir, je vais expliquer tout le reste.
Je vais commencer par quelques bases de la science informatique, comme la complexité temporelle des algorithmes (Big O). Je sais que certains d'entre vous détestent ce concept, mais sans lui, vous ne pourrez pas comprendre les subtilités à l'intérieur de la base de données. Étant donné que c'est un vaste sujet, je vais me concentrer sur ce que je considère comme important: comment la base de données traite SQL requête. Je ne présenterai que les concepts de base des bases de données, afin qu'à la fin de l'article, vous ayez une idée de ce qui se passe sous le capot.
Puisque cet article est long et technique, incluant de nombreux algorithmes et structures de données, ne vous dépêchez pas de le lire. Certains concepts peuvent être difficiles à comprendre; vous pouvez les manquer et obtenir tout de même une bonne vue d'ensemble.
Pour les plus informés d'entre vous, cet article est divisé en 3 parties :
- Aperçu des composants de base de données bas niveau et haut niveau
- Aperçu du processus d'optimisation des requêtes
- Aperçu de la gestion des transactions et du pool de tampons
Revenons aux bases
Il y a de nombreuses années (dans une galaxie lointaine, très lointaine…), les développeurs devaient connaître précisément le nombre d'opérations qu'ils codifiaient. Ils connaissaient par cœur leurs algorithmes et leurs structures de données car ils ne pouvaient pas se permettre de gaspiller le CPU et la mémoire de leurs ordinateurs lents.
Dans cette partie, je vous rappellerai certains de ces concepts, car ils sont nécessaires pour comprendre les bases de données. J'introduirai également le concept d' index de base de données.
O(1) contre O(n2)
Aujourd'hui, de nombreux développeurs ne se soucient pas de la complexité temporelle des algorithmes… et ils ont raison !
Mais lorsque vous traitez un grand volume de données (je ne parle pas de milliers) ou si vous luttez pour des millisecondes, il devient critique de comprendre ce concept. Et comme vous pouvez le comprendre, les bases de données doivent gérer les deux situations ! Je ne vous ferai pas perdre plus de temps que nécessaire pour saisir l'essentiel. Cela nous aidera plus tard à comprendre le concept d'optimisation basé sur les coûts (cost based optimization).
Concept
La complexité temporelle d'un algorithme est utilisée pour voir combien de temps il faudra pour exécuter l'algorithme pour un certain volume de données. Pour décrire cette complexité, on utilise des notations mathématiques en grand O. Cette notation est utilisée avec une fonction décrivant combien d'opérations un algorithme nécessite pour un certain volume de données d'entrée.
Par exemple, quand je dis "cet algorithme a une complexité O (some_function())", cela signifie que pour traiter une certaine quantité de données, l'algorithme nécessite some_function(a_certain_amount_of_data) opérations.
En même temps, il est important de ne pas considérer le nombre de données**, mais plutôt comment ** le nombre d'opérations augmente lorsque le volume de données augmente. La complexité temporelle ne donne pas un nombre exact d'opérations, mais c'est un bon moyen d'estimer le temps d'exécution.
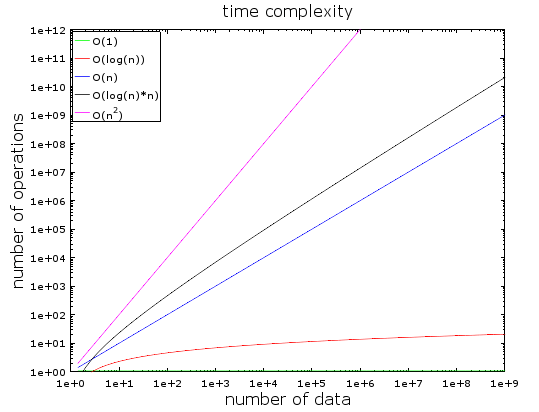
Dans ce graphique, vous pouvez voir la dépendance du nombre d'opérations par rapport à la taille des données d'entrée pour différents types de complexités temporelles des algorithmes. J'ai utilisé une échelle logarithmique pour les représenter. En d'autres termes, la quantité de données augmente rapidement de 1 à 1 milliard. Nous pouvons observer que :
- O(1) ou complexité constante reste constante (sinon, cela ne serait pas considéré comme une complexité constante).
- O(log(n)) reste faible même avec des milliards de données.
- La pire complexité est — O(n2), où le nombre d'opérations augmente rapidement.
- Les deux autres complexités augmentent également rapidement.
Exemples
Avec un petit nombre de données, la différence entre O(1) et O(n2) est négligeable. Par exemple, supposons que vous ayez un algorithme qui doit traiter 2000 éléments.
- L'algorithme O(1) vous coûtera 1 opération
- L'algorithme O(log(n)) vous coûtera 7 opérations
- L'algorithme O(n) vous coûtera 2 000 opérations
- L'algorithme O(n * log(n)) vous coûtera 14 000 opérations
- L'algorithme O(n2) vous coûtera 4 000 000 d'opérations
La différence entre O(1) et O(n2) semble importante (4 millions d'opérations) mais vous perdrez au maximum 2 ms, juste le temps de cligner des yeux. En effet, les processeurs modernes peuvent traiter . Voilà pourquoi la performance et l'optimisation ne sont pas un problème dans de nombreux projets informatiques.
Comme je l'ai déjà dit, il est toujours important de comprendre ce concept lorsque vous travaillez avec d'énormes ensembles de données. Si cette fois, l'algorithme doit traiter 1 000 000 d'éléments (ce qui n'est pas beaucoup pour une base de données) :
- L'algorithme O(1) vous coûtera 1 opération
- L'algorithme O(log(n)) vous coûtera 14 opérations
- L'algorithme O(n) vous coûtera 1 000 000 d'opérations
- L'algorithme O(n * log(n)) vous coûtera 14 000 000 d'opérations
- L'algorithme O(n2) vous coûtera 1 000 000 000 000 d'opérations
Je n'ai pas fait de calculs, mais je dirais qu'avec un algorithme O(n2), vous avez le temps de prendre un café (voire deux !). Si vous ajoutez un 0 à la taille des données, vous aurez le temps de faire une sieste.
Allons plus loin
Pour référence :
- La recherche dans une bonne table de hachage trouve un élément en O(1).
- La recherche dans un arbre bien équilibré donne un résultat en O(log(n)).
- La recherche dans un tableau donne un résultat en O(n).
- Les meilleurs algorithmes de tri ont une complexité de O(n * log(n)).
- Un mauvais algorithme de tri a une complexité de O(n2).
Remarque : dans les parties suivantes, nous verrons ces algorithmes et structures de données.
Il existe plusieurs types de complexité temporelle d'un algorithme :
- scénario moyen
- meilleur scénario
- et pire scénario
La complexité temporelle est souvent le pire scénario.
Je n'ai parlé que de la complexité temporelle d'un algorithme, mais la complexité s'applique également à :
- la consommation de mémoire par un algorithme
- la consommation d'entrée/sortie sur disque par un algorithme
Bien sûr, il existe des complexités pires que n², par exemple :
- n⁴ : c'est horrible ! Certains des algorithmes mentionnés ont une telle complexité.
- 3n : c'est encore pire ! L'un des algorithmes que nous verrons au milieu de cet article a cette complexité (et il est vraiment utilisé dans de nombreuses bases de données).
- factoriel n : vous n'obtiendrez jamais vos résultats même avec un petit ensemble de données.
- nⁿ : si vous rencontrez cette complexité, vous devez vous demander si c'est vraiment votre domaine...
Remarque : je ne vous ai pas donné une définition réelle de la notation « grand O », mais simplement une idée. Vous pouvez lire cet article pour une définition réelle (asymptotique). de tri.
MergeSort (Tri par fusion)
Que faites-vous lorsque vous devez trier une collection ? Quoi ? Vous appelez la fonction sort()… D'accord, bonne réponse… Mais pour une base de données, vous devez comprendre comment fonctionne cette fonction sort().
Il existe plusieurs bons algorithmes de tri, donc je vais me concentrer sur le plus important : le tri par fusion. Vous ne comprenez peut-être pas maintenant pourquoi le tri des données est utile, mais vous devrez le comprendre après la partie consacrée à l'optimisation des requêtes. De plus, comprendre le tri par fusion nous aidera plus tard à comprendre l'opération de jointure des bases de données, appelée fusionner joindre (jointure par fusion).
Fusion (Merge)
Comme beaucoup d'algorithmes utiles, le tri par fusion repose sur une astuce : fusionner 2 tableaux triés de taille N/2 en un tableau trié de N éléments coûte seulement N opérations. Cette opération s'appelle la fusion.
Voyons ce que cela signifie avec un exemple simple :
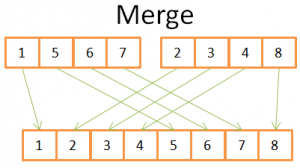
Sur cette image, vous pouvez voir que pour construire le tableau final trié de 8 éléments, vous devez simplement effectuer une itération une fois dans 2 tableaux de 4 éléments. Comme les deux tableaux de 4 éléments sont déjà triés :
- 1) vous comparez les deux éléments actuels dans les deux tableaux (au début actuel = au premier)
- 2) ensuite, prenez le plus petit pour le placer dans un tableau de 8 éléments
- 3) et passez à l'élément suivant dans le tableau où vous avez pris l'élément le plus petit
- et répétez 1, 2, 3, jusqu'à ce que vous atteigniez le dernier élément d'un des tableaux.
- Ensuite, vous prenez les autres éléments de l'autre tableau pour les placer dans un tableau de 8 éléments.
Cela fonctionne parce que les deux tableaux de 4 éléments sont triés, vous n'avez donc pas besoin de "revenir" dans ces tableaux.
Maintenant que nous avons compris ce truc, voici mon pseudo-code pour la fusion :
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //appels récursifs
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //fusionner les 2 petits tableaux ordonnés en un grand
   array result := merge(new_left_array,new_right_array);
   return result;
Le tri fusion divise la tâche en tâches plus petites, puis trouve les résultats des tâches plus petites pour obtenir le résultat de la tâche d'origine (remarque : ce type d'algorithmes est appelé diviser pour régner). Si vous ne comprenez pas cet algorithme, ne vous inquiétez pas ; je ne l'ai pas compris la première fois que je l'ai vu. Pour vous aider, je vois cet algorithme comme un algorithme en deux phases :
- Phase de division, où le tableau est divisé en tableaux plus petits
- Phase de tri, où les petits tableaux sont fusionnés (en utilisant la fusion) pour former un tableau plus grand.
Phase de division
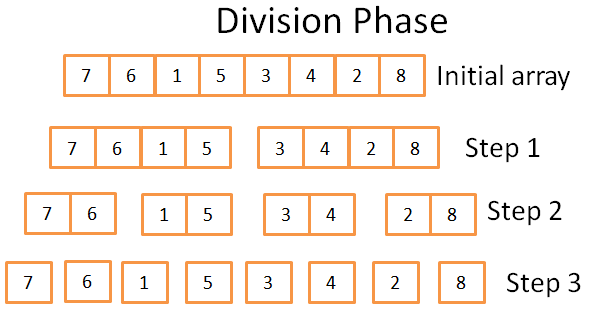
À l'étape de division, le tableau est divisé en tableaux unitaires en 3 étapes. Le nombre formel d'étapes est log(N) (puisque N=8, log(N) = 3).
Comment le sais-je ?
Je suis un génie ! En un mot — mathématiques. L'idée est que chaque étape divise la taille du tableau d'origine par 2. Le nombre d'étapes est le nombre de fois que vous pouvez diviser le tableau d'origine par deux. C'est la définition exacte du logarithme (en base 2).
Phase de tri
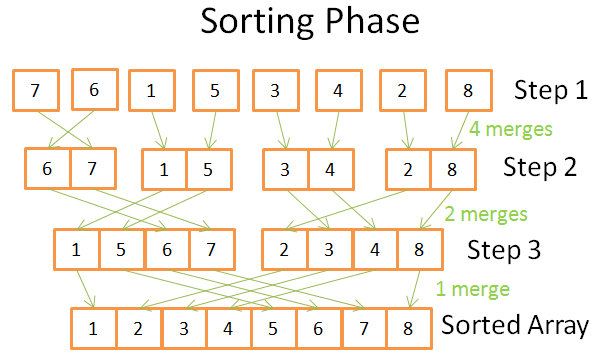
À l'étape de tri, vous commencez avec des tableaux unitaires (à un élément). À chaque étape, vous appliquez plusieurs opérations de fusion, et le coût total est N = 8 opérations :
- À la première étape, vous avez 4 fusions qui coûtent 2 opérations chacune
- À la deuxième étape, vous avez 2 fusions qui coûtent 4 opérations chacune
- À la troisième étape, vous avez 1 fusion qui coûte 8 opérations
Puisqu'il y a log(N) étapes, le coût total est N * log(N) opérations.
Avantages du tri fusion
Pourquoi cet algorithme est-il si puissant ?
Parce que :
- Vous pouvez le modifier pour réduire l'utilisation de la mémoire, de manière à ne pas créer de nouveaux tableaux, mais à modifier directement le tableau d'entrée.
Remarque : ce type d'algorithmes s'appelle (tri sans mémoire supplémentaire).
- Vous pouvez le modifier pour utiliser simultanément l'espace disque et une faible quantité de mémoire sans coûts importants en entrée/sortie disque. L'idée est de ne charger en mémoire que les parties qui sont actuellement traitées. Cela est important lorsque vous devez trier un tableau de plusieurs gigaoctets avec uniquement un tampon de 100 mégaoctets.
Remarque : ce type d'algorithmes s'appelle .
- Vous pouvez le modifier pour fonctionner sur plusieurs processus / threads / serveurs.
Par exemple, le tri par fusion distribué est l'un des composants clés (qui est une infrastructure pour le big data).
- Cet algorithme peut transformer du plomb en or (c'est vrai !).
Cet algorithme de tri est utilisé dans la plupart (s'il n'y en a pas d'autres) des bases de données, mais il n'est pas le seul. Si vous voulez en savoir plus, vous pouvez lire ce , qui discute des avantages et des inconvénients des algorithmes de tri courants dans les bases de données.
Tableau, Arbre et Table de Hachage
Maintenant que nous comprenons l'idée de complexité temporelle et de tri, je dois vous parler de 3 structures de données. C'est important car elles sont à la base des bases de données modernes. J'introduirai également le concept de index de base de données.
Tableau
Un tableau à deux dimensions est la structure de données la plus simple. Une table peut être considérée comme un tableau. Par exemple :
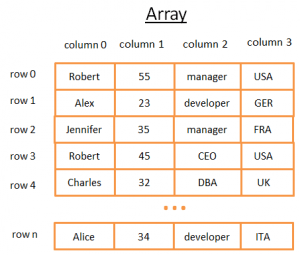
Ce tableau 2D représente une table avec des lignes et des colonnes :
- Chaque ligne représente une entité
- Les colonnes contiennent des propriétés décrivant l'entité.
- Chaque colonne stocke des données d'un type particulier (entier, chaîne, date ...).
C'est pratique pour stocker et visualiser des données, mais lorsque vous devez trouver une valeur particulière, ce n'est pas adapté.
Par exemple, si vous souhaitez trouver tous les gars qui travaillent au Royaume-Uni, vous devrez parcourir chaque ligne pour déterminer si cette ligne appartient au Royaume-Uni. Cela vous coûtera N opérations, où N — nombre de lignes, ce qui n'est pas mal, mais peut-il y avoir un chemin plus rapide ? Il est maintenant temps de se familiariser avec les arbres.
Remarque : la plupart des bases de données modernes fournissent des tableaux étendus pour un stockage efficace : des tables organisées par tas et des tables organisées par index. Mais cela ne change pas le problème d'une recherche rapide d'une certaine condition dans un groupe de colonnes.
Arbre et index de base de données
Un arbre binaire de recherche est un arbre binaire avec une propriété spéciale, la clé de chaque nœud doit être :
- plus grande que toutes les clés stockées dans le sous-arbre gauche
- plus petite que toutes les clés stockées dans le sous-arbre droit
Voyons ce que cela signifie visuellement
Idée
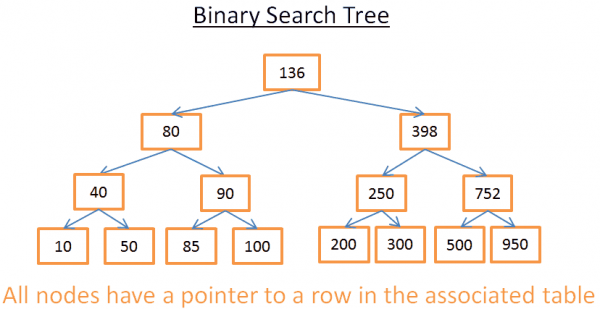
Cet arbre a N = 15 éléments. Supposons que je cherche 208 :
- Je commence par la racine, dont la clé est 136. Puisque 136<208, je regarde le sous-arbre droit du nœud 136.
- 398>208, par conséquent, je regarde le sous-arbre gauche du nœud 398
- 250>208, par conséquent, je regarde le sous-arbre gauche du nœud 250
- 200<208, par conséquent, je regarde le sous-arbre droit du nœud 200. Mais 200 n'a pas de sous-arbre droit, la valeur n'existe pas (parce que, si elle existait, elle se trouverait dans le sous-arbre droit de 200).
Maintenant, disons que je cherche 40
- Je commence par la racine, dont la clé est 136. Puisque 136 > 40, je regarde le sous-arbre gauche du nœud 136.
- 80 > 40, par conséquent, je regarde le sous-arbre gauche du nœud 80
- 40= 40, le nœud existe. J'extrais l'identifiant de ligne à l'intérieur du nœud (cela n'est pas visible sur le dessin) et je consulte la table pour cet identifiant de ligne.
- Connaître l'identifiant de ligne me permet de savoir exactement où se trouvent les données dans la table, et je peux donc les obtenir instantanément.
En fin de compte, les deux recherches me coûteront en nombre de niveaux à l'intérieur de l'arbre. Si vous avez bien lu la partie sur le tri par fusion, vous devez voir qu'il y a log(N) niveaux ici. Cela signifie que le coût de recherche est log(N), pas mal !
Revenons à notre problème
Mais c'est très abstrait, alors revenons à notre problème. Au lieu d'un simple entier, imaginez une chaîne qui représente le pays de quelqu'un dans le tableau précédent. Supposons que vous avez un arbre qui contient le champ "country" (colonne 3) de la table :
- Si vous voulez savoir qui travaille au Royaume-Uni
- vous regardez l'arbre pour obtenir le nœud qui représente le Royaume-Uni
- À l'intérieur de "UKnode", vous trouverez l'emplacement des enregistrements des travailleurs au Royaume-Uni.
Cette recherche coûtera log(N) opérations au lieu de N opérations si vous utilisez directement un tableau. Ce que vous venez de présenter était un index de base de données.
Vous pouvez construire un arbre d'index pour n'importe quel groupe de champs (chaîne, nombre, 2 chaînes, nombre et chaîne, date, etc.) tant que vous disposez d'une fonction pour comparer les clés (c'est-à-dire les groupes de champs) afin que vous puissiez établir un ordre parmi les clés (ce qui est valable pour tous les types de base dans une base de données).
B+TreeIndex
Bien que cet arbre fonctionne bien pour obtenir une valeur spécifique, il existe un GRAND problème lorsque vous devez obtenir plusieurs éléments entre deux valeurs. Cela coûtera O(N) car vous devrez examiner chaque nœud dans l'arbre et vérifier s'il se situe entre ces deux valeurs (par exemple, avec un parcours ordonné de l'arbre). De plus, cette opération n'est pas pratique pour les entrées-sorties disque, car vous devrez lire l'ensemble de l'arbre. Nous devons trouver un moyen d'exécuter efficacement une requête de plage. Pour résoudre ce problème, les bases de données modernes utilisent une version modifiée de l'arbre précédent appelée B+Tree. Dans un arbre B+Tree :
- seuls les nœuds les plus bas (feuilles) conservent les informations (l'emplacement des lignes dans la table associée)
- les autres nœuds sont ici pour le routage vers le bon nœud lors de la recherche.
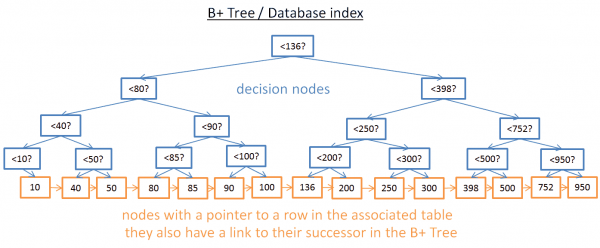
Comme vous pouvez le voir, il y a plus de nœuds ici (deux fois plus). En effet, vous avez des nœuds supplémentaires, des "nœuds de décision", qui vous aideront à trouver le bon nœud (qui conserve l'emplacement des lignes dans la table associée). Mais la complexité de la recherche est toujours O(log(N)) (il n'y a qu'un niveau supplémentaire). La grande différence est que les nœuds au niveau le plus bas sont liés à leurs successeurs..
Avec cet arbre B+, si vous cherchez des valeurs de 40 à 100 :
- Vous devez simplement chercher 40 (ou la valeur la plus proche après 40, si 40 n'existe pas), comme vous le faisiez avec l'arbre précédent.
- Ensuite, collectez les successeurs de 40, en utilisant des liens directs vers les successeurs, jusqu'à atteindre 100.
Supposons que vous ayez trouvé M successeurs, et que l'arbre ait N nœuds. La recherche d'un nœud spécifique coûte log(N) comme pour l'arbre précédent. Mais, une fois ce nœud obtenu, vous obtiendrez M successeurs en M opérations avec des références à leurs successeurs. Cette recherche ne coûte que M+log(N) opérations par rapport à N opérations avec l'arbre précédent. De plus, vous n’avez pas besoin de lire l'arbre entier (seulement M + log(N) nœuds), ce qui signifie une utilisation réduite du disque. Si M est faible (par exemple, 200 lignes) et N est élevé (1 000 000 lignes), cela fera UNE GRANDE différence.
Mais ici, de nouveaux problèmes apparaissent (encore une fois !). Si vous ajoutez ou supprimez une ligne dans la base de données (et donc dans l'indice B+Tree associé) :
- vous devez maintenir l'ordre entre les nœuds à l'intérieur de l'arbre B+Tree, sinon vous ne pourrez pas trouver les nœuds dans un arbre non trié.
- vous devez conserver le nombre minimal possible de niveaux dans le B+Tree, sinon la complexité temporelle en O(log(N)) deviendra O(N).
En d'autres termes, le B+Tree doit être auto-ordonné et équilibré. Heureusement, cela est possible avec des opérations d'insertion et de suppression intelligentes. Mais cela coûte cher : l'insertion et la suppression dans l'arbre B+ coûtent O(log(N)). C'est pourquoi certains d'entre vous ont entendu dire que l'utilisation d'un nombre excessif d'index n'est pas une très bonne idée. En effet, vous ralentissez l'insertion / mise à jour / suppression rapide d'une ligne dans une table, car la base de données doit mettre à jour les index de la table avec une opération coûteuse O(log(N)) pour chaque index. De plus, l'ajout d'index signifie une plus grande charge pour le gestionnaire de transactions (décrit à la fin de l'article).
Pour plus d'informations, vous pouvez consulter l'article de Wikipédia sur . Si vous souhaitez un exemple d'implémentation d'un B+Tree dans une base de données, regardez et par le développeur principal de MySQL. Ils se concentrent tous deux sur la manière dont InnoDB (moteur de MySQL) gère les index.
Remarque : un lecteur m'a dit que, en raison des optimisations de bas niveau, l'arbre B+ doit être complètement équilibré.
Table de hachage
Notre dernière structure de données importante est la table de hachage. Elle est très utile lorsque vous souhaitez rechercher rapidement des valeurs. De plus, comprendre la table de hachage nous aidera plus tard à comprendre l'opération de jointure en base de données appelée jointure par hachage ( hash join). Cette structure de données est également utilisée par la base de données pour stocker certaines choses internes (par exemple, table de verrouillage ou pool de tampon, nous verrons ces deux concepts plus tard).
Une table de hachage est une structure de données qui trouve rapidement un élément par sa clé. Pour construire une table de hachage, vous devez définir :
- clé pour vos éléments
- fonction de hachage pour les clés. Les hachages des clés calculés donnent la position des éléments (appelés segments ).
- fonction pour comparer les clés. Une fois que vous avez trouvé le bon segment, vous devez trouver l'élément que vous recherchez à l'intérieur du segment en utilisant cette comparaison.
Exemple simple
Prenons un exemple illustratif :
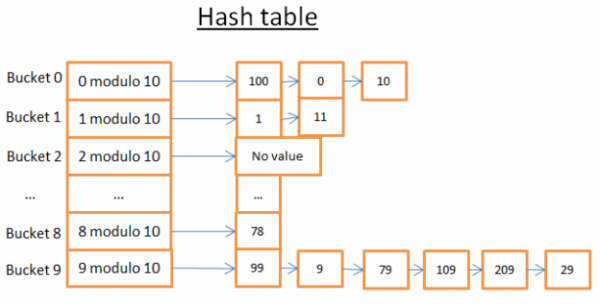
Cette table de hachage a 10 segments. Comme je suis paresseux, j'ai seulement représenté 5 segments, mais je sais que vous êtes intelligents, donc je vous laisse imaginer les 5 autres par vous-même. J'ai utilisé une fonction de hachage basée sur le module 10 de la clé. En d'autres termes, je ne conserve que le dernier chiffre de la clé de l'élément pour trouver son segment :
- si le dernier chiffre est 0, l'élément va dans le segment 0,
- si le dernier chiffre est 1, l'élément va dans le segment 1,
- si le dernier chiffre est 2, l'élément va dans le secteur 2,
- …
La fonction de comparaison que j'ai utilisée est simplement l'égalité entre deux nombres entiers.
Disons que vous voulez obtenir l'élément 78 :
- La table de hachage calcule le code de hachage pour 78, qui est 8.
- La table de hachage regarde dans le segment 8, et le premier élément qu'elle trouve est 78.
- Elle vous retourne l'élément 78
- La recherche n'a coûté que 2 opérations (une pour calculer la valeur de la fonction de hachage et l'autre pour rechercher l'élément dans le segment).
Maintenant, disons que vous voulez obtenir l'élément 59 :
- La table de hachage calcule le code de hachage pour 59, qui est 9.
- La table de hachage cherche dans le segment 9, le premier élément trouvé est 99. Comme 99!=59, l'élément 99 n'est pas le bon élément.
- En utilisant cette même logique, on prend le deuxième élément (9), le troisième (79), …, le dernier (29).
- Élément non trouvé.
- La recherche a coûté 7 opérations.
Une bonne fonction de hachage
Comme vous le voyez, selon la valeur que vous recherchez, le coût n'est pas le même !
Si maintenant je change la fonction de hachage pour le module 1 000 000 de la clé (c'est-à-dire en prenant les 6 derniers chiffres), la deuxième recherche ne coûtera qu'une opération, car il n'y a pas d'éléments dans le segment 000059. Le véritable défi consiste à trouver une bonne fonction de hachage qui créera des segments contenant très peu d'éléments..
Dans mon exemple, il est facile de trouver une bonne fonction de hachage. Mais c'est un exemple simple, trouver une bonne fonction de hachage devient plus compliqué lorsque la clé :
- est une chaîne (par exemple, un nom de famille)
- 2 chaînes (par exemple, un nom de famille et un prénom)
- 2 chaînes et une date (par exemple, un nom de famille, un prénom et une date de naissance)
- …
Avec une bonne fonction de hachage, la recherche dans une table de hachage s'effectue en O(1)..
Tableau vs table de hachage
Pourquoi ne pas utiliser un tableau ?
Hmm, bonne question.
- Une table de hachage peut être partiellement chargée en mémoire,tandis que les autres segments peuvent rester sur le disque.
- Avec un tableau, vous devez utiliser un espace contigu en mémoire. Si vous chargez un grand tableau, il est très difficile de trouver suffisamment d'espace contigu..
- Pour une table de hachage, vous pouvez choisir la clé dont vous avez besoin (par exemple, le pays et le nom de famille de la personne).
Pour plus d'informations, vous pouvez lire l'article sur qui est une implémentation efficace d'une table de hachage ; vous n'avez pas besoin de comprendre Java pour saisir les concepts présentés dans cet article.
Source : habr.com
