

Préface
Il existe un outil simple et très utile dans le monde — , et il se trouve qu'il fait partie de notre processus de production depuis très longtemps (bien que je n'ai pas réussi à installer sa version, il est clair qu'elle n'était pas la dernière disponible). Nous l'utilisons pour sa fonction principale — la création de patchs binaires. En regardant ce qu'il y a dans le dépôt, on devient un peu triste : en gros, il est depuis longtemps à l'abandon et beaucoup de choses y sont très obsolètes (mon ancien collègue a apporté quelques modifications là-bas, mais cela fait longtemps). En gros, j'ai décidé de le ressusciter : j'ai fait un fork, supprimé ce que je ne compte pas utiliser, et j'ai migré le projet sur , j'ai intégré en ligne de petites micro-fonctions, retiré de la pile de grands tableaux (et des tableaux de longueur variable, qui me font clairement 'exploser'), j'ai encore une fois passé le profileur — et j'ai appris que près de 40 % du temps est consacré à …
Alors, qu'en est-il de fwrite ?
Dans ce code, fwrite (dans mon cas de test spécifique : création d'un patch entre des fichiers proches de 300 Mo, les données d'entrée étant entièrement en mémoire) est appelé des millions de fois avec un petit tampon. Il est évident que cela va ralentir les performances, et donc j'aimerais influencer cela d'une manière ou d'une autre sans vouloir introduire des sources de données différentes ou une entrée/sortie asynchrone, je cherchais une solution plus simple. La première chose qui m'est venue à l'esprit — augmenter la taille du tampon
setvbuf(file, nullptr, _IOFBF, 64* 1024)mais je n'ai pas obtenu d'amélioration significative (maintenant fwrite prenait environ 37 % du temps) — donc le problème n'est pas réellement dû à l'écriture fréquente de données sur le disque. En regardant 'sous le capot' de fwrite, on peut voir qu'il y a un lock/unlock de la structure FILE qui se passe à peu près comme ça (pseudocode, toute l'analyse a été faite sous Visual Studio 2017) :
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Si l'on en croit le profileur, seulement 6 % du temps est consacré à _fwrite_nolock, le reste étant des overheads. Dans mon cas spécifique, la sécurité des flux est un excès évident, et je vais faire des sacrifices en remplaçant l'appel à fwrite par — même avec des arguments, il n'est pas nécessaire de compliquer les choses. En résumé : cette astuce simple a considérablement réduit les coûts d'écriture des résultats, qui, dans la version initiale, représentaient presque la moitié du temps total. D'ailleurs, dans le monde de POSIX, il existe une fonction similaire — . En général, cela s'applique également à fread. Ainsi, avec quelques #define, on peut obtenir une solution entièrement multiplateforme sans verrouillages inutiles, lorsque cela n'est pas nécessaire (ce qui est souvent le cas).
fwrite, _fwrite_nolock, setvbuf
Abstrayons-nous du projet original et concentrons-nous sur le test d'un cas spécifique : l'écriture d'un gros fichier (512 Mo) en très petites portions — 1 octet. Système de test : AMD Ryzen 7 1700, 16 Go de RAM, HDD 7200 rpm, 64 Mo de cache, Windows 10 1809, binaire construit en 32 bits, optimisations activées, bibliothèque statiquement liée.
Échantillon pour réaliser l'expérience :
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Les variables seront TEST_BUFFER_SIZE, et dans quelques cas, nous remplacerons fwrite_unlocked par fwrite. Commençons par le cas de fwrite sans spécification explicite de la taille du tampon (nous commenterons setvbuf et le code associé) : temps 27048906 µs, vitesse d'écriture — 18,93 Mo/s. Maintenant, établissons la taille du tampon à 64 Ko : temps — 25037111 µs, vitesse — 20,44 Mo/s. Testons maintenant le fonctionnement de _fwrite_nolock sans appel à setvbuf : 7262221 µs, vitesse — 70,5 Mo/s !
Continuons à expérimenter avec la taille du tampon (setvbuf) :
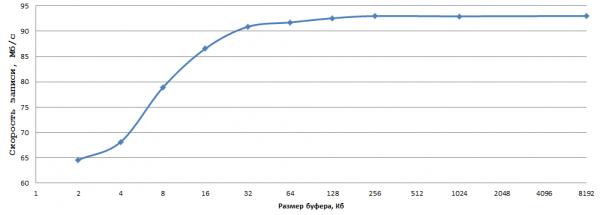
Les données sont obtenues par la moyenne de 5 expériences, je n'ai pas pris la peine de calculer les erreurs. Pour moi, 93 Mo/s lors de l'écriture de 1 octet sur un HDD standard est un très bon résultat, il suffit de choisir la taille de tampon optimale (dans mon cas, 256 Ko — c'est parfait) et de remplacer fwrite par _fwrite_nolock/fwrite_unlocked (si la sécurité des threads n'est pas nécessaire, bien sûr).
De même avec fread dans de telles conditions. Étant donné que je n'ai pas de machine 'physique' avec linux sous la main (les cartes simples ne comptent pas), j'ai décidé de réaliser une expérience limitée sur une machine virtuelle (Hyper-V, OpenSUSE 15, GCC 8.3.1) — la tendance est essentiellement la même : fwrite pur 20 Mo/s, fwrite + tampon de 256 Ko a donné 23 Mo/s, fwrite_unlocked avec le même tampon — 35 Mo/s (binaire 64 bits, compilé avec g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Postface
L'objectif de cet article était de décrire une méthode simple et efficace dans de nombreux cas (je n'avais jamais rencontré les fonctions _fwrite_nolock/fwrite_unlocked auparavant, elles ne sont pas très populaires - et c'est dommage). Je ne prétends pas à la nouveauté du contenu, mais j'espère que cet article sera utile à la communauté.
Source : habr.com
