

Alors, vous collectez des métriques. Tout comme nous. Nous collectons également des métriques. Bien sûr, celles nécessaires pour les affaires. Aujourd'hui, nous allons parler du tout premier maillon de notre système de surveillance — un serveur d'agrégation compatible avec statsd. , pourquoi nous l'avons écrit et pourquoi nous avons abandonné brubeck.
Dans nos articles précédents (, ) vous pouvez apprendre que jusqu'à un certain moment, nous avons collecté des tags à l'aide de . Il est écrit en C. En termes de code, il est aussi simple qu'un bouchon (ce qui est important lorsque vous souhaitez contribuer) et, surtout, il gère sans problème nos volumes de 2 millions de métriques par seconde (MPS) en pointe. La documentation annonce un support de 4 millions de MPS avec astérisque. Cela signifie que vous obtiendrez le chiffre annoncé si vous configurez correctement le réseau sous Linux. (Nous ne savons pas combien de MPS il est possible d'obtenir si le réseau reste tel quel). Malgré ces avantages, nous avions quelques griefs sérieux contre brubeck.
Grief 1. Github — le développeur du projet — a cessé de le soutenir : publier des patchs et des corrections, accepter nos PR (et d'autres également). Au cours des derniers mois (depuis environ février-mars 2018), l'activité a repris, mais avant cela, il y avait presque 2 ans de silence complet. De plus, le projet est développé , ce qui peut constituer un obstacle sérieux à l'implémentation de nouvelles fonctionnalités.
Grief 2. Précision des calculs. Brubeck ne collecte que 65536 valeurs pour l'agrégation. Dans notre cas, pour certaines métriques pendant la période d'agrégation (30 secondes), il peut y avoir beaucoup plus de valeurs (1 527 392 en pointe). En conséquence de cet échantillonnage, les valeurs des maximums et minimums semblent inutiles. Par exemple, ainsi :
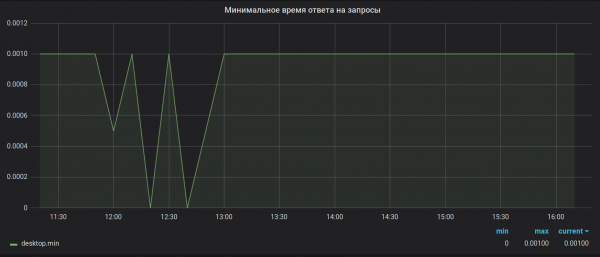
Comment c'était
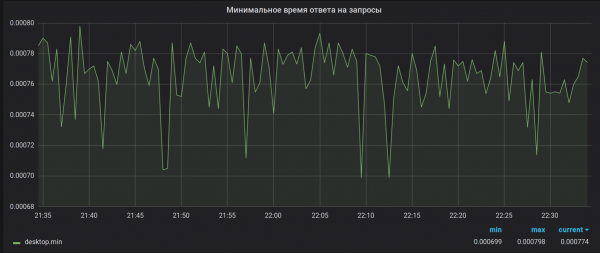
Comment cela aurait dû être
Pour la même raison, les sommes sont complètement incorrectes. Ajoutez à cela un bug de débordement des flottants 32 bits, qui envoie le serveur dans un segfault lorsqu'il reçoit une métrique apparemment innocente, et c'est encore mieux. Au fait, ce bug n'a toujours pas été corrigé.
Et enfin, Grief X. Au moment de la rédaction de cet article, nous sommes prêts à le soumettre à toutes les 14 implémentations de statsd plus ou moins fonctionnelles que nous avons pu trouver. Imaginons qu'une infrastructure donnée ait grandi au point où accepter 4 millions de MPS ne suffit plus. Ou peut-être n'a-t-elle pas encore grandi, mais les métriques sont déjà si importantes pour vous que même de courtes interruptions de 2 à 3 minutes sur les graphiques peuvent devenir critiques et plonger les managers dans une dépression insurmontable. Comme traiter la dépression est une tâche ingrate, des solutions techniques sont nécessaires.
Tout d'abord, la tolérance aux pannes, afin qu'un problème soudain sur le serveur ne déclenche pas l'apocalypse zombie psychiatrique au bureau. Deuxièmement, l'évolutivité, pour pouvoir accepter plus de 4 millions de MPS sans avoir à plonger dans la pile réseau Linux et croître aisément "en largeur" jusqu'aux dimensions nécessaires.
Comme nous avions suffisamment de réserve en matière d'évolutivité, nous avons décidé de commencer par la tolérance aux pannes. « Oh ! Tolérance aux pannes ! C'est simple, nous savons faire ça », avons-nous pensé et avons lancé 2 serveurs, levant sur chacun une copie de brubeck. Pour cela, nous avons dû copier le trafic des métriques sur les deux serveurs et même écrire une . Nous avons résolu le problème de tolérance aux pannes, mais... pas très bien. Au début, tout semblait aller bien : chaque brubeck collecte sa propre variante d'agrégation, écrit des données dans Graphite toutes les 30 secondes, en écrasant l'intervalle précédent (cela se fait côté Graphite). Si un serveur tombe en panne, nous avons toujours le deuxième avec sa propre copie des données agrégées. Mais voilà le problème : si un serveur tombe en panne, il y a une "scie" sur les graphiques. Cela est dû au fait que les intervalles de 30 secondes sur brubeck ne sont pas synchronisés, et au moment de la panne, l'un d'eux n'est pas réécrit. Lors du démarrage du deuxième serveur, c'est la même chose. C'est assez tolérable, mais nous voulons mieux ! Le problème d'évolutivité n'a également pas disparu. Toutes les métriques continuent de "fuser" vers un serveur unique, et nous sommes donc limités par ces mêmes 2 à 4 millions de MPS en fonction de l'optimisation du réseau.
Si l'on réfléchit un peu au problème tout en pelletant la neige, une idée évidente peut venir à l'esprit : un statsd capable de fonctionner en mode distribué. C'est-à-dire, celui qui dispose d'une synchronisation entre les nœuds en termes de temps et de métriques. « Bien sûr, une telle solution existe sûrement déjà », avons-nous dit en allant faire des recherches… Et nous n'avons rien trouvé. En parcourant la documentation de différents statsd, à la date du 11.12.2017), nous n'avons trouvé absolument rien. Il semble que ni les développeurs ni les utilisateurs de ces solutions ne se soient encore heurtés à UN TEL nombre de métriques, sinon ils auraient sûrement trouvé quelque chose.
Et là, nous nous sommes rappelés du statsd « jouet » - bioyino, que nous avions écrit lors du hackathon juste pour le plaisir (le nom du projet a été généré par un script avant le début du hackathon) et nous avons réalisé qu'il nous fallait d'urgence notre propre statsd. Pourquoi ?
- Parce qu'il y a trop peu de clones de statsd dans le monde,
- Parce qu'il est possible d'assurer une résilience et une évolutivité souhaitées ou proches du souhaité (y compris synchroniser les métriques agrégées entre les serveurs et résoudre les problèmes de conflits lors de l'envoi),
- Parce qu'il est possible de calculer les métriques plus précisément que ne le fait brubeck,
- Parce qu'il est possible de collecter nous-mêmes des statistiques plus détaillées, que brubeck ne nous fournissait pratiquement pas,
- Parce qu'une chance s'est présentée de programmer notre propre application de distribution haute performance, qui ne reproduira pas entièrement l'architecture d'une autre application similaire.
Sur quoi programmer ? Bien sûr, en Rust. Pourquoi ?
- Parce qu'il y avait déjà un prototype de solution,
- Parce que l'auteur de l'article savait déjà Rust à ce moment-là et voulait écrire quelque chose en production avec la possibilité de le publier en open-source,
- Parce que les langages avec GC ne conviennent pas à cause de la nature du trafic reçu (pratiquement en temps réel) et les pauses de GC sont quasiment inacceptables,
- Parce qu'il faut maximum de performance, comparable à C
- Parce que Rust nous offre une concurrence sans crainte, et en commençant à écrire cela en C/C++, nous aurions accumulé encore plus de vulnérabilités, de débordements de tampon, de conditions de course et d'autres mots effrayants.
Il y avait également des arguments contre Rust. L'entreprise n'avait pas d'expérience dans le développement de projets avec Rust, et nous ne prévoyons pas de l'utiliser dans le projet principal. Par conséquent, il y avait de sérieuses inquiétudes quant à la réussite, mais nous avons décidé de prendre le risque et d'essayer.
Le temps passait...
Enfin, après plusieurs tentatives infructueuses, la première version opérationnelle était prête. Quel en a été le résultat ? Voici ce que nous avons obtenu.
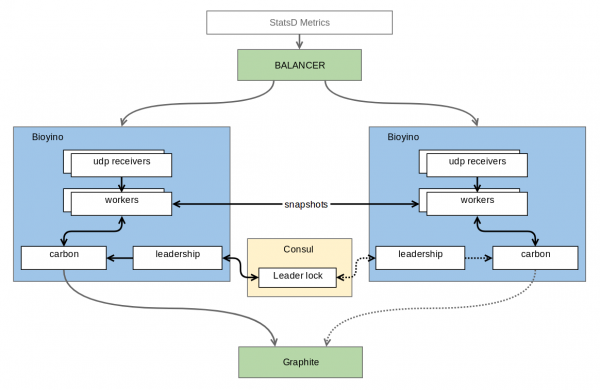
Chaque nœud reçoit son propre ensemble de métriques et les accumule, sans agréger les métriques pour les types qui nécessiteraient un ensemble complet pour l'agrégation finale. Les nœuds sont interconnectés par un protocole de verrouillage distribué (distributed lock) qui permet de choisir celui qui est le seul (c'est ici que nous avons pleuré) digne d'envoyer les métriques au Grand. Actuellement, ce problème est résolu par les moyens , mais à l'avenir, les ambitions de l'auteur s'étendent à Raft, où celui qui mérite d'envoyer les métriques sera, bien sûr, le nœud leader du consensus. En plus du consensus, les nœuds envoient souvent (par défaut une fois par seconde) à leurs voisins les parties pré-agrégées des métriques qu'ils ont pu accumuler durant cette seconde. Ainsi, l'évolutivité et la tolérance aux pannes sont conservées - chaque nœud garde toujours un ensemble complet de métriques, mais les métriques sont maintenant envoyées sous forme agrégée, par TCP et avec un encodage dans un protocole binaire, ce qui réduit considérablement les coûts de duplication par rapport à UDP. Malgré le nombre relativement élevé de métriques entrantes, l'accumulation nécessite très peu de mémoire et encore moins de CPU. Pour nos métriques facilement compressibles, cela ne représente que quelques dizaines de mégaoctets de données. Un bonus supplémentaire est l'absence de réécritures inutiles de données dans Graphite, comme cela a été le cas avec burbeck.
Les paquets UDP avec des métriques sont répartis entre les nœuds sur le matériel réseau via un simple Round Robin. Évidemment, le matériel réseau ne déchiffre pas le contenu des paquets et peut donc gérer bien plus que 4 millions de paquets par seconde, sans parler des métriques qu'il ne connaît pas du tout. Étant donné que les métriques ne viennent pas une par une dans chaque paquet, nous ne prévoyons pas de problèmes de performance à ce niveau. En cas de panne du serveur, l'appareil réseau détecte rapidement (dans un délai de 1 à 2 secondes) ce fait et retire le serveur défaillant de la rotation. En conséquence, les nœuds passifs (c'est-à-dire non leaders) peuvent être activés et désactivés sans que des baisses soient visibles sur les graphiques. Au maximum, ce que nous perdons, c'est une partie des métriques reçues au cours de la dernière seconde. Une perte/suspension/changement soudain du leader dessinera toujours une légère anomalie (l'intervalle de 30 secondes reste désynchronisé), mais avec une communication entre les nœuds, ces problèmes peuvent être minimisés, par exemple en envoyant des paquets de synchronisation.
Un peu sur la structure interne. L'application est bien sûr multithread, mais l'architecture des threads diffère de celle utilisée dans brubeck. Les threads dans brubeck sont identiques - chacun d'eux est responsable à la fois de la collecte d'informations et de l'agrégation. Dans bioyino, les threads de travail (workers) sont répartis en deux groupes : ceux responsables du réseau et ceux responsables de l'agrégation. Cette séparation permet de gérer l'application de manière plus flexible selon le type de métriques : là où une agrégation intensive est nécessaire, on peut ajouter des agrégateurs, là où le trafic réseau est élevé - augmenter le nombre de threads réseau. Actuellement, sur nos serveurs, nous travaillons avec 8 threads réseau et 4 threads d'agrégation.
La partie calculatrice (responsable de l'agrégation) est assez ennuyeuse. Les tampons remplis par les threads réseau sont répartis entre les threads de calcul, où ils sont ensuite analysés et agrégés. Sur demande, les métriques sont renvoyées pour être envoyées à d'autres nœuds. Tout cela, y compris le transfert de données entre les nœuds et le travail avec Consul, est effectué de manière asynchrone, fonctionnant sur le framework .
Le développement de la partie réseau, responsable de la réception des métriques, a posé beaucoup plus de problèmes. L'objectif principal de séparer les flux réseau en entités distinctes était de réduire le temps que prend le flux ne pour lire les données à partir d'un socket. Les options utilisant UDP asynchrone et la fonction recvmsg ont rapidement été écartées : la première consomme trop de CPU en espace utilisateur pour le traitement des événements, la seconde entraîne trop de changements de contexte. Par conséquent, nous utilisons maintenant avec de grands tampons (et les tampons, mesdames et messieurs, ce n'est pas rien !). Le support de l'UDP standard est maintenu pour les cas peu chargés, où recvmmsg n'est pas nécessaire. En mode multimessage, nous parvenons à atteindre l'essentiel : la majorité du temps, le flux réseau gère la file d'attente du système d'exploitation — il lit les données du socket et les transfère dans le tampon utilisateur, ne passant que rarement sur le traitement des tampons remplis par les agrégateurs. La file d'attente dans le socket ne s'accumule pratiquement pas, et le nombre de paquets abandonnés n'augmente pratiquement pas.
Remarque
Dans les paramètres par défaut, la taille du tampon est définie suffisamment grande. Si vous décidez d'essayer le serveur par vous-même, vous pourriez rencontrer le problème selon lequel, après l'envoi d'un petit nombre de métriques, elles n'arrivent pas dans Graphite, restant dans le tampon du flux réseau. Pour travailler avec un petit nombre de métriques, il faut définir dans la configuration des valeurs plus petites pour bufsize et task-queue-size.
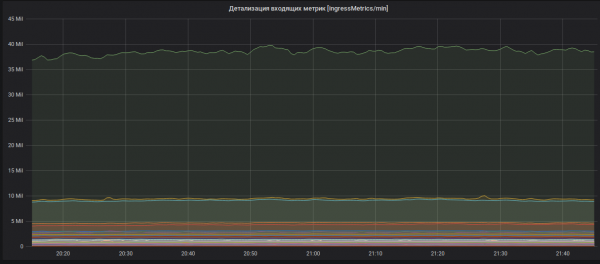
Enfin, un peu de graphiques pour les amateurs de graphiques.
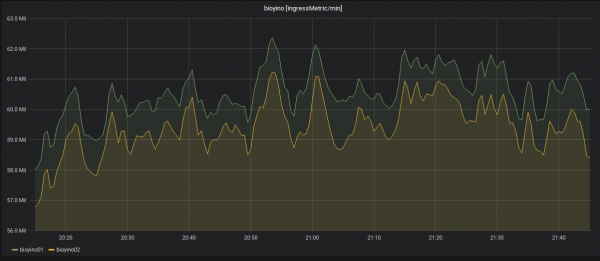
Statistique du nombre de métriques entrantes par serveur : plus de 2 millions MPS.
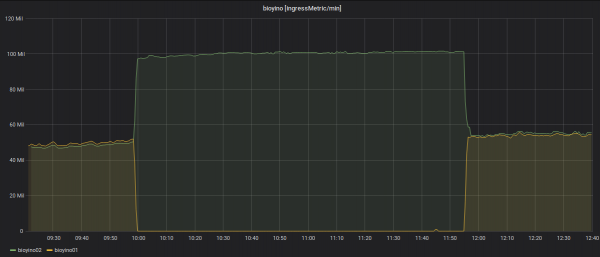
Désactivation de l'un des nœuds et redistribution des métriques entrantes.
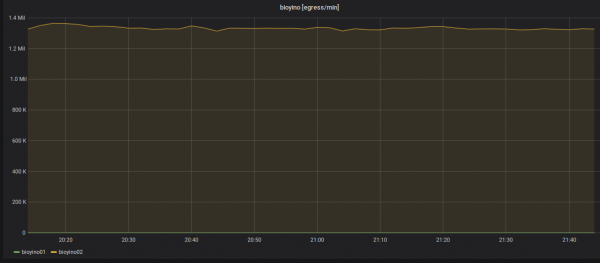
Statistiques sur les métriques sortantes : une seule nœud envoie toujours — le raidboss.
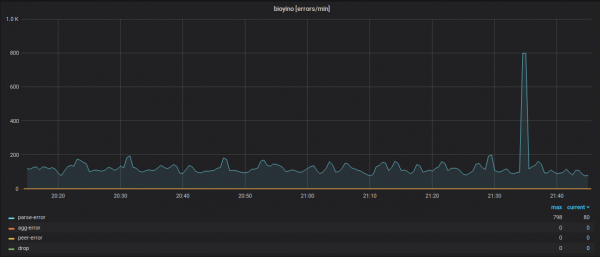
Statistiques de travail de chaque nœud en tenant compte des erreurs dans divers modules du système.
Détails des métriques entrantes (les noms des métriques sont masqués).
Que prévoyons-nous de faire ensuite avec tout cela ? Bien sûr, écrire du code, bl... ! Le projet a été initialement prévu comme open-source et le restera tout au long de sa vie. Dans nos projets à court terme, nous comptons passer à notre propre version de Raft, changer le protocole peer pour un plus portable, ajouter des statistiques internes supplémentaires, de nouveaux types de métriques, corriger des erreurs et d'autres améliorations.
Bien sûr, toutes les personnes désireuses d'aider au développement du projet sont les bienvenues : créez des PR, des Issues, et nous répondrons et travaillerons dessus si possible, etc.
Sur ce, comme on dit, c'est tout pour aujourd'hui, achetez nos éléphants !
Source : habr.com
