

Bonjour à tous ! Dans mon je parlais de l'organisation d'un système de surveillance modulaire pour une architecture microservices. Rien ne reste immobile, notre projet est en constante expansion, tout comme le nombre de métriques stockées. Comment nous avons organisé la transition de Graphite+Whisper à Graphite+ClickHouse dans des conditions de forte charge, nos attentes à cet égard et les résultats de la migration se lisent ci-dessous.
Avant de vous expliquer comment nous avons organisé la transition du stockage des métriques de Graphite+Whisper à Graphite+ClickHouse, je voudrais donner des informations sur les raisons qui ont conduit à une telle décision et sur les inconvénients de Whisper avec lesquels nous avons vécu pendant une longue période.
Problèmes avec Graphite+Whisper
1. Charge élevée sur le système de disque
Au moment de la transition, nous recevions environ 1,5 million de métriques par minute. Avec ce flux, l'utilisation des disques sur les serveurs était d'environ 30 %. Dans l'ensemble, c'était tout à fait acceptable — tout fonctionnait de manière stable, les écritures étaient rapides, les lectures aussi… Jusqu'à ce qu'une des équipes de développement ne déploie une nouvelle fonctionnalité et ne commence à nous envoyer 10 millions de métriques par minute. C'est à ce moment-là que le système de disque a commencé à s'engorger, et nous avons vu une utilisation à 100 %. Le problème a pu être résolu rapidement, mais la mauvaise expérience est restée.
2. Absence de réplication et de cohérence
Comme beaucoup de ceux qui utilisent/ont utilisé Graphite+Whisper, nous envoyions le même flux de métriques à plusieurs serveurs Graphite pour créer de la redondance. Cela ne posait pas de problèmes majeurs — jusqu'à ce qu'un des serveurs tombe pour une raison quelconque. Parfois, nous parvenions à redémarrer le serveur tombé assez rapidement, et carbon-c-relay pouvait lui envoyer les métriques de son cache, parfois non. Et à ce moment-là, il y avait un trou dans les métriques, que nous remplissions avec rsync. La procédure était assez longue. La seule chose qui nous sauvait, c'est que ces incidents étaient très rares. De plus, nous prenions périodiquement un ensemble aléatoire de métriques et les comparions avec d'autres similaires sur les nœuds voisins du cluster. Environ 5 % des cas révélaient des différences, ce qui ne nous réjouissait pas.
3. Grand volume d'espace occupé
Étant donné que nous écrivons dans Graphite non seulement des métriques d'infrastructure, mais aussi des métriques commerciales (et maintenant des métriques provenant de Kubernetes), nous nous trouvons souvent dans une situation où la métrique ne contient que quelques valeurs, et le fichier .wsp est créé en tenant compte de toute la période de rétention, occupant ainsi un espace prédéfini qui était d'environ 2 Mo. Le problème est aggravé par le fait que de tels fichiers apparaissent en grande quantité avec le temps, et lors de la génération de rapports basés sur eux, le temps et les ressources nécessaires pour lire les points vides sont considérables.
Il convient de noter dès le départ que les problèmes décrits ci-dessus peuvent être combattus par divers moyens et avec des degrés d'efficacité variés, mais plus vous recevez de données, plus ils s'aggravent.
Ayant tout ce qui précède (en tenant compte de précédents ), ainsi que la croissance constante du nombre de métriques reçues, le désir de réduire l'intervalle de conservation de toutes les métriques à 30 secondes (et si nécessaire, à 10 secondes), nous avons décidé d'essayer Graphite+ClickHouse comme alternative prometteuse à Whisper.
Graphite+ClickHouse. Attentes
Après avoir assisté à plusieurs meetups des gars de Yandex, lu , fouillé la documentation et trouvé des composants raisonnables pour intégrer ClickHouse à Graphite, nous avons décidé de passer à l'action !
Nous voulions obtenir ce qui suit :
- réduire l'utilisation du sous-système de disque de 30% à 5%;
- réduire l'espace occupé de 1 To à 100 Go;
- avoir la capacité d'accepter 100 millions de métriques par minute sur le serveur;
- réplication des données et tolérance aux pannes par défaut;
- ne pas passer une année sur ce projet et effectuer la transition dans un délai raisonnable;
- changer sans temps d'arrêt.
Assez ambitieux, n'est-ce pas ?
Graphite+ClickHouse. Composants
Pour recevoir des données via le protocole Graphite et les enregistrer par la suite dans ClickHouse, le choix s'est porté sur (golang).
Comme base de données pour le stockage des séries temporelles, la dernière version stable de ClickHouse à ce moment-là, la version 1.1.54253, a été choisie. Lors de son utilisation, des problèmes ont surgi : une multitude d'erreurs étaient générées dans les journaux, et il n'était pas tout à fait clair comment y faire face. Dans une discussion avec (auteur de carbon-clickhouse, graphite-clickhouse et bien d'autres), une version plus ancienne . Les erreurs ont disparu – tout a commencé à fonctionner à merveille.
Pour lire les données à partir de ClickHouse, nous avons choisi (golang). En tant qu'interface API pour Graphite – (golang). Pour organiser la réplication entre les tables ClickHouse, nous avons utilisé . Pour le routage des métriques, nous avons gardé notre cher (C) .
Graphite+ClickHouse. Structure des tables
«graphite» — une base de données que nous avons créée pour les tables de surveillance.
«graphite.metrics» — table avec le moteur ReplicatedReplacingMergeTree (répliqué ). Dans cette table, sont stockés les noms des métriques et les chemins vers celles-ci.
CREATE TABLE graphite.metrics ( Date Date, Level UInt32, Path String, Deleted UInt8, Version UInt32 ) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.metrics', 'r1', Date, (Level, Path), 8192, Version);«graphite.data» — table avec le moteur ReplicatedGraphiteMergeTree (répliqué ). Dans cette table, sont stockées les valeurs des métriques.
CREATE TABLE graphite.data ( Path String, Value Float64, Time UInt32, Date Date, Timestamp UInt32 ) ENGINE = ReplicatedGraphiteMergeTree('\/clickhouse\/tables\/replicator\/graphite.data', 'r1', Date, (Path, Time), 8192, 'graphite_rollup')«graphite.date_metrics» — table remplie selon condition, avec le moteur ReplicatedReplacingMergeTree. Dans cette table, sont enregistrés les noms de toutes les métriques rencontrées au cours de la journée. Les raisons de sa création sont décrites dans la section à la fin de cet article.
CREATE MATERIALIZED VIEW graphite.date_metrics ( Path String, Level UInt32, Date Date) ENGINE = ReplicatedReplacingMergeTree('\/clickhouse\/tables\/replicator\/graphite.date_metrics', 'r1', Date, (Level, Path, Date), 8192) AS SELECT toUInt32(length(splitByChar('.', Path))) AS Level, Date, Path FROM graphite.data«graphite.data_stat» — table remplie selon condition, avec le moteur ReplicatedAggregatingMergeTree (répliqué ). Dans cette table, est enregistré le nombre de métriques entrantes, avec une répartition jusqu'au 4e niveau de profondeur.
CREATE MATERIALIZED VIEW graphite.data_stat ( Date Date, Prefix String, Timestamp UInt32, Count AggregateFunction(count)) ENGINE = ReplicatedAggregatingMergeTree('\/clickhouse\/tables\/replicator\/graphite.data_stat', 'r1', Date, (Timestamp, Prefix), 8192) AS SELECT toStartOfMonth(now()) AS Date, replaceRegexpOne(Path, '^([^.]+.[^.]+.[^.]+).*$', '1') AS Prefix, toUInt32(toStartOfMinute(toDateTime(Timestamp))) AS Timestamp, countState() AS Count FROM graphite.data GROUP BY Timestamp, PrefixGraphite+ClickHouse. Schéma d'interaction des composants
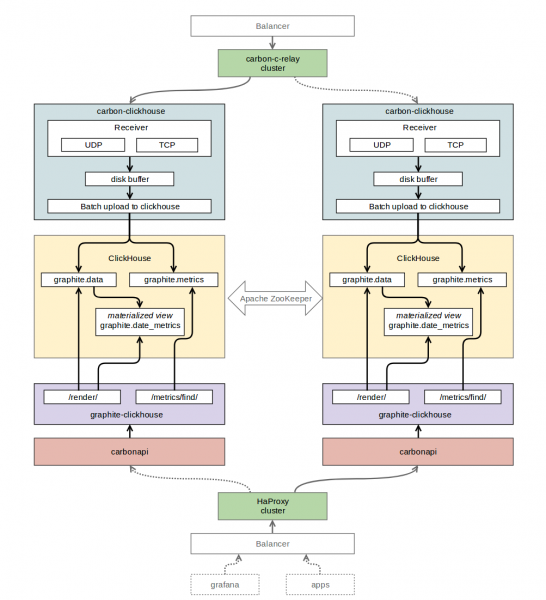
Graphite+ClickHouse. Migration des données
Comme nous nous en souvenons des attentes pour ce projet, la transition vers ClickHouse doit se faire sans temps d'arrêt, par conséquent, nous devions en quelque sorte basculer tout notre système de surveillance vers le nouveau stockage de manière aussi transparente que possible pour nos utilisateurs.
Nous l'avons fait de cette façon.
Dans carbon-c-relay, nous avons ajouté une règle pour envoyer un flux supplémentaire de métriques à carbon-clickhouse l'un des serveurs participant à la réplication des tables ClickHouse.
Nous avons écrit un petit script en Python qui, à l'aide de la bibliothèque whisper-dump, a lu tous les fichiers .wsp de notre stockage et a envoyé ces données au carbon-clickhouse décrit ci-dessus en 24 flux. Le nombre de valeurs métriques acceptées dans carbon-clickhouse atteignait 125 millions par minute, et ClickHouse n'a même pas transpiré.
Nous avons créé une source de données distincte dans Grafana pour déboguer les fonctions utilisées dans les tableaux de bord existants. Nous avons identifié une liste de fonctions que nous avons utilisées, mais qui n'étaient pas implémentées dans le carbonapi. Nous avons écrit ces fonctions et envoyé des PR aux auteurs de carbonapi (un grand merci à eux).
- Pour basculer la charge de lecture, nous avons modifié les points d'extrémité dans la configuration des équilibreurs de charge, passant de graphite-api (interface API pour Graphite+Whisper) à carbonapi.
Graphite+ClickHouse. Résultats
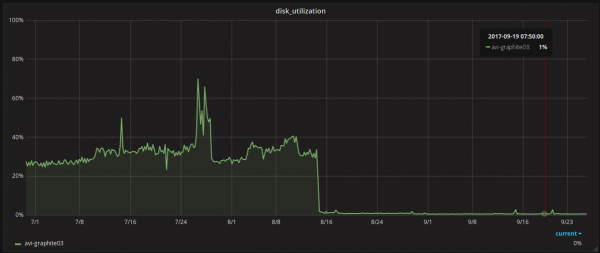
nous avons réduit l'utilisation du système de disque de 30% à 1%;

- nous avons réduit l'espace occupé de 1 To à 300 Go;
- nous avons la capacité d'accepter 125 millions de métriques par minute sur le serveur (pics lors de la migration);
- nous avons transféré toutes les métriques à un intervalle de stockage de 30 secondes;
- nous avons obtenu la réplication des données et la tolérance aux pannes;
- nous avons basculé sans temps d'arrêt;
- nous avons dépensé environ 7 semaines au total.
Graphite+ClickHouse. Problèmes
Dans notre cas, nous avons également rencontré des écueils. Voici ce à quoi nous avons été confrontés après la migration.
- ClickHouse ne relit pas toujours les configurations à la volée, il faut parfois le redémarrer. Par exemple, pour la description du cluster zookeeper dans la configuration de ClickHouse — elle n'était pas appliquée avant le redémarrage de clickhouse-server.
- Les grandes requêtes ClickHouse ne passaient donc pas, ce qui fait que notre connexion graphite-clickhouse à ClickHouse ressemble à ceci :
url = "http://localhost:8123/?max_query_size=268435456&max_ast_elements=1000000" - De nouvelles versions stables de ClickHouse sortent assez souvent, et elles peuvent apporter des surprises : restez vigilant.
- Les conteneurs créés dynamiquement dans Kubernetes envoient un grand nombre de métriques avec une durée de vie courte et aléatoire. Il n'y a pas beaucoup de points pour ces métriques, et il n'y a pas de problème d'espace. Toutefois, lors de la construction des requêtes, ClickHouse récupère un énorme volume de ces métriques de la table ‘metrics’. Dans 90 % des cas, les données pour celles-ci sont absentes sur la période (24 heures). La recherche de ces données dans la table ‘data’ prend néanmoins du temps et finit par atteindre un timeout. Pour résoudre ce problème, nous avons commencé à tenir une vue distincte avec des informations sur les métriques rencontrées au cours de la journée. Ainsi, lors de l'élaboration de rapports (graphes) sur les conteneurs créés dynamiquement, nous interrogeons uniquement les métriques qui ont été rencontrées dans la fenêtre spécifiée, et non pas pendant toute la durée, ce qui a accéléré considérablement la création des rapports à leur sujet. Pour la solution décrite ci-dessus, nous avons développé , incluant la mise en œuvre du travail avec la table date_metrics.
Graphite+ClickHouse. Tags
Depuis la version 1.1.0, Graphite a officiellement . Et nous réfléchissons activement à ce qu'il faut faire pour soutenir cette initiative dans la pile graphite+clickhouse.
Graphite+ClickHouse. Détecteur d'anomalies
Sur la base de l'infrastructure décrite ci-dessus, nous avons réalisé un prototype de détecteur d'anomalies, et il fonctionne ! Mais nous en parlerons dans le prochain article.
Abonnez-vous, cliquez sur la flèche vers le haut et soyez heureux !
Source : habr.com
