

Aujourd'hui, sur notre projet, en plus du code monolithique, des dizaines de microservices fonctionnent. Chacun d'eux nécessite une surveillance. Faire cela à cette échelle avec les ingénieurs DevOps est problématique. Nous avons développé un système de surveillance qui fonctionne comme un service pour les développeurs. Ils peuvent eux-mêmes écrire des métriques dans le système de surveillance, les utiliser, construire des tableaux de bord sur cette base, y ajouter des alertes qui se déclencheront lors de l'atteinte de valeurs seuil. Des ingénieurs DevOps, seuls l'infrastructure et la documentation sont nécessaires.
Ce post est la transcription de ma présentation lors de notre à RIT++. Beaucoup d'entre vous nous ont demandé de produire des versions écrites des exposés présentés là-bas. Si vous étiez à la conférence ou que vous avez regardé la vidéo, vous ne trouverez rien de nouveau. Pour tous les autres, bienvenue sous le cut. Je vais expliquer comment nous avons créé un tel système, comment il fonctionne et comment nous prévoyons de le mettre à jour.
Le passé : schémas et plans
Comment sommes-nous arrivés au système de surveillance actuel ? Pour répondre à cette question, il faut remonter à 2015. Voici à quoi cela ressemblait à l'époque :
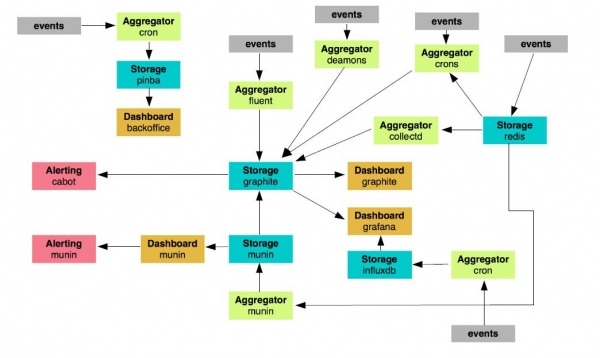
Nous avions environ 24 nœuds responsables de la surveillance. Ici, il y avait toute une série de cron, de scripts et de démons qui surveillaient quelque chose quelque part d'une manière ou d'une autre, envoyaient des messages et exécutaient des fonctions. Nous avons pensé qu'à mesure que le temps passait, un tel système deviendrait de moins en moins viable. Il n'était pas sensé de continuer à le développer : il était trop encombrant.
Nous avons décidé de sélectionner les éléments de surveillance que nous allions conserver et développer, et ceux dont nous nous débarrasserions. Au final, il y en avait 19. Seuls des graphite, des agrégateurs et Grafana comme tableau de bord ont été retenus. Mais à quoi ressemblera le nouveau système ? Voici ce que cela donnera :
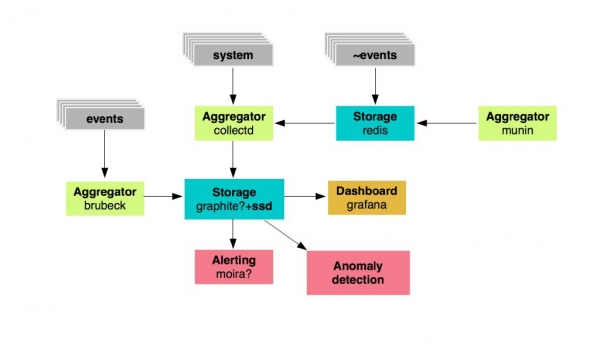
Nous avons un stockage de métriques : ce sont des graphite qui seront basés sur des disques SSD rapides, ainsi que des agrégateurs spécifiques pour les métriques. Ensuite, Grafana pour l'affichage des tableaux de bord et Moira pour les alertes. Nous souhaitions également développer un système de recherche d'anomalies.
Standard : Surveillance 2.0
Voici à quoi ressemblaient les projets en 2015. Mais nous devions préparer non seulement l'infrastructure et le service lui-même, mais aussi la documentation qui l'accompagne. Nous avons élaboré un standard d'entreprise que nous avons appelé surveillance 2.0. Quelles étaient les exigences du système ?
- disponibilité permanente ;
- intervalle de stockage des métriques = 10 secondes ;
- stockage structuré des métriques et des tableaux de bord;
- SLA > 99,99%
- collecte de métriques d'événements via UDP (!).
Nous avions besoin de UDP car nous avons un grand flux de trafic et d'événements qui génèrent des métriques. Si nous écrivons toutes les métriques directement dans Graphite, le stockage va tomber. Nous avons également choisi des préfixes de premier niveau pour toutes les métriques.
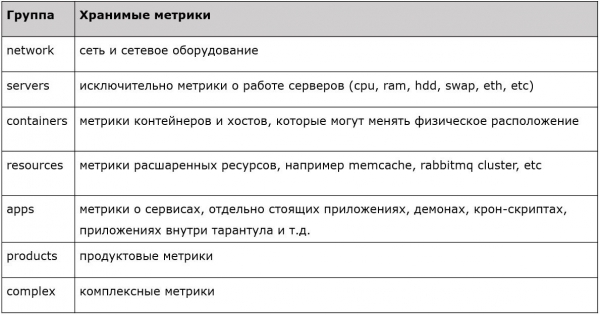
Chacun des préfixes possède une certaine propriété. Il existe des métriques pour les serveurs, les réseaux, les conteneurs, les ressources, les applications, etc. Une filtration claire, stricte et typée a été mise en place, où nous acceptons les métriques de premier niveau et les autres sont simplement ignorées. Voici comment nous avions planifié ce système en 2015. Qu'en est-il maintenant?
Présent : schéma d'interaction des composants de surveillance
Tout d'abord, nous surveillons les applications : notre code PHP, les applications et les microservices - en bref, tout ce que nos développeurs écrivent. Toutes les applications envoient des métriques à l'agrégateur Brubeck (statsd, réécrit en C) via UDP. Ce dernier s'est avéré être le plus rapide selon les résultats des tests synthétiques. Il envoie les métriques déjà agrégées vers Graphite via TCP.
Il a un type de métriques appelé minuteries. C'est un outil très pratique. Par exemple, pour chaque connexion d'utilisateur au service, vous envoyez à Brubeck une métrique avec le temps de réponse. Un million de réponses sont arrivées, et l'agrégateur a fourni seulement 10 métriques. Vous avez le nombre de personnes arrivées, le temps de réponse maximum, minimum et moyen, la médiane et 4 percentiles. Ensuite, les données sont transférées dans Graphite et nous les voyons toutes en temps réel.
Nous avons également une agrégation pour les métriques liées au matériel, au logiciel, aux métriques système et notre ancien système de surveillance Munin (qui a fonctionné chez nous jusqu'en 2015). Nous collectons tout cela via le démon CollectD en C (qui intègre une série de plugins variés, capable d'interroger toutes les ressources du système hôte sur lequel il est installé, il suffit de spécifier dans la configuration où écrire les données) et nous écrivons les données dans Graphite via celui-ci. Il prend également en charge les plugins Python et les scripts shell, vous pouvez donc écrire vos propres solutions personnalisées : CollectD collectera ces données depuis un hôte local ou distant (par exemple, avec Curl) et les expédiera vers Graphite.
Ensuite, toutes les métriques que nous avons collectées sont envoyées à Carbon-c-relay. C'est une solution de Carbon Relay basée sur Graphite, améliorée en C. C'est un routeur qui reçoit toutes les métriques que nous envoyons depuis nos agrégateurs et les achemine vers les nœuds. De plus, au stade du routage, il vérifie la validité des métriques. Elles doivent, d'une part, correspondre au schéma de préfixes que j'ai montré précédemment et, d'autre part, être valides pour Graphite. Sinon, elles sont supprimées.
Ensuite, Carbon-c-relay envoie les métriques au cluster Graphite. Nous utilisons Carbon-cache, réécrit en Go, comme principal stockage des métriques. Go-carbon, en raison de sa capacité à gérer plusieurs threads, surpasse largement Carbon-cache en performances. Il reçoit les données et les écrit sur les disques à l'aide du paquet whisper (standard, écrit en python). Pour lire les données de nos stockages, nous utilisons l'API Graphite. Elle fonctionne beaucoup plus rapidement que le standard Graphite WEB. Que se passe-t-il ensuite avec les données?
Elles vont dans Grafana. Comme source principale de données, nous utilisons nos clusters Graphite, et nous avons également Grafana comme interface web pour afficher les métriques et construire des tableaux de bord. Chaque service développe son propre tableau de bord. Ensuite, ils construisent des graphiques basés sur les métriques qu'ils envoient depuis leurs applications. En plus de Grafana, nous avons également SLAM. C'est un démon Python qui calcule le SLA sur la base des données provenant de Graphite. Comme je l'ai déjà mentionné, nous avons plusieurs dizaines de microservices, chacun ayant ses propres exigences. Avec SLAM, nous consultons la documentation et la comparons à ce qui est disponible dans Graphite pour vérifier à quel point les exigences correspondent à la disponibilité de nos services.
Poursuivons : l'alerte. Elle est organisée à l'aide d'un système robuste : Moira. Elle est indépendante car elle dispose de son propre Graphite en arrière-plan. Développée par les gars de la SKB « Kontur », écrite en python et en Go, entièrement open-source. Moira reçoit le même flux que celui qui est envoyé à Graphite. Si pour une raison quelconque votre stockage tombe en panne, votre système d'alerte continuera à fonctionner.
Nous avons déployé Moira dans Kubernetes, utilisant un cluster de serveurs Redis comme base de données principale. Au final, cela a créé un système résilient. Il compare le flux des métriques avec une liste de déclencheurs : si elle n'y trouve aucune mention, alors elle ignore la métrique. Elle est capable de traiter des gigaoctets de métriques par minute.
Nous y avons également intégré un LDAP d'entreprise, qui permet à chaque utilisateur du système de créer des notifications basées sur des déclencheurs existants (ou nouvellement créés). Puisque Moira contient Graphite, elle prend en charge toutes ses fonctionnalités. Vous copiez d'abord une ligne dans Grafana pour voir comment les données s'affichent sur les graphiques. Ensuite, vous copiez cette même ligne dans Moira, que vous paramétrez avec des limites pour obtenir des alertes. Pour cela, aucune connaissance spécifique n'est nécessaire. Moira peut envoyer des alertes par SMS, email, dans Jira, Slack… Elle prend aussi en charge l'exécution de scripts personnalisés. Lorsqu'un déclencheur se produit et qu'elle est liée à un script ou un binaire, elle l'exécute et transmet un JSON à ce binaire via stdin. Votre programme doit alors le parser. Que vous fassiez avec ce JSON — c'est à vous de décider. Vous pouvez l'envoyer sur Telegram, ouvrir des tâches dans Jira, ou faire ce que vous voulez.
Pour les alertes, nous utilisons également notre propre développement — Imagotag. Nous avons adapté un panneau généralement utilisé pour les étiquettes de prix électroniques au magasin à nos besoins. Nous y avons intégré les déclencheurs de Moira, indiquant leur état et le moment où ils se sont produites. Certaines personnes de l'équipe de développement ont abandonné les notifications dans Slack et par email au profit de ce panneau.
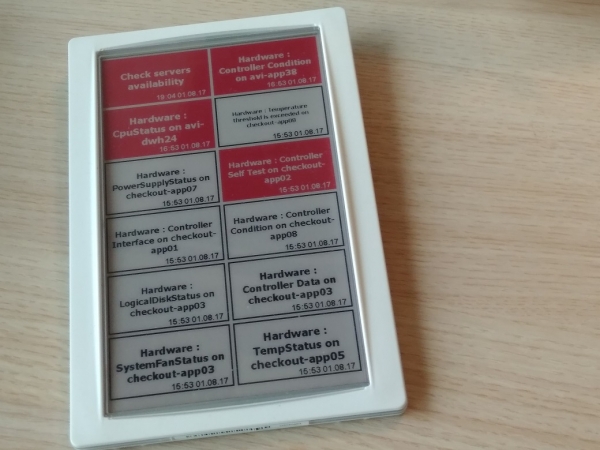
Comme nous sommes une entreprise progressive, nous avons également surveillé Kubernetes dans ce système. Nous l'avons intégré grâce à Heapster, installé dans le cluster, qui collecte des données et les envoie à Graphite. Ainsi, le schéma se présente comme suit :
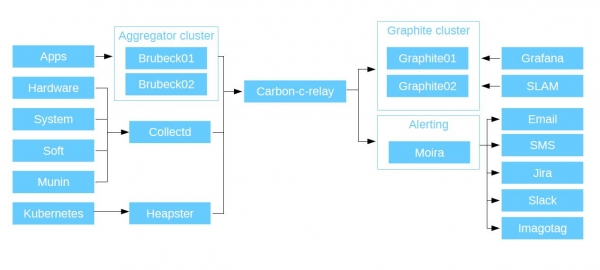
Composants de surveillance
Voici une liste de liens vers les composants que nous avons utilisés pour cette tâche. Tous sont open source.
Graphite :
- go-carbon :
- whisper :
- graphite-api :
Carbon-c-relay :
Brubeck :
Collectd :
Moira :
Grafana :
Heapster :
Statistiques
Voici quelques chiffres sur le fonctionnement de notre système.
Agrégateur (brubeck)
Nombre de métriques : ~ 300 000 / sec
Intervalle d'envoi des métriques à Graphite : 30 sec
Utilisation des ressources serveur : ~ 6% CPU (pour des serveurs complets) ; ~ 1Go RAM ; ~ 3 Mbps LAN
Graphite (go-carbon)
Nombre de métriques : ~ 1 600 000 / min
Intervalle de mise à jour des métriques : 30 sec
Schéma de stockage des métriques : 30sec 35j, 5min 90j, 10min 365j (permet de comprendre ce qui se passe avec le service sur une longue période)
Utilisation des ressources serveur : ~ 10% CPU ; ~ 20Go RAM ; ~ 30 Mbps LAN
Flexibilité
Chez Avito, nous attachons une grande importance à la flexibilité de notre service de surveillance. Pourquoi est-il ainsi conçu ? Premièrement, ses composants sont interchangeables : tant les composants eux-mêmes que leurs versions. Deuxièmement, la maintenabilité. Étant donné que tout le projet est basé sur l'open source, vous pouvez modifier le code, apporter des modifications et implémenter des fonctionnalités qui ne sont pas disponibles en standard. Des piles assez courantes sont utilisées, principalement Go et Python, ce qui rend cela relativement simple.
Voici un exemple d'un problème réel. Une métrique dans Graphite est un fichier. Il a un nom. Le nom du fichier = le nom de la métrique. Et il a un chemin d'accès. Les noms de fichiers sous Linux sont limités à 255 caractères. Et nous avons (en tant que 'commanditaires internes') des gars du département des bases de données. Ils nous disent : 'Nous voulons surveiller nos requêtes SQL. Or, elles ne font pas 255 caractères, mais 8 Mo chacune. Nous voulons les afficher dans Grafana, voir les paramètres de cette requête, et encore mieux, nous voulons voir le top de ces requêtes. Ce serait génial si cela pouvait être affiché en temps réel. Et ce serait encore mieux de les intégrer dans des alertes.'
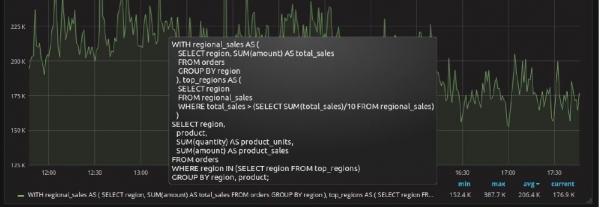
L'exemple de requête SQL est pris à titre d'exemple sur
Nous mettons en place un serveur Redis et nos plugins Collectd, qui se connectent à Postgres pour extraire toutes les données, envoyant les métriques à Graphite. Nous remplaçons le nom de la métrique par des hachages. Ce même hachage est simultanément envoyé à Redis comme clé, et toute la requête SQL comme valeur. Nous devons maintenant faire en sorte que Grafana puisse interroger Redis et récupérer ces informations. Nous ouvrons l'API de Graphite, car c'est l'interface principale permettant à tous les composants de surveillance d'interagir avec Graphite, et nous écrivons une nouvelle fonction appelée aliasByHash() — nous recevons le nom de la métrique de Grafana et l'utilisons dans la requête à Redis comme clé, obtenant en retour la valeur de la clé, qui est notre “requête SQL”. Ainsi, nous avons rendu possible l'affichage dans Grafana de la requête SQL, qui autrement ne pouvait pas être affichée, accompagnée des statistiques associées (appels, lignes, temps_total, …).
Résultats
Disponibilité. Notre service de surveillance est disponible 24/7 depuis n'importe quelle application et n'importe quel code. Si vous avez accès aux stockages, vous pouvez envoyer des données au service. Le langage n'est pas important, les solutions ne comptent pas. Vous devez juste savoir comment ouvrir un socket, y envoyer la métrique et fermer le socket.
La fiabilité. Tous les composants sont tolérants aux pannes et gèrent bien nos charges.
Faible barrière d'entrée. Pour utiliser ce système, vous n'avez pas besoin d'apprendre des langages de programmation ou des requêtes dans Grafana. Il vous suffit d'ouvrir votre application, d'y insérer un socket qui enverra des métriques à Graphite, de le fermer, d'ouvrir Grafana, de créer des tableaux de bord et d'observer le comportement de vos métriques, en recevant des notifications via Moira.
Autonomie. Tout cela peut être fait soi-même, sans l'aide d'ingénieurs DevOps. Et c'est un surcoût, car vous pouvez surveiller votre projet dès maintenant, sans demander l'aide de personne, ni pour commencer ni pour faire des modifications.
Quels sont nos objectifs ?
Tout ce qui est mentionné ci-dessous n'est pas seulement des pensées abstraites, mais des domaines vers lesquels des premières étapes ont déjà été faites.
- Détecteur d'anomalies. Nous souhaitons développer un service qui interrogera nos stockages Graphite et vérifiera chaque métrique selon divers algorithmes. Il existe déjà des algorithmes que nous souhaitons examiner, des données sont disponibles, nous savons les manipuler.
- Métadonnées. Nous avons de nombreux services qui évoluent avec le temps, tout comme les personnes qui y travaillent. Maintenir la documentation manuellement n'est pas une option. C'est pourquoi nous intégrons actuellement des métadonnées dans nos microservices. Elles indiquent qui les a développées, les langages avec lesquels elles interagissent, les exigences SLA, ainsi que l'adresse et le destinataire des notifications. Lors du déploiement du service, toutes les données de l'entité sont créées automatiquement. Au final, vous obtenez deux liens : l'un pour les déclencheurs, l'autre pour les tableaux de bord dans Grafana.
- Surveillance à domicile. Nous pensons qu'un tel système doit être utilisé par tous les développeurs. Dans ce cas, vous comprenez toujours où se trouve votre trafic, ce qui lui arrive, où il chute et quels sont ses points faibles. Si, par exemple, quelque chose venait à perturber votre service, vous n'en serez pas informé lors d'un appel du manager, mais par une alerte, et vous pourrez immédiatement ouvrir les logs récents pour voir ce qui s'est passé.
- Haute performance. Notre projet ne cesse de croître, et aujourd'hui, il traite environ 2 000 000 de valeurs de métriques par minute. Il y a un an, ce chiffre était de 500 000. La croissance se poursuit, et cela signifie qu'à un moment donné, Graphite (whisper) commencera à lourdement solliciter le sous-système de stockage. Comme je l'ai déjà mentionné, ce système de surveillance est assez polyvalent grâce à l'interchangeabilité des composants. Certains entretiennent et étendent leur infrastructure spécialement pour Graphite, mais nous avons décidé d'adopter une autre approche : utiliser comme stockage de nos métriques. Cette transition est pratiquement terminée et je vous expliquerai bientôt plus en détail comment cela a été réalisé : les difficultés rencontrées et comment elles ont été surmontées, le processus de migration, et je décrirai les composants choisis comme enveloppe ainsi que leurs configurations.
Merci de votre attention ! Posez vos questions sur le sujet, je ferai de mon mieux pour y répondre ici ou dans les prochains articles. Peut-être que quelqu'un a de l'expérience dans la construction d'un tel système de surveillance ou la migration vers Clickhouse dans des situations similaires – partagez-le dans les commentaires.
Source : habr.com
