

Je suis tombé sur un article intéressant sur l'intelligence artificielle dans les jeux. Il explique les concepts de base sur l'IA à travers des exemples simples, et contient également de nombreux outils et méthodes utiles pour son développement et sa conception. Il y a des conseils sur comment, où et quand les utiliser.
La plupart des exemples sont écrits en pseudocode, donc des connaissances approfondies en programmation ne seront pas nécessaires. Il y a 35 pages de texte avec des images et des GIF, alors préparez-vous.
UPD. Je m'excuse, mais j'ai déjà fait ma propre traduction de cet article sur Habr. . Vous pouvez lire ma version , mais il semble que cet article m'ait échappé (j'ai utilisé la recherche, mais quelque chose a mal tourné). Comme j'écris dans un blog dédié au développement de jeux, j'ai décidé de laisser ma version de la traduction pour mes abonnés (certains points sont présentés différemment, d'autres sont intentionnellement omis sur les conseils des développeurs).
Qu'est-ce que l'IA ?
L'IA de jeu se concentre sur les actions qu'un objet doit effectuer en fonction des conditions dans lesquelles il se trouve. Cela s'appelle généralement la gestion des « agents intelligents », où l'agent peut être un personnage de jeu, un véhicule, un bot, et parfois quelque chose de plus abstrait : un groupe entier d'entités ou même une civilisation. Dans chaque cas, c'est un élément qui doit percevoir son environnement, prendre des décisions basées sur cela et agir en conséquence. Cela s'appelle le cycle Sense/Think/Act (Percevoir/Penser/Agir) :
- Sense : l'agent trouve ou reçoit des informations sur des éléments dans son environnement qui peuvent influencer son comportement (menaces à proximité, objets à collecter, lieux intéressants à explorer).
- Think : l'agent décide comment réagir (il évalue s'il est suffisamment en sécurité pour collecter des objets ou s'il doit d'abord se battre/se cacher).
- Act : l'agent effectue des actions pour mettre en œuvre la décision précédente (il commence à se déplacer vers l'ennemi ou l'objet).
- …la situation a maintenant changé en raison des actions des personnages, donc le cycle se répète avec de nouvelles données.
L'IA se concentre généralement sur la partie Sense du cycle. Par exemple, les voitures autonomes prennent des images de la route, les combinent avec des données radar et lidar, et les interprètent. Cela est généralement fait par l'apprentissage automatique, qui traite les données entrantes et leur donne un sens, en extrayant des informations sémantiques comme « il y a une autre voiture à 20 mètres devant vous ». Ce sont ce qu'on appelle des problèmes de classification.
Les jeux n'ont pas besoin d'un système complexe pour extraire des informations, car la plupart des données en font déjà partie intégrante. Il n'est pas nécessaire d'exécuter des algorithmes de reconnaissance d'image pour déterminer s'il y a un ennemi devant — le jeu le sait déjà et transmet les informations directement pendant le processus de prise de décision. Par conséquent, la partie Sense du cycle est souvent beaucoup plus simple que Think et Act.
Les limitations de l'IA dans les jeux vidéo
L'IA doit respecter un certain nombre de limitations :
- L'IA n'a pas besoin d'être préalablement entraînée, comme un algorithme d'apprentissage automatique. Il est inutile d'écrire un réseau neuronal pendant le développement pour observer des dizaines de milliers de joueurs et apprendre la meilleure façon de jouer contre eux. Pourquoi ? Parce que le jeu n'est pas encore sorti et qu'il n'y a pas de joueurs.
- Le jeu doit divertir et représenter un défi, donc les agents ne doivent pas trouver la meilleure approche contre les humains.
- Les agents doivent avoir l'air réalistes pour que les joueurs aient l'impression de jouer contre de vraies personnes. Le programme AlphaGo a dépassé l'humain, mais les mouvements choisis étaient très éloignés de la compréhension traditionnelle du jeu. Si le jeu imite un adversaire humain, cette impression ne doit pas exister. L'algorithme doit être modifié pour qu'il prenne des décisions plausibles, et non parfaites.
- L'IA doit fonctionner en temps réel. Cela signifie que l'algorithme ne peut pas monopoliser l'utilisation du processeur pendant trop longtemps pour prendre des décisions. Même 10 millisecondes pour cela — c'est trop long, car la plupart des jeux se contentent de 16 à 33 millisecondes pour effectuer tout le traitement et passer au cadre graphique suivant.
- Idéalement, au moins une partie du système doit être gérée par des données, afin que les « non-codeurs » puissent apporter des modifications et que les ajustements se fassent plus rapidement.
Examinons les approches de l'IA qui couvrent l'ensemble du cycle Sense/Think/Act.
Prise de décisions de base
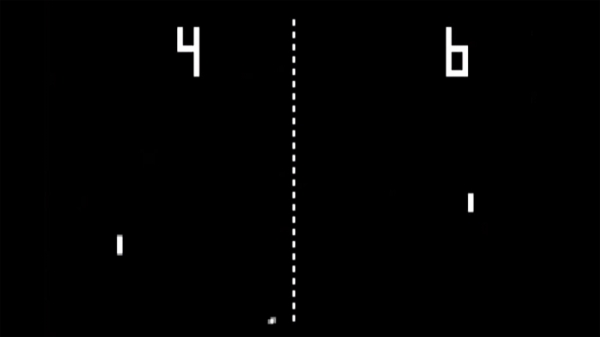
Commençons par le jeu le plus simple — Pong. Objectif : déplacer la plateforme (paddle) pour que la balle rebondisse dessus, au lieu de passer à côté. C'est comme le tennis, où vous perdez si vous ne renvoyez pas la balle. Ici, l'IA a une tâche relativement facile — décider dans quelle direction déplacer la plateforme.
Opérateurs conditionnels
Pour l'IA dans Pong, la solution la plus évidente est de toujours tenter de positionner la plateforme sous la balle.
Voici un algorithme simple pour cela, écrit en pseudo-code :
chaque trame/mise à jour pendant que le jeu est en cours :
si la balle est à gauche de la plateforme :
déplacer la plateforme à gauche
sinon si la balle est à droite de la plateforme :
déplacer la plateforme à droite
Si la plateforme se déplace à la vitesse de la balle, c'est l'algorithme idéal pour l'IA dans Pong. Il n'est pas nécessaire de compliquer les choses si les données et les actions possibles pour l'agent ne sont pas si nombreuses.
Cette approche est si simple que tout le cycle Sense/Think/Act est à peine perceptible. Mais il est présent :
- La partie Sense se trouve dans les deux opérateurs if. Le jeu sait où est la balle et où est la plateforme, donc l'IA s'y réfère pour obtenir ces informations.
- La partie Think entre également dans les deux opérateurs if. Ils incarnent deux solutions qui, dans ce cas, sont mutuellement exclusives. En conséquence, une des trois actions est choisie — déplacer la plateforme à gauche, déplacer à droite, ou ne rien faire si elle est déjà positionnée correctement.
- La partie Act se trouve dans les opérateurs Move Paddle Left et Move Paddle Right. En fonction du design du jeu, ils peuvent déplacer la plateforme instantanément ou à une certaine vitesse.
Ces approches sont appelées réactives — il y a un ensemble simple de règles (dans ce cas, des opérateurs if dans le code) qui réagissent à l'état actuel du monde et agissent.
Arbre de décision
L'exemple du jeu Pong équivaut en fait à une conception formelle de l'IA, qui est appelée arbre de décision. L'algorithme le parcourt pour atteindre une « feuille » — une décision sur quelle action entreprendre.
Créons un diagramme de l'arbre de décision pour l'algorithme de notre plateforme :
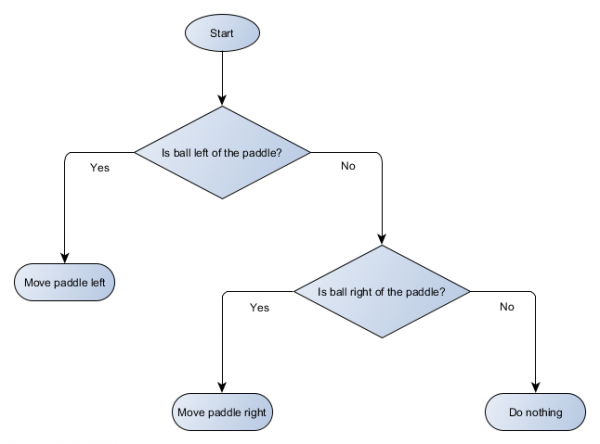
Chaque partie de l'arbre s'appelle un node (nœud) — l'IA utilise la théorie des graphes pour décrire de telles structures. Il existe deux types de nœuds :
- Nœuds de décision : choix entre deux alternatives basé sur la vérification d'une certaine condition, où chaque alternative est représentée sous forme de nœud distinct.
- Nœuds finaux : action à exécuter, représentant la décision finale.
L'algorithme commence par le premier nœud (« racine » de l'arbre). Il prend soit la décision de passer à un nœud enfant, soit exécute une action stockée dans le nœud et se termine.
Quel est l'avantage, si les arbres de décision font le même travail que les opérateurs if dans la section précédente ? Il existe ici un système général où chaque décision a une seule condition et deux résultats possibles. Cela permet au développeur de créer une IA à partir de données représentant des décisions dans l'arbre, évitant ainsi son hardcoding. Représentons cela sous forme de tableau :
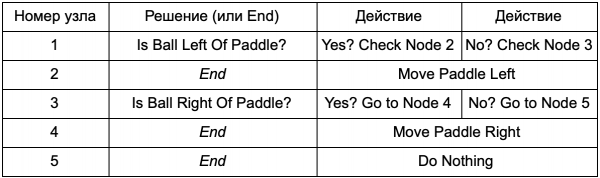
Du côté du code, vous obtiendrez un système pour lire des lignes. Créez un nœud pour chacune d'elles, connectez la logique de prise de décision basée sur la deuxième colonne et des nœuds enfants basés sur les troisième et quatrième colonnes. Vous devez encore programmer les conditions et les actions, mais maintenant la structure du jeu sera plus complexe. Vous ajouterez des décisions et des actions supplémentaires, puis configurerez toute l'IA simplement en modifiant un fichier texte définissant l'arbre. Vous transmettrez ensuite le fichier au concepteur de jeux, qui pourra modifier le comportement sans recompilation du jeu ni modification du code.
Les arbres de décision sont très utiles lorsqu'ils sont construits automatiquement sur la base d'un grand ensemble d'exemples (par exemple, en utilisant l'algorithme ID3). Cela en fait un outil efficace et performant pour classifier des situations sur la base des données obtenues. Cependant, nous dépassons le simple système de choix d'actions par les agents.
Scénarios
Nous avons examiné le système d'arbre de décision qui utilisait des conditions et des actions prédéfinies. La personne qui conçoit l'IA peut organiser l'arbre comme elle le souhaite, mais elle doit encore compter sur le codeur qui l’a programmée. Que se passerait-il si nous pouvions donner au designer des outils pour créer ses propres conditions ou actions ?
Pour qu'un programmeur n'ait pas à écrire de code pour les conditions Is Ball Left Of Paddle et Is Ball Right Of Paddle, il peut créer un système dans lequel le designer enregistrera les conditions pour vérifier ces valeurs. Les données de l'arbre de décision ressembleront alors à ceci :
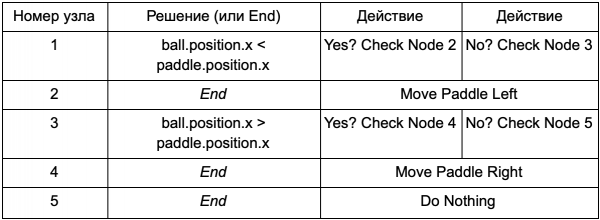
En réalité, c'est la même chose que dans le premier tableau, mais les solutions elles-mêmes ont leur propre code qui ressemble un peu à la partie conditionnelle d'un opérateur if. Dans le code, cela serait identifié dans la deuxième colonne pour les nœuds de prise de décision, mais au lieu de rechercher une condition spécifique à exécuter (Is Ball Left Of Paddle), il évalue l'expression conditionnelle et renvoie true ou false en conséquence. Cela est réalisé avec des langages de script comme Lua ou Angelscript. Avec eux, le développeur peut prendre des objets dans son jeu (ball et paddle) et créer des variables qui seront disponibles dans le scénario (ball.position). En outre, le langage de script est plus simple que le C++. Il ne nécessite pas une étape de compilation complète, ce qui le rend idéal pour un ajustement rapide de la logique de jeu et permet aux « non-programmeurs » de créer eux-mêmes les fonctions nécessaires.
Dans l'exemple ci-dessus, le langage de script est utilisé uniquement pour évaluer une expression conditionnelle, mais il peut également être utilisé pour des actions. Par exemple, Move Paddle Right peut devenir un opérateur de script (ball.position.x += 10). Ainsi, l'action peut également être déterminée dans le script, sans avoir besoin de programmer Move Paddle Right.
On peut aller encore plus loin et écrire complètement un arbre de décision dans un langage de script. Cela serait du code sous forme d'opérateurs conditionnels hardcodés, mais ils seraient dans des fichiers de script externes, ce qui signifie qu'ils peuvent être modifiés sans recompiler l'ensemble du programme. Souvent, il est possible de changer le fichier de script pendant que le jeu est en cours, pour tester rapidement différentes réactions de l'IA.
Réagir aux événements
Les exemples ci-dessus conviennent parfaitement à Pong. Ils exécutent en continu un cycle Sense/Think/Act et agissent en fonction du dernier état du monde. Mais dans des jeux plus complexes, il faut réagir à des événements particuliers, et non évaluer tout en même temps. Pong n'est donc plus un bon exemple. Choisissons un autre.
Imaginez un shooter où les ennemis sont immobiles jusqu'à ce qu'ils détectent le joueur, après quoi ils agissent en fonction de leur « spécialisation » : certains vont foncer, tandis que d'autres attaqueront à distance. C'est toujours un système réactif de base — « si le joueur est vu, alors fais quelque chose » — mais il peut être logiquement divisé en un événement Player Seen (joueur vu) et une réaction (choisissez une réponse et exécutez-la).
Cela nous ramène au cycle Sense/Think/Act. Nous pouvons coder la partie Sense, qui vérifiera à chaque image si l'IA voit le joueur. S'il ne le voit pas, rien ne se passe, mais s'il le voit, un événement Player Seen est créé. Le code aura une section distincte qui indiquera : « lorsque l'événement Player Seen se produit, fais », où est la réponse dont vous avez besoin pour appeler les parties Think et Act. Ainsi, vous configurerez les réactions à l'événement Player Seen : pour un personnage « rushant » — ChargeAndAttack, et pour un tireur d'élite — HideAndSnipe. Ces liaisons peuvent être créées dans un fichier de données pour une édition rapide, sans avoir à recompilation. Et ici aussi, nous pouvons utiliser un langage de script.
Prendre des décisions complexes
Bien que les systèmes de réaction simples soient très efficaces, il existe de nombreuses situations où ils ne suffisent pas. Parfois, il est nécessaire de prendre différentes décisions en fonction de ce que fait l'agent à ce moment précis, mais représenter cela en tant que condition est difficile. Il existe parfois trop de conditions pour les représenter efficacement dans un arbre de décision ou un script. Parfois, il est nécessaire d'évaluer à l'avance comment la situation va évoluer avant de prendre une décision sur la prochaine étape. Pour résoudre ces problèmes, des approches plus complexes sont nécessaires.
Machine à états finis
Une machine à états finis ou FSM (finite state machine) est un moyen de dire que notre agent se trouve actuellement dans l'un de plusieurs états possibles et qu'il peut passer d'un état à un autre. Ces états sont au nombre déterminé — d'où le nom. Le meilleur exemple de la vie quotidienne est le feu de circulation. Dans différents endroits, il y a différentes séquences de lumières, mais le principe est le même — chaque état représente quelque chose (arrêtez, allez, etc.). Un feu de circulation est toujours dans un seul état à tout moment et passe d'un état à un autre sur la base de règles simples.
Avec les NPC dans les jeux, c'est une histoire similaire. Prenons par exemple un garde avec les états suivants :
- Patrouillant (Patrolling).
- Attaquant (Attacking).
- Fuyant (Fleeing).
Et avec ces conditions pour changer son état :
- Si le garde voit un ennemi, il attaque.
- Si le garde attaque, mais ne voit plus l'ennemi, il revient à sa patrouille.
- Si le garde attaque, mais est gravement blessé, il s'enfuit.
Vous pouvez également écrire des opérateurs if avec une variable d'état pour la sentinelle et diverses vérifications : y a-t-il un ennemi à proximité, quel est le niveau de santé du PNJ, etc. Ajoutons encore quelques états.
- Inactivité (Idling) — entre les patrouilles.
- Recherche (Searching) — lorsque l'ennemi aperçu s'est caché.
- Demander de l'aide (Finding Help) — lorsqu'un ennemi est aperçu mais trop fort pour être combattu seul.
Les choix pour chacun d'eux sont limités — par exemple, la sentinelle n'ira pas chercher un ennemi caché si sa santé est basse.
En fin de compte, une longue liste « si <x и y, но не z>, alors <p>» peut devenir trop encombrante. Il est donc nécessaire de formaliser une méthode qui nous permette de garder à l'esprit les états et les transitions entre ces états. Pour ce faire, prenons en compte tous les états et, sous chaque état, notons dans une liste toutes les transitions vers d'autres états, ainsi que les conditions nécessaires pour celles-ci.
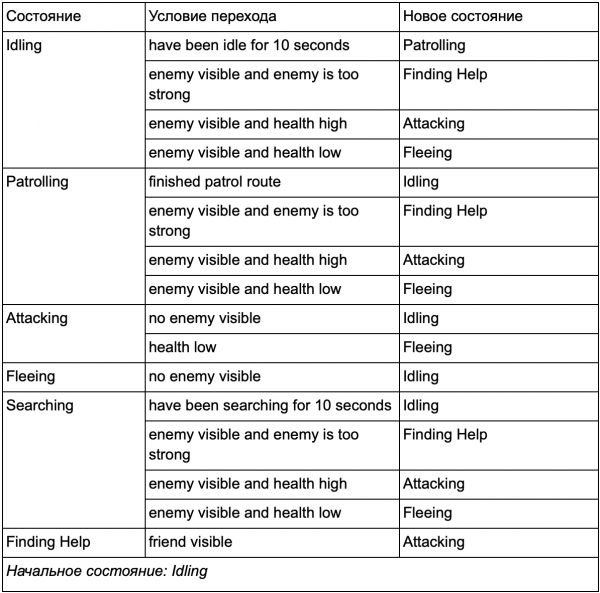
Voici un tableau des transitions d'états — une manière complexe de représenter un FSM. Dessinons un diagramme pour obtenir un aperçu complet de l'évolution du comportement des PNJ.
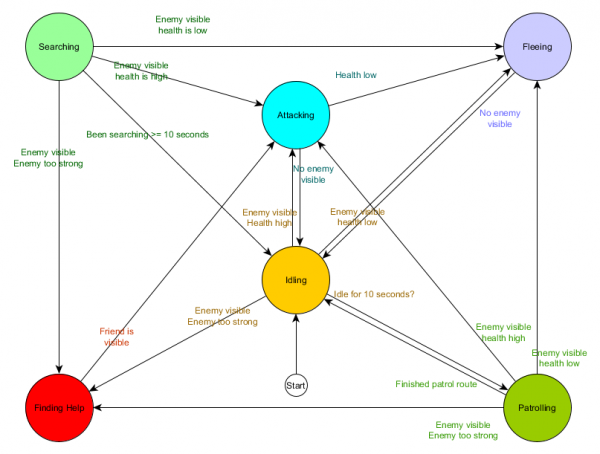
Le diagramme reflète l'essence de la prise de décision pour cet agent en fonction de la situation actuelle. Chaque flèche montre la transition entre les états, si la condition à côté d'elle est vraie.
À chaque mise à jour, nous vérifions l'état actuel de l'agent, consultons la liste des transitions, et si les conditions pour une transition sont remplies, il adopte un nouvel état. Par exemple, à chaque image, nous vérifions si le chronomètre de 10 secondes a expiré, et si oui, alors de l'état Idling, la sentinelle passe à l'état Patrolling. De la même manière, l'état Attacking vérifie la santé de l'agent — si elle est basse, il passe à l'état Fleeing.
C'est le traitement des transitions entre les états, mais qu'en est-il du comportement associé aux états eux-mêmes ? Pour la mise en œuvre du comportement réel pour un état particulier, il existe généralement deux types de « crochets » où nous assignons des actions au FSM :
- Des actions que nous effectuons périodiquement pour l'état actuel.
- Des actions que nous entreprenons lors d'une transition d'un état à un autre.
Exemples pour le premier type. L'état Patrolling déplacera l'agent le long de la route de patrouille à chaque image. L'état Attacking essaiera de commencer une attaque ou de passer à un état lorsque cela est possible à chaque image.
Pour le deuxième type, considérons le passage « si l'ennemi est visible et que l'ennemi est trop puissant, alors passer à l'état Finding Help. L'agent doit choisir où demander de l'aide et conserver cette information afin que l'état Finding Help sache où s'adresser. Une fois l'aide trouvée, l'agent retourne à l'état Attacking. À ce moment-là, il voudra informer un allié de la menace, ce qui peut entraîner l'action NotifyFriendOfThreat.
Encore une fois, nous pouvons envisager ce système à travers le prisme du cycle Sense/Think/Act. Sense se matérialise dans les données utilisées par la logique de transition. Think consiste en les transitions disponibles dans chaque état. Act est réalisé par les actions entreprises périodiquement au sein d'un état ou lors des transitions entre états.
Parfois, l'interrogation continue des conditions de transition peut être coûteuse. Par exemple, si chaque agent effectue des calculs complexes à chaque image pour déterminer s'il voit des ennemis et s'il peut passer de l'état Patrolling à Attacking, cela prendra beaucoup de temps processeur.
Des changements importants dans l'état du monde peuvent être considérés comme des événements qui seront traités au fur et à mesure de leur apparition. Au lieu que le FSM vérifie chaque image la condition de transition « mon agent peut-il voir le joueur ? », on peut configurer un système séparé pour effectuer les vérifications moins fréquemment (par exemple, 5 fois par seconde). Le résultat générera Player Seen lorsque la vérification passe.
Cela est transmis au FSM, qui doit maintenant passer à la condition Player Seen event received et réagir en conséquence. Le comportement final est le même, à l'exception d'un léger retard presque imperceptible avant la réponse. Cependant, les performances se sont améliorées grâce à la séparation d'une partie de Sense dans une partie distincte du programme.
Machine à états finis hiérarchique
Cependant, travailler avec de grands FSM n'est pas toujours pratique. Si nous voulons élargir l'état d'attaque, en le remplaçant par des états distincts MeleeAttacking (combat rapproché) et RangedAttacking (combat à distance), nous devrons modifier les transitions de tous les autres états qui mènent à l'état Attacking (actuels et futurs).
Vous avez sûrement remarqué qu'il y a beaucoup de transitions dupliquées dans notre exemple. La plupart des transitions dans l'état Idling sont identiques à celles dans l'état Patrolling. Il serait bien de ne pas se répéter, surtout si nous ajoutons davantage d'états similaires. Il est logique de regrouper Idling et Patrolling sous un étiquetage commun de « non-combattant », où il n'y a qu'un ensemble général de transitions vers des états combattants. Si nous considérons cette étiquette comme un état, alors Idling et Patrolling deviendront des sous-états. Un exemple d'utilisation d'une table de transitions distincte pour le nouveau sous-état non-combattant :
États principaux :
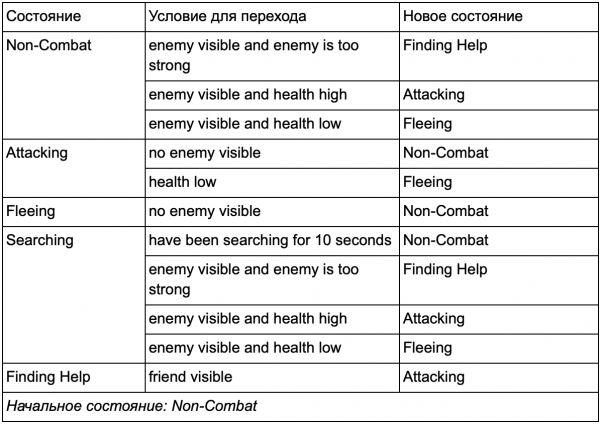
État hors combat :
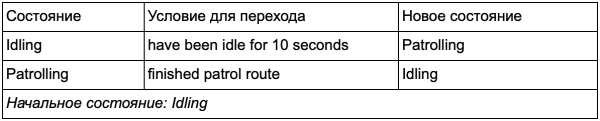
Et sous forme de diagramme :
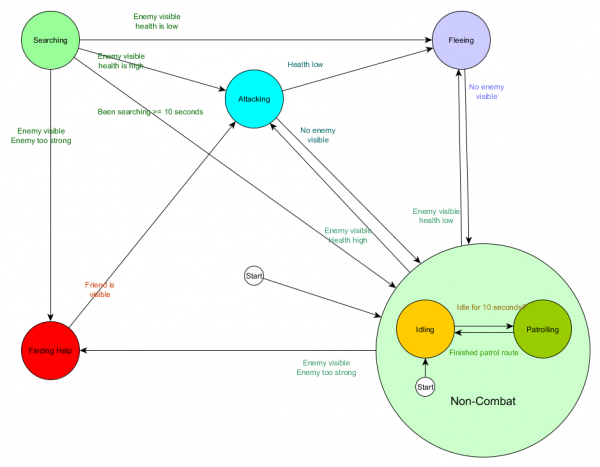
C'est le même système, mais avec un nouvel état non-combattant qui inclut Idling et Patrolling. Avec chaque état contenant un FSM avec des sous-états (et ces sous-états contenant à leur tour leurs propres FSM — et ainsi de suite autant de fois que nécessaire), nous obtenons une Machine à États Finis Hiérarchique ou HFSM. En regroupant l'état non-combattant, nous avons éliminé beaucoup de transitions redondantes. Nous pouvons faire la même chose pour tout nouvel état avec des transitions communes. Par exemple, si à l'avenir nous développons l'état Attacking en sous-états MeleeAttacking et MissileAttacking, ils seront des sous-états se déplaçant l'un entre l'autre en fonction de la distance à l'ennemi et de la disponibilité de munitions. Au final, des modèles de comportement complexes et des sous-modèles de comportement peuvent être représentés avec un minimum de transitions dupliquées.
Arbre des comportements
Avec HFSM, des combinaisons complexes de comportements sont créées de manière simple. Cependant, il y a une petite difficulté : la prise de décision sous forme de règles de transition est étroitement liée à l'état actuel. Et dans de nombreux jeux, c’est exactement ce dont on a besoin. Une utilisation soigneuse de la hiérarchie des états peut réduire le nombre de répétitions lors des transitions. Mais parfois, des règles doivent fonctionner indépendamment de l'état dans lequel vous vous trouvez ou qui s'appliquent presque dans tous les états. Par exemple, si la santé de l'agent tombe à 25 %, vous voudrez qu'il s'enfuie, peu importe s'il était en combat, inactif ou en train de parler — vous devrez ajouter cette condition à chaque état. Et si votre designer souhaite ensuite modifier le seuil de santé basse de 25 % à 10 %, il faudra s'y replonger.
Idéalement, cette situation nécessite un système dans lequel les décisions « quel état adopter » se trouvent en dehors des états eux-mêmes, permettant ainsi de modifier un seul endroit sans toucher aux conditions de transition. C'est ici que se présentent les arbres de comportement.
Il existe plusieurs manières de les réaliser, mais l'essentiel est à peu près le même et ressemble à un arbre de décision : l'algorithme commence par un nœud « racine », et dans l'arbre se trouvent des nœuds représentant soit des décisions, soit des actions. Cependant, il y a quelques différences clés :
- À présent, les nœuds renvoient l'une des trois valeurs : Succeeded (si le travail est effectué), Failed (si l'exécution est impossible) ou Running (si elle est toujours en cours et qu'il n'y a pas de résultat final).
- Il n'y a plus de nœuds de décision pour choisir entre deux alternatives. À la place, il y a des nœuds Decorator, qui ont un seul nœud enfant. S'ils réussissent, ils exécutent leur unique nœud enfant.
- Les nœuds effectuant des actions renvoient la valeur Running pour signifier que des actions sont en cours.
Cet ensemble limité de nœuds peut être combiné pour créer une grande variété de modèles de comportement complexes. Imaginons un HFSM de garde de l'exemple précédent sous forme d'arbre de comportement :
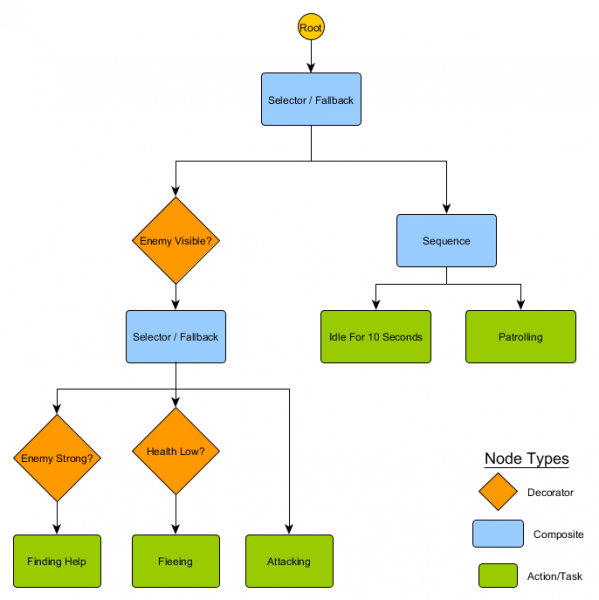
Avec cette structure, il ne devrait pas y avoir de transition explicite entre les états Idling/Patrolling et l'état Attacking ou tout autre. Si l'ennemi est visible et que la santé du personnage est basse, l'exécution s'arrêtera au nœud Fleeing, peu importe quel nœud il exécutait précédemment — Patrolling, Idling, Attacking ou tout autre.
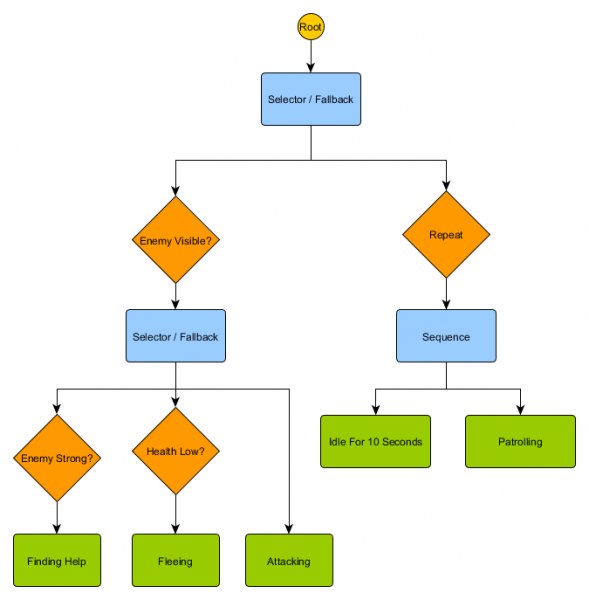
Les arbres de comportement sont complexes — il existe de nombreuses façons de les composer, et trouver la bonne combinaison de décorateurs et de nœuds composites peut également poser problème. Il y a aussi des questions sur la fréquence des vérifications de l'arbre — voulons-nous le parcourir à chaque étape ou seulement lorsque l'une des conditions change ? Comment conserver l'état lié aux nœuds — comment savoir quand nous avons été dans l'état Idling pendant 10 secondes ou comment connaître quels nœuds ont été exécutés la dernière fois pour gérer correctement la séquence ?
C'est pourquoi il existe de nombreuses réalisations. Par exemple, dans certains systèmes, des nœuds décorateurs peuvent avoir remplacé les décorateurs intégrés. Ils réévaluent l'arbre lorsque les conditions du décorateur changent, aident à se connecter aux nœuds et fournissent des mises à jour périodiques.
Système basé sur l'utilité
Certain games have a variety of mechanics. It's desirable for them to utilize the advantages of simple and general transition rules, but not necessarily in the form of a complete behavior tree. Instead of having a clear set of choices or a tree of possible actions, it's easier to explore all actions and select the most appropriate one for the moment.
A utility-based system will help with this. It's a system where the agent has multiple actions and chooses which to execute based on the relative utility of each. Here, utility is an arbitrary measure of how important or desirable performing that action is for the agent.
Based on the calculated utility of the action given the current state and environment, the agent can check and choose the most appropriate different state at any time. This is similar to an FSM, except that transitions are determined by an evaluation for each potential state, including the current one. Note that we choose the most useful action for transitioning (or stay if we have already performed it). For greater variety, this can be a weighted but random choice from a small list.
The system assigns an arbitrary range of utility values — for example, from 0 (not desirable at all) to 100 (completely desirable). Each action has a number of parameters that affect the computation of this value. Returning to our guard example:
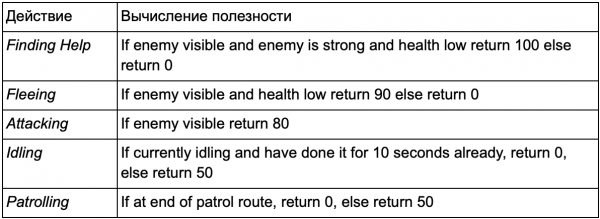
Transitions between actions are ambiguous — any state can follow any other. The priorities of actions are reflected in the returned utility values. If an enemy is visible, and this enemy is strong, while the character's health is low, both Fleeing and FindingHelp will return high non-zero values. However, FindingHelp will always be higher. Similarly, non-combat actions never return more than 50, so they will always be below combat actions. This must be considered when creating actions and calculating their utility.
Dans notre exemple, les actions retournent soit une valeur constante fixe, soit l'une des deux valeurs fixes. Un système plus réaliste suppose le retour d'une évaluation à partir d'une plage continue de valeurs. Par exemple, l'action Fuir retourne des valeurs d'utilité plus élevées lorsque la santé de l'agent est faible, tandis que l'action Attaquer retourne des valeurs plus basses lorsque l'ennemi est trop fort. En raison de cela, l'action Fuir a la priorité sur Attaquer dans toute situation où l'agent estime qu'il n'a pas assez de santé pour vaincre l'adversaire. Cela permet d'ajuster les priorités des actions en fonction d'un certain nombre de critères, rendant cette approche plus flexible et variable que l'arbre de comportement ou FSM.
Chaque action a de nombreuses conditions pour le calcul du programme. Celles-ci peuvent être écrites dans un langage de script ou sous forme de série de formules mathématiques. Dans The Sims, qui modélise la routine quotidienne d'un personnage, un niveau supplémentaire de calculs est ajouté — l'agent reçoit une série de « motivations » influençant les évaluations d'utilité. Si le personnage a faim, il ressentira un besoin croissant de nourriture, et le résultat de l'action Manger augmentera jusqu'à ce que le personnage l'exécute, réduisant ainsi son niveau de faim et ramenant la valeur Manger à zéro.
L'idée de choisir des actions sur la base d'un système d'évaluation est assez simple, c'est pourquoi un système basé sur l'utilité peut être utilisé comme partie des processus de prise de décision de l'IA, plutôt que comme un remplacement complet. Un arbre de décision peut demander une évaluation de l'utilité de deux nœuds enfants et choisir le plus élevé. De même, un arbre de comportement peut avoir un nœud composite Utilité pour évaluer l'utilité des actions afin de décider quel élément enfant exécuter.
Mouvement et navigation
Dans les exemples précédents, nous avions une plateforme que nous déplacions vers la gauche ou vers la droite, et un garde qui patrouillait ou attaquait. Mais comment traitons-nous exactement le mouvement d'un agent sur une période définie ? Comment définissons-nous la vitesse, comment évitons-nous les obstacles, et comment planifions-nous un itinéraire si atteindre la destination est plus compliqué que de se déplacer tout droit ? Voyons cela de plus près.
Gestion
Au départ, nous allons considérer que chaque agent a une valeur de vitesse, qui inclut à quel point il se déplace et dans quelle direction. Elle peut être mesurée en mètres par seconde, kilomètres par heure, pixels par seconde, etc. En rappelant le cycle Sens/Think/Agir, nous pouvons imaginer qu'une partie de la pensée choisit la vitesse, tandis qu'une partie de l'action applique cette vitesse à l'agent. En général, les jeux disposent d'un système physique qui exécute cette tâche pour vous, en examinant la valeur de la vitesse de chaque objet et en l'ajustant. Par conséquent, nous pouvons laisser l'IA avec une seule tâche — déterminer quelle vitesse l'agent doit avoir. S'il est connu où l'agent doit se rendre, il faut le déplacer dans la bonne direction à une vitesse définie. Une équation très triviale :
desired_travel = destination_position – agent_position
Imaginez un monde en 2D. L'agent est situé au point (-2,-2), la destination se trouve quelque part au nord-est au point (30, 20), et le chemin nécessaire pour que l'agent y arrive est (32, 22). Supposons que ces positions soient mesurées en mètres — si nous prenons la vitesse de l'agent à 5 mètres par seconde, nous allons mettre à l'échelle notre vecteur de déplacement et obtenir une vitesse d'environ (4,12, 2,83). Avec ces paramètres, l'agent arriverait à destination presque après 8 secondes.
Les valeurs peuvent être recalculées à tout moment. Si l'agent était à mi-chemin de la destination, le déplacement serait de la moitié de la distance, mais comme la vitesse maximale de l'agent est de 5 m/s (nous l'avons décidé plus haut), la vitesse restera la même. Cela fonctionne aussi pour des cibles en mouvement, permettant à l'agent d'apporter de petits ajustements au fur et à mesure de leur déplacement.
Mais nous voulons plus de variabilité — par exemple, augmenter progressivement la vitesse pour simuler un personnage passant d'un état stationnaire à la course. On peut en faire de même à la fin avant de s'arrêter. Ces fonctionnalités sont connues sous le nom de comportements de direction, chacun d'eux ayant des noms spécifiques : Seek (recherche), Flee (fuite), Arrival (arrivée), etc. L'idée est que les forces d'accélération peuvent être appliquées à la vitesse de l'agent, en fonction de la comparaison de la position de l'agent et de sa vitesse actuelle avec la destination, afin d'utiliser différentes manières de se déplacer vers l'objectif.
Chaque comportement a un objectif légèrement différent. Seek et Arrival sont des méthodes pour déplacer un agent vers un point de destination. Obstacle Avoidance (éviter les obstacles) et Separation (séparation) ajustent le mouvement de l'agent pour contourner les obstacles sur le chemin vers l'objectif. Alignment (alignement) et Cohesion (cohésion) maintiennent les agents ensemble lors de leurs déplacements. Un certain nombre de comportements de direction différents peuvent être combinés pour obtenir un seul vecteur de chemin en tenant compte de tous les facteurs. Un agent utilisant les comportements Arrival, Separation et Obstacle Avoidance pour s'éloigner des murs et d'autres agents. Cette approche fonctionne bien dans des lieux ouverts sans détails superflus.
Dans des conditions plus difficiles, la combinaison de différents comportements fonctionne moins bien : par exemple, un agent peut se retrouver coincé dans un mur à cause d'un conflit entre Arrival et Obstacle Avoidance. Il est donc nécessaire d'envisager des options plus complexes que la simple addition de toutes les valeurs. Une méthode consiste à considérer le mouvement dans différentes directions et à choisir la meilleure option au lieu d'additionner les résultats de chaque comportement.
Cependant, dans un environnement complexe avec des impasses et le choix de la direction à prendre, nous aurons besoin de quelque chose de plus avancé.
Recherche de chemin
Les comportements de direction conviennent parfaitement pour le déplacement simple sur un terrain dégagé (terrain de football ou arène), où atteindre l'point A à B est un chemin direct avec de légères déviations autour des obstacles. Pour des itinéraires plus complexes, nous avons besoin de pathfinding (recherche de chemin), qui est une méthode d'exploration du monde et de décision sur l'itinéraire à travers celui-ci.
La méthode la plus simple consiste à superposer une grille sur chaque carré adjacent à l'agent et à évaluer dans lesquels il est permis de se déplacer. Si l'un d'eux est un point de destination, suivez le parcours depuis celui-ci à chaque carré jusqu'à revenir au début. C'est le chemin. Sinon, répétez le processus avec les autres carrés les plus proches jusqu'à ce que vous trouviez la destination ou que vous manquiez de carrés (ce qui signifie qu'il n'y a pas de chemin possible). Ce qui est formellement connu sous le nom de recherche en largeur (ou Breadth-First Search, BFS). À chaque étape, elle examine dans toutes les directions (d'où le nom « largeur »). L'espace de recherche ressemble à un front d'onde qui se déplace jusqu'à atteindre le point recherché - la zone de recherche s'étend à chaque étape jusqu'à ce qu'elle atteigne le point final, après quoi il est possible de retracer le chemin jusqu'au début.
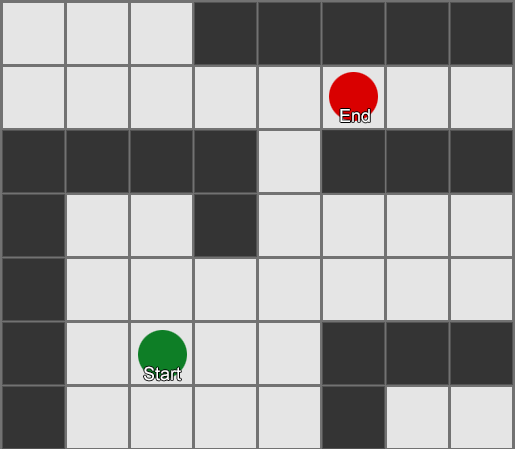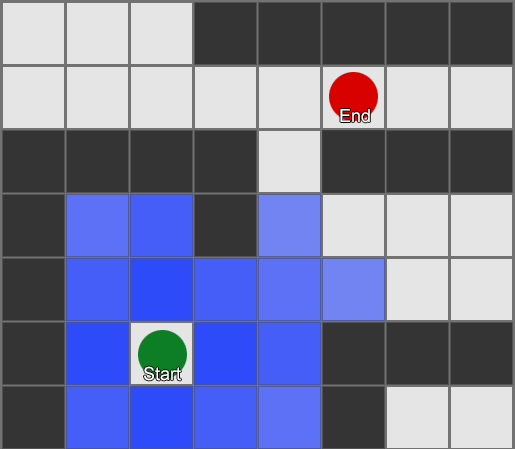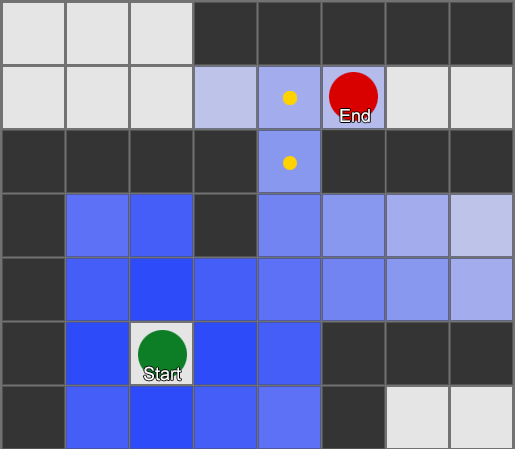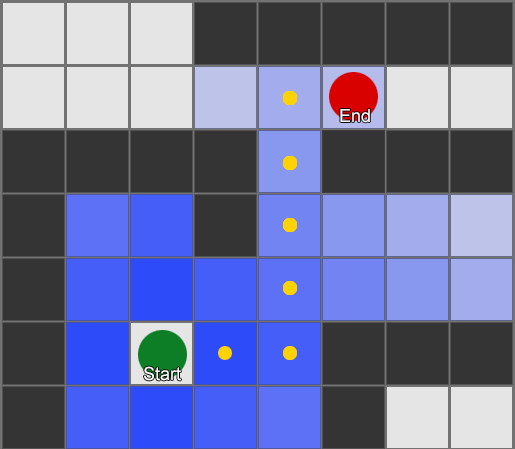
En conséquence, vous obtiendrez une liste de carrés qui compose le chemin nécessaire. C'est ce qu'on appelle le chemin (d'où le terme pathfinding) - une liste des lieux que l'agent visitera en se dirigeant vers la destination.
Étant donné que nous connaissons la position de chaque carré dans le monde, nous pouvons utiliser les comportements de pilotage (steering behaviours) pour se déplacer le long du chemin - du nœud 1 au nœud 2, puis du nœud 2 au nœud 3, et ainsi de suite. La solution la plus simple consiste à se diriger vers le centre du carré suivant, mais il est encore préférable de s'arrêter au milieu de l'arête entre le carré actuel et le suivant. Cela permet à l'agent de couper les angles lors des virages serrés.
L'algorithme BFS a aussi ses inconvénients - il explore autant de carrés dans la « mauvaise » direction que dans la « bonne ». C'est là qu'intervient un algorithme plus complexe appelé A* (A star). Il fonctionne de la même manière, mais au lieu d'explorer aveuglément les carrés voisins (puis les voisins des voisins, et ainsi de suite), il collecte les nœuds dans une liste et les trie de manière à ce que le prochain nœud exploré soit toujours celui qui mènera au chemin le plus court. Les nœuds sont triés en fonction d'une heuristique qui prend en compte deux choses : le « coût » du chemin hypothétique vers le carré souhaité (y compris les frais de déplacement) et une évaluation de la distance entre ce carré et la destination (orientant la recherche dans la bonne direction).
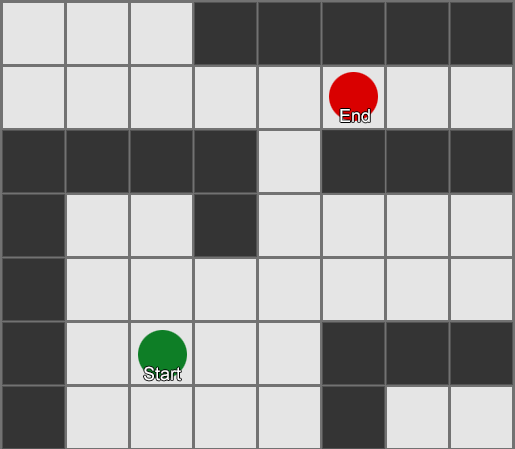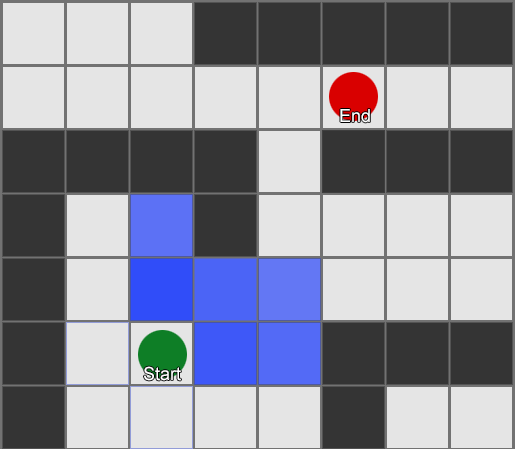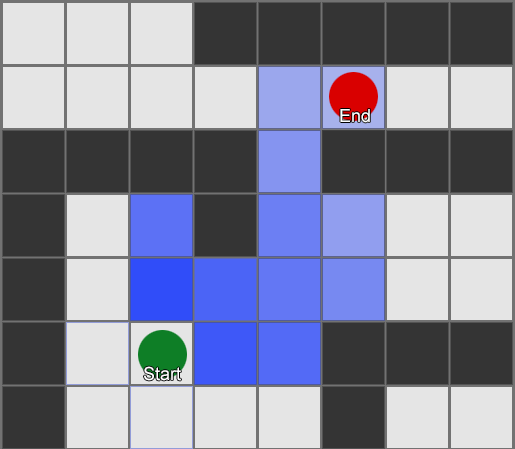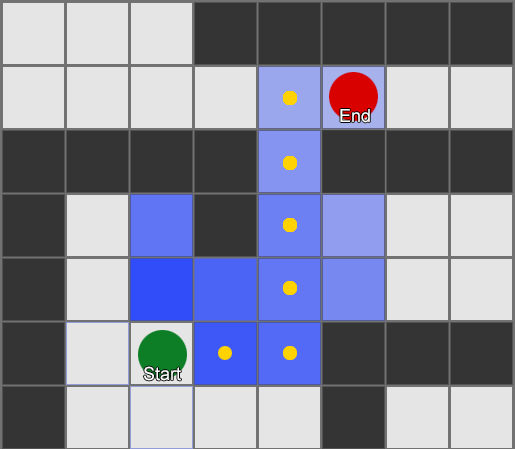
Cet exemple montre qu'un agent explore un carré à la fois, choisissant à chaque fois le voisin le plus prometteur. Le chemin obtenu est le même que celui de l'algorithme BFS, mais moins de carrés ont été examinés au cours du processus, ce qui a une grande importance pour les performances du jeu.
Mouvement sans grille
Mais la plupart des jeux ne sont pas basés sur une grille, et souvent, il est impossible d'en créer une sans compromettre le réalisme. Des compromis sont nécessaires. Quelle devrait être la taille des carrés ? Trop grands, et ils ne pourront pas correctement représenter de petits couloirs ou virages, trop petits, il y aura trop de carrés à rechercher, ce qui prendra beaucoup de temps.
La première chose à comprendre est que la grille nous donne un graphe de nœuds connectés. Les algorithmes A* et BFS fonctionnent en réalité sur des graphes et ne se soucient pas du tout de notre grille. Nous pourrions placer des nœuds à n'importe quel endroit dans le monde du jeu : tant qu'il existe une connexion entre deux nœuds liés, ainsi qu'entre le point de départ et le point d'arrivée et au moins un des nœuds, l'algorithme fonctionnera aussi bien qu'auparavant. Cela est souvent appelé un système de points de passage (waypoint), car chaque nœud représente une position significative dans le monde, pouvant faire partie de n'importe quel nombre de chemins hypothétiques.
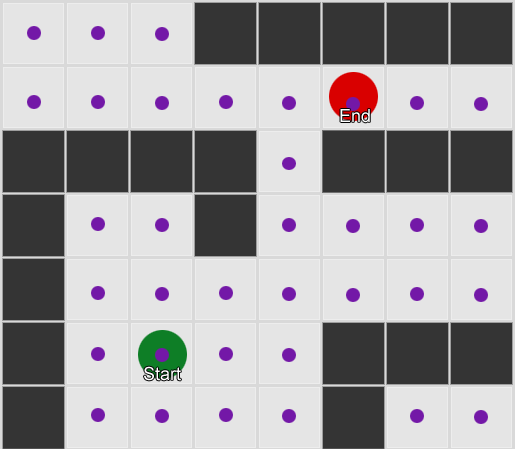
Exemple 1 : un nœud dans chaque carré. La recherche commence à partir du nœud où se trouve l'agent et se termine au nœud du carré souhaité.
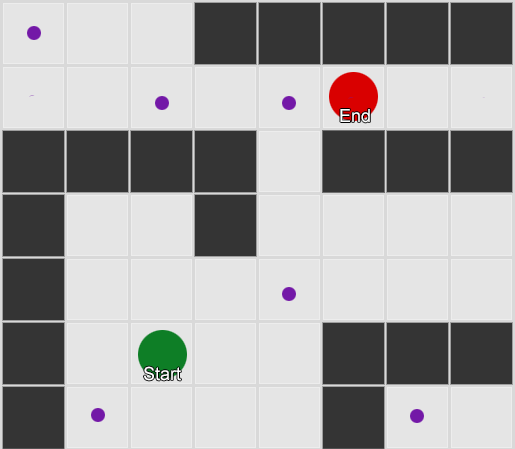
Exemple 2 : un ensemble de nœuds plus réduit (points de passage). La recherche commence dans le carré avec l'agent, passe par le nombre nécessaire de nœuds, puis continue jusqu'à la destination.
C'est un système assez flexible et puissant. Mais une certaine prudence est nécessaire dans les décisions concernant où et comment placer les points de passage, autrement les agents pourraient tout simplement ne pas voir le point le plus proche et ne pas pouvoir commencer leur chemin. Ce serait plus facile si nous pouvions automatiquement placer des points de passage en fonction de la géométrie du monde.
C'est là qu'apparaît la navigation mesh ou navmesh (grille de navigation). Il s'agit généralement d'une grille 2D de triangles superposée à la géométrie du monde — partout où il est permis à l'agent de se déplacer. Chacun des triangles de la grille devient un nœud dans le graphe et a jusqu'à trois triangles adjacents, qui deviennent des nœuds voisins dans le graphe.
Cette image est un exemple du moteur Unity — il a analysé la géométrie du monde et créé un navmesh (en bleu clair sur l'image). Chaque polygone dans le navmesh correspond à une zone où un agent peut se tenir ou se déplacer d'un polygone à un autre. Dans cet exemple, les polygones sont plus petits que les étages sur lesquels ils se trouvent — cela a été fait pour prendre en compte les dimensions de l'agent, qui pourraient s'étendre au-delà de sa position nominale.
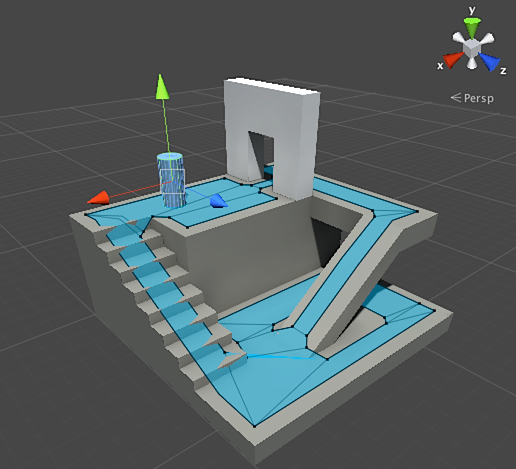
Nous pouvons rechercher un chemin à travers cette grille en utilisant à nouveau l'algorithme A*. Cela nous donnera pratiquement le chemin idéal dans un monde qui tient compte de toute la géométrie tout en évitant les nœuds superflus et la création de points de passage.
La recherche de chemin est un sujet trop vaste pour être couvert en un seul article. Si vous souhaitez l'explorer plus en détail, vous pouvez vous référer au .
Planification
Nous avons découvert avec la recherche de chemin que parfois, il ne suffit pas de choisir une direction et de progresser — nous devons choisir un chemin et faire plusieurs tournants pour atteindre notre destination. Nous pouvons résumer cette idée : atteindre un objectif ce n'est pas simplement le prochain pas, mais une séquence entière où, parfois, il est nécessaire de regarder un peu plus loin pour savoir ce qu'il faut faire en premier. Cela s'appelle la planification. La recherche de chemin peut être considérée comme un des plusieurs compléments à la planification. Du point de vue de notre cycle Sense/Think/Act, c'est là que la partie Think planifie plusieurs parties Act pour le futur.
Prenons l'exemple d'un jeu de cartes Magic : The Gathering. Nous commençons avec cet ensemble de cartes en main :
- Swamp — génère 1 mana noir (carte de terrain).
- Forest — génère 1 mana vert (carte de terrain).
- Fugitive Wizard — nécessite 1 mana bleu pour être invoqué.
- Elvish Mystic — nécessite 1 mana vert pour être invoqué.
Nous ignorons les trois cartes restantes pour simplifier. Selon les règles, un joueur est autorisé à jouer 1 carte de terrain par tour, il peut « taper » cette carte pour en extraire du mana, puis utiliser des sorts (y compris l'invocation d'une créature) en fonction de la quantité de mana. Dans cette situation, un joueur humain sait qu'il doit jouer Forest, « taper » 1 mana vert, puis invoquer Elvish Mystic. Mais comment un IA de jeu pourrait-elle en déduire cela ?
Planification simple
L'approche triviale consiste à essayer chaque action à tour de rôle jusqu'à ce qu'il ne reste plus d'options appropriées. En regardant les cartes, l'IA constate qu'elle peut jouer un Swamp. Et elle le joue. Y a-t-il d'autres actions possibles à ce tour ? Elle ne peut pas invoquer Elvish Mystic ou Fugitive Wizard, car leur invocation nécessite respectivement de la mana verte et bleue, tandis que Swamp ne fournit que de la mana noire. De plus, elle ne pourra pas jouer Forest car elle a déjà joué Swamp. Ainsi, l'IA a agi selon les règles, mais de manière peu efficace. Cela peut être amélioré.
La planification peut déterminer une liste d'actions qui mènent le jeu à l'état souhaité. Tout comme chaque case sur le chemin avait des voisins (dans la recherche de chemin), chaque action dans le plan a également des voisins ou des successeurs. Nous pouvons explorer ces actions et les actions suivantes jusqu'à ce que nous atteignions l'état désiré.
Dans notre exemple, le résultat souhaité est « invoquer une créature si possible ». Au début du tour, nous ne voyons que deux actions possibles autorisées par les règles du jeu :
1. Jouer un Swamp (résultat : Swamp en jeu)
2. Jouer un Forest (résultat : Forest en jeu)
Chaque action prise peut entraîner d'autres actions et en fermer d'autres, encore une fois en fonction des règles du jeu. Imaginez que nous avons joué Swamp — cela éliminera Swamp comme option suivante (puisque nous l'avons déjà joué) et cela éliminera également Forest (car selon les règles, on ne peut jouer qu'une seule carte de terrain par tour). Après cela, l'IA ajoute comme prochaine étape — obtenir 1 mana noire, car il n'y a pas d'autres options. Si elle avance et choisit de Taper le Swamp, elle obtiendra 1 mana noire et ne pourra rien en faire.
1. Jouer un Swamp (résultat : Swamp en jeu)
1.1 « Taper » Swamp (résultat : Swamp « tapé », +1 mana noire)
Pas d'actions disponibles – FIN
2. Jouer un Forest (résultat : Forest en jeu)
La liste des actions est devenue courte, nous sommes bloqués. Nous répétons le processus pour l'action suivante. Nous jouons un Forest, ouvrons l'action « obtenir 1 mana verte », qui à son tour ouvrira une troisième action — invoquer Elvish Mystic.
1. Jouer un Swamp (résultat : Swamp en jeu)
1.1 « Taper » Swamp (résultat : Swamp « tapé », +1 mana noire)
Pas d'actions disponibles – FIN
2. Jouer un Forest (résultat : Forest en jeu)
2.1 « Taper » Forest (résultat : Forest « tapé », +1 mana verte)
2.1.1 Invoquer Elvish Mystic (résultat : Elvish Mystic en jeu, -1 mana verte)
Pas d'actions disponibles – FIN
Enfin, nous avons exploré toutes les actions possibles et trouvé un plan pour invoquer une créature.
C'est un exemple très simplifié. Il est préférable de choisir le meilleur plan possible plutôt qu'un plan qui répond simplement à certains critères. En règle générale, les plans potentiels peuvent être évalués en fonction du résultat final ou du bénéfice total de leur exécution. On peut se donner 1 point pour jouer une carte de terrain et 3 points pour invoquer une créature. Jouer Swamp donnerait 1 point. Et jouer Forest → Tap the Forest → invoquer Elvish Mystic donnerait immédiatement 4 points.
Voici comment fonctionne la planification dans Magic: The Gathering, mais cette logique s'applique également dans d'autres situations. Par exemple, déplacer un pion pour dégager de l'espace pour le mouvement d'un fou aux échecs. Ou se cacher derrière un mur pour pouvoir tirer en toute sécurité dans XCOM. En gros, vous avez compris l'idée.
Planification améliorée
Parfois, il y a trop d'actions potentielles à considérer pour examiner chaque option possible. Pour revenir à l'exemple de Magic: The Gathering : supposons qu'il y ait plusieurs cartes de terrain et de créatures en jeu et dans votre main - le nombre de combinaisons de mouvements peut se chiffrer par dizaines. Il existe plusieurs solutions à ce problème.
La première méthode est le backward chaining (chaînage inversé). Au lieu d'examiner toutes les combinaisons, il est préférable de commencer par le résultat final et d'essayer de trouver un chemin direct. Au lieu d'aller de la racine de l'arbre à une feuille spécifique, nous allons dans l'autre sens - de la feuille à la racine. Cette méthode est plus simple et plus rapide.
Si l'adversaire a 1 point de vie, on peut trouver un plan pour « infliger 1 point de dégâts ou plus ». Pour y parvenir, il faut respecter une série de conditions :
1. Les dégâts peuvent être infligés par un sort - il doit être dans votre main.
2. Pour jouer le sort, il faut de la mana.
3. Pour obtenir de la mana, il faut jouer une carte de terrain.
4. Pour jouer une carte de terrain, il faut l'avoir dans votre main.
Une autre méthode est le best-first search (recherche du meilleur premier). Au lieu d'examiner tous les chemins, nous choisissons le plus approprié. Ce processus donne souvent un plan optimal sans coûts excessifs en recherche. A* est une forme de recherche du meilleur premier - en explorant les chemins les plus prometteurs dès le départ, il peut déjà trouver le meilleur chemin sans avoir besoin de vérifier les autres options.
Une variante intéressante et de plus en plus populaire de la recherche par meilleur d'abord est la recherche d'arbre de Monte Carlo. Au lieu de deviner quels plans sont les meilleurs lors du choix de chaque action suivante, l'algorithme choisit des successeurs aléatoires à chaque étape, jusqu'à ce qu'il atteigne la fin (lorsque le plan mène à une victoire ou une défaite). Le résultat final est ensuite utilisé pour augmenter ou diminuer l'évaluation du « poids » des options précédentes. En répétant ce processus plusieurs fois, l'algorithme donne une bonne estimation de la meilleure prochaine étape, même si la situation change (si l'adversaire prend des mesures pour entraver le joueur).
Dans l'histoire de la planification dans les jeux, on ne peut pas éviter le Goal-Oriented Action Planning ou GOAP (planification d'actions orientées vers un but). C'est une méthode largement utilisée et discutée, mais en dehors de quelques détails distinctifs, c'est essentiellement une méthode de rétroaction dont nous avons parlé précédemment. Si la tâche est « détruire le joueur », et que le joueur est derrière une couverture, le plan peut être le suivant : détruit avec une grenade → s'en saisir → lancer.
Il y a généralement plusieurs objectifs, chacun avec sa propre priorité. Si l'objectif de plus haute priorité ne peut pas être atteint (aucune combinaison d'actions ne crée le plan « détruire le joueur », car le joueur n'est pas visible), l'IA reviendra aux objectifs de priorité inférieure.
Apprentissage et adaptation
Nous avons déjà évoqué que l'IA de jeu utilise généralement peu l'apprentissage automatique, car cela ne convient pas à la gestion des agents en temps réel. Mais cela ne signifie pas qu'il n'y a rien à emprunter dans ce domaine. Nous voulons un adversaire dans un shooter dont on peut apprendre quelque chose. Par exemple, connaître les meilleures positions sur la carte. Ou un adversaire dans un jeu de combat qui bloquerait les combos souvent utilisés par le joueur, incitant à utiliser d'autres. Ainsi, l'apprentissage automatique dans de telles situations peut être très utile.
Statistiques et probabilités
Avant de passer à des exemples complexes, examinons jusqu'où nous pouvons aller en prenant quelques mesures simples et en les utilisant pour prendre des décisions. Par exemple, dans une stratégie en temps réel, comment pouvons-nous déterminer si un joueur peut lancer une attaque dans les premières minutes du jeu et quelle défense préparer contre cela ? Nous pouvons étudier l'expérience passée du joueur pour comprendre quelle pourrait être sa réaction future. Commençons par le fait que nous n'avons pas de telles données de base, mais nous pouvons les collecter : chaque fois que l'IA joue contre un humain, elle peut enregistrer le temps de la première attaque. Après quelques sessions, nous obtiendrons la moyenne du temps avant que le joueur attaque à l'avenir.
Les valeurs moyennes ont aussi un problème : si un joueur a attaqué 20 fois en mode rush et joué lentement 20 fois, les valeurs pertinentes seront quelque part au milieu, ce qui ne nous sera d'aucune utilité. L'une des solutions consiste à limiter les données d'entrée : nous pouvons prendre en compte les 20 dernières actions.
Une approche similaire est utilisée pour évaluer la probabilité de certaines actions, en supposant que les préférences passées du joueur demeureront les mêmes à l'avenir. Si un joueur nous attaque cinq fois avec un boule de feu, deux fois avec un éclair et une fois au corps à corps, il est évident qu'il préfère la boule de feu. Extrapolons et observons la probabilité d'utilisation de différentes armes : boule de feu = 62,5 %, éclair = 25 % et corps à corps = 12,5 %. Notre IA de jeu doit se préparer à se défendre contre le feu.
Une autre méthode intéressante consiste à utiliser le Naive Bayes Classifier (classificateur naïf de Bayes) pour étudier de grandes quantités de données d'entrée et classifier la situation afin que l'IA réagisse de la manière appropriée. Les classificateurs bayésiens sont surtout connus pour leur utilisation dans les filtres anti-spam des e-mails. Ils analysent les mots, les comparent à là où ces mots apparaissaient auparavant (dans des spams ou non), et tirent des conclusions sur les courriers entrants. Nous pouvons faire la même chose même avec moins de données d'entrée. Sur la base de toute l'information utile que l'IA observe (par exemple, quels unités ennemies ont été créées, ou quels sorts ils utilisent, ou quelles technologies ils ont recherchées), et du résultat final (guerre ou paix, attaquer ou défendre, etc.) — nous choisirons le comportement approprié pour l'IA.
Tous ces moyens d'apprentissage sont suffisants, mais il est préférable de les utiliser en fonction des données provenant des tests. L'IA apprendra à s'adapter aux différentes stratégies utilisées par vos testeurs. Une IA qui s'adapte au joueur après la sortie peut devenir trop prévisible ou, au contraire, trop difficile à battre.
Adaptation basée sur des valeurs
Étant donné le contenu de notre monde de jeu et de ses règles, nous pouvons modifier l'ensemble des valeurs qui influencent la prise de décision, plutôt que de simplement utiliser les données d'entrée. Voici comment procéder :
- Laissons l'IA collecter des données sur l'état du monde et les événements clés durant le jeu (comme mentionné ci-dessus).
- Modifions quelques valeurs clés (value) en fonction de ces données.
- Implémentons nos décisions, basées sur le traitement ou l'évaluation de ces valeurs.
Par exemple, l'agent a plusieurs pièces à choisir sur la carte d'un jeu de tir à la première personne. Chaque pièce a sa propre valeur, qui détermine combien elle est désirable à visiter. L'IA choisit aléatoirement la pièce vers laquelle aller, en se basant sur la valeur. Ensuite, l'agent se souvient dans quelle pièce il a été tué et diminue sa valeur (la probabilité qu'il y retourne). La situation inverse est également valable : si l'agent élimine de nombreux ennemis, la valeur de la pièce augmente.
Modèle de Markov
Que se passerait-il si nous utilisions les données collectées pour faire des prévisions ? Si nous mémorisons chaque pièce où nous avons vu un joueur pendant une certaine période, nous pourrons prédire dans quelle pièce le joueur pourrait se déplacer. En suivant et enregistrant les mouvements des joueurs dans les pièces (values), nous pouvons les prévoir.
Prenons trois pièces : rouge, verte et bleue. Et aussi les observations que nous avons enregistrées en visionnant la session de jeu :
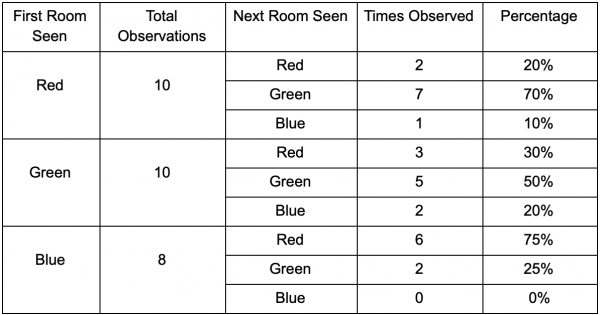
Le nombre d'observations pour chaque pièce est presque égal — où établir un bon endroit pour une embuscade, nous ne savons toujours pas. La collecte de statistiques est également compliquée par le respawn des joueurs, qui apparaissent uniformément sur toute la carte. Mais les données concernant la prochaine pièce dans laquelle ils entrent après leur apparition sur la carte sont déjà utiles.
On voit que la salle verte satisfait les joueurs — la plupart des personnes passant de la salle rouge à celle-ci y restent, dont 50 % y restent par la suite. En revanche, la salle bleue ne rencontre pas ce succès, elle est rarement fréquentée et ceux qui la visitent ne s'y attardent pas.
Cependant, les données nous révèlent quelque chose de plus important — lorsque le joueur se trouve dans la salle bleue, la salle suivante où nous le verrons probablement sera rouge, et non verte. Bien que la salle verte soit plus populaire que la rouge, la situation change si le joueur se trouve dans la bleue. L'état suivant (c'est-à-dire la salle dans laquelle le joueur va passer) dépend de l'état précédent (c'est-à-dire la salle dans laquelle le joueur se trouve actuellement). Grâce à l'étude des dépendances, nous ferons des prévisions plus précises que si nous comptions simplement les observations indépendamment les unes des autres.
La prévision de l'état futur basée sur les données de l'état passé est appelée modèle de Markov (Markov model), et de tels exemples (avec des salles) sont appelés chaînes de Markov. Comme les modèles représentent la probabilité de changements entre états successifs, ils sont visualisés sous forme de FSM avec une probabilité autour de chaque transition. Auparavant, nous avons utilisé des FSM pour représenter l'état comportemental dans lequel se trouvait l'agent, mais ce concept s'applique à tout état, qu'il soit lié ou non à l'agent. Dans ce cas, les états représentent la salle occupée par l'agent :
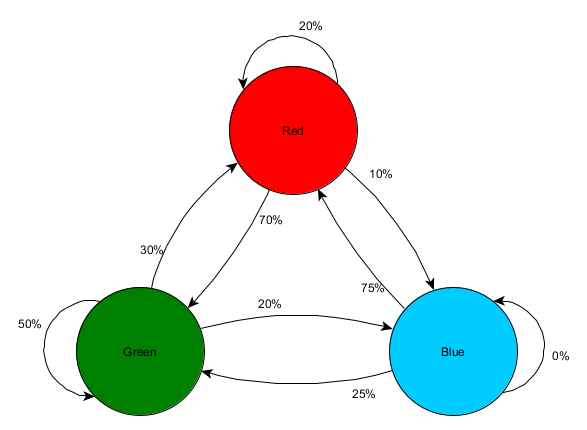
C'est une version simple de la représentation de la probabilité relative des changements d'états, donnant à l'IA une certaine capacité à prédire l'état suivant. Il est possible de prévoir plusieurs étapes à l'avance.
Si le joueur se trouve dans la salle verte, il y a 50 % de chances qu'il y reste lors de la prochaine observation. Mais quelle est la probabilité qu'il y soit encore même après ? Il n'y a pas seulement la chance que le joueur soit resté dans la salle verte après deux observations, mais aussi la chance qu'il soit parti et revenu. Voici un nouveau tableau prenant en compte les nouvelles données :
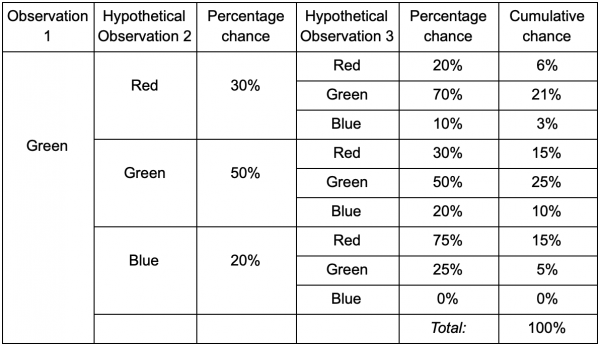
On peut voir que la probabilité de voir le joueur dans la salle verte après deux observations sera de 51 % — 21 % qu'il provienne de la salle rouge, 5 % qu'il ait visité la salle bleue entre les deux, et 25 %, qu'il ne quitte pas du tout la salle verte.
Le tableau est un simple outil visuel : la procédure nécessite seulement de multiplier les probabilités à chaque étape. Cela signifie que vous pouvez regarder loin dans le futur avec une seule condition : nous supposons que la chance d'entrer dans une pièce dépend uniquement de la pièce actuelle. Cela s'appelle la propriété de Markov (Markov Property) : l'état futur dépend uniquement de l'état présent. Mais ce n'est pas toujours exact. Les joueurs peuvent changer de décisions en fonction d'autres facteurs : le niveau de santé ou le nombre de munitions. Étant donné que nous ne prenons pas en compte ces valeurs, nos prévisions seront moins précises.
N-Grams
Que dire de l'exemple d'un jeu de combat et de la prévision des combos d'un joueur ? C'est exactement la même chose ! Mais au lieu d'un seul état ou événement, nous allons explorer des séquences entières qui composent le coup combo.
Une des façons de le faire est de conserver chaque entrée (par exemple, Kick, Punch ou Block) dans un tampon et d'enregistrer tout le tampon sous forme d'événement. Ainsi, lorsqu'un joueur appuie plusieurs fois sur Kick, Kick, Punch pour exécuter une attaque SuperDeathFist, le système IA stocke toutes les entrées dans le tampon et se souvient des trois dernières entrées utilisées à chaque étape.
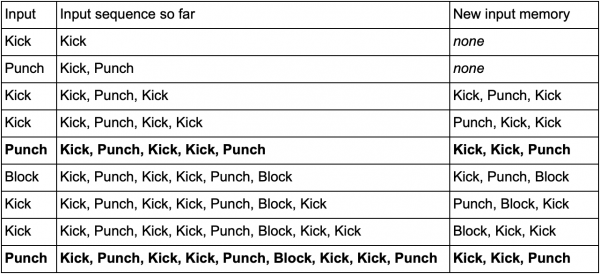
(Les lignes en gras sont celles où le joueur déclenche l'attaque SuperDeathFist.)
L'IA verra toutes les options lorsque le joueur a choisi Kick, suivi d'un autre Kick, puis remarquera que la prochaine entrée est toujours Punch. Cela permettra à l'agent de prédire le combo SuperDeathFist et de le bloquer si c'est possible.
Ces séquences d'événements sont appelées N-grams, où N est le nombre d'éléments stockés. Dans l'exemple précédent, il s'agissait d'un trigramme (3-gram), ce qui signifie que les deux premières entrées sont utilisées pour prédire la troisième. Ainsi, dans un 5-gram, les quatre premières entrées prédisent la cinquième, et ainsi de suite.
Le développeur doit choisir soigneusement la taille des N-grams. Un nombre N plus petit nécessite moins de mémoire, mais stocke également une histoire plus courte. Par exemple, un bigram (2-gram) enregistrera Kick, Kick ou Kick, Punch, mais ne pourra pas stocker Kick, Kick, Punch, donc l'IA ne réagira pas au combo SuperDeathFist.
D'un autre côté, des nombres plus grands nécessitent plus de mémoire et il sera plus difficile pour l'IA d'apprendre, car il y aura beaucoup plus d'options possibles. Si vous aviez trois entrées possibles : Kick, Punch ou Block, et que nous avons utilisé un 10-gram, cela représenterait environ 60 000 variations différentes.
Le modèle de bigramme est une chaîne de Markov simple : chaque paire « état précédent / état actuel » constitue un bigramme, et vous pouvez prédire le second état basé sur le premier. Les trigrammes et les N-grammes de plus grande taille peuvent également être considérés comme des chaînes de Markov, où tous les éléments (sauf le dernier dans le N-gramme) forment ensemble le premier état, et le dernier élément est le second. Un exemple avec un combat montre la chance de passer de l'état Kick et Kick à l'état Kick et Punch. En considérant plusieurs enregistrements de l'historique d'entrée comme une seule unité, nous transformons essentiellement la séquence d'entrée en une partie d'un tout. Cela nous donne une propriété de Markov, nous permettant d'utiliser des chaînes de Markov pour prédire l'entrée suivante et deviner quel coup combo sera le suivant.
Conclusion
Nous avons discuté des outils et des approches les plus courants dans le développement de l'intelligence artificielle. Nous avons également examiné les situations dans lesquelles ils doivent être appliqués et où ils sont particulièrement utiles.
Cela devrait suffire pour comprendre les concepts de base de l'IA dans les jeux. Mais, bien sûr, ce n'est pas tous les méthodes. Parmi les méthodes moins populaires mais tout aussi efficaces, il y a :
- des algorithmes d'optimisation, y compris la montée en colline, la descente du gradient et les algorithmes génétiques
- des algorithmes de recherche / planification compétitifs (minimax et élagage alpha-bêta)
- des méthodes de classification (perceptrons, réseaux de neurones et machines à vecteurs de soutien)
- des systèmes pour le traitement de la perception et de la mémoire des agents
- des approches architecturales pour l'IA (systèmes hybrides, sous-ensembles d'architectures et autres manières de superposer des systèmes IA)
- des outils d'animation (planification et coordination des mouvements)
- des facteurs de performance (niveau de détail, algorithmes anytime et timeslicing)
Ressources Internet sur le sujet :
1. Sur GameDev.net, il y a , ainsi que .
2. contient de nombreuses présentations et articles sur un large éventail de sujets liés au développement de l'IA de jeu.
3. inclut des sujets du sommet GDC AI, dont beaucoup sont disponibles gratuitement.
4. Des matériaux utiles peuvent également être trouvés sur le site .
5. Tommy Thompson, un chercheur en IA et développeur de jeux, réalise des vidéos sur la chaîne YouTube expliquant et étudiant l'IA dans les jeux commerciaux.
Livres sur le sujet :
1. La série de livres Game AI Pro est une collection d'articles courts expliquant comment implémenter des fonctionnalités spécifiques ou résoudre des problèmes particuliers.
2. La série AI Game Programming Wisdom est le prédécesseur de la série Game AI Pro. Elle contient des méthodes plus anciennes, mais presque toutes restent pertinentes même aujourd'hui.
3. — c'est l'un des textes de base pour quiconque souhaite comprendre le domaine général de l'intelligence artificielle. Ce livre ne traite pas du développement de jeux — il enseigne les bases de l'IA.
Source : habr.com
