

Nous allons vous raconter une histoire rafraîchissante sur la façon dont des « tiers » ont essayé de déranger le travail de nos clients, et comment ce problème a été résolu.
Comment tout a commencé
Tout a commencé le matin du 31 octobre, le dernier jour du mois, lorsque beaucoup de gens doivent impérativement régler des questions urgentes et importantes.
Un de nos partenaires, qui héberge dans notre cloud plusieurs machines virtuelles pour ses clients, a signalé qu'entre 9h10 et 9h20, plusieurs serveurs Windows fonctionnant sur notre site en Ukraine ne prenaient pas de connexions au service d'accès à distance, les utilisateurs ne pouvaient pas accéder à leurs bureaux, mais quelques minutes plus tard, le problème semblait s'être résolu de lui-même.
Nous avons consulté les statistiques de fonctionnement des canaux de communication, mais n'avons trouvé ni pics de trafic, ni défaillances. Nous avons vérifié la charge des ressources de calcul – aucune anomalie. Et qu'est-ce que cela pouvait être ?
Ensuite, un autre partenaire, qui héberge dans notre cloud encore une centaine de serveurs, a signalé des problèmes similaires que certains de leurs clients avaient remarqués. Il s'est avéré que les serveurs étaient globalement accessibles (répondaient correctement aux tests ping et à d'autres requêtes), mais le service d'accès à distance sur ces serveurs acceptait parfois de nouvelles connexions et parfois les rejetait, malgré le fait que ces serveurs étaient situés sur différentes plateformes, et que le trafic leur arrivait par différents canaux de transmission de données.
Regardons ce trafic. Un paquet avec une demande d'établissement de connexion arrive sur le serveur :
xx:xx:xx.xxxxxx IP xxx.xxx.xxx.xxx.58355 > 192.168.xxx.xxx.3389: Flags [S], seq 467744439, win 64240, options [mss 1460,nop,wscale 8,nop,nop,sackOK], length 0
Le serveur reçoit ce paquet, mais refuse la connexion :
xx:xx:xx.xxxxxx IP 192.168.xxx.xxx.3389 > xxx.xxx.xxx.xxx.58355: Flags [R.], seq 0, ack 467744440, win 0, length 0
Cela signifie que le problème n'est clairement pas dû à des défaillances de l'infrastructure, mais à autre chose. Peut-être que tous les utilisateurs rencontrent des problèmes de licenciement des bureaux à distance ? Peut-être qu'un logiciel malveillant a réussi à s'introduire dans leurs systèmes, et aujourd'hui, il s'est activé, comme il y a quelques années avec XData et Petya?
Pendant que nous enquêtions, nous avons reçu des signalements similaires de plusieurs autres clients et partenaires.
Que se passe-t-il exactement sur ces machines ?
Les journaux d'événements sont remplis de messages sur des tentatives de piratage de mots de passe :
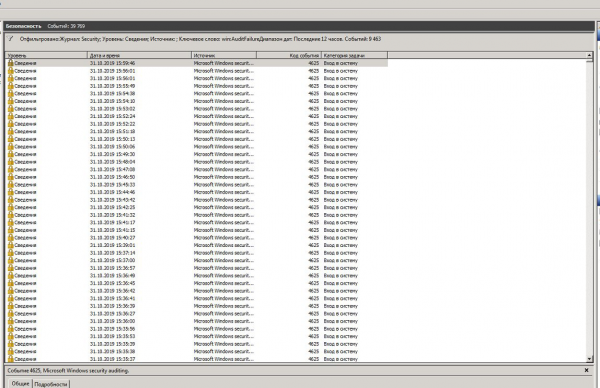
De telles tentatives sont généralement enregistrées sur tous les serveurs où le port standard (3389) est utilisé pour le service d'accès à distance et où l'accès est autorisé depuis n'importe où. Internet regorge de bots qui scannent constamment tous les points de connexion disponibles et essaient de deviner les mots de passe (c'est précisément pour cette raison que nous recommandons vivement d'utiliser des mots de passe complexes au lieu de « 123 »). Cependant, l'intensité de ces tentatives ce jour-là était incontestablement excessive.
Que faire ?
Recommander aux clients de passer beaucoup de temps à modifier les réglages pour un grand nombre d'utilisateurs finaux afin de changer de port ? Ce n’est pas une bonne idée, les clients ne seront pas contents. Conseiller de permettre l'accès uniquement via VPN ? Se précipiter pour établir des connexions IPSec là où elles n'existent pas encore n'est sans doute pas non plus une bonne solution pour les clients. Néanmoins, cela reste une démarche louable, et nous recommandons toujours de cacher le serveur dans un réseau privé et sommes prêts à aider avec les réglages. Pour ceux qui aiment se débrouiller, nous partageons des instructions pour configurer IPSec/L2TP dans notre cloud en mode site-à-site ou road-warrior, et pour ceux qui souhaitent mettre en place un service VPN sur leur propre serveur Windows, nous sommes toujours prêts à fournir des conseils sur la mise en place d'un RAS standard ou d'OpenVPN. Mais quelle que soit notre compétence, ce n'était pas le meilleur moment pour mener un travail éducatif auprès des clients, car il était nécessaire de résoudre le problème le plus rapidement possible avec un minimum de dérangement pour les utilisateurs.
La solution que nous avons mise en œuvre était la suivante. Nous avons configuré l'analyse du trafic entrant pour suivre toutes les tentatives d'établissement d'une connexion TCP sur le port 3389 et pour extraire les adresses qui, pendant 150 secondes, tentent de se connecter à plus de 16 serveurs différents de notre réseau, – ce sont les sources de l'attaque (bien sûr, si l'un de nos clients ou partenaires a un besoin réel d'établir des connexions avec autant de serveurs à partir d'une même source, il est toujours possible d'ajouter ces sources à la liste « blanche ». Par ailleurs, si plus de 32 adresses sont détectées dans un même réseau de classe C au cours de ces 150 secondes, il est judicieux de bloquer l'ensemble du réseau. Le blocage est appliqué pendant 3 jours, et si aucune attaque n'est effectuée à partir de cette source durant ce délai, cette source est automatiquement supprimée de la « liste noire ». La liste des sources bloquées est mise à jour toutes les 300 secondes.
Cette liste est accessible à cette adresse : , vous pouvez construire vos ACL sur la base de cela.
Nous sommes prêts à partager le code source de ce système, il n'y a rien de particulièrement complexe (ce sont quelques scripts simples, élaborés en quelques heures « à la volée »), et il peut également être adapté et utilisé non seulement pour se protéger contre ce type d'attaque, mais aussi pour identifier et bloquer toute tentative de scan du réseau :
De plus, nous avons apporté quelques modifications aux paramètres du système de surveillance, qui surveille désormais de plus près la réaction d'un groupe témoin de serveurs virtuels dans notre cloud face à une tentative d'établissement d'une connexion RDP : si la réaction n'a pas lieu dans la seconde – cela mérite attention.
La solution s'est révélée assez efficace : il n'y a plus de plaintes de la part des clients et des partenaires, ni de la part du système de surveillance. De nouvelles adresses et des réseaux entiers figurent régulièrement sur la « liste noire », ce qui indique que l'attaque se poursuit, mais n'affecte plus le fonctionnement de nos clients.
Un homme seul ne fait pas le warrior.
Aujourd'hui, nous avons appris que d'autres opérateurs ont rencontré un problème similaire. Certains pensent encore que c'est Microsoft qui a apporté des modifications au code du service d'accès à distance (si vous vous souvenez, nous avons soupçonné la même chose dès le premier jour, mais nous avons rapidement rejeté cette version) et promettent de tout faire pour trouver une solution le plus rapidement possible. D'autres ignorent simplement le problème et conseillent à leurs clients de se défendre eux-mêmes (changer le port de connexion, cacher le serveur dans un réseau privé, etc.). Dès le premier jour, nous avons non seulement résolu ce problème, mais également créé une base pour un système de détection des menaces plus global que nous prévoyons de développer.
Un grand merci aux clients et partenaires qui n'ont pas gardé le silence et n'ont pas attendu sur les rives pour que le corps de l'ennemi passe un jour, mais ont immédiatement attiré notre attention sur le problème, ce qui nous a permis de le résoudre le jour même.
Source : habr.com
