

La résilience et la haute disponibilité sont des sujets importants, c'est pourquoi nous consacrerons des articles distincts à RabbitMQ et à Kafka. Cet article est consacré à RabbitMQ, tandis que le suivant portera sur Kafka, en le comparant à RabbitMQ. L'article est long, alors installez-vous confortablement.
Examinons les stratégies de résilience, de cohérence et de haute disponibilité (HA), ainsi que les compromis à accepter dans chaque stratégie. RabbitMQ peut fonctionner sur un cluster de nœuds, le classant ainsi comme un système distribué. Lorsqu'il s'agit de systèmes distribués, nous parlons souvent de cohérence et de disponibilité.
Ces concepts décrivent comment le système se comporte en cas de défaillance. Une défaillance de la connexion réseau, un plantage du serveur, une défaillance du disque dur, une indisponibilité temporaire du serveur due à une collecte de déchets, une perte de paquets ou un ralentissement de la connexion. Tout cela peut entraîner une perte de données ou des conflits. Il s'avère qu'il est presque impossible de construire un système qui soit à la fois complètement cohérent (sans perte de données, sans divergences de données) et disponible (acceptant des opérations de lecture et d'écriture) pour toutes les défaillances.
Nous verrons que la cohérence et la disponibilité se situent à des extrémités opposées du spectre, et vous devez choisir dans quelle direction optimiser. La bonne nouvelle est qu'avec RabbitMQ, ce choix est possible. Vous disposez de « manettes de nerd » pour ajuster l'équilibre en faveur d'une plus grande cohérence ou d'une plus grande disponibilité.
Nous mettrons particulièrement l'accent sur les configurations qui entraînent une perte de données en raison des accusés de réception. Il existe une chaîne de responsabilité entre les éditeurs, les courtiers et les consommateurs. Une fois qu'un message a été remis au courtier, c'est son travail de ne pas perdre ce message. Lorsque le courtier accuse réception de la réception d'un message à l'éditeur, nous ne nous attendons pas à ce qu'il soit perdu. Mais nous verrons que cela peut vraiment se produire en fonction de la configuration de votre courtier et de votre éditeur.
Primitifs de résilience d'un seul nœud
Queues de résilience / routage
Dans RabbitMQ, il existe deux types de files d'attente : les files d'attente durables (durable) et non durables (non-durable). Toutes les files d'attente sont sauvegardées dans la base de données Mnesia. Les files d'attente durables sont réannoncées lors du démarrage du nœud et, par conséquent, survivent à un redémarrage, à une panne système ou à un échec du serveur (tant que les données sont conservées). Cela signifie que tant que vous déclarez le routage (exchange) et la file d'attente comme durables, l'infrastructure des files d'attente / routage passera en mode opérationnel.
Les files d'attente non durables et le routage sont supprimés lors du redémarrage du nœud.
Messages durables
Le fait qu'une file d'attente soit durable ne signifie pas que tous ses messages survivront au redémarrage du nœud. Seuls les messages définis par le publiant comme durables (persistent) seront restaurés. Les messages durables créent effectivement une charge supplémentaire pour le courtier, mais si la perte d'un message est inacceptable, il n'y a pas d'autre option.
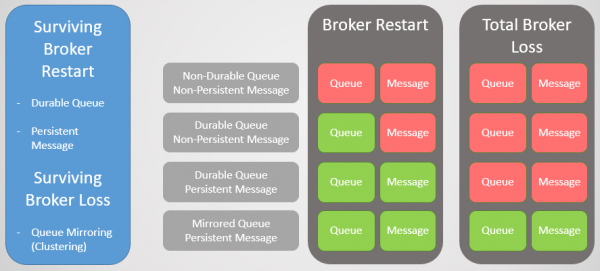
Fig. 1. Matrice de durabilité
Clustering avec réplication de files d'attente
Pour survivre à la perte d'un courtier, nous avons besoin de redondance. Nous pouvons regrouper plusieurs nœuds RabbitMQ en un cluster, puis ajouter une redondance supplémentaire en répliquant les files d'attente entre plusieurs nœuds. Ainsi, si un nœud tombe, nous ne perdons pas de données et restons accessibles.
Réplication de file d'attente:
- une file d'attente principale (master), qui reçoit toutes les commandes d'écriture et de lecture
- une ou plusieurs répliques, qui reçoivent tous les messages et métadonnées de la file principale. Ces répliques n'existent pas pour l'évolutivité, mais uniquement pour la redondance.
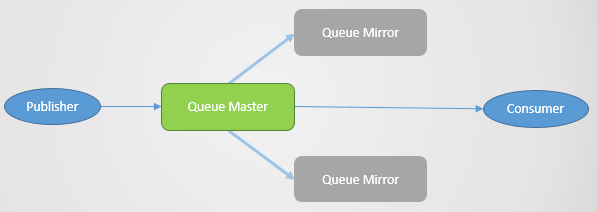
Fig. 2. Réplication de file d'attente
La réplication est configurée par la politique appropriée. Vous pouvez y choisir le coefficient de réplication et même les nœuds sur lesquels la file d'attente doit être placée. Exemples :
ha-mode: allha-mode: exactly, ha-params: 2(un maître et une réplique)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Confirmation au publiant
Pour assurer un enregistrement cohérent, des confirmations sont nécessaires de la part du publieur (Publisher Confirms). Sans elles, il y a un risque de perte de messages. La confirmation est envoyée au publieur après que le message a été écrit sur le disque. RabbitMQ écrit les messages sur le disque non pas à la réception, mais de manière périodique, dans une plage de plusieurs centaines de millisecondes. Lorsque la file est mise en miroir, la confirmation n'est envoyée qu'après que tous les miroirs aient également écrit leur copie du message sur le disque. Cela signifie que l'utilisation de confirmations ajoute un retard, mais si la sécurité des données est importante, elles sont nécessaires.
File d'attente tolérante aux pannes
Lorsque le courtier s'arrête ou tombe en panne, toutes les files maîtresses sur ce nœud tombent avec lui. Ensuite, le cluster choisit le miroir le plus ancien de chaque maître et le promeut en tant que nouveau maître.
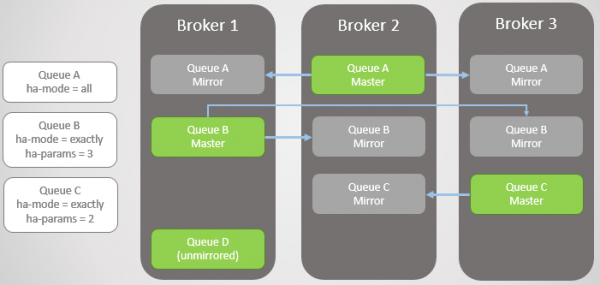
Fig. 3. Plusieurs files d'attente mises en miroir et leurs politiques
Le courtier 3 tombe. Notez que le miroir de la File d'attente C sur le Courtier 2 est promu au rang de maître. Remarquez également qu'un nouveau miroir pour la File d'attente C est créé sur le Courtier 1. RabbitMQ essaie toujours de maintenir le ratio de réplication défini dans vos politiques.
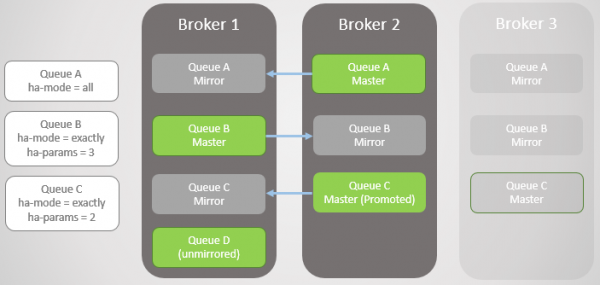
Fig. 4. Le courtier 3 tombe, ce qui provoque une défaillance de la File d'attente C
Le prochain Courtier 1 tombe ! Il ne nous reste qu'un seul courtier. Le miroir de la File d'attente B est promu au rang de maître.
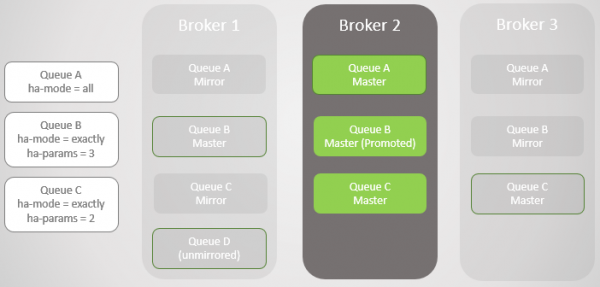
Fig. 5
Nous avons récupéré le Courtier 1. Peu importe combien de données ont survécu à la perte et à la récupération du courtier, tous les messages mis en miroir de la file d'attente sont rejetés lors du redémarrage. Il est important de noter cela car il y aura des conséquences. Nous examinerons bientôt ces conséquences. Ainsi, le Courtier 1 est à nouveau membre du cluster et le cluster essaie de respecter les politiques et crée donc des miroirs sur le Courtier 1.
Dans ce cas, la perte du Courtier 1 était totale, tout comme la perte de données, donc la File d'attente B, non mise en miroir, est complètement perdue.
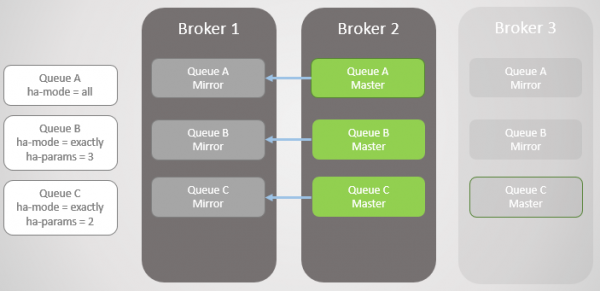
Fig. 6. Le Courtier 1 revient en ligne
Le Broker 3 est de retour en service, ce qui permet aux files A et B de reprendre les miroirs qui y ont été créés pour satisfaire à leurs politiques HA. Mais maintenant, toutes les files principales se trouvent sur un seul nœud ! Ce n'est pas idéal, un meilleur équilibrage entre les nœuds serait préférable. Malheureusement, il n'y a pas beaucoup d'options pour rebalancer les maîtres. Nous reviendrons sur ce problème plus tard, car il faut d'abord examiner la synchronisation des files.
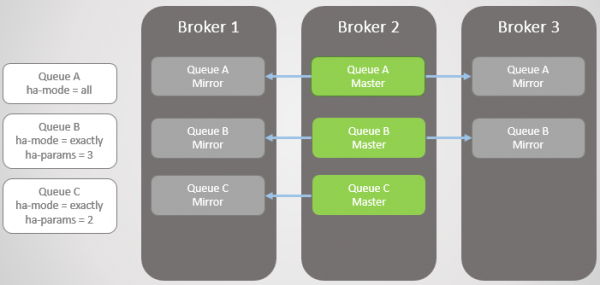
Fig. 7. Le Broker 3 reprend du service. Toutes les files principales sur un seul nœud !
Ainsi, vous devriez désormais avoir une idée de la manière dont les miroirs assurent la redondance et la tolérance aux pannes. Cela garantit la disponibilité en cas de défaillance d'un nœud et protège contre la perte de données. Mais nous n'en avons pas encore terminé, car en réalité, tout cela est bien plus complexe.
Synchronisation
Lors de la création d'un nouveau miroir, tous les nouveaux messages seront toujours répliqués vers ce miroir et tous les autres. En ce qui concerne les données existantes dans la file principale, nous pouvons les répliquer dans le nouveau miroir, qui devient une copie complète du maître. Nous pouvons également choisir de ne pas répliquer les messages existants et laisser la file principale et le nouveau miroir se synchroniser dans le temps, avec les nouveaux messages entrant à la fin, tandis que les messages existants sortent du début de la file principale.
Cette synchronisation peut être effectuée automatiquement ou manuellement et est gérée via des politiques de files. Prenons un exemple.
Nous avons deux files en miroir. La file A se synchronise automatiquement, tandis que la file B se synchronise manuellement. Les deux files contiennent dix messages.
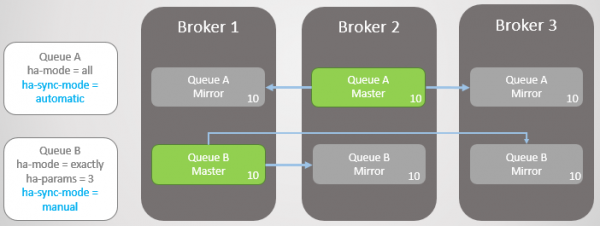
Fig. 8. Deux files avec différents modes de synchronisation
Nous perdons maintenant le Broker 3.
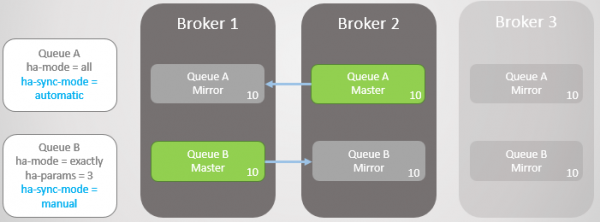
Fig. 9. Le Broker 3 est tombé
Le Broker 3 reprend du service. Le cluster crée un miroir pour chaque file sur un nouveau nœud et synchronise automatiquement la nouvelle file A avec le maître. Cependant, le miroir de la nouvelle file B reste vide. Ainsi, nous avons une redondance complète pour la file A et seulement un miroir pour les messages existants de la file B.
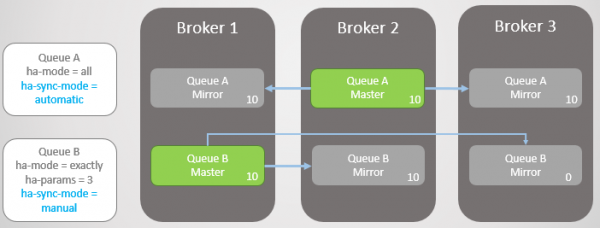
Fig. 10. Le nouveau miroir de la file A reçoit tous les messages existants, tandis que le nouveau miroir de la file B ne reçoit rien.
Dans les deux files, dix nouveaux messages sont ajoutés. Ensuite, le Courtier 2 tombe, et la File A revient à la plus ancienne réplique, qui se trouve sur le Courtier 1. Aucun perte de données ne se produit lors de la panne. Dans la File B, il y a vingt messages dans le maître et seulement dix dans la réplique, car cette file n'a jamais répliqué les dix messages originaux.
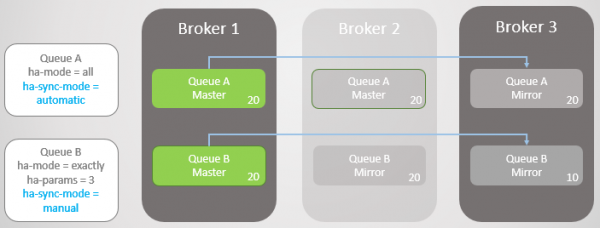
Fig. 11. La File A revient sur le Courtier 1 sans perte de messages
Dans les deux files, dix nouveaux messages sont ajoutés. Maintenant, le Courtier 1 tombe. La File A bascule sans problème vers la réplique sans perte de messages. Cependant, la File B rencontre des problèmes. À ce stade, nous pouvons optimiser soit la disponibilité, soit la cohérence.
Si nous voulons optimiser la disponibilité, alors la politique ha-promote-on-failure doit être définie sur always. C'est la valeur par défaut, donc nous pouvons simplement ne pas spécifier de politique. Dans ce cas, nous acceptons en effet des pannes dans des répliques non synchronisées. Cela entraînera la perte de messages, mais la file reste accessible en lecture et écriture.
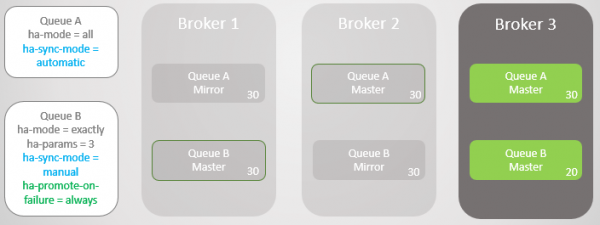
Fig. 12. La File A revient sur le Courtier 3 sans perte de messages. La File B revient sur le Courtier 3 avec une perte de dix messages
Nous pouvons également définir ha-promote-on-failure à la valeur when-synced. Dans ce cas, au lieu de revenir à la réplique, la file attendra que le Courtier 1 avec ses données revienne en ligne. Après son retour, la file principale est à nouveau sur le Courtier 1 sans perte de données. La disponibilité est sacrifiée au profit de la sécurité des données. Mais c'est un mode risqué qui peut même entraîner une perte complète de données, ce que nous examinerons prochainement.
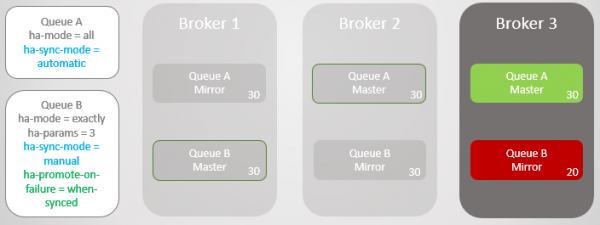
Fig. 13. La File B reste inaccessible après la perte du Courtier 1
Vous pourriez vous demander : « Peut-être vaut-il mieux ne jamais utiliser la synchronisation automatique ? ». La réponse est que la synchronisation est une opération bloquante. Pendant la synchronisation, la file principale ne peut effectuer aucune opération de lecture ou d'écriture !
Considérons un exemple. Nous avons maintenant des files très grandes. Comment peuvent-elles atteindre une telle taille ? Pour plusieurs raisons :
- Les files ne sont pas utilisées activement
- Ce sont des files à haute vitesse, et en ce moment, les consommateurs fonctionnent lentement
- Ce sont des files à haute vitesse, il y a eu une panne, et les consommateurs rattrapent leur retard
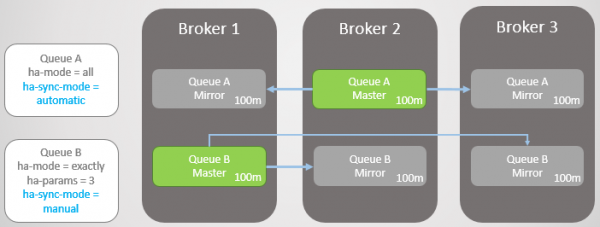
Fig. 14. Deux grandes files d'attente avec différents modes de synchronisation
Maintenant, le Broker 3 tombe.
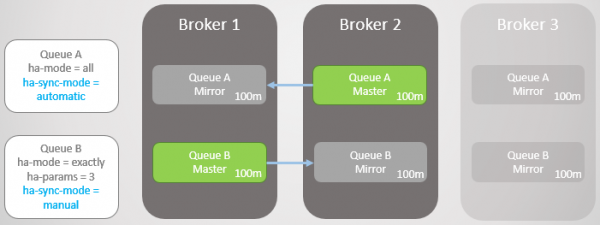
Fig. 15. Le Broker 3 tombe, laissant un maître et un miroir dans chaque file d'attente
Le Broker 3 revient en ligne, et de nouveaux miroirs sont créés. La File d'attente Principale A commence à répliquer les messages existants sur le nouveau miroir, ce qui rend la file d'attente indisponible pendant cette période. La réplication des données prend deux heures, entraînant deux heures de temps d'arrêt pour cette file d'attente !
Cependant, la File d'attente B reste disponible pendant toute cette période. Elle a sacrifié une partie de sa redondance pour la disponibilité.
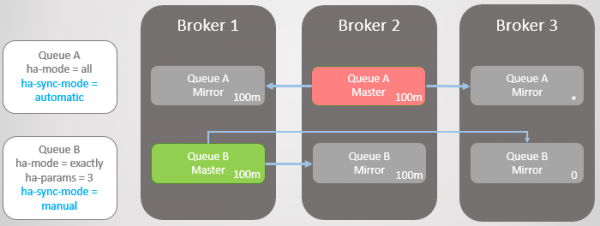
Fig. 16. La file d'attente reste indisponible pendant la synchronisation
Après deux heures, la File d'attente A devient également disponible et peut à nouveau commencer à accepter des opérations de lecture et d'écriture.
Mises à jour
Ce comportement bloquant pendant la synchronisation complique la mise à jour des clusters avec des files d'attente très grandes. À un moment donné, le nœud avec le maître doit être redémarré, ce qui signifie soit passer au miroir, soit désactiver la file d'attente pendant la mise à jour du serveur. Si nous choisissons de passer, nous perdrons des messages si les miroirs ne sont pas synchronisés. Par défaut, lors de la désactivation du broker, le passage à un miroir non synchronisé ne se produit pas. Cela signifie qu'une fois le broker de retour, nous ne perdons aucun message, le seul dommage étant le temps d'arrêt de la file d'attente. Les règles de comportement lors de la désactivation du broker sont définies par la politique ha-promote-on-shutdown. Vous pouvez définir l'une des deux valeurs :
always= activation du passage aux miroirs non synchroniséswhen-synced= passage uniquement au miroir synchronisé, sinon la file d'attente devient indisponible pour la lecture et l'écriture. La file d'attente revient en ligne dès que le broker revient
Quoi qu'il en soit, avec de grandes files d'attente, il faut choisir entre perdre des données et être indisponible.
Lorsque la disponibilité accroît la sécurité des données
Avant de prendre une décision, il faut prendre en compte une autre complication. Bien que la synchronisation automatique soit meilleure pour la redondance, comment cela affecte-t-il la sécurité des données ? Certes, grâce à une meilleure redondance, RabbitMQ est moins susceptible de perdre des messages existants, mais qu'en est-il des nouveaux messages des éditeurs ?
Voici ce qu'il faut prendre en compte :
- Un éditeur peut-il simplement renvoyer une erreur, et le service supérieur ou l'utilisateur essaiera-t-il à nouveau plus tard ?
- Un éditeur peut-il conserver le message localement ou dans une base de données pour réessayer plus tard ?
Si l'éditeur ne peut que rejeter le message, alors en réalité, améliorer la disponibilité augmente également la sécurité des données.
Ainsi, il faut chercher un équilibre, et la solution dépend de la situation spécifique.
Problèmes avec ha-promote-on-failure=when-synced
Idée ha-promote-on-failure= when-synced réside dans le fait que nous prévenons le passage à un miroir non synchronisé, évitant ainsi la perte de données. La file d'attente reste inaccessible en lecture ou écriture. Au lieu de cela, nous tentons de rétablir le courtier échoué avec des données intactes pour qu'il reprenne son rôle de maître sans perte de données.
Mais (et c'est un gros mais) si le courtier a perdu ses données, nous avons un grand problème : la file est perdue ! Toutes les données ont disparu ! Même si vous avez des miroirs qui sont principalement en train de rattraper la file principale, ces miroirs sont également rejetés.
Pour ajouter à nouveau un nœud avec le même nom, nous demandons au cluster d'oublier le nœud perdu (avec la commande rabbitmqctl forget_cluster_node) et de lancer un nouveau courtier avec le même nom d'hôte. Tant que le cluster se souvient du nœud perdu, il se souvient de l'ancienne file et des miroirs non synchronisés. Lorsque l'on demande au cluster d'oublier le nœud perdu, cette file est également oubliée. Il faut maintenant la redéclarer. Nous avons perdu toutes les données, même si nous avions des miroirs avec un ensemble de données partiel. Il aurait été préférable de passer à un miroir non synchronisé !
C'est pourquoi la synchronisation manuelle (et le non-synchronisation) associée à ha-promote-on-failure=when-synced, à mon avis, présente un risque considérable. Les documents indiquent qu'une telle option existe pour la sécurité des données, mais c'est une arme à double tranchant.
Rebalancement des maîtres
Comme promis, nous revenons au problème de l'accumulation de tous les maîtres sur un ou plusieurs nœuds. Cela peut se produire même à la suite d'une mise à jour « roulante » du cluster. Dans un cluster de trois nœuds, toutes les files principales s'accumuleront sur un ou deux nœuds.
Le rebalancement des maîtres peut poser problème pour deux raisons :
- Il n'existe pas de bons outils pour effectuer le rebalancement
- Synchronisation des files d'attente
Pour le rééquilibrage, il existe un outil tiers , qui n'est pas officiellement pris en charge. En ce qui concerne les plugins tiers, le guide RabbitMQ : « Le plugin fournit certains outils supplémentaires de configuration et de reporting, mais il n'est pas pris en charge ni vérifié par l'équipe RabbitMQ. Utilisez-le à vos risques et périls. »
Il existe également une autre astuce pour déplacer la file d'attente principale via des politiques HA. Le guide mentionne cela. Cela fonctionne comme suit :
- Supprime tous les miroirs à l'aide d'une politique temporaire avec une priorité plus élevée que la politique HA existante.
- Modifie la politique temporaire HA pour utiliser le mode « nœuds » en spécifiant le nœud vers lequel la file d'attente principale doit être déplacée.
- Synchronise la file d'attente pour forcer la migration.
- Une fois la migration terminée, la politique temporaire est supprimée. La politique HA d'origine entre en vigueur et le nombre nécessaire de miroirs est créé.
L'inconvénient est que cette approche peut ne pas fonctionner si vous avez de grandes files d'attente ou des exigences strictes en matière de redondance.
Regardons maintenant comment les clusters RabbitMQ fonctionnent avec les partitions réseau.
Violation de la cohérence
Les nœuds d'un système distribué sont connectés par des liaisons réseau, et ces liaisons peuvent être et seront coupées. La fréquence des coupures dépend de l'infrastructure locale ou de la fiabilité du cloud choisi. Dans tous les cas, les systèmes distribués doivent être capables de gérer ces situations. Encore une fois, nous sommes confrontés à un choix entre disponibilité et cohérence, et encore une fois, la bonne nouvelle est que RabbitMQ offre les deux options (mais pas en même temps).
Avec RabbitMQ, nous avons deux options principales :
- Autoriser la division logique (split-brain). Cela garantit la disponibilité, mais peut entraîner une perte de données.
- Interdire la division logique. Cela peut conduire à une perte temporaire de disponibilité selon la façon dont les clients se connectent au cluster. Cela peut également conduire à une indisponibilité totale du cluster composé de deux nœuds.
Mais qu'est-ce que la division logique ? C'est lorsque le cluster est divisé en deux en raison d'une perte de liaison réseau. De chaque côté, les miroirs passent en mode maître, de sorte qu'au final, chaque file d'attente a plusieurs maîtres.
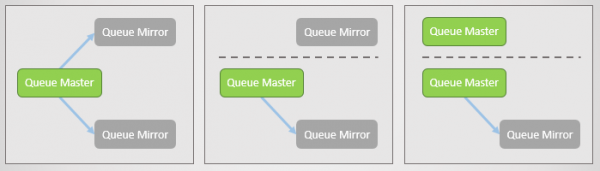
Fig. 17. La file principale et deux miroirs, chacun sur un nœud distinct. Ensuite, une défaillance réseau se produit, et un des miroirs se déconnecte. Le nœud séparé constate que les deux autres sont hors ligne et promeut ses miroirs au statut de maître. Nous avons maintenant deux files principales, toutes deux autorisant l'écriture et la lecture.
Si les éditeurs envoient des données vers les deux maîtres, nous obtiendrons deux copies divergentes de la file.
Différents modes RabbitMQ offrent soit la disponibilité, soit la cohérence.
Mode Ignore (par défaut)
Ce mode assure la disponibilité. Après une perte de connectivité, une séparation logique se produit. Après la restauration de la connectivité, l'administrateur doit décider quel segment privilégier. Le côté perdant sera redémarré, et toutes les données accumulées de ce côté seront perdues.
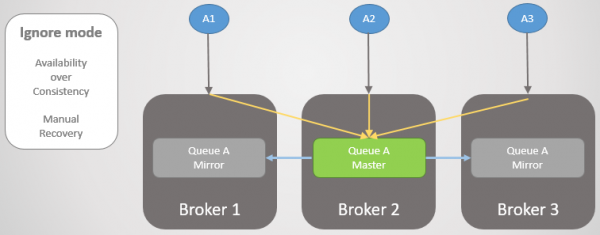
Fig. 18. Trois éditeurs sont connectés à trois courtiers. En interne, le cluster dirige toutes les requêtes vers la file principale sur le Courtier 2.
Nous perdons maintenant le Courtier 3. Il constate que d'autres courtiers sont hors ligne et promeut son miroir au statut de maître. Cela entraîne une séparation logique.
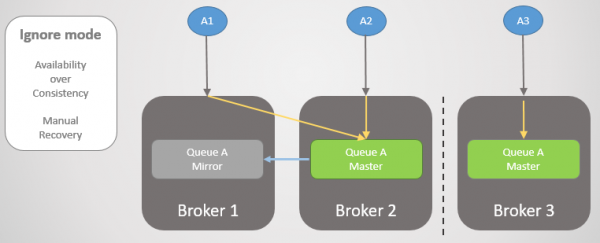
Fig. 19. Séparation logique (split-brain). Les écritures sont dirigées vers deux files principales, et deux copies divergent.
La connectivité est rétablie, mais la séparation logique reste. L'administrateur doit manuellement choisir le côté perdant. Dans le cas ci-dessous, l'administrateur redémarre le Courtier 3. Tous les messages qui n'ont pas été transmis sont perdus.
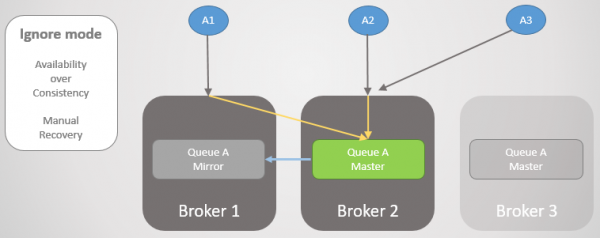
Fig. 20. L'administrateur déconnecte le Courtier 3.
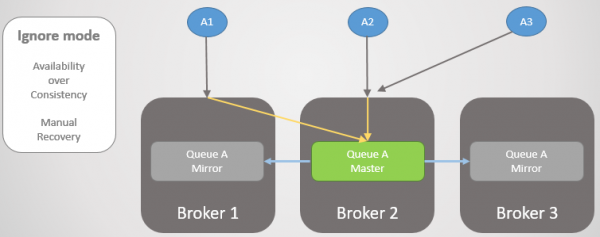
Fig. 21. L'administrateur redémarre le Courtier 3, et il se reconnecte au cluster, perdant tous les messages qui y sont restés.
Pendant la perte de connectivité et après sa restauration, le cluster et cette file étaient disponibles pour la lecture et l'écriture.
Mode Autoheal
Fonctionne de manière similaire au mode Ignore, sauf que le cluster choisit automatiquement le côté perdant après la séparation et la restauration de la connectivité. Le côté perdant revient dans le cluster vide, et la file perd tous les messages qui n'ont été envoyés qu'à ce côté.
Mode Pause Minority
Si nous ne voulons pas permettre une séparation logique, notre seule option est de renoncer à la lecture et à l'écriture sur le côté minoritaire après la partition du cluster. Lorsque le courtier constate qu'il se trouve sur le côté minoritaire, il suspend son activité, c'est-à-dire qu'il ferme toutes les connexions existantes et refuse toutes les nouvelles. Une fois par seconde, il vérifie la restauration de la connectivité. Dès que la connectivité est rétablie, il reprend son activité et rejoint le cluster.
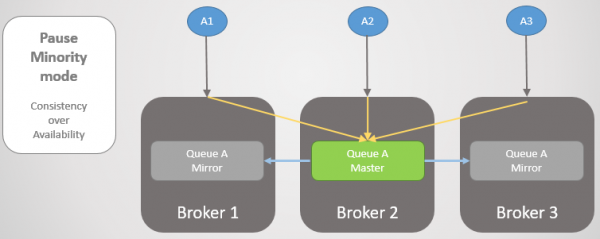
Fig. 22. Trois éditeurs sont liés à trois courtiers. En interne, le cluster dirige toutes les demandes vers la file d'attente principale du Courtier 2.
Ensuite, les Courtiers 1 et 2 se séparent du Courtier 3. Au lieu d'élever son miroir en maître, le Courtier 3 suspend son activité et devient indisponible.
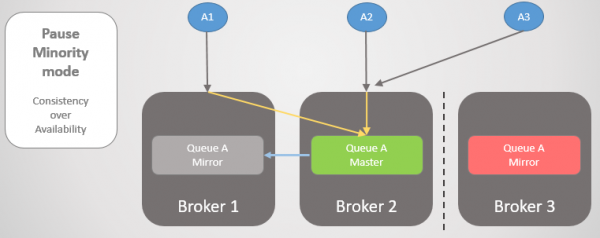
Fig. 23. Le Courtier 3 suspend son activité, déconnecte tous les clients et rejette les demandes de connexion.
Dès que la connectivité est rétablie, il revient dans le cluster.
Examinons un autre exemple où la file d'attente principale se trouve sur le Courtier 3.
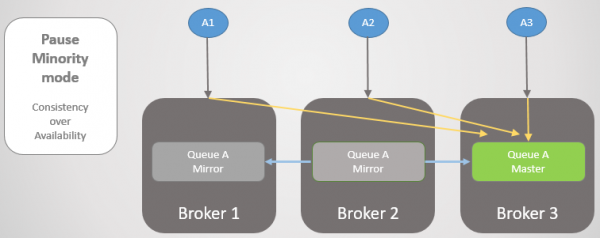
Fig. 24. La file d'attente principale sur le Courtier 3.
Ensuite, la même perte de connectivité se produit. Le Courtier 3 se met en pause, car il se trouve sur le côté minoritaire. De l'autre côté, les nœuds voient que le Courtier 3 s'est déconnecté, donc un miroir plus ancien des Courtiers 1 et 2 est élevé en maître.
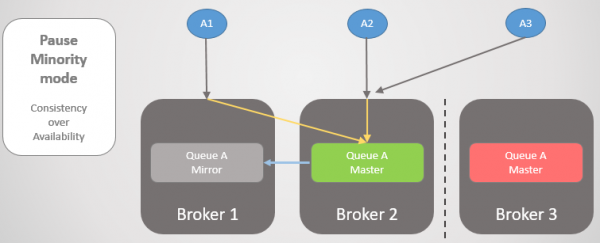
Fig. 25. Passage au Courtier 2 en cas d'indisponibilité du Courtier 3.
Lorsque la connectivité est rétablie, le Courtier 3 rejoindra le cluster.

Fig. 26. Le cluster est revenu à un fonctionnement normal.
Il est important de comprendre ici que nous obtenons la cohérence, mais nous pouvons également obtenir la disponibilité, si nous transférons avec succès les clients vers la plus grande partie de la partition. Pour la plupart des situations, personnellement, je choisirais le mode Pause Minority, mais cela dépend réellement du cas spécifique.
Pour assurer la disponibilité, il est important de garantir que les clients se connectent avec succès au nœud. Examinons nos options.
Assurer la connectivité des clients
Nous avons plusieurs options pour rediriger les clients vers la partie principale du cluster ou vers des nœuds opérationnels après une perte de connectivité (après la défaillance d'un nœud). Commençons par rappeler qu'une file d'attente spécifique est hébergée sur un nœud donné, mais le routage et les politiques sont répliqués sur tous les nœuds. Les clients peuvent se connecter à n'importe quel nœud, et le routage interne les dirigera là où ils doivent aller. Mais lorsque le nœud est suspendu, il rejette les connexions, donc les clients doivent se connecter à un autre nœud. Si un nœud est défaillant, il ne peut absolument rien faire.
Nos options :
- L'accès au cluster se fait via un répartiteur de charge qui parcourt simplement les nœuds de manière circulaire, tandis que les clients réessaient de se connecter jusqu'à ce que cela réussisse. Si un nœud ne fonctionne pas ou est suspendu, les tentatives de connexion échoueront, mais les suivantes iront vers d'autres serveurs (en mode circulaire). Cela convient pour une perte de connectivité à court terme ou pour un serveur en panne qui sera rapidement rétabli.
- Accéder au cluster via un répartiteur de charge et retirer les nœuds suspendus ou défaillants de la liste dès qu'ils sont détectés. Si cela est fait rapidement, et si les clients peuvent réessayer de se connecter, nous obtiendrons une disponibilité constante.
- Donner à chaque client une liste de tous les nœuds, et le client choisit aléatoirement l'un d'eux lors de la connexion. S'il reçoit une erreur lors de la tentative de connexion, il passe au nœud suivant dans la liste, jusqu'à ce qu'il se connecte.
- Éliminer le trafic du nœud défaillant ou suspendu à l'aide de DNS. Cela se fait grâce à un faible TTL.
Conclusions
La clustering de RabbitMQ a ses propres avantages et inconvénients. Les inconvénients les plus sérieux sont que :
- lorsqu'ils rejoignent le cluster, les nœuds rejettent leurs données ;
- la synchronisation bloquante entraîne une indisponibilité de la file d'attente.
Toutes les décisions difficiles découlent de ces deux caractéristiques de l'architecture. Si RabbitMQ pouvait conserver des données lors de la reconnexion d'un cluster, la synchronisation serait plus rapide. S'il était capable de synchronisation non bloquante, il supporterait mieux les grandes files d'attente. La résolution de ces deux problèmes améliorerait considérablement les performances de RabbitMQ en tant que technologie de messagerie résiliente et hautement disponible. Je ne recommanderais pas RabbitMQ avec clustering dans les situations suivantes :
- Réseau peu fiable.
- Stockage peu fiable.
- Très grandes files d'attente.
Concernant les réglages pour une haute disponibilité, envisagez les suivants :
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignoreouautoheal)- messages durables
- veuillez vous assurer que les clients se connectent à un nœud actif lorsque quelque chose échoue
Pour la cohérence (sécurité des données), envisagez les réglages suivants :
- Publisher Confirms et Manual Acknowledgements du côté du consommateur
ha-promote-on-failure=when-synced, si les éditeurs peuvent réessayer plus tard et si vous avez un stockage très fiable ! Sinon, définissez=always.ha-sync-mode=automatic(mais pour les grandes files d'attente inactives, un mode manuel peut être nécessaire ; de plus, considérez si l'indisponibilité pourrait entraîner la perte de messages)- mode Pause Minority
- messages durables
Nous n'avons pas encore abordé toutes les questions de résilience et de haute disponibilité ; par exemple, comment effectuer en toute sécurité des procédures administratives (telles que les mises à jour continues). Il faut aussi parler de la fédération et du plugin Shovel.
Si j'ai encore quelque chose à manquer, merci de me le faire savoir.
Voir aussi mon , où j'explore le cluster RabbitMQ avec Docker et Blockade pour tester certains scénarios de perte de messages décrits dans cet article.
Articles précédents de la série :
n°1 —
n°2 —
n°3 —
Source : habr.com
